

Jeg vil gerne præsentere en gennemgang af præsentationen fra begyndelsen af 2016 af Andrei Salnikov "Typiske fejl i applikationer, der fører til bloat i PostgreSQL"
I denne præsentation vil jeg gennemgå de primære fejl i applikationer, der opstår i designfasen og under kodningen af applikationen. Jeg vil kun tage de fejl, der fører til bloat i PostgreSQL. Som regel markerer dette begyndelsen på enden af din systems samlede ydeevne, selvom der i starten ikke var nogen åbenlyse tegn på det.
Jeg glæder mig til at byde alle velkommen! Denne præsentation er ikke så teknisk som den forrige fra min kollega. Denne præsentation er primært rettet mod udviklere af backend-systemer, fordi vi har et tilstrækkeligt antal kunder. Og alle begår de samme fejl. Om dem vil jeg fortælle jer. Jeg vil forklare, hvad disse fejl kan føre til forfærdelige og dårlige konsekvenser.
Hvorfor opstår fejltagelser? De opstår af to grunde: ved at tage chancer, måske vil det gå, og på grund af manglende viden om de mekanismer, der sker mellem databasen og applikationen, samt i selve databasen.
Jeg vil give jer tre eksempler med forfærdelige billeder af, hvordan alting er blevet dårligt. Kort fortælle om mekanismen, der foregår der, og hvordan man kan håndtere dem, når de opstår, samt hvilke præventive metoder der kan anvendes til at forhindre fejl. Jeg vil fortælle om hjælpemidler og give nyttige links.
Jeg brugte en testdatabase, hvor jeg havde to tabeller. Den ene tabel indeholdt kundernes konti, den anden med transaktioner på disse konti. Og med en vis regelmæssighed opdaterer vi saldi på disse konti.
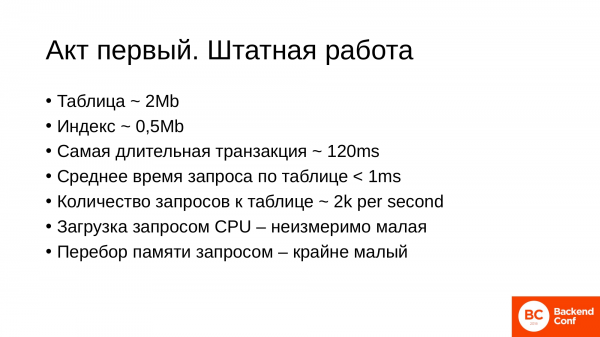
Oprindelige data for tabellen: den er ret lille, 2 MB. Svar tiden på databasen og specifikt på tabellen er også meget god. Og en god belastning – 2.000 operationer pr. sekund på tabellen.
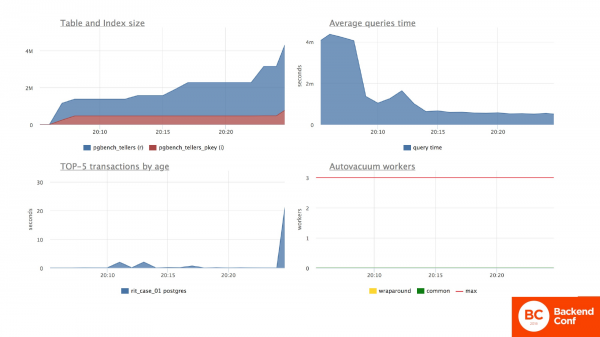
Og gennem denne præsentation vil jeg vise jer grafikker, så det er tydeligt, hvad der sker. Der vil altid være 2 slides med grafer. Den første slide viser, hvad der generelt sker på serveren.
Og i denne situation ser vi, at vores tabel virkelig er af lille størrelse. Indekset er lille på 2 MB. Dette er den første graf til venstre.
Den gennemsnitlige svartid på serveren er også stabil og lav. Dette er den øverste højre graf.
Den nederste venstre graf viser de længste transaktioner. Vi kan se, at transaktioner udføres hurtigt. Og auto-vakuumet fungerer endnu ikke, fordi det var en starttest. Fremadrettet vil det fungere og være nyttigt for os.
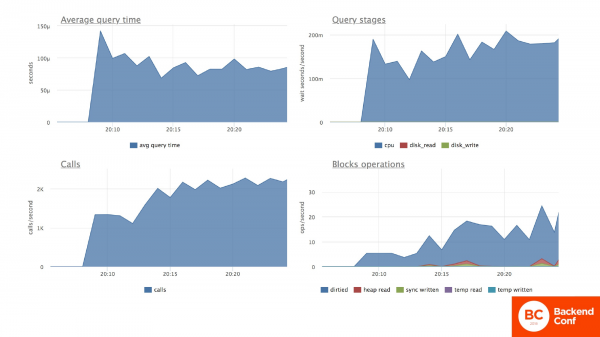
Den anden slide vil altid være dedikeret til den testede tabel. I denne situation opdaterer vi konstant balancerne på kundens konti. Og vi ser, at den gennemsnitlige svartid for opdateringsoperationen er ganske god, mindre end et millisekund. Vi kan også se, at CPU-ressourcerne (den øverste højre graf) forbruges jævnt og i ganske små mængder.
Den nederste højre graf viser, hvor meget operativ- og diskhukommelse vi gennemgår i jagten på den nødvendige linje, før vi opdaterer den. Og antallet af operationer på tabellen er 2.000 per sekund, som jeg nævnte i begyndelsen.
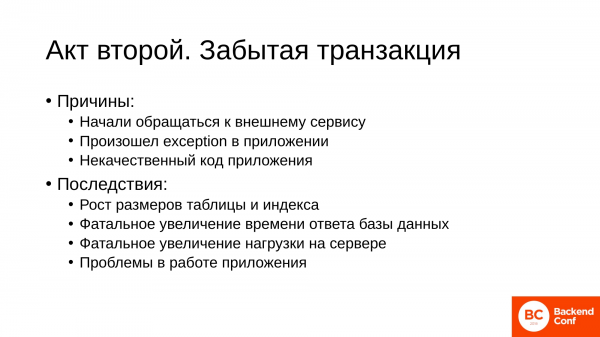
Og nu sker der en tragedie. Af en eller anden grund opstår der en lang glemt transaktion. Årsagerne er som regel banale:
- En af de mest almindelige årsager er, at vi i applikationskoden er begyndt at anmode om en ekstern service. Og denne service svarer ikke. Det vil sige, at vi åbnede en transaktion, foretog en ændring i databasen og gik for at læse e-mails eller til en anden service inden for vores infrastruktur, og af en eller anden grund svarer den ikke. Og vi har en session, der hænger i en tilstand – det er uklart, hvornår den vil blive løst.
- Den anden situation opstår, når der i koden af en eller anden grund opstod en exception. Og vi håndterede ikke lukningen af transaktionen i exception. Og vi har en hængende session med en åben transaktion.
- Og den sidste – det er også et ret almindeligt tilfælde. Det er dårlig kvalitet på koden. Nogle frameworks åbner en transaktion. Den hænger, og du kan være uvidende i applikationen om, at den hænger.
Hvad fører sådanne ting til?
Til at vores tabeller og indekser begynder at svulme op. Det er lige præcis den effekt, vi kalder bloat. For databasen vil det udtrykke sig i, at vi pludselig får en dramatisk stigning i svartiden for databasen, og belastningen på database-serveren vil øges. Og som følge heraf vil applikationen lide. Fordi hvis du i koden brugte 10 millisekunder på at anmode databasen, 10 millisekunder på din logik, så sluttede din funktion på 20 millisekunder. Men nu vil din situation være helt trist.
Lad os se, hvad der sker. Den nederste venstre grafik viser, at vi har en langvarig transaktion. Og hvis vi ser på den øverste venstre grafik, kan vi se, at størrelsen på tabellen, som var 2 megabyte, pludselig er steget til 300 megabyte. Samtidig er mængden af data i tabellen ikke ændret, dvs. der er en betydelig mængde affald.
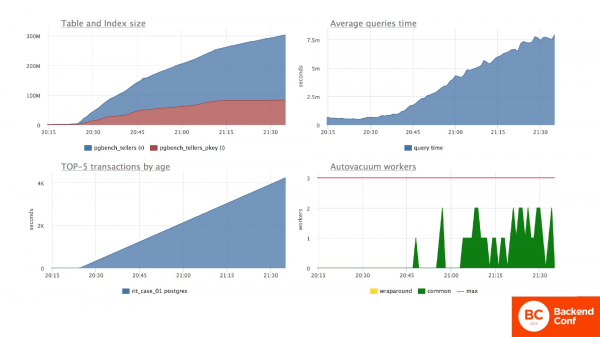
Den overordnede situation med den gennemsnitlige serverresponsstid er også ændret betydeligt. Dvs. alle anmodninger til serveren er begyndt at falde kraftigt. Og samtidig er interne PostgreSQL-processer, i form af autovacuum, startet, som prøver at gøre noget og bruger ressourcer.
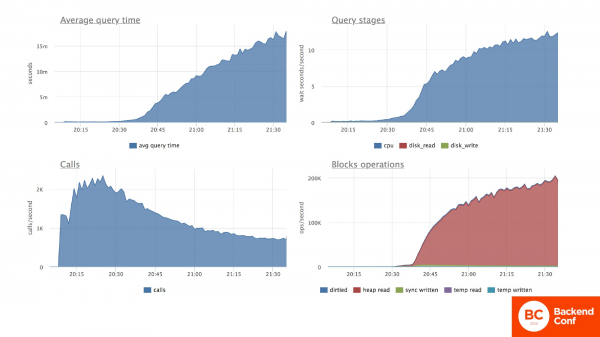
Hvad sker der med vores tabel? Det samme. Den gennemsnitlige svarstid for tabellen er steget markant. Hvis vi ser specifikt på de forbrugte ressourcer, kan vi se, at belastningen på CPU'en er steget voldsomt. Dette er den øverste højre grafik. Og den er steget, fordi CPU'en skal sortere gennem en masse ubrugelige linjer på jagt efter én, der er nødvendig. Dette er den nederste højre grafik. Som et resultat er antallet af opkald pr. sekund begyndt at falde dramatisk, fordi databasen ikke kan behandles i samme omfang som før.
Vi skal komme tilbage til livet. Vi går på internettet og finder ud af, at lange transaktioner fører til problemer. Vi identificerer og dræber denne transaktion. Og alt fungerer normalt. Alt fungerer som det skal.
Vi har taget det roligt, men efter et stykke tid begynder vi at bemærke, at applikationen ikke fungerer som før hændelsen. Anmodningerne behandles stadig langsommere, og det er væsentligt langsommere. I mit specifikke eksempel langsommere med 1,5-2 gange. Belastningen på serveren er også højere end før hændelsen.
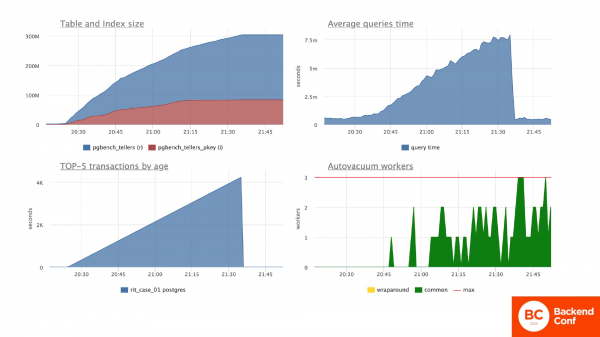
Og spørgsmålet er: 'Hvad sker der med databasen i dette øjeblik?'. Og med databasen sker der følgende. På transaktionsgrafikken kan du se, at den er stoppet, og der er faktisk ingen lange transaktioner. Men størrelsen på tabellen er dramatisk steget under hændelsen. Og siden da er den ikke blevet mindre. Den gennemsnitlige tid for databasen har stabiliseret sig. Og responsen ser ud til at være rimelig med en acceptabel hastighed for os. Autovacuum er blevet mere aktivt og er begyndt at håndtere tabellen, fordi det skal bearbejde en større mængde data.
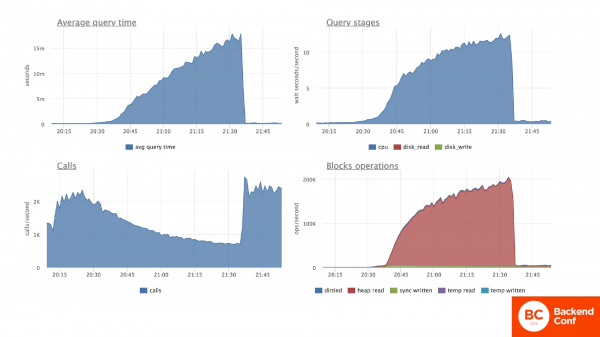
Specifikt for den testede tabel med konti, hvor vi ændrer saldoer: svartiden på anmodningen ser ud til at være tilbage til det normale. Men i virkeligheden er den 1,5 gange højere.
Og hvad angår belastningen på processoren, ser vi, at belastningen ikke er vendt tilbage til det ønskede niveau efter ulykken. Årsagerne ligger netop i det nederste højre diagram. Det er tydeligt, at der sker en overskridelse af noget hukommelse. Det vil sige, at vi bruger serverens database ressourcer på at gennemgå unødvendige data for at finde den ønskede række. Antallet af transaktioner pr. sekund har stabiliseret sig.
Overordnet set er det godt, men situationen er værre end før. Der er en klar degradering af databasen som følge af vores applikation, der arbejder med denne database.
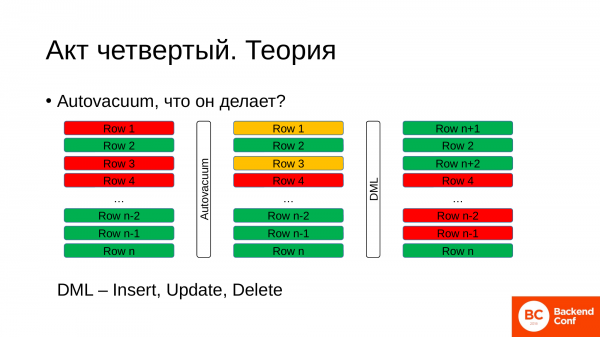
Og for at forstå, hvad der foregår, hvis du ikke var til det tidligere oplæg, så her er lidt teori. Teori om den interne proces. Hvad er autovacuum og hvad gør det?
Bare kort for forståelsens skyld. På et tidspunkt har vi en tabel. I tabellen har vi rækker. Disse rækker kan være aktive, levende, nødvendige for os lige nu. På billedet er de markeret med grøn farve. Og der er døde rækker, som allerede er blevet behandlet, er blevet opdateret, og hvor der er blevet tilføjet nye poster. Og de er markeret som ikke interessante for databasen længere. Men de ligger stadig i tabellen på grund af Postgres' egenskaber.
Hvad er formålet med autovacuum? Autovacuum kontakter på et tidspunkt databasen og spørger: "Giv mig venligst id'et på den ældste transaktion, der aktuelt er åben i databasen." Databasen returnerer dette id. Og autovacuum, baseret på det, gennemgår rækkerne i tabellen. Og hvis det ser, at nogle rækker er blevet ændret af meget ældre transaktioner, har det ret til at markere dem som rækker, som vi kan genbruge i fremtiden ved at skrive nye data til dem. Dette er en baggrundsproces.
Imens fortsætter vi med at arbejde med databasen, fortsætter med at foretage ændringer i tabellen. Og til de rækker, vi kan genbruge, skriver vi nye data. Og således får vi et kredsløb, hvor der hele tiden opstår nogle døde gamle rækker, som vi i stedet skriver nye rækker til, som vi har brug for. Og dette er en normal tilstand for at arbejde med PostgreSQL.
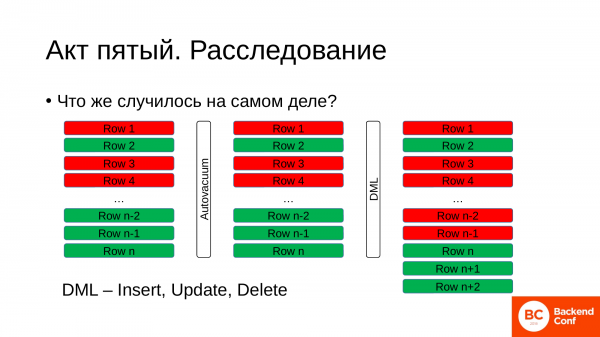
Hvad skete der under ulykken? Hvordan foregik denne proces der?
Vi havde en tabel i en eller anden tilstand, nogle rækker var levende, og nogle var døde. Så kom autovakuum. Han spurgte databasen om, hvad der var den ældste transaktion, og hvad dens id var. Han fik denne id, der kan være flere timer gammel, eller måske ti minutter. Det afhænger af, hvor meget belastning du har på din database. Og så gik han på jagt efter rækker, som han kunne markere som genbrugelige. Og han fandt ingen sådanne rækker i vores tabel.
Men i mellemtiden fortsætter vi med at arbejde på tabellen. Vi gør noget indeni, opdaterer, ændrer data. Hvad skal databasen så gøre i mellemtiden? Den har ikke andet valg end at tilføje nye rækker i slutningen af den eksisterende tabel. Og på den måde begynder størrelsen af tabellen at vokse.
Faktisk har vi brug for de grønne rækker til vores arbejde. Men under et sådant problem ender vi med, at procentdelen af de grønne rækker er ekstremt lav i hele tabelens omfang.
Når vi udfører en forespørgsel, er databasen nødt til at gennemgå alle rækkerne: både de røde og de grønne for at finde den rigtige række. Og effekten af at tabe pladser til unyttige data kaldes "bloat", som også æder vores diskplads. Kan du huske, det var 2 MB, nu er det blevet 300 MB? Og nu skal du ændre megabyte til gigabyte, så mister du hurtigt alle dine diskressourcer.
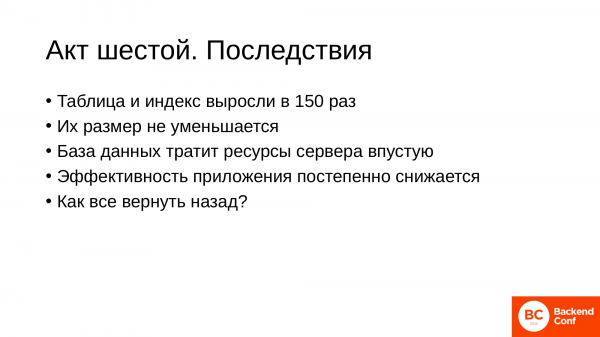
Hvilke konsekvenser kan der være for os?
- I mit eksempel voksede tabellen og indekset 150 gange. Nogle af vores kunder har haft mere fatale tilfælde, hvor der simpelthen ikke var plads på disken.
- Størrelsen på tabellerne vil aldrig falde af sig selv. Autovakuum kan i nogle tilfælde skære enden af tabellen, hvis der kun er døde rækker. Men da der sker en konstant rotation, kan en grøn række hænge i slutningen og ikke blive opdateret, mens alle andre bliver skrevet et eller andet sted i begyndelsen af tabellen. Men det er så usandsynligt, at din tabel vil falde i størrelse, at det ikke er værd at håbe på.
- Databasen skal gennemgå hele bunken af unyttige rækker. Og vi bruger diskressourcer, CPU-ressourcer og elektricitet.
- Og det påvirker direkte vores applikation, fordi hvis vi i starten brugte 10 millisekunder på en forespørgsel, 10 millisekunder på vores kode, så begyndte vi under nedbruddet at bruge et sekund på forespørgslen og 10 millisekunder på koden, dvs. applikationens ydeevne faldt med en faktor. Og når nedbruddet blev løst, begyndte vi at bruge 20 millisekunder på forespørgslen, 10 millisekunder på koden. Det betyder, at vi stadig er faldet med halvanden gang i ydeevne. Og det er alt sammen på grund af en transaktion, der hang, muligvis på grund af vores egen fejl.
- Og spørgsmålet er: "Hvordan får vi det hele tilbage?", så alt fungerer godt igen, og forespørgslerne kører lige så hurtigt som før nedbruddet.
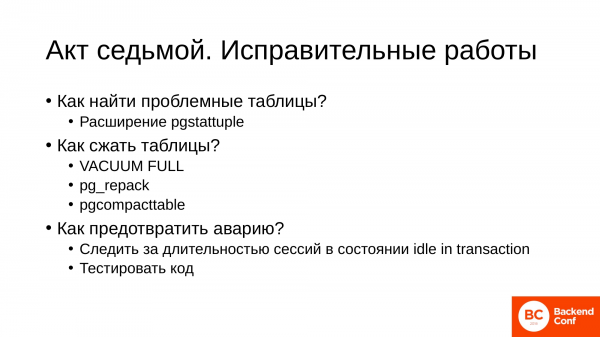
Derfor er der en bestemt arbejdsproces, der udføres.
Først skal vi finde de problematiske tabeller, som er vokset for meget. Vi forstår, at nogle tabeller har en mere aktiv skrive aktivitet, mens andre har mindre. Og til dette bruges udvidelsen . Når du har installeret denne udvidelse, kan du skrive forespørgsler, der hjælper dig med at finde de tabeller, der er vokset betydeligt.
Når du har fundet disse tabeller, skal de komprimeres. Der er allerede værktøjer til dette. I vores virksomhed bruger vi tre værktøjer. Det første – den indbyggede VACUUM FULL. Det er brutalt, hårdt og ubarmhjertigt, men nogle gange er det meget nyttigt. og – det er tredjeparts værktøjer til at komprimere tabeller. Og de er mere skånsomme over for databasen.
De bruges afhængigt af hvad der er mest praktisk for dig. Men jeg vil tale om det til sidst. Det vigtigste er, at der er tre værktøjer. Der er valg.
Når vi har rettet alt og sikret os, at alt er i orden, skal vi vide, hvordan vi kan forhindre denne situation i fremtiden:
- Det er ret let at forebygge. Man skal holde øje med sessionernes varighed på Master-serveren. Især farlige sessioner i tilstanden idle in transaction. Det er dem, der lige har åbnet en transaktion, lavet noget og derefter forlod eller bare hang, mistede sig selv i koden.
- Og for jer, som udviklere, er det vigtigt at teste koden på tidspunktet for opståen af disse situationer. Det er ikke svært at gøre. Det vil være en nyttig kontrol. I vil undgå mange "børnesygdomme" relateret til lange transaktioner.
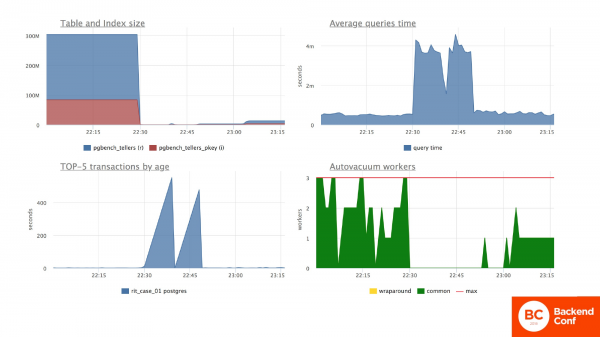
På disse diagrammer ville jeg vise, hvordan tabellen og adfærden i databasen ændrede sig, efter at jeg i dette tilfælde kørte VACUUM FULL på tabellen. Dette er ikke i produktion.
Størrelsen på tabellen vendte straks tilbage til en normal driftsstatus på et par megabyte. Det havde ikke stor indflydelse på den gennemsnitlige svartid på serveren.
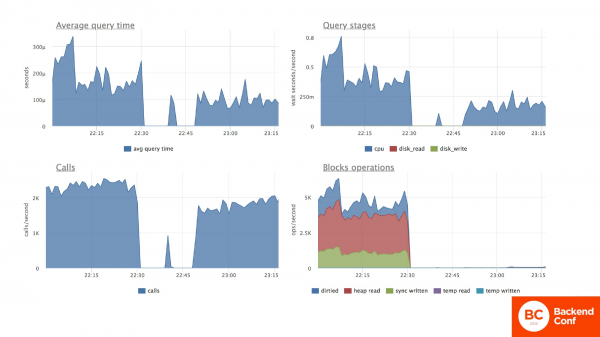
Men specifikt for vores testtabel, hvor vi opdaterede saldi på konti, ser vi, at den gennemsnitlige svartid for opdateringsforespørgsler er faldet til det præ-katastrofale niveau. Ressourcerne, der forbruges af processoren til at udføre denne forespørgsel, er også faldet til det præ-katastrofale niveau. Og det højre nederste diagram viser, at vi nu hurtigt finder den ønskede række uden at gennemgå en masse døde rækker, som var til stede før komprimeringen af tabellen. Den gennemsnitlige forespørgselstid er dog forblevet omtrent på samme niveau. Men dette kan skyldes en fejlmargin i mit udstyr.
Dette afslutter den første historie. Den er meget almindelig. Og den sker for alle, uanset kundens erfaring og hvor kvalificerede programmører der er. Det sker før eller siden.
Den anden historie, hvor vi fordelte belastningen og optimerede serverressourcerne.
- Vi er vokset og er blevet seriøse. Vi forstår, at vi har en replika, og det ville være godt at balancere belastningen: skrive til Master og læse fra replika. Denne situation opstår normalt, når vi ønsker at forberede nogle rapporter eller ETL. Og virksomheden er meget glad for det. De ønsker meget forskellige rapporter med kompleks analyse.
- Rapporter tager timer, fordi kompleks analyse ikke kan beregnes på millisekunder. Vi, som de seje fyre, skriver kode. Vi laver indsætninger i applikationen, så vi skriver til Master og udfører rapporter på replika.
- Vi fordeler belastningen.
- Det hele fungerer glimrende. Vi er dygtige.
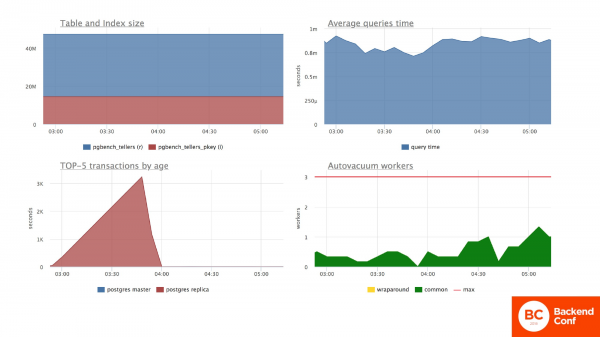
Hvordan ser denne situation ud? Specifikt på disse diagrammer har jeg også tilføjet varigheden af transaktioner fra replikaen. Alle andre diagrammer vedrører kun Master-serveren.
Rapport tabellen er vokset på dette tidspunkt. Der er blevet flere af dem. Vi kan se, at den gennemsnitlige svartid på serveren er stabil. Vi kan se, at der på replikaen er en langvarig transaktion, der kører i 2 timer. Vi ser, at autovacuumet arbejder tilfredsstillende og behandler døde rækker. Alt er godt.
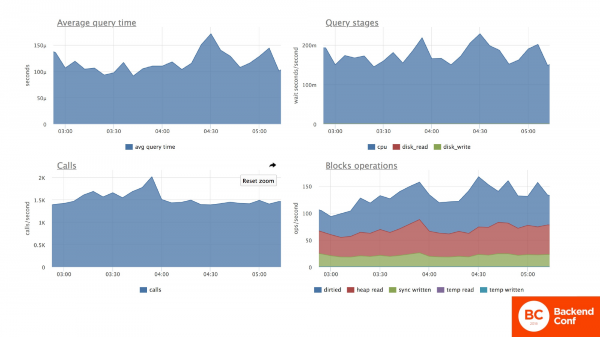
Specifikt vedrørende den undersøgte tabel fortsætter vi med at opdatere saldoerne på kontiene. Og vi har også en stabil svartid på forespørgslerne, stabil ressourceforbrug. Alt er godt.
Alt er godt, indtil rapporterne begynder at blive afvist på grund af konflikter med replikationen. Og de afvises med konstant periodicitet.
Vi går på internettet og begynder at læse, hvorfor dette sker. Og vi finder en løsning.
Den første løsning er at øge replikationsforsinkelsen. Vi ved, at vores rapport kører i 3 timer. Vi indstiller replikationsforsinkelsen til 3 timer. Vi starter alt, men vi har stadig problemer med, at rapporterne nogle gange bliver afvist.
Vi vil gerne have, at alt er perfekt. Vi dykker videre ned i informationen og finder en fantastisk indstilling - hot_standby_feedback. Vi aktiverer det. Hot_standby_feedback gør det muligt for os at holde arbejdet med autovacuumet tilbage på Masteren. Dermed slipper vi helt for replikationskonflikter. Og alt fungerer godt med rapporterne.
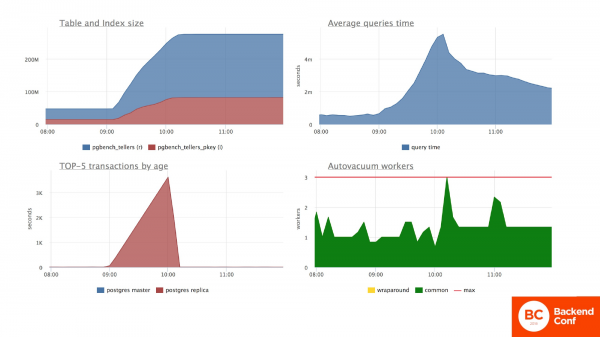
Hvad sker der med Master-serveren i mellemtiden? Med Master-serveren er der totale problemer. Lige nu observerer vi graferne, når jeg har aktiveret begge disse indstillinger. Og vi kan se, at sessionen på replikaen på en eller anden måde er begyndt at påvirke situationen på Master-serveren. Den påvirker faktisk, fordi den har suspenderet autovacuumet, der rydder døde rækker. Størrelsen på tabellen er steget himmelhøjt igen. Den gennemsnitlige forespørgselstid i hele databasen er også steget himmelhøjt. Autovacuumene er blevet lidt mere pressede.
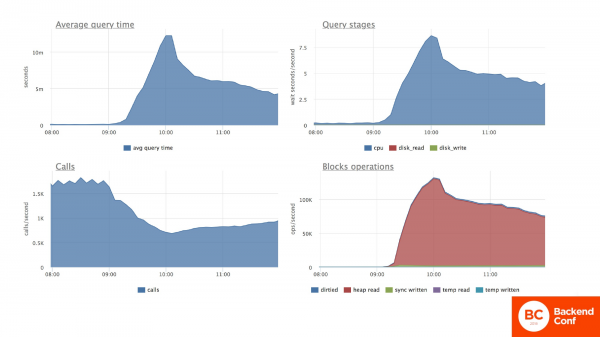
Specifikt for vores tabel kan vi se, at dataopdateringen også er steget himmelhøjt. CPU-forbrugsniveauet er også steget meget. Vi gennemgår igen et stort antal døde, ubrugelige rækker. Og svartiden for denne tabel, antallet af transaktioner, er faldet.
Hvordan vil det se ud, hvis vi ikke ved, hvad jeg har talt om tidligere?
- Vi begynder at se efter problemer. Hvis vi har stået overfor problemer i første del, ved vi, at det kan skyldes en lang transaktion, og vi kigger på Master. Problemet er hos os på Master. Det ryster. Det varmer op, og dets Load Average er under hundrede.
- Anmodningerne der bremser, men vi ser ingen langvarige transaktioner. Og vi forstår ikke, hvad problemet er. Vi ved ikke, hvor vi skal lede.
- Vi tjekker serverens udstyr. Måske har vores RAID svigtet. Måske er en RAM-brik brændt ud. Hvad som helst kan være tilfældet. Men nej, serverne er nye, og alt fungerer perfekt.
- Alle løber rundt: administratorer, udviklere og direktøren. Intet hjælper.
- Og på et tidspunkt begynder alt pludselig at rette sig selv.
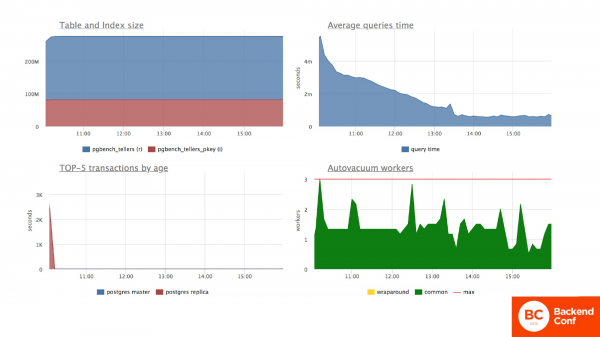
På replikaen har vi i mellemtiden fået en anmodning til at køre og afslutte. Vi har modtaget en rapport. Virksomheden er stadig tilfreds. Som vi ser, er tabellen vokset igen og ser ikke ud til at ville mindske sig. På grafen med sessioner har jeg efterladt et stykke af denne lange transaktion fra replikaen, så I kan vurdere, hvor lang tid der går, før situationen stabiliserer sig.
Sessionen er forsvundet. Og først efter noget tid kommer serveren mere eller mindre i orden. Og den gennemsnitlige svartid for anmodningerne på Master-serveren kommer tilbage til normalen. Fordi autobekræftelse endelig har fået mulighed for at rense op, markere disse døde rækker. Og hvor hurtigt det gør det, så hurtigt vil vi komme i orden.
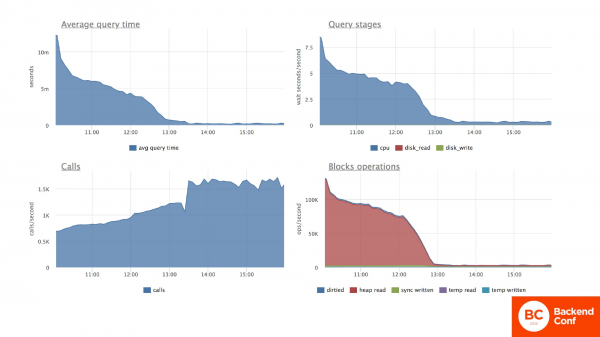
På den testede tabel, hvor vi opdaterer balanceoplysningerne, ser vi et helt ensartet billede. Den gennemsnitlige opdateringstid for kontoen normaliseres også gradvist. Ressourcerne, der forbruges af CPU'en, falder også. Og antallet af transaktioner pr. sekund vender tilbage til normal. Men igen, ikke til den norm, vi havde før uheldet.
Vi oplever i hvert fald et fald i ydeevnen, ligesom i første tilfælde, på en og halv til to gange, nogle gange endda mere.
Vi har tilsyneladende gjort alt rigtigt. Fordelt belastningen. Udstyret står ikke stille. Vi har fornuftigt opdelt anmodningerne, men det er stadig gået dårligt.
- Skal hot_standby_feedback ikke aktiveres? Ja, det anbefales ikke at aktivere det uden gode grunde. Fordi denne indstilling påvirker Master-serveren direkte og sænker autoscrubberens arbejde der. Hvis du aktiverer det på en replika og glemmer det, kan du dræbe Master og få store problemer med applikationen.
- Skal max_standby_streaming_delay øges? Ja, det er sådan for rapporter. Hvis du har en rapport, der tager tre timer, og du ikke ønsker, at den falder på grund af replikationskonflikter, så øg blot forsinkelsen. En lang rapport kræver aldrig data, der lige er kommet ind i databasen. Hvis den tager tre timer, betyder det, at du kører den for en ældre periode. Og for dig betyder det ingen forskel om der er tre eller seks timers forsinkelse; du vil stadig få rapporterne stabilt uden problemer med nedbrud.
- Det er naturligvis nødvendigt at overvåge lange sessioner på de replikerede enheder, især hvis du har besluttet at aktivere hot_standby_feedback på en replika. For der kan ske hvad som helst. Du har givet denne replika til en udvikler for at teste forespørgsler. Han skrev en vanvittig forespørgsel. Startede og gik for at drikke te, mens vi fik en overbelastet Master. Eller vi gav ikke den rigtige applikation adgang. Situationerne er mangeartede. Sessioner på replikaer skal overvåges lige så omhyggeligt som på Master.
- Og hvis du har hurtige og langvarige forespørgsler fra replikaer, så er det bedre at fordele belastningen ved at splitte dem op. Dette er en reference til streaming_delay. For hurtige forespørgsler, hav en replika med en lille replikationsforsinkelse. For lange rapporteringsforespørgsler, hav en replika, der kan være forsinket med 6 timer eller en dag. Det er en helt normal situation.
Vi afhjælper konsekvenserne på samme måde:
- Vi finder oppustede tabeller.
- Og vi komprimerer dem med det mest hensigtsmæssige værktøj, vi har.
Den anden historie er slut her. Vi går videre til den tredje historie.
Denne er også ret almindelig for os, hvor vi laver migration.
- Ethvert softwareprodukt vokser. Kravene til det ændres. Vi ønsker alle at udvikle os. Og nogle gange er det nødvendigt at opdatere dataene i tabellen, nemlig at køre en opdatering i forbindelse med vores migration for at implementere den nye funktionalitet, som vi indfører i løbet af vores udvikling.
- Den gamle dataformat fungerer ikke længere. Lad os antage, at vi nu henviser til den anden tabel, hvor jeg har operationer på disse konti. Og lad os sige, at de var i rubler, men vi har besluttet at øge præcisionen og gøre det i kopejek. For dette skal vi lave en opdatering: feltet med operationsbeløbet skal ganges med hundrede.
- I den moderne verden bruger vi automatiserede værktøjer til versionskontrol af databaser. Lad os antage, . Vi skriver vores migration der. Tester den på vores testdatabase. Alt er godt. Opdateringen går igennem. Den blokerer arbejdet i et stykke tid, men vi får opdaterede data. Og vi kan køre nye funktioner på dette. Alt er testet, kontrolleret. Alt er bekræftet.
- Vi har udført planlagte arbejder, gennemført migrationen.
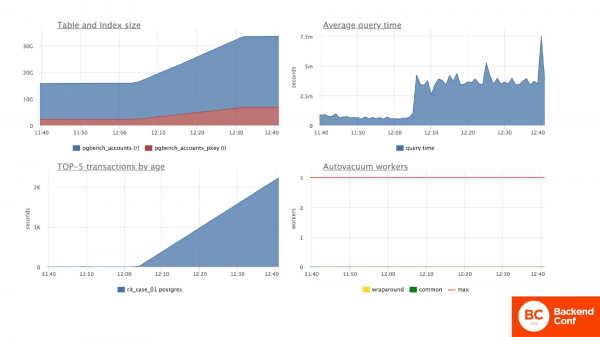
Her er migrationen med opdateringen præsenteret for dig. Da det drejer sig om operationer på konti, var tabellen 15 GB stor. Og da vi opdaterer hver enkelt række, har vi fordoblet størrelsen på tabellen med opdateringen, fordi vi har overskrevet hver række.
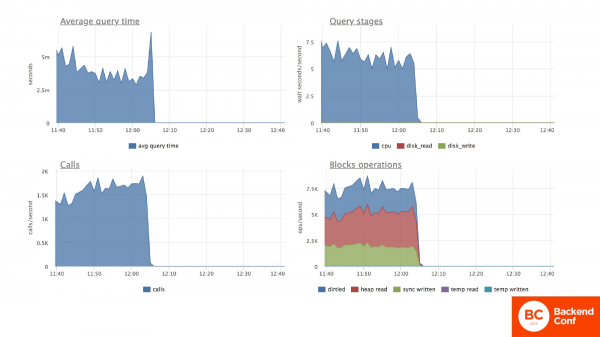
Under migrationen kunne vi ikke gøre noget med denne tabel, fordi alle forespørgsler til den blev sat i kø og ventede på, at denne opdatering blev afsluttet. Men her vil jeg gerne henlede din opmærksomhed på tallene på den lodrette akse. Det vil sige, at vi har den gennemsnitlige forespørgselstid før migrationen på omkring 5 millisekunder, og belastningen på CPU'en, antallet af blokoperationer til læsning fra disken, er mindre end 7,5.
Vi gennemførte migrationen og fik igen problemer.
Migrationen var vellykket, men:
- Den gamle funktionalitet tog længere tid at udføre.
- Tabellen voksede igen i størrelse.
- Belastningen på serveren blev igen større, end den var.
- Og selvfølgelig, mens vi stadig beskæftiger os med den funktionalitet, der tidligere fungerede godt, har vi forbedret den en smule.
Og dette er igen bloat, som skaber problemer for os.
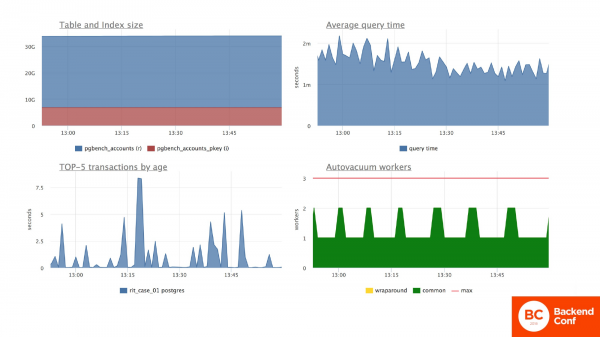
Her viser jeg, at tabellen, ligesom i de tidligere to tilfælde, ikke har tænkt sig at vende tilbage til de tidligere størrelser. Den gennemsnitlige belastning på serveren synes at være passende.
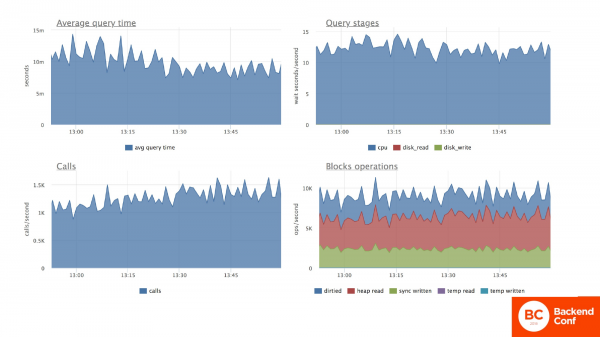
Hvis vi kigger på regnearkslisten, kan vi se, at den gennemsnitlige forespørgselstid er steget med det dobbelte i forhold til dette ark. Belastningen på CPU'en og antallet af gennemkørte rækker i hukommelsen er steget over 7,5, hvor det tidligere var lavere. Og CPU'ernes belastning er steget med det dobbelte, mens belastningen ved blokoperationer er steget med 1,5 gange, det vil sige, vi har oplevet en nedgang i serverens ydeevne. Og som en konsekvens – en nedgang i vores applikations ydeevne. I mellemtiden er antallet af kald forblevet på omtrent samme niveau.
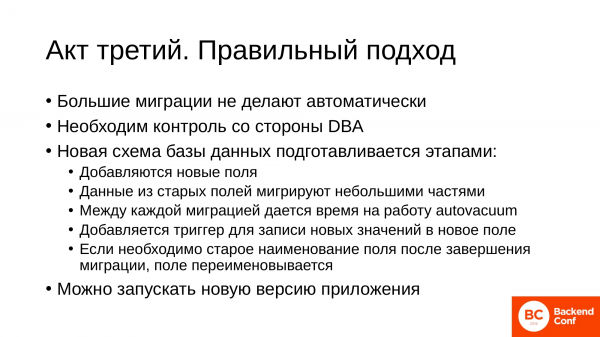
Her er det vigtigt at forstå, hvordan man korrekt udfører sådanne migrationer. Og de skal udføres. Vi foretager ret konstant disse migrationer.
- Store migrationer foretages ikke automatisk. De skal altid være kontrollerede.
- Der er behov for kontrol fra en person med viden. Hvis I har en DBA på holdet, så lad DBA'en gøre det. Det er hans job. Hvis ikke, så lad den mest erfarne person gøre det, som ved hvordan man arbejder med databaser.
- Den nye databaseskema, selv hvis vi blot opdaterer én kolonne, bliver altid forberedt i faser, det vil sige på forhånd før den nye version af applikationen bliver rullet ud:
- Der tilføjes nye felter, hvor vi netop vil gemme de opdaterede data.
- Vi flytter data fra det gamle felt til det nye felt i små portioner. Hvorfor gør vi det? For det første har vi altid kontrol over denne proces. Vi ved, at vi allerede har flyttet så mange batches, og at der er så mange tilbage.
- En anden fordel er, at mellem hver batch afslutter vi transaktionen, åbner en ny, og det giver mulighed for, at autovacuumet kan arbejde på tabellen og markere døde rækker til genbrug.
- For de rækker, der vil dukke op under applikationens drift (vi har stadig den gamle applikation kørende), tilføjer vi en trigger, der skriver de nye værdier til de nye felter. I vores tilfælde er det en gang med hundrede af den gamle værdi.
- Hvis vi er stædige og ønsker at bruge det samme felt, så ændrer vi blot navnene på felterne efter at alle migrationer er afsluttet, og før den nye version af applikationen rulles ud. De gamle navne gives et påfundet navn, og de nye felter gives de gamle navne.
- Og først efter dette starter vi den nye version af applikationen.
Og samtidig vil vi ikke opleve bloat og vil ikke falde i ydeevne.
Dette er slutningen på den tredje historie.
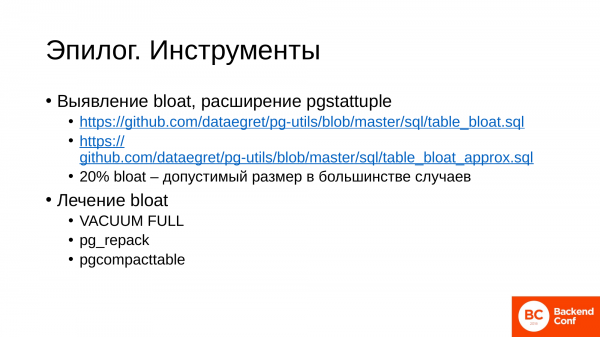
Lad os nu se lidt nærmere på de værktøjer, jeg nævnte i den første historie.
Før du begynder at lede efter bloat, skal du sørge for at installere udvidelsen. .
For at du ikke skal finde på forespørgsler, har vi allerede skrevet disse forespørgsler i vores arbejde. Du kan bruge dem. Her præsenteres to forespørgsler.
- Den første kører relativt længe, men den viser dig nøjagtige bloatværdier for tabellen.
- Den anden kører hurtigere og er meget effektiv, når du hurtigt skal vurdere – om der er bloat eller ej i tabellen. Og du skal også forstå, at bloat i en Postgres-tabel altid er til stede. Det er en funktion i dens MVCC-model.
- Og 20 % bloat er normalt for tabeller i de fleste tilfælde. Det vil sige, at du ikke behøver at bekymre dig og komprimere denne tabel.
Hvordan man identificerer tabeller, der er blevet oppustet, har vi fundet ud af, især når de er blevet oppustet med ubrugelige data.
Nu til, hvordan man retter bloat:
- Hvis vi har en lille tabel og gode drev, det vil sige, at for en tabel på op til en gigabyte, kan VACUUM FULL bruges. Den vil tage en eksklusiv lås på tabellen i et par sekunder, men til gengæld gør den det hurtigt og effektivt. Hvad gør VACUUM FULL? Den tager en eksklusiv lås på tabellen og kopierer de levende rækker fra gamle tabeller til en ny tabel. Og til sidst bytter den dem om. De gamle filer slettes, nye erstatter de gamle. Men under sin arbejdsproces tager den en eksklusiv lås på tabellen. Dette betyder, at du ikke kan gøre noget med denne tabel: hverken skrive til, læse fra eller modificere den. Og VACUUM FULL kræver ekstra plads på disken for at skrive dataene.
- Det næste værktøj . I princippet minder det meget om VACUUM FULL, fordi det også omskriver data fra gamle filer til nye og udskifter dem i tabellen. Men i begyndelsen tager det ikke en eksklusiv lås på tabellen, men først når det har de nødvendige data klar til at udskifte filerne. Kravene til diskressourcer er de samme som ved VACUUM FULL. Du har brug for ekstra plads på disken, og det kan være kritisk, hvis du har terabyte store tabeller. Og det er også ret krævende for processoren, fordi det arbejder aktivt med input/output.
- Det tredje værktøj er Den er mere skånsom mod ressourcerne, fordi den arbejder lidt ud fra andre principper. Hovedideen med pgcompacttable er, at den med opdateringer i tabellen flytter alle aktive rækker til begyndelsen af tabellen. Derefter kører den vacuum på denne tabel, fordi vi ved, at vi har de aktive i starten og de døde i slutningen. Vacuumet skærer så selv den hale af, så det kræver ikke meget ekstra diskplads. Og samtidig kan det også optimeres i forhold til ressourcerne.
Med værktøjerne er alt i orden.
Hvis emnet med bloat virker interessant for dig i forhold til at grave dybere, så her er nogle nyttige links:
- – det er en præsentation af min kollega. Den er generel omkring, hvor pladsen går hen i Postgres under dens drift og liv. Og der er en meget stor og detaljeret teknisk sektion for databaseadministratorer om bloat.
- – det er et link til vores repository, hvor vi gemmer en masse nyttige scripts til at tjekke databasens tilstand. Her kan du finde scripts til at finde bloat.
- og links til værktøjer, der kan hjælpe dig med at optimere tabeller.
- – det er et indlæg fra min kollega. Der forklarer han bloat ganske grundigt og teknisk, især på et niveau tættere på administratorerne.
Jeg har her forsøgt at vise skræmmebilleder for udviklerne, fordi de er vores direkte kunder af databaserne og skal forstå, hvilke handlinger fører til hvad. Jeg håber, jeg har lykkedes med det. Tak for opmærksomheden!
Spørgsmål
Tak for præsentationen! Du talte om, hvordan man kan identificere problemer. Men hvordan kan man forebygge dem? Jeg havde en situation, hvor forespørgsler hængte, ikke kun fordi de henvendte sig til eksterne tjenester. Det var simpelthen nogle vilde joins. Der var nogle små, harmløse forespørgsler, der hang i et døgn, og derefter begyndte at lave noget skørt. Det ligner meget det, du beskriver. Hvordan kan man holde øje med det? Skal man sidde og konstant kigge på, hvilken forespørgsel der hænger? Hvordan kan man forebygge det?
I dette tilfælde er det en opgave for administratorerne i jeres virksomhed, ikke nødvendigvis for DBA'er.
Jeg er administrator.
I PostgreSQL er der en visning kaldet pg_stat_activity, hvor hængende forespørgsler vises. Og du kan se, hvor længe den har hængt der.
Skal jeg tjekke hver 5. minut?
Sæt cron op og kontroller. Hvis du har en langvarig forespørgsel, så skriv en e-mail, og det er det. Det vil sige, at du ikke behøver at holde øje med det, det kan automatiseres. Du får en e-mail, og du reagerer på den. Eller du kan skyde den af automatisk.
Er der klare grunde til, at dette sker?
Jeg har nævnt nogle. Andre er mere komplekse eksempler. Og der kan være en lang samtale.
Tak for rapporten! Jeg ville gerne præcisere noget om værktøjet pg_repack. Hvis det ikke laver en eksklusiv lås, så…
Det laver en eksklusiv lås.
… så kan jeg potentielt miste data. Må mit program ikke skrive noget i mellemtiden?
Nej, det fungerer fint med tabellen, det vil sige, at pg_repack først overfører alle de levende rækker, der findes. Naturligvis sker der et eller andet skrivning til tabellen. Det er bare det sidste stykke, der tilføjes.
Det vil sige, at det gør det til sidst?
Til sidst tager det en eksklusiv lås for at bytte de filer om.
Bliver det hurtigere end VACUUM FULL?
VACUUM FULL, så snart det starter, tager straks en eksklusiv lås. Og indtil det er færdigt, slipper det ikke. Men pg_repack tager en eksklusiv lås kun i det øjeblik, hvor filerne udskiftes. På det tidspunkt kan du ikke skrive der, men dataene går ikke tabt, alt vil være i orden.
Hej! Du fortalte om hvordan autovacuum fungerer. Der var et diagram med røde, gule og grønne celler til optagelse. Det vil sige, at de gule er blevet markeret som slettet. Og som følge deraf kan man skrive noget nyt i dem?
Ja. Postgres sletter ikke rækker. Det er dens særlige karakteristika. Hvis vi opdaterer en række, markerer vi den gamle som slettet. Der sættes en transaktions-id, der ændrede denne række, og vi skriver den nye række. Og vi har sessioner, der potentielt kan læse dem. På et tidspunkt bliver de meget gamle. Og essensen af autovacuumets arbejde er, at det går igennem disse rækker og markerer dem som unødvendige. Og man kan overskrive data der.
Jeg forstår. Men spørgsmålet handler lidt om noget andet. Jeg nåede ikke at sige det. Antag, at vi har en tabel. Der er felter med variabel størrelse. Og hvis jeg forsøger at indsætte noget nyt, så kan det simpelthen ikke være plads i den gamle celle.
Nej, hele linjen opdateres i hvert fald. I Postgres er der to datalagringsmodeller. Den vælges ud fra datatypen. Nogle data gemmes direkte i tabellen, mens der også er tos-data. Det er store datamængder: tekst, json. De gemmes i separate tabeller. Og for disse tabeller sker der det samme med bloat, dvs. alt er det samme. Bare de er adskilt.
Tak for præsentationen! Hvor acceptabelt er det at bruge statement timeout for at begrænse varigheden af forespørgsler?
Meget acceptabelt. Vi bruger det overalt. Da vi ikke har vores egne tjenester, men yder fjernsupport, har vi ganske forskellige kunder. Og alle er ret tilfredse med dette. Dvs. vi har opgaver i cron, der tjekker. Det aftales blot med kunden, hvor længe sessionerne skal vare, før vi afbryder. Det kan være et minut, det kan være 10 minutter. Det afhænger af belastningen på databasen og dens formål. Men vi bruger pg_stat_activity hos alle.
Tak for præsentationen! Jeg prøver at tilpasse din præsentation til mine applikationer. Og det ser ud til, at vi altid starter en transaktion, og altid afslutter den eksplicit. Hvis der opstår en exception, bliver der stadig udført rollback. Og her tænkte jeg på det. Det er muligt, at transaktionen kan starte uden at være eksplicit. Det er en anmodning til pigen, tror jeg. Hvis jeg blot opdaterer en post, vil transaktionen starte i PostgreSQL og afsluttes først, når forbindelsen afbrydes?
Hvis du taler om applikationsniveauet, så afhænger det af den driver, du bruger, og den ORM, der anvendes. Der er mange indstillinger. Hvis auto commit er aktiveret, så starter transaktionen og afsluttes med det samme.
Dvs. den afsluttes lige efter opdateringen?
Det afhænger af indstillingerne. En indstilling har jeg nævnt. Det er auto commit on. Den er ret udbredt. Hvis den er aktiveret, åbnes og lukkes transaktionen. Hvis du ikke eksplicit har sagt "start transaction" og "end transaction", men blot har startet en forespørgsel i sessionen.
Hej! Tak for præsentationen! Lad os forestille os, at vi har en database, som vokser og vokser, og pludselig slipper der plads på serveren. Er der nogle værktøjer til at rette op på denne situation?
Pladsen på serveren bør ideelt set overvåges.
For eksempel, hvis DBA'en er gået for at drikke te, eller var på ferie osv.
Når et filsystem oprettes, bliver der i det mindste oprettet noget reserveret plads, hvor data ikke skrives.
Og hvis det helt skal ned til nul?
Det kaldes faktisk reserved space, dvs. det kan frigøres afhængigt af hvor stort det er blevet oprettet, og så har du lidt frit plads. Som standard ved jeg ikke, hvor meget der er der. I et andet tilfælde skal man levere diske, så du har plads til at udføre en genoprettelsesoperation. Man kan slette en tabel, som du garanteret ikke har brug for.
Er der ingen andre værktøjer?
Det er altid manuelt arbejde. Og på stedet findes der en vurdering af, hvad man bedst kan gøre, fordi der er kritiske og ikke-kritiske data. Og for hver database og det program, der arbejder med det, afhænger det af forretningen. Det besluttes altid på stedet.
Tak for præsentationen! Jeg har to spørgsmål. For det første viste du dias, hvor det blev demonstreret, at i tilfælde af hængende transaktioner stiger både størrelsen af tabelrummet og størrelsen af indekset. Og længere fremme i præsentationen var der en hel del værktøjer, der pakker tabellen. Hvad med indekset?
De pakker dem også.
Men vakuum påvirker ikke indekset?
Nogle arbejder med indekset. For eksempel pg_rapack, pgcompacttable. Vakuum genskaber indekserne, det påvirker dem. Hovedideen med VACUUM FULL er at omskrive alt, dvs. det arbejder med alt.
Og det andet spørgsmål. Jeg forstod ikke, hvorfor rapporter på replikaer så meget afhænger af selve replikationen. Jeg troede, at rapporter var læsning, mens replikation var skrivning.
Hvor opstår konflikten i replikationen? Vi har en Master, hvor processerne finder sted. Der er en autovakuum. Hvad gør autovakuum i praksis? Det fjerner nogle gamle rækker. Hvis vi på det tidspunkt har en forespørgsel på replikaen, der læser disse gamle rækker, og på Masteren er der sket en situation, hvor autovakuum har markeret disse rækker som mulige til overskrivning, så overskriver vi dem. Og så kommer der et datapakke, når vi skal overskrive de rækker, der er nødvendige for forespørgslen på replikaen, vil replikationsprocessen vente på den timeout, som du har indstillet. Og så vil PostgreSQL afgøre, hvad der er vigtigere for det. Og replikation er vigtigere for det end forespørgslen, så det vil give slip på forespørgslen for at udføre disse ændringer på replikaen.
André, jeg har et spørgsmål. Er disse fantastiske grafer, som du viste under præsentationen, resultatet af et eller andet værktøj, du har lavet? Hvilket program blev brugt til at lave graferne?
Det er en tjeneste .
Er dette et kommercielt produkt?
Ja. Dette er et kommercielt produkt.
Kilde: habr.com
