

For ikke så længe siden stødte jeg på en temmelig usædvanlig opgave med at konfigurere routing for MetalLB. Der var ikke noget problem, da MetalLB normalt ikke kræver yderligere handlinger, men i vores tilfælde har vi et ret stort cluster med en ret enkel netværkskonfiguration.
I denne artikel vil jeg fortælle, hvordan du kan konfigurere source-based og policy-based routing for et eksternt netværk i dit cluster.
Jeg vil ikke gå ind i detaljerne omkring installation og opsætning af MetalLB, da jeg forudsætter, at du allerede har en vis erfaring. Lad os springe direkte til sagen, nemlig opsætningen af routing. Så vi har fire tilfælde:
Case 1: Når opsætning ikke er nødvendig
Lad os tage et simpelt tilfælde.
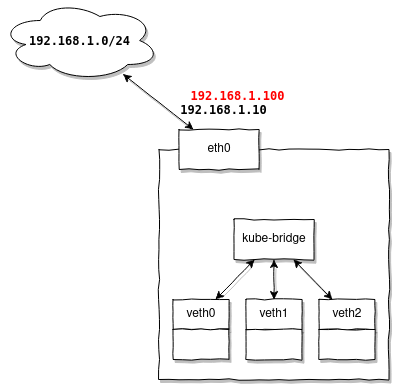
Yderligere routing-konfiguration er ikke nødvendig, når de IP-adresser, som MetalLB tildeler, ligger i samme subnet som dine node-adresser.
For eksempel har du et subnet 192.168.1.0/24, der har en router 192.168.1.1, og dine noder får adresserne: 192.168.1.10-30, så for MetalLB kan du konfigurere et interval 192.168.1.100-120 og være sikker på, at de vil fungere uden nogen yderligere opsætning.
Hvorfor er det sådan? Fordi dine noder allerede har konfigurerede ruter:
# ip route
default via 192.168.1.1 dev eth0 onlink
192.168.1.0/24 dev eth0 proto kernel scope link src 192.168.1.10
Og adresserne fra det samme interval vil genbruge dem uden nogen yderligere tiltag.
Case 2: Når der kræves yderligere opsætning
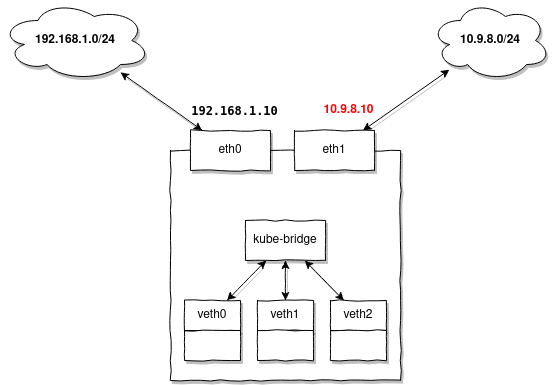
Du skal konfigurere yderligere ruter hver gang dine noder ikke har en konfigureret IP-adresser eller rute til subnettet, som MetalLB tildeler adresser til.
Lad mig forklare lidt nærmere. Hver gang MetalLB tildeler en adresse, kan det sammenlignes med en simpel tildeling:
ip addr add 10.9.8.7/32 dev loBemærk, at:
- a) Adressen tildeles med en præfiks,
/32som betyder, at ruten til subnettet automatisk ikke tilføjes (det er bare en adresse). - b) Adressen knyttes til hvilken som helst node-interface (f.eks. loopback). Her skal det nævnes, at det er en særlig egenskab ved Linux-netværksstakken. Uanset hvilket interface du tilføjer adressen til, vil kernen altid håndtere arp-forespørgsler og sende arp-svar tilbage til hvilket som helst af dem; denne opførsel anses for korrekt og er desuden ganske almindelig i et dynamisk miljø som Kubernetes.
Denne opførsel kan konfigureres ved f.eks. at aktivere strict arp:
echo 1 > /proc/sys/net/ipv4/conf/all/arp_ignore
echo 2 > /proc/sys/net/ipv4/conf/all/arp_announce
I dette tilfælde vil arp-svar kun blive sendt, hvis interfacet tydeligt indeholder en specifik IP-adresse. Denne indstilling er obligatorisk, hvis du planlægger at bruge MetalLB, og din kube-proxy kører i IPVS-tilstand.
MetalLB bruger dog ikke kernen til at håndtere arp-anmodninger, men gør det selv i user-space, så denne mulighed vil ikke påvirke MetalLB's funktion.
Lad os vende tilbage til vores opgave. Hvis der ikke eksisterer nogen rute for de udleverede adresser på dine noder, skal du tilføje den på forhånd til alle noder:
ip route add 10.9.8.0/24 dev eth1Sagsnummer 3: Når source-based routing er nødvendig
Source-based routing skal du konfigurere, når du modtager pakker via en separat gateway, som ikke er den, der er indstillet som standard, og derfor skal de svarende pakker også sendes via denne samme gateway.
For eksempel har du stadig den samme subnet 192.168.1.0/24 dedikeret til dine noder, men du ønsker at udlevere eksterne adresser ved hjælp af MetalLB. Antag, at du har flere adresser fra subnettet 1.2.3.0/24 der findes i VLAN 100, og du vil bruge dem til at få adgang til Kubernetes-tjenester udefra.
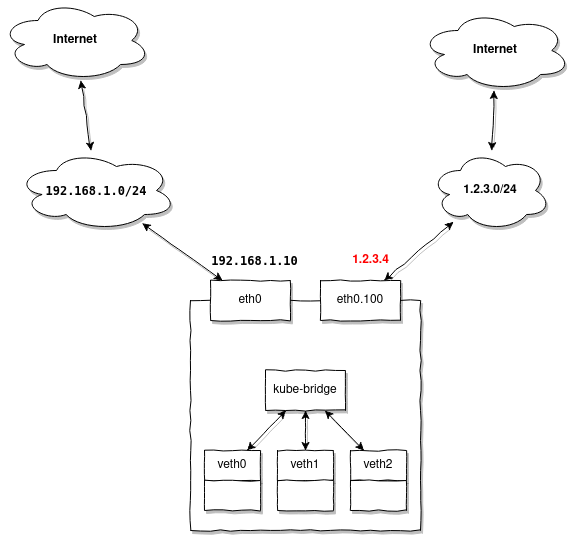
Når du ringer til 1.2.3.4 vil du sende anmodninger fra et andet subnet end 1.2.3.0/24 og forvente et svar. Den node, der i øjeblikket er master for den udleverede MetalLB-adresse 1.2.3.4, vil modtage pakken fra routeren 1.2.3.1, men svaret til den skal nødvendigvis sendes samme vej, gennem 1.2.3.1.
Da vores node allerede har en konfigureret default gateway 192.168.1.1, vil svaret som standard gå til den, og ikke til 1.2.3.1, gennem hvilken vi modtog pakken.
Hvordan håndterer vi denne situation?
I dette tilfælde skal du forberede alle dine noder, så de er klar til at betjene eksterne adresser uden yderligere konfiguration. Det vil sige, at du i det ovennævnte eksempel skal oprette en VLAN-interface på noden på forhånd:
ip link add link eth0 name eth0.100 type vlan id 100
ip link set eth0.100 up
Og så tilføje ruter:
ip route add 1.2.3.0/24 dev eth0.100 table 100
ip route add default via 1.2.3.1 table 100
Bemærk, at vi tilføjer ruter til en separat routetabel 100 den vil kun indeholde de to ruter, der er nødvendige for at sende svaret gennem gatewayen 1.2.3.1, der findes bag interfacet eth0.100.
Nu skal vi tilføje en simpel regel:
ip rule add from 1.2.3.0/24 lookup 100som tydeligt siger: hvis kildens IP-adresse for pakken findes i 1.2.3.0/24, skal routetabellen bruges 100. I den har vi allerede beskrevet en rute, der sender den gennem 1.2.3.1
Case 4: Når policy-baseret routing er nødvendig
Netværkstopologien er som i det foregående eksempel, men lad os antage, at du også vil have muligheden for at henvende dig til eksterne adresser i puljen 1.2.3.0/24 fra dine pods:
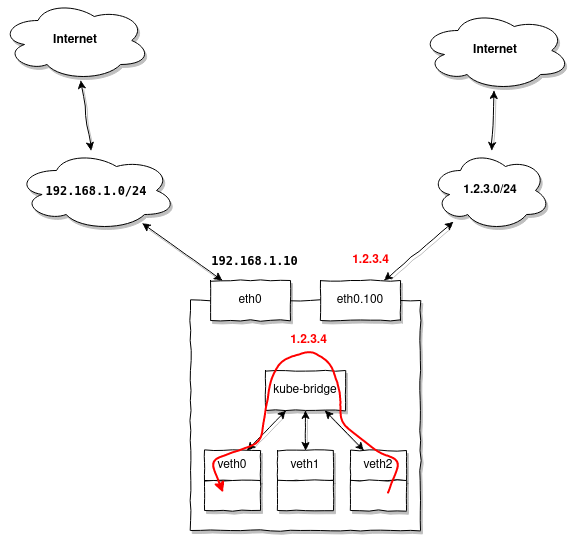
Funktionen ligger i, at når man adresserer en hvilken som helst adresse i 1.2.3.0/24, vil det svarende pakke, når det når noden og har en kildeadresse i intervallet 1.2.3.0/24 , blive sendt i overensstemmelse med eth0.100, men vi vil have, at Kubernetes omdirigerer det til vores første pod, som genererede den oprindelige anmodning.
Det viste sig at være vanskeligt at løse dette problem, men det blev muligt takket være policy-baseret routing:
For bedre at forstå processen vil jeg give et blokdiagram af netfilter:
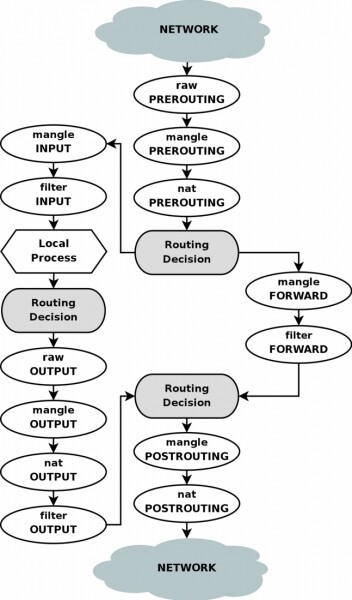
For at starte, som i det foregående eksempel, lad os oprette en yderligere routingtabel:
ip route add 1.2.3.0/24 dev eth0.100 table 100
ip route add default via 1.2.3.1 table 100
Nu skal vi tilføje et par regler i iptables:
iptables -t mangle -A PREROUTING -i eth0.100 -j CONNMARK --set-mark 0x100
iptables -t mangle -A PREROUTING -j CONNMARK --restore-mark
iptables -t mangle -A PREROUTING -m mark ! --mark 0 -j RETURN
iptables -t mangle -A POSTROUTING -j CONNMARK --save-mark
Disse regler vil mærke indgående forbindelser på interfacet eth0.100, idet alle pakker får et tag 0x100, dette samme tag vil også blive brugt til svarene inden for en enkelt forbindelse.
Nu kan vi tilføje en routingregel:
ip rule add from 1.2.3.0/24 fwmark 0x100 lookup 100Det vil sige, at alle pakker med en kildeadresse 1.2.3.0/24 og tag 0x100 skal ruttes ved brug af tabellen 100.
Dermed vil andre pakker, der modtages på en anden grænseflade, ikke falde ind under denne regel, hvilket vil gøre det muligt for dem at blive rutet ved hjælp af de standardværktøjer, som Kubernetes tilbyder.
Der er dog en anden ting; i Linux findes der såkaldt reverse path filter, som ødelægger alt ved at udføre en simpel kontrol: For alle indgående pakker ændrer den kildeadressen til afsenderens adresse og tjekker, om pakken kan sendes tilbage via den samme grænseflade, som den blev modtaget på; hvis ikke, så filtreres den fra.
Problemet er, at i vores tilfælde vil det fungere forkert, men vi kan deaktivere det:
echo 0 > /proc/sys/net/ipv4/conf/all/rp_filter
echo 0 > /proc/sys/net/ipv4/conf/eth0.100/rp_filter
Bemærk, at det første kommando styrer den globale adfærd af rp_filter; hvis det ikke deaktiveres, vil den anden kommando ikke have nogen effekt. Ikke desto mindre forbliver de øvrige grænseflader aktiveret med rp_filter.
For ikke at begrænse filterets funktionalitet fuldstændigt kan vi anvende implementeringen af rp_filter til netfilter. Ved at bruge rpfilter som en iptables-modul kan der opsættes ret fleksible regler, for eksempel:
iptables -t raw -A PREROUTING -i eth0.100 -d 1.2.3.0/24 -j RETURN
iptables -t raw -A PREROUTING -i eth0.100 -m rpfilter --invert -j DROP
aktiverer rp_filter på interfacing eth0.100 for alle adresser undtagen 1.2.3.0/24.
Kilde: habr.com
