

Jeg hedder Yuriy, jeg er leder af systemadministrationsgruppen hos Citymobil. I dag vil jeg dele erfaringer med teknologien for tynd provisionering (thin provisioning) af Linux-filsystemer og fortælle, hvordan den kan anvendes i virksomhedens CI/CD-processer. Vi vil gennemgå en situation, hvor vi hurtigst muligt har brug for MySQL-databasekopier, der er så tæt som muligt på "produktion"-versionen, og som er tilgængelige til læsning og skrivning.
Introduktion: Hvorfor give dårlige råd?
Et logisk spørgsmål, for der findes velafprøvede mekanismer til migrering af DB-schemas til testmiljøer. Hvorfor overhovedet lade den primære, ikke-shardede DB vokse til sådanne dimensioner? Og for testning er ikke alle data nødvendige. Jeg vil forsøge at forklare.
For cirka et år siden, midt i den aktive vækst af vores tax aggregator (i 2018 voksede vi omtrent 15 gange i afsluttede ture), voksede datamængden, belastningen på serverne og frekvensen af udrulninger. Vi befandt os i følgende situation:
- Den primære MySQL-database voksede til omkring 1000 tabeller med en samlet størrelse på 2,5 TB og fortsatte med at vokse.
- Der var ikke mulighed for hurtigt at shard'e og sprede databasen. Den gamle tilgang med "jeg skriver i databasen, hvad jeg vil, og som jeg vil" samt mange JOINs og interne tabelafhængigheder tillod ikke dette.
- Der var ikke nogen mekanisme til at migrere DB-schemaet til testmiljøer.
- Der var ikke automatisk tests af koden ved udrulning til produktion.
Den sidste problemstilling ønskede vi at løse så hurtigt som muligt. Der var allerede skrevet Postman-tests for at tjekke den primære PHP-mono, men en aktuel database manglede. Vi kunne ikke skabe en replik om natten, gøre den til master og give den til rådighed om dagen: et meget stort antal udrulninger og ændringer, både i dataene og i DB-schemat, ville gøre standen ugyldig allerede ved middagstid. Og at begrænse udrulninger til kun arbejdsdage ville være ineffektivt.
Alligevel blev opgaven løst: den første fungerende stand fik vi allerede efter to uger. I det forløbne år har den undergået mange ændringer og bliver stadig brugt.
Herefter vil jeg detaljeret beskrive alle trin og faser af udviklingen af vores løsning. Du vil se, at denne metode fortjener at eksistere.
Hvad er "tynd provisionering"?
Det er en hardware- eller softwareteknologi (også kendt som sparse volumes), der gør det muligt at allokere flere krævede ressourcer, end der faktisk er tilgængelige. Den allokerede kapacitet skal opfylde kriterierne just-enough (så meget som nødvendigt) og just-in-time (i den nødvendige tid). Primært anvendes thin provisioning i forskellige SAN-løsninger for at tilbyde diskplads i nødvendige mængder, der overstiger den faktiske tilgængelighed. Teknologien understøttes af forskellige filsystemer, som f.eks. LVM2, ZFS, BTRFS. Den bruges bredt i virtualiseringshypervisorer. Thin provisioning gjorde det muligt for os hurtigt at skabe så mange kopier af hovedpartitionen med data (data-mappen for MySQL-databasen) som vi havde brug for, direkte fra snapshots.
Første stand, Thin LVM-teknologi
Dette kapitel kan også kaldes "Sådan laver du maksimal hurtige snapshots af store datamængder ved hjælp af ", hvilket reducerer stabiliteten af filsystemet og MySQL-databasen til urimelige niveauer."
Da vi allerede havde brugt LVM til at oprette hovedpartitionerne til OS, besluttede vi at starte netop med det. Først havde vi brug for en separat fysisk maskine — en kopi af vores hoved-MySQL-database, hvor vi kunne oprette snapshots af replikaen efter behov og køre den ved siden af en separat MySQL-instans. I testperioden tillod vi at udføre ændrende operationer på denne instans, og når testene var afsluttet, blev den med succes slettet. Serverkonfigurationen var som følger:
- 2 x Intel Silver 4114 (10×2,2 GHz HT)
- 8 x 32 GB DDR4
- 8 x 1920 GB Intel SSD i Adaptec RAID-controller i RAID-10
Emnet om valget mellem RAID-controller og software-RAID MD kunne fylde en egen artikel. Jeg vil kun sige, at vores valg blev påvirket af to faktorer:
- På det tidspunkt, hvor opgaven blev stillet, installerede vi alle databaser på RAID-controllere, så man kan sige, at det er blevet historisk.
- Forskellen i ydeevne ved syntetiske tests af filsystemet og tests med forskellige operationer i MySQL var minimal.
Vi har opdelt den resulterende RAID-10: vi har lavet en samlet Volume Group (VG) på hele kapaciteten (med overhead på cirka 6,7 GB) og oprettet et logisk volumen (Logical Volume, LV) til systemet på 50 GB. Under normale omstændigheder ville vi tildele resten af pladserne til MySQL-partitionen. Men vi havde brug for fleksibel backup, så vi oprettede først en såkaldt pool, inden vi oprettede en partition til /var/lib/mysql på 3,5 TB (baseret på de forventede database størrelser):
lvcreate -l 100%FREE -T vga/thin
lvcreate -V 3.5T -T vga/thin -n mysql
Vi formaterede partitionen til ext4, monterede den, indspillede en kopi og fik det oprindelige miljø. Derefter lavede vi et API, der skal oprette snapshots, starte en MySQL-databaseinstans på den angivne port og slette den oprettede instans. Da der kun anvendes systemopkald, valgte vi at skrive scriptet i almindelig bash, og som API-forbindelse HTTP → bash implementerede vi en open source-løsning , skrevet i Go.
En dag vil vi give vores bash-scripts til open source, men indtil da vil jeg blot beskrive den grundlæggende algoritme:
Oprettelse af det primære snapshot snapmain:
- Vi stopper den primære kopi.
- Vi sætter lås på operationer med snapshot snapmain.
- Vi opretter et nyt snapshot snapmain.
- Vi starter MySQL og fjerner låsen.
Oprettelse af en database på en vilkårlig port fra snapmain:
- Vi sætter lås på den specifikke databaseinstans (port).
- Vi kontrollerer, om der er en lås til oprettelsen af det primære snapshot. Hvis det er tilfældet, venter vi og tjekker igen hvert 5. sekund.
- Vi tjekker, om der er et gammelt LV-volumen til instansen.
3.1 Hvis der er, stopper vi MySQL-instansen med kill -9 og sletter LV-volumenet. - Vi opretter en ny instans fra snapmain.
- Vi forbereder og monterer mapperne til denne instans.
- Vi fjerner tegn på slaver (filer) og starter MySQL-instansen.
- Vi gør den til master.
- Vi fjerner låsen.
Sletning af databasen på en vilkårlig port:
- Vi sætter lås på den specifikke databaseinstans (port).
- Vi dræber MySQL-instansen med kill -9.
- Vi afmonterer mapperne.
- Vi sletter LV-volumen og fjerner låsen.
Eksempelkommandoer til kloning af partitioner til den nye databaseinstans:
lvcreate -n stage_3307 -s vga/snapmain
lvchange -ay -K vga/stage_3307
mount -o noatime,nodiratime,data=writeback /dev/mapper/vga-stage_3307 /mnt/stage_3307
Lad os nu tale om det primære problem, vi stødte på ved brug af thin provisioning. Vi ramte ydeevnegrænsen på SSD-diske. Dette skete på grund af egenskaberne ved Thin LVM: det fungerer grundlæggende på en lavere enhedsniveau med chunks, der som standard er 4 MB store. Sådan så det ud:
- Vi opretter et snapshot fra hovedpartitionen /var/lib/mysql.
- Vi starter replikationen for at indhente masteren.
- Enhver ændring i tabellerne på replikationen tvinger os til at gemme gamle, uændrede datachunks i snapshot-partitionen.
- Enhver ændring i den oprettede testinstans tvinger os til at gemme gamle, uændrede datachunks i partitionen af det klonede snapshot for denne instans.
- Vi oplever 100% I/O-belastning på enheden, hvilket medfører, at alle operationer forsinkes, og replikationen står stille.
- Ved dagens udgang har vi et stand, der er forsinket med flere timer.
Sådan kæmpede vi med det for at få et mere rimeligt resultat (hæftninger):
RAID-controller:
- Vi har som standard deaktiveret al form for caching.
- Vi har indstillet writeback (når dataene kommer i cache, afsluttes skrivningen, før den faktiske gemmelse på disk sker).
Filsystem:
- Ved monteringspunktet /var/lib/mysql har vi angivet noatime,nodiratime,data=writeback
- Vi har deaktiveret ext4 logning ved hjælp af tune2fs.
MySQL:
- Vi har angivet innodb_flush_method = O_DSYNC (vi øgede skrivehastigheden og dermed sænkede pålideligheden).
- Vi har deaktiveret logning, da vi ikke har brug for logfiler.
- Vi har angivet innodb_buffer_pool_size = 4G (jo mindre størrelsen på InnoDB-poolen er, jo hurtigere vil MySQL stoppe ved nedlukning, og jo hurtigere kan vi oprette et snapshot).
Dette er langt fra en udtømmende liste, især hvad angår MySQL. Andre ændringer er dog mindre og gælder ofte ikke altid og ikke præcist. For eksempel, i forsøget på at aflaste diske, flyttede vi endda innodb_parallel_doublewrite_path til /dev/shm, hvilket i nogle tilfælde ved opstart af en forkert afsluttet instans sparede os op til 5 sekunder.
Hvorfor stopper vi MySQL, før vi laver et snapshot? Vi kan jo tage et fra den kørende replikation. Det er korrekt, men den nye DB-instans på dette snapshot vil som standard blive betragtet som beskadiget og kræver en fuld scanning ved opstart. At stoppe replikationen er bestemt hurtigere, selvom det i sidste ende er den mest tidskrævende operation i hele processen.
Som resultat har vi fået mere acceptable timings og en klar arbejdsstand. Selvom det, som det fremgår af det mest talende diagram over forsinkelsen af replikationen af hovedreplikatet, stadig er langt fra ideelt:
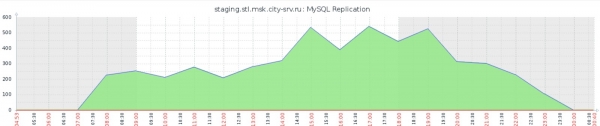
Fra andre ulemper kan nævnes den praktiske umulighed af at overvåge Thin LVM-poolen: Udover systemets standardfunktioner iostat er det umuligt at forstå, hvilken del af poolen der i øjeblikket belaster filsystemet mest.
Det er vigtigt at nævne en stor ulempe ved den ovennævnte optimering: Vi fik en YOLO-stand. Cirka en gang hver måned eller to kunne ext4 ikke holde til sådanne overgreb og brød ned uigenkaldeligt, hvilket krævede omformatering og genindlæsning af replikatet. Selvom vi vandt i hastighed, ødelagde vi håbløst stabiliteten.
Hvilke målinger bør man holde øje med under drift af Thin LVM:
- Thin pool data %
- Thin pool metadata %
Hvis vores stand kan overleve, at der ikke er mere plads til data (det er nok at rydde op på diskene), vil manglende plads til metadata føre til en komplet sammenbrud af poolen og behovet for at oprette den fra bunden.
Filsystemet inden for poolen fragmenteres meget over tid. Jeg anbefaler at køre kommandoen fstrim -v /var/lib/mysql.
Mellemsummer:
- Teknologien er let at anvende, ligesom selve LVM, og kræver ikke særlig kvalifikation af ingeniøren.
- Den vil være velegnet til små databaser, der ikke er for belastede. Jo mindre databasen er, jo færre chunks bevæger sig gennem filsystemet i poolen, og jo lavere belastning på diskene.
- Til vores opgave begyndte vi at søge efter alternative løsninger, som vil blive diskuteret i næste afsnit.
Den anden stand, teknologien ZFS
For a long time, I dealt with the ZFS file system, but back then ZFS operated well only on its native OS family, Solaris. There was a ported version on FreeBSD that had a decent level of implementation. There was also an unfinished port for Linux that few used. Due to the B-tree data storage structure (which, by the way, is the same structure used by InnoDB MySQL), ZFS performed poorly in installations with a very large number of files. All this, combined with the need to learn the technical details before using it, removed this file system from my practice for a long time. Then ext4 and xfs emerged, which became the standard. However, considering that ZFS is more than suitable for our task, and judging by reviews, the Linux version has grown into a quite reasonable product (although not fully supported, which is why setting up a system on ZFS from scratch can only be done with various tricks), we decided to give it a try.
For obvious reasons, we chose a stand with a similar configuration (except for the RAID controller). We installed eight SSDs of 1920 GB each. There was no desire to write our own network image to upload the server to bare ZFS, so we took 50 GB from each disk and created an MD RAID-10 for the system. The remaining 1950 GB on each disk were combined into a ZFS equivalent of RAID-10:
zpool create zpool mirror /dev/sda2 /dev/sdb2 mirror /dev/sdc2 /dev/sdd2 mirror /dev/sde2 /dev/sdf2 mirror /dev/sdg2 /dev/sdh2We created partitions for MySQL:
zfs create zpool/mysql
zfs set compression=gzip zpool/mysql
zfs set recordsize=128k zpool/mysql
zfs set atime=off zpool/mysql
zfs create zpool/mysql/data
zfs set recordsize=16k zpool/mysql/data
zfs set primarycache=metadata zpool/mysql/data
zfs set mountpoint=/var/lib/mysql zpool/mysql/data
Note that we enabled the built-in gzip data compression. We have plenty of CPU resources on the server, and they are not fully utilized. As a result, 3 TB of our database turned into 1.6 TB, and since the weakest link, as before, is the maximum disk performance, the less data there is — the better. From the very start, we get a great bonus from ZFS! At peak hours, with full load, maintaining gzip consumes up to 4 cores, but we don't mind.
Next, the implementation went faster. We replicated the MySQL settings from the LVM stand. It took some time to rewrite the scripts to ZFS commands, but overall the algorithms remained the same. Here is an example of creating a snapshot:
zfs set snapdir=visible zpool/mysql/data
zfs create zpool/stage_3307
zfs clone zpool/mysql/data@snapmain zpool/stage_3307/data
zfs set mountpoint=/mnt/stage_3307 zpool/stage_3307/data
Fra den ekstra tuning: vi har flyttet ZFS-partitioner med metadata og logs l2arc og zil ind i hukommelsen. For vores opgave var dette, som det viste sig senere, overflødigt, men indtil videre har vi beholdt denne optimering, da det er nemt at ændre det, hvis nødvendigt. De negative effekter — man skal genskabe de relevante hukommelsesområder efter genstart af serveren. Data går ikke tabt. Uddrag af zpool status:
logs
      /dev/shm/zil_slog.img  ONLINE       0     0     0
cache
      /dev/shm/l2arc.img     ONLINE       0     0     0
I denne konfiguration begyndte vi at teste opsætningen og fik fremragende resultater: med to samtidig kørende databaseinstanser (og en aktiv primær replika) på snapshots havde vi en diskbelastning på 50-60 %.
Vi har løst vores primære problem, hvilket fremgår af grafen for replikeringsefterlag (sammenlign med den tidligere graf i afsnittet Thin LVM):
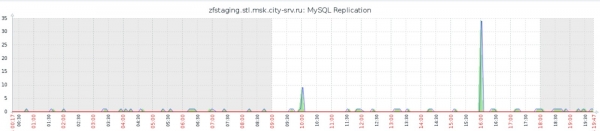
Udover og takket være dette er vi blevet meget hurtigere i alle operationer: oprettelse af et snapshot med stop og genstart af replikationen tager op til 40 sekunder, udrulning af en ny MySQL instans fra et snapshot tager op til 20 sekunder. Dette tilfredsstiller både os og vores kode-tests.
Mellemsummer:
- Resultaterne har fuldt ud tilfredsstillet vores behov for at få en kopi af den operationelle database til test af koden.
- Teknologien kræver forståelse: man skal vide, hvad ZFS er, og hvordan man arbejder med det.
- Vi har ikke tjekket den nuværende status på ZFS med et stort antal (over 1 million) små filer. Men vi antager, at problemet stadig eksisterer, så jeg ville ikke anbefale dette filsystem til nogen filopbevaring.
Hvad nu?
Vi har ikke planlagt at gøre andet med standet; resultatet tilfredsstiller os. Måske vil vi fremover tilføje undtagelser for tabeller, der ikke er nødvendige til testning, i konfigurationen af standets replikation, hvilket yderligere vil reducere størrelsen af databasen. Vi har ikke testet BTRFS-systemet og dets implementering af teknologi til såkaldt “thin provisioning”. Men det er heller ikke længere en opgave, da det primære mål er nået. Generelt ønsker vi naturligvis at bevæge os væk fra den ovenfor beskrevne tilgang — at implementere arbejdsprocesser for database-migrationer til testmiljøet, skabe en separat testkontur for databasen og arbejde med sharding af hoveddatabasen. Meget af dette er vi allerede i gang med at realisere, hvilket vi vil dele i kommende artikler.
Resumé
Den oprindelige opgave blev løst, om end på en utraditionel måde. I de mellemliggende konklusioner blev styrkerne og svaghederne ved hver af de anvendte teknologier beskrevet, så lad os beslutte, hvilken teknologi og hvornår man kan bruge:
- Thin LVM — til små databaser og når man ikke har lyst til eller ikke har tid til at sætte sig ind i ZFS.
- ZFS — hvis der er erfaring med det, eller hvis der er tid til at undersøge det under alle omstændigheder.
På et højere niveau er denne artikel ikke blot en sammenligning af teknologien mellem to filsystemer. Den grundlæggende idé, jeg gerne vil viderebringe og styrke, er, at man ikke skal være bange for at tænke kreativt i situationer, der er kritiske for forretningen, og kun stole på standardløsninger. Engang kunne vi som hele den tekniske afdeling ryste på hovedet og sige, at opgaven med at lave tre terabytes databackup på mindre end et minut ikke kunne lade sig gøre, og vi havde ikke brug for risikable teknologier, lad os gøre det rigtigt. Det var muligt, men vi ville have tabt omkring et halvt til et år og mange kundeprojekter (rejser er vores vigtigste forretningsindikator) uden tests og under implementeringen. Ved at tænke anderledes tabte vi ikke så meget tid på implementeringen, fik erfaringer med nye og glemte gamle teknologier, og kunne levere testningen netop på det tidspunkt, hvor vi nødvendigvis havde brug for det. Uden tvivl har dette haft en positiv indvirkning på alle vores resultater. Valget er altid jeres, og vi vil fortsætte med at fortælle om interessante aktuelle og fremtidige præstationer i vores blog.
Kilde: habr.com
