

Heisenbergs usikkerhedsprincip siger, at man ikke kan måle en objekts position og hastighed samtidig. Hvis et objekt bevæger sig, har det ikke en præcis placering. Og hvis der er en placering – har det ikke nogen hastighed.
Når det kommer til mikrotjenester på Red Hat OpenShift-platformen (under Kubernetes), kan de takket være den rette open source-software rapportere om både deres ydeevne og tilstand samtidig. Dette modsiger ikke Heisenbergs teori, men fjerner usikkerheden i arbejdet med skyapplikationer. Istio gør det let at organisere sporing og overvågning af sådanne applikationer for at holde alt under kontrol.
Lad os definere terminologien
Under sporing (Tracing) forstår vi som logning af systemaktivitet. Det lyder ret generelt, men en af de grundlæggende regler her er, at man skal gemme sporingsdata i den passende opbevaring uden at bekymre sig om deres formatering. Alt arbejdet med at finde og analysere data overlades til forbrugeren. I Istio anvendes sporing systemet Jaeger, som implementerer OpenTracing datamodel.
Spor (Traces, hvor ordet "spor" her bruges i betydningen "fødder", som i ballistisk analyse) kalder vi de data, der fuldt ud beskriver forløbet af en forespørgsel eller en arbejdsenhed, så at sige "fra start til slut". For eksempel alt hvad der sker fra det øjeblik, brugeren trykker en knap på en webside, til dataene returneres, inklusive alle involverede mikrotjenester. Man kan sige, at et spor fuldt ud beskriver (eller modellerer) forløbet af en forespørgsel frem og tilbage. I Jaeger-grænsefladen nedbrydes sporene i komponenter langs tidsaksen, ligesom en kæde kan opdeles i individuelle led. Men i stedet for led består et spor af såkaldte spans.
Span – er intervallet fra begyndelsen af en arbejdsenheds udførelse til dens afslutning. Fortsætter vi analogien, kan vi sige, at hver span repræsenterer et enkelt led i kæden. En span kan have (eller ikke have) en eller flere underordnede spans. Som følge heraf vil den øverste spans (root span) have den samme samlede varighed som det spor, som den tilhører.
Overvågning – det er i grunden selve overvågningen af dit system – med øjnene, gennem UI eller automatiseringsmidler. I bunden af overvågningen ligger sporingsdata. I Istio er overvågning implementeret ved hjælp af Prometheus og har en tilsvarende UI. Prometheus understøtter automatisk overvågning med brug af advarsler Alerts og Alert Managers.
Lader os lave mærker
For at sporingen kan finde sted, skal applikationen oprette en samling af spans. Derefter skal de eksporteres til Jaeger, så Jaeger til sin side kan oprette en visuel repræsentation af sporingen. Blandt andet mærker disse spans navnet på operationen samt tidsstempler for dens start og slutning. Overførslen af spans udføres ved at omdirigere de HTTP-anmodningsoverskrifter, der er beregnet til Jaeger, fra indkommende til udgående anmodninger. Afhængig af det anvendte programmeringssprog kan det kræve mindre ændringer af kildeteksten i applikationerne. Nedenfor er et eksempel på kode i Java (ved brug af Spring Boot-rammen), som tilføjer B3-overskrifter (Zipkin-stil) til din anmodning i Spring-konfigurationsklassen:
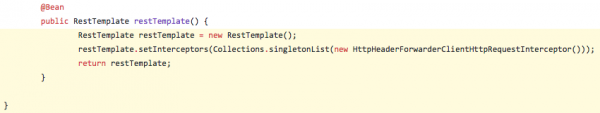
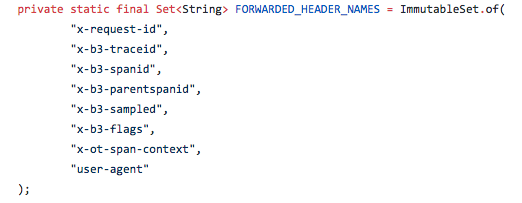
Der anvendes følgende overskriftsindstillinger:
Hvis du bruger Java, behøver du ikke ændre koden, men kan blot tilføje et par linjer i POM-filen Maven og angive miljøvariabler. Her er de linjer, du skal tilføje i POM.XML-filen for at implementere Jaeger Tracer Resolver:
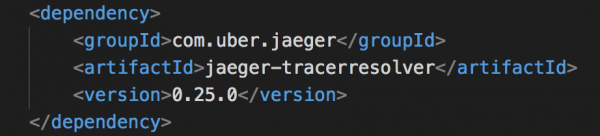
De tilsvarende miljøvariabler angives i Dockerfilen:
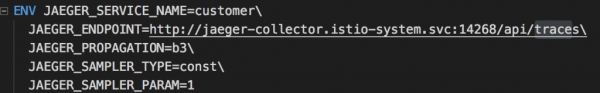
Alt er nu konfigureret, og vores mikrotjenester vil begynde at generere sporingsdata.
Lad os se på det overordnede billede
Istio inkluderer et simpelt kontrolpanel baseret på Grafana. Når alt er konfigureret og fungerer på Red Hat OpenShift PaaS-platformen (i vores eksempel er Red Hat OpenShift og Kubernetes implementeret på minishift), startes dette panel med følgende kommando:
open "$(minishift openshift service grafana -u)\/d\/1\/istio-dashboard?refresh=5⩝Id=1"
Grafana-panelet gør det muligt hurtigt at vurdere systemets ydeevne. Et udsnit af dette panel vises på billedet nedenfor:
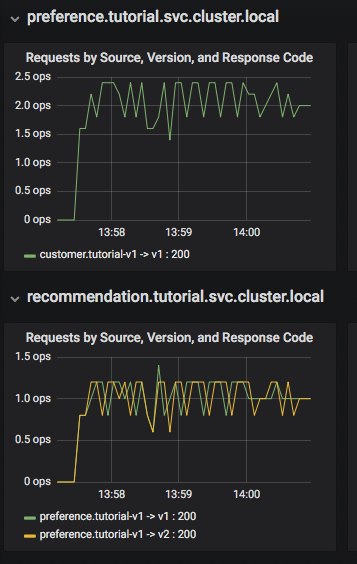
Her kan man se, at microservicen customer kalder microservicen preference v1, som igen kalder microservices recommendation v1 og v2. På Grafana-panelet findes der et Dashboard Row for overordnede metrics, såsom det samlede antal anmodninger (Global Request Volume), andelen af succesfulde anmodninger (success rates), samt 4xx-fejl. Derudover er der en visning af Server Mesh med grafer for hver service og et Services Row for detaljeret visning af oplysninger pr. container for hver service.
Lad os dykke dybere.
Med korrekt konfigureret Istio-tracing kan man, så at sige, direkte ud af boksen dykke ned i systemets ydeevneanalyse. I Jaeger UI kan man gennemse tracing og se, hvor langt og dybt de går, samt visuelt lokalisere flaskehalse i ydeevnen. Når man bruger Red Hat OpenShift på minishift-platformen, udfører man opstart af Jaeger UI med følgende kommando:
minishift openshift service jaeger-query --in-browser
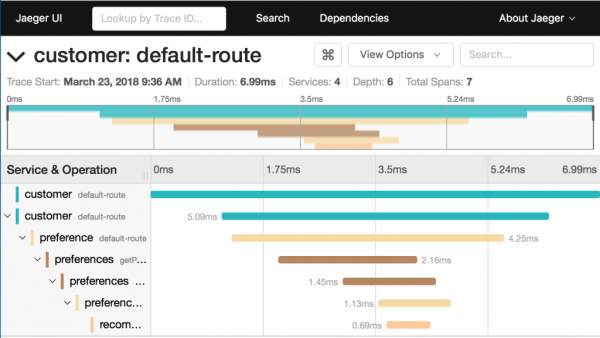
Hvad kan man sige om tracing på dette screenshot:
- Det er opdelt i 7 spans.
- Den samlede udførelsestid er 6,99 ms.
- Microservicen recommendation, som er den sidste i kæden, bruger 0,69 ms.
Diagrammer af denne type gør det muligt hurtigt at få indsigt i situationen, når ydeevnen i hele systemet lider på grund af en enkelt, mindre fungerende service.
Lad os nu komplicere opgaven og starte to instanser af microservicen recommendation:v2 med kommandoen oc scale --replicas=2 deployment/recommendation-v2. Her er, hvad vi har af pods efter dette:
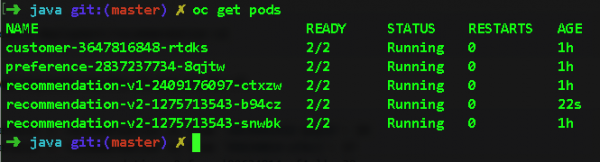
Hvis vi nu skifter tilbage til Jaeger og udvider span for servicen recommendation, vil vi se, hvilken pod anmodningerne rutes til. På den måde kan vi nemt lokalisere flaskehalse på niveauet for en bestemt pod. Man skal se på feltet node_id:
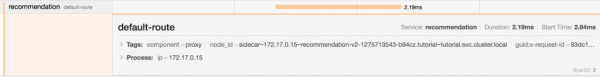
Hvor og hvordan alt bevæger sig.
Nu går vi ind i Prometheus-grænsefladen og ser, som forventet, at anmodningerne mellem anden og første version af servicen recommendation fordeles i forholdet 2:1, strengt efter antallet af aktive pods. Denne graf vil dynamisk ændre sig ved skalering af pods op og ned, hvilket vil være særligt nyttigt ved Canary Deployment (vi vil se nærmere på denne implementeringsmetode næste gang).
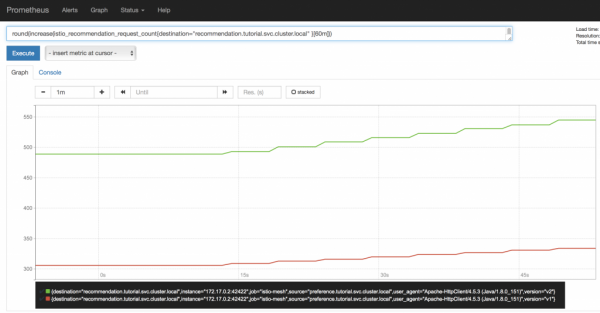
Det er kun begyndelsen.
I virkeligheden har vi i dag kun nævnt en lille del af den værdifulde information om Jaeger, Grafana og Prometheus. Det var egentlig vores mål – at guide jer i den rigtige retning og åbne op for perspektiverne ved Istio.
Og husk, alt dette er allerede indbygget i Istio. Ved brug af bestemte programmeringssprog (f.eks. Java) og rammeværker (f.eks. Spring Boot) kan alt dette implementeres uden at røre selve kodebasen. Ja, koden skal have lidt modifikation, hvis du bruger andre sprog, især Nodejs eller C#. Men da sporbarhed (læs: „tracing“) er et af de obligatoriske krav for at skabe pålidelige cloud-systemer, bliver du nødt til at ændre koden, uanset om du bruger Istio eller ej. Så hvorfor ikke bruge kræfterne mere fordelagtigt?
Bare for at kunne svare på spørgsmålene „hvor?“ og „hvor hurtigt?“ med 100% sikkerhed.
Chaos engineering i Istio: det var hele idéen.
Evnen til at bryde ting hjælper med at sikre, at de ikke bryder.
Softwaretest er ikke kun kompliceret, men også vigtig. Samtidig er test for korrekthed (f.eks. returnerer funktionen det korrekte resultat) én ting, mens test under uhåndterlig netværksforhold er en helt anden opgave (man antager ofte, at netværket altid fungerer uden problemer, og det er den primære af otte misforståelser om distribuerede beregninger). En af udfordringerne ved at løse denne opgave er, hvordan man simulerer fejl i systemet eller indfører dem med vilje ved at udføre såkaldt fault injection. Dette kan gøres ved at ændre selve kildekoden til applikationen. Men så tester du ikke din oprindelige kode, men en version af den, der specifikt simulerer fejl. Som følge heraf risikerer du at falde ind i de fatale omfavnelse af fault injection og støde på geizenbugs – fejl, der forsvinder, når man forsøger at opdage dem.
Og nu vil vi vise, hvordan Istio hjælper med at tackle disse udfordringer nemt.
Hvordan det ser ud, når alt fungerer perfekt.
Lad os overveje følgende scenario: vi har to pods til vores recommendations-mikrotjeneste, som vi har taget fra Istio-leksikonet. Den ene pod er markeret som v1, og den anden som v2. Som vi kan se, fungerer alt fremragende indtil videre:
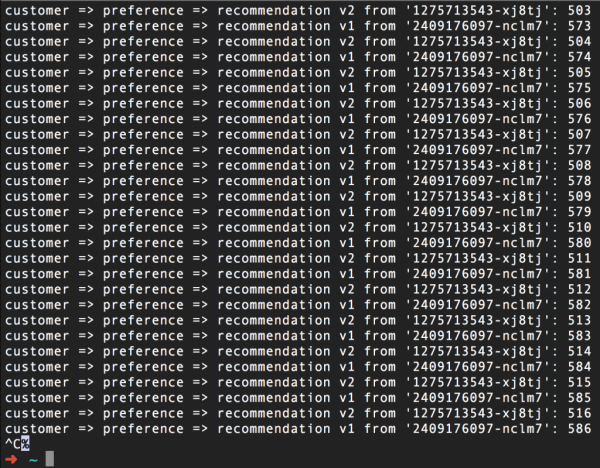
(For resten, tallet til højre er bare en tæller for hver pod.)
Men det er ikke det, vi har brug for, er det? Lad os prøve at bryde det hele uden at røre ved kildekoden.
Lad os forårsage nedbrud i mikrotjenesten
Nedenfor er yaml-filen for routingreglen i Istio, som vil fejle (give en fejl) i halvdelen af tilfældene server 503):
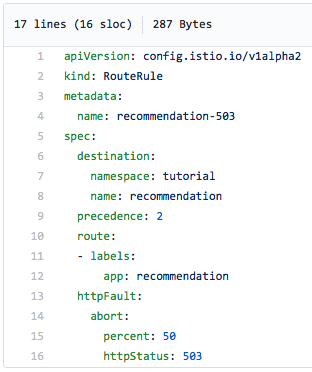
Bemærk, at vi eksplicit angiver, at der skal returneres en fejl 503 i halvdelen af tilfældene.
Her er hvordan skærmbilledet ser ud, når kommandoen curl køres i en loop, efter at vi aktiverer denne regel for at simulere nedbrud. Som vi kan se, returnerer halvdelen af anmodningerne fejl 503, uanset hvilken pod – v1 eller v2 – de sendes til:
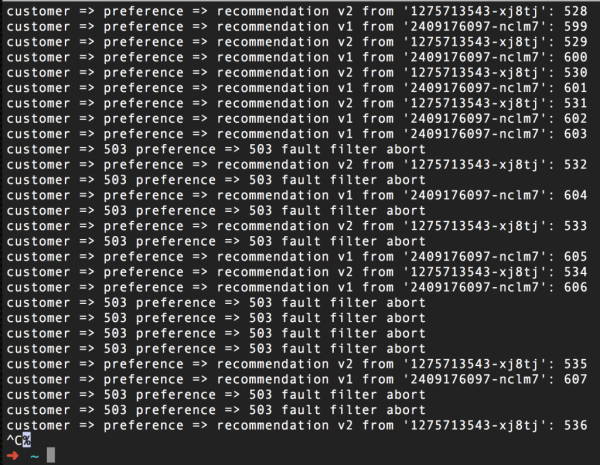
For at genoprette normal drift er det tilstrækkeligt at slette denne regel, i vores tilfælde med kommandoen istioctl delete routerule recommendation-503 -n tutorial. Her er Tutorial navnet på det Red Hat OpenShift-projekt, hvor vores Istio-tutorial kører.
Indfører kunstige forsinkelser
Kunstige fejl 503 hjælper med at teste systemets modstandsdygtighed overfor nedbrud, men evnen til at forudsige og håndtere forsinkelser burde imponere dig endnu mere. I virkeligheden opstår forsinkelser oftere end nedbrud. En langsomt fungerende mikrotjeneste er en gift for hele systemet. Med Istio kan du teste koden, der relaterer sig til håndtering af forsinkelser, uden at ændre den. Først vil vi vise, hvordan man gør dette i tilfælde af kunstigt indførte netværksforsinkelser.
Bemærk, at efter en sådan test, vil du måske have behov for (eller ønske at) forbedre din kode. Den gode nyhed her er, at i så fald vil du handle proaktivt frem for reaktivt. Det er sådan, udviklingscyklus bør bygges: kodning-test-feedback-kodning-test…
Her er hvordan reglen ser ud, der... Men ved du hvad? Istio er så enkelt, og denne yaml-fil er så klar, at alt i dette eksempel taler for sig selv, kig bare:
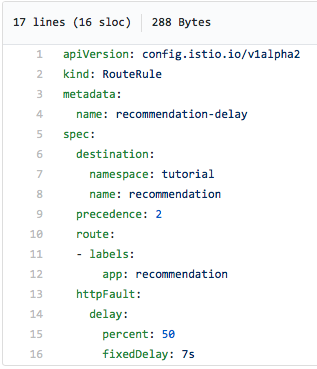
I halvdelen af tilfældene vil vi opleve en 7-sekunders forsinkelse. Og det er slet ikke det samme som at indsætte en sleep-kommando i kildekoden, da Istio reelt forsinker forespørgslen i 7 sekunder. Da Istio understøtter Jaeger-tracing, er denne forsinkelse tydeligt synlig i Jaeger UI, som vist på skærmbilledet nedenfor. Bemærk den lange forespørgsel i øverste højre hjørne af diagrammet – varigheden er 7,02 sekunder:
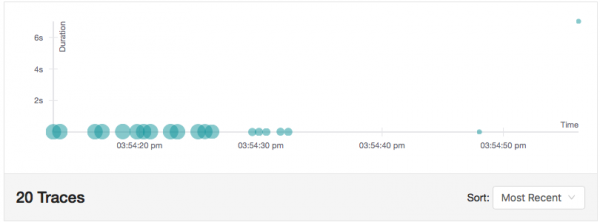
Dette scenarie giver mulighed for at teste koden under netværksforsinkelser. Og det er klart, at hvis vi fjerner denne regel, vil vi fjerne den kunstige forsinkelse. Lad os gentage det, men vi har alligevel gjort alt dette uden at røre ved kildekoden.
Efter ikke at give op
En anden nyttig funktion ved chaos engineering i Istio er muligheden for at gentage anmodninger til tjenesten et bestemt antal gange. Ideen her er at fortsætte med at forsøge, når den første forespørgsel returnerer fejl 503 – og så er det måske i den N-te gang, vi har held. Måske hvilede tjenesten bare lidt af en eller anden grund. Ja, den årsag skal undersøges og udbedres. Men det kan vi tage senere, for nu vil vi forsøge at holde systemet i gang.
Så vi ønsker, at tjenesten indimellem skal returnere en fejl 503, og Istio skal efterfølgende forsøge at oprette forbindelse igen. Her har vi klart brug for en måde at generere fejl 503 uden at røre ved selve koden…
Stop, vent! Det gjorde vi lige.
Denne fil vil få tjenesten recommendation-v2 til at returnere fejl 503 i halvdelen af tilfældene:
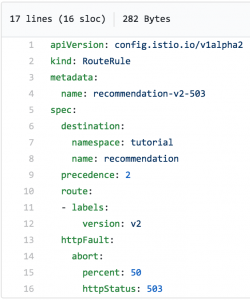
Det er åbenlyst, at nogle anmodninger vil ende med at fejle:
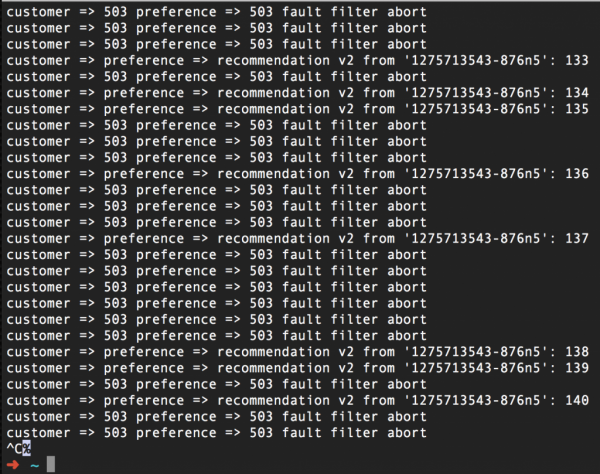
Lad os nu aktivere Istio-funktionen Retry:
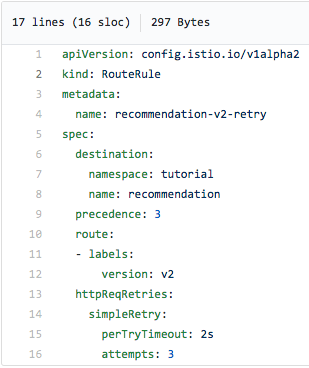
Denne routingregel laver tre forsøg med et interval på to sekunder og bør reducere (og ideelt set helt fjerne fra radar) fejl 503:
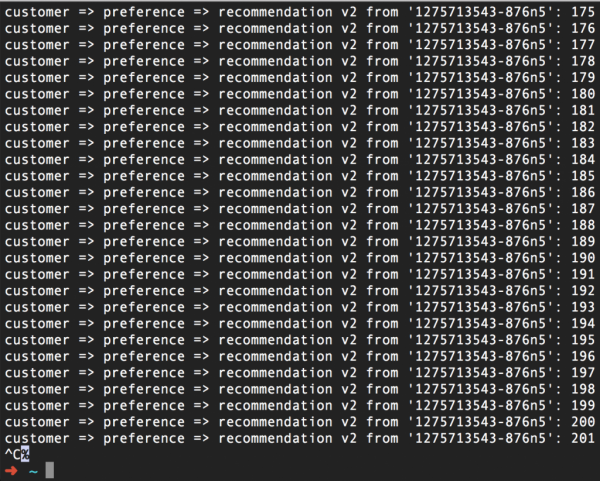
Sammenfattet: vi har fået Istio til dels at generere fejl 503 for halvdelen af anmodningerne. For det andet udfører Istio de tre forsøg på at oprette forbindelse til tjenesten, når der opstår en fejl 503. Som et resultat fungerer alt bare fantastisk. Ved at bruge Retry-funktionen har vi indfriet vores løfte om ikke at give op.
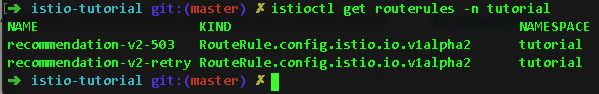
Og ja, vi har igen gjort dette uden at røre ved koden. Alt, hvad vi havde brug for, var to routingregler i Istio:
Hvordan man ikke skuffer brugeren, eller syv venter ikke på en
Og nu vender vi situationen på hovedet og ser på et scenarie, hvor det kun er værd at holde stand i en bestemt tidsperiode. Derefter skal vi bare stoppe med at forsøge at behandle anmodningen for ikke at få alle til at vente på en enkelt bremse-service. Med andre ord, vi vil ikke forsvare den tabte position, men i stedet trække os tilbage til en sikker linje for ikke at skuffe brugeren af hjemmesiden og ikke tvinge dem til at være i uvisshed.
I Istio kan man angive en timeout for udførelsen af anmodningen. Hvis servicen overskrider denne timeout, returneres fejl 504 (Gateway Timeout) – alt dette gøres igen gennem Istios konfiguration. Men vi bliver nødt til at tilføje en sleep-kommando i koden til servicen (og derefter selvfølgelig udføre rebuild og redeploy) for at simulere en langsom servicerespons. Desværre kan vi ikke undgå det.
Så, vi har indsat et tre-sekunders sleep i koden til servicen recommendation v2, bygget det relevante billede, og udført redeploy af containeren, og nu skal vi tilføje en timeout ved hjælp af følgende Istio routingregel:
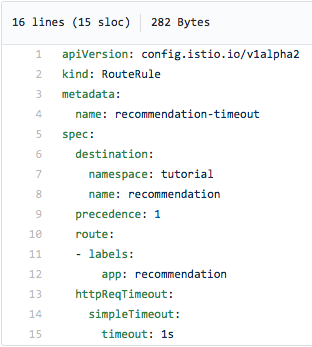
Som vist i skærmbilledet ovenfor, stopper vi med at forsøge at kontakte servicen recommendation, hvis vi ikke får svar inden for et sekund, det vil sige før fejlen 504 opstår. Efter anvendelsen af denne routingregel (og tilføjelsen af et tre-sekunders sleep i koden til servicen recommendation:v2) vil vi få følgende:
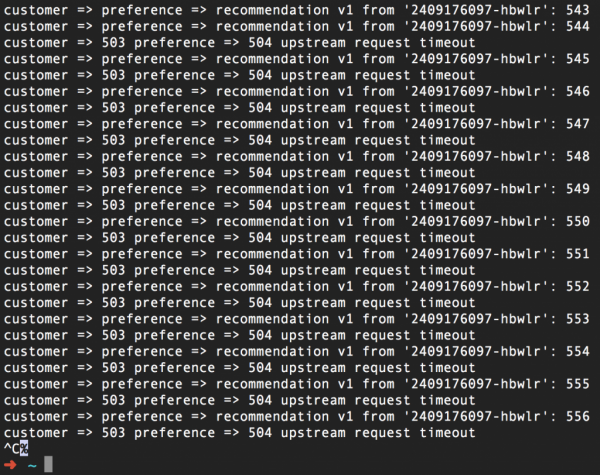
Vi gentager igen, men du kan angive en timeout uden at røre ved koden. Og en ekstra fordel her er, at du nu kan modificere din kode, så den reagerer på timeouten, og let teste disse ændringer med Istio.
Og nu alt sammen
At tilføje lidt kaos via Istio er en fremragende måde at teste din kode og pålideligheden af dit system generelt. Fallback-, bulkhead- og circuit breaker-mønstre, mekanismer til at skabe kunstige fejl og forsinkelser, samt genkaldelser og timeouts vil være meget nyttige ved opbygning af fejltolerante cloud-systemer. I kombination med Kubernetes og Red Hat OpenShift vil disse værktøjer hjælpe med at møde fremtiden med selvtillid.
Kilde: habr.com
