

I vores projekter bruger vi mikroservicearkitektur. Når der opstår flaskehalse i ydeevnen, bruges der ofte meget tid på overvågning og analyse af logfiler. Når man logger tider for specifikke operationer til logfilen, kan det som regel være svært at forstå, hvad der førte til opkald af disse operationer, følge rækkefølgen af handlinger eller tidsforskydningen af en operation i forhold til en anden på tværs af forskellige tjenester.
For at minimere manuelt arbejde besluttede vi at bruge et af trace-værktøjerne. Denne artikel vil diskutere, hvordan og hvorfor man kan bruge tracing, og hvordan vi har gjort det.
Hvilke problemer kan løses med hjælp af tracing
- At finde flaskehalse i ydeevnen både inden for en enkelt tjeneste og i hele udførelsestræet mellem alle involverede tjenester. For eksempel:
- Mange korte sekventielle opkald mellem tjenester, for eksempel til geokodning eller til databasen.
- Lange ventetider for ind- og uddata, for eksempel dataoverførsel over netværket eller læsning fra disk.
- Lang parsing af data.
- Lange operationer, der kræver CPU.
- Kodeområder, der ikke er nødvendige for at opnå det endelige resultat og kan fjernes eller køres forsinket.
- At få en klar forståelse af i hvilken rækkefølge tingene kaldes, og hvad der sker, når en operation udføres.

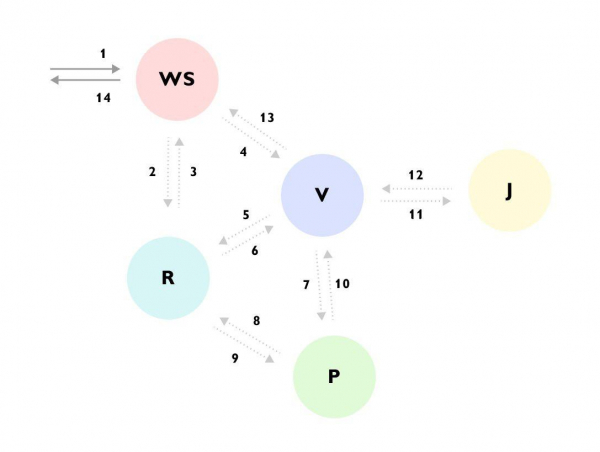
Det fremgår klart, at for eksempel en anmodning kom til tjenesten WS -> tjenesten WS fyldte data via tjenesten R -> derefter sendte den en anmodning til tjenesten V -> tjenesten V hentede mange data fra tjenesten R -> gik til tjenesten P -> tjenesten P gik igen til tjenesten R -> tjenesten V ignorerede resultatet og gik til tjenesten J -> og først derefter returnerede svaret til tjenesten WS, mens den samtidig fortsatte med at beregne noget i baggrunden.
Uden en sådan trace eller detaljeret dokumentation for hele processen er det meget svært at forstå, hvad der sker, ved første øjekast på koden, og koden er desuden spredt ud over forskellige tjenester og skjult bag en masse biner og interfaces. - Indsamling af oplysninger om udførelsestræet til efterfølgende analyse. På hvert trin i udførelsen kan der tilføjes oplysninger til trace, som er tilgængelige på det pågældende trin, og derefter undersøges, hvilke inputdata der førte til et sådant scenarie. For eksempel:
- Bruger-ID
- Rettigheder
- Type af valgt metode
- Log eller udførelsesfejl
- Transformation of traces into a subset of metrics and subsequent analysis in the form of metrics.
What tracing can log. Span
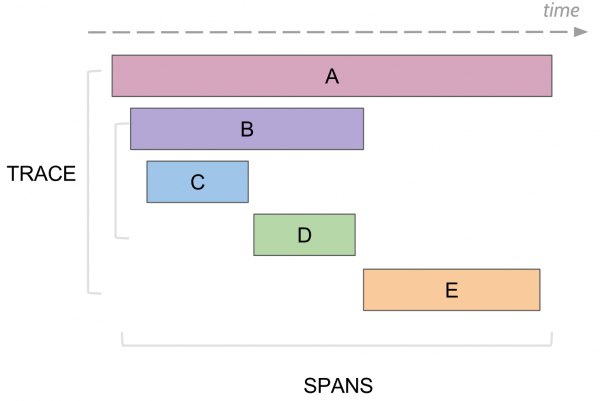
In tracing, there is a concept of a span, which is analogous to a single log in the console. A span has:
- A name, usually the name of the method that was executed
- The name of the service where the span was generated
- A unique ID of its own
- Some meta information in the form of key/value that was logged into it. For example, method parameters or whether the method ended with an error or not
- The start and end time of the execution of this span
- The ID of the parent span
Each span is sent to the span collector for storage in a database for subsequent viewing as soon as it finishes execution. In the future, it is possible to build a tree of all spans connecting by parent ID. During analysis, it is possible to find, for example, all spans in a specific service that took more than a certain amount of time. Then, by going to a specific span, you can see the entire tree above and below that span.
Opentrace, Jaeger and how we implemented this for our projects
There is a common standard , which describes how and what should be collected, without tying tracing to a specific implementation in any language. For example, in Java, all work with traces is done through the common Opentrace API, and underneath it can hide, for example, Jaeger or an empty default implementation that does nothing.
We use as the implementation of Opentrace. It consists of several components:
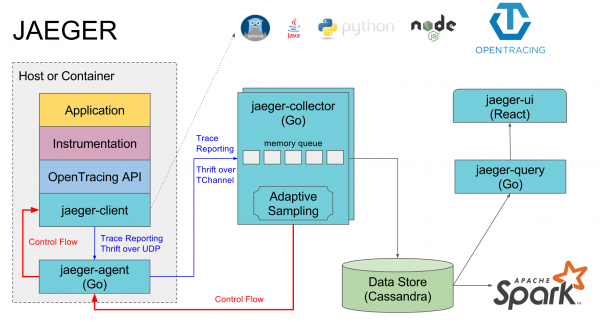
- Jaeger-agent — a local agent that usually runs on each machine and logs into it from services on a local default port. If no agent is present, traces from all services on this machine are usually disabled.
- Jaeger-collector — all agents send collected traces to it, and it places them in the selected database.
- The database — their preferred choice is Cassandra, but we use Elasticsearch. There are implementations for a couple of other databases and an in-memory implementation that doesn't save anything to disk.
- Jaeger-query — this service accesses the database and provides collected traces for analysis.
- Jaeger-ui — this is a web interface for searching and viewing traces, which accesses jaeger-query.
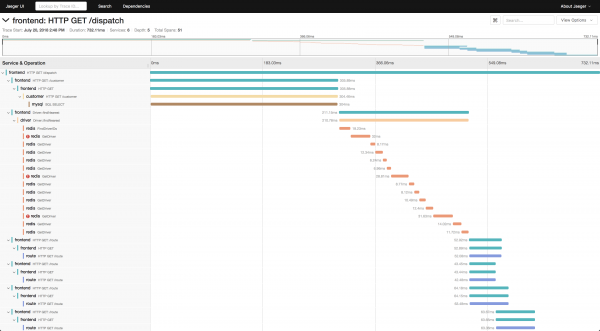
A separate component can be called the Opentrace Jaeger implementation for specific languages, through which spans are sent to the jaeger-agent.
det handler om at implementere grænsefladen io.opentracing.Tracer, hvorefter alle traces vil blive sendt til den rigtige agent gennem den.
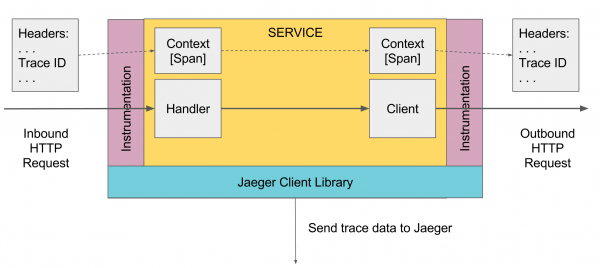
Samtidig kan komponenter i Spring tilsluttes og implementeringen fra Jaeger som automatisk konfigurerer tracing for alt, hvad der går gennem disse komponenter, for eksempel HTTP-anmodninger i controllere, anmodninger til databasen via jdbc osv.
Logning af traces i Java
Et sted på det øverste niveau skal den første Span oprettes; dette kan gøres automatisk, for eksempel af en Spring-kontroller ved modtagelse af en anmodning, eller manuelt hvis der ikke er en. Derefter overføres den gennem Scope nedenfor. Hvis en metode nedenunder ønsker at tilføje en Span, henter den den nuværende activeSpan fra Scope, opretter en ny Span og angiver, at dens forælder er den ekstraherede activeSpan, og gør den nye Span aktiv. Ved kald af eksterne tjenester videresendes den nuværende aktive Span til dem, og de tjenester opretter nye spans knyttet til denne span.
Alt arbejde udføres gennem en instans af Tracer, som kan fås gennem DI-mekanismen, eller GlobalTracer.get() som en global variabel, hvis DI-mekanismen ikke fungerer. Som standard, hvis tracer ikke er blevet initialiseret, returneres NoopTracer, som ikke gør noget.
Derefter hentes den nuværende scope fra tracer via ScopeManager, en ny scope oprettes fra den nuværende med knytning til den nye span, og derefter lukkes den oprettede Scope, som lukker den oprettede span og returnerer den tidligere Scope til den aktive tilstand. Scope er knyttet til tråden, så ved flertrådet programmering skal man huske at overføre den aktive span til en anden tråd for senere at aktivere Scope for den anden tråd med knytning til denne span.
io.opentracing.Tracer tracer = ...; // GlobalTracer.get()

void DoSmth () {
   try (Scope scope = tracer.buildSpan("DoSmth").startActive(true)) {
      ...
   }
}
void DoOther () {
    Span span = tracer.buildSpan("someWork").start();
    try (Scope scope = tracer.scopeManager().activate(span, false)) {
        // Gør ting.
    } catch(Exception ex) {
        Tags.ERROR.set(span, true);
        span.log(Map.of(Fields.EVENT, "error", Fields.ERROR_OBJECT, ex, Fields.MESSAGE, ex.getMessage()));
    } finally {
        span.finish();
    }
}

void DoAsync () {
    try (Scope scope = tracer.buildSpan("ServiceHandlerSpan").startActive(false)) {
        ...
        final Span span = scope.span();
        doAsyncWork(() -> {
            // TRIN 2 OVENFOR: genaktiver span i callback'et, ved at sende true til
            // startActive(), hvis/når span skal afsluttes.
            try (Scope scope = tracer.scopeManager().activate(span, false)) {
                ...
            }
        });
    }
}
Til multitrådet programmering er der også TracedExecutorService og lignende indpakninger, som automatisk videregiver den nuværende spand til tråden, når asynkrone opgaver startes:
private ExecutorService executor = new TracedExecutorService(
    Executors.newFixedThreadPool(10), GlobalTracer.get()
);
Til eksterne http-anmodninger er der
HttpClient httpClient = new TracingHttpClientBuilder().build();Problemer, vi stødte på
- Beans og DI fungerer ikke altid, hvis tracer ikke bruges i en service eller komponent, så Tracer måske ikke fungerer, og det bliver nødvendigt at bruge GlobalTracer.get().
- Annotationer virker ikke, hvis det ikke er en komponent eller service, eller hvis metodeopkaldet sker fra en nabometode i samme klasse. Man skal være forsigtig, kontrollere hvad der virker og bruge manuel oprettelse af trace, hvis @Traced ikke fungerer. Man kan også tilføje en ekstra compiler til java-annotationer, så de bør fungere overalt.
- I gamle spring og spring boot fungerer automatisk konfiguration af opentracing spring cloud ikke på grund af fejl i DI, så hvis man ønsker, at traces automatisk skal fungere i spring-komponenter, kan man gøre det efter mønsteret med
- I groovy fungerer try with resources ikke, man skal nødvendigvis bruge try finally.
- Hver service skal have sit eget spring.application.name, under hvilket traces vil blive logget. Desuden et separat navn for produktion og test, så de ikke blandes sammen.
- Hvis man bruger GlobalTracer og tomcat, så har alle services, der køres i denne tomcat, én GlobalTracer, så de vil alle have det samme servicenavn.
- Når man tilføjer traces i en metode, skal man være sikker på, at den ikke kaldes i en løkke flere gange. Man skal tilføje én fælles trace for alle opkald, der logger den samlede tid for behandlingen. Ellers vil der blive skabt en overflødig belastning.
- Engang i jaeger-ui lavede de for store anmodninger om et stort antal traces, og fordi de ikke ventede på svar, blev der lavet endnu en anmodning. I sidste ende begyndte jaeger-query at bruge meget hukommelse og bremse elastic. Et genstart af jaeger-query hjalp.
Sampling, lagring og visning af traces
Der er tre typer :
- Const, der sender og gemmer alle traces.
- Probabilistic, der filtrerer traces med en given sandsynlighed.
- Ratelimiting, som begrænser antallet af traces pr. sekund. Disse parametre kan konfigureres på klienten, på jaeger-agenten eller i samleren. I øjeblikket bruger vi i vores validator-stack const 1, da der ikke er mange anmodninger, men de tager lang tid. Hvis dette i fremtiden lægger for meget pres på systemet, kan vi begrænse det.
Hvis man bruger Cassandra, gemmer den som standard traces kun i to dage. Vi bruger og traces gemmes for al tid og slettes ikke. Der oprettes et separat indeks for hver dag, for eksempel jaeger-service-2019-03-04. I fremtiden skal vi konfigurere automatisk oprydning af gamle traces.
For at se traces, skal du:
- Vælg den service, du vil filtrere traces efter, for eksempel tomcat7-default for en service, der kører i Tomcat og ikke kan have et eget navn.
- Vælg derefter operation, tidsinterval og den minimale operationstid, for eksempel fra 10 sekunder, for kun at tage de lange udførelser.

- Gå til en af tracesene og se, hvad der forårsagede forsinkelsen.

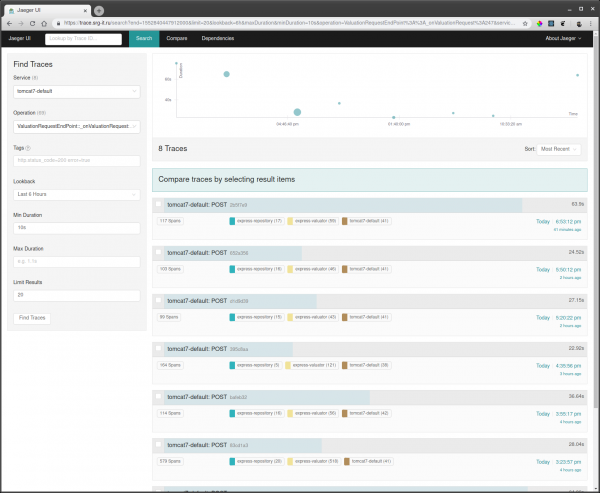
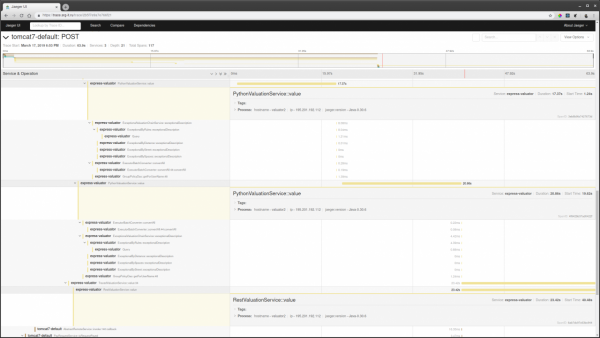
Hvis en anmodnings-ID er kendt, kan man finde tracen ved hjælp af denne ID gennem søgning på tags, hvis denne ID logges i trace span.
Dokumentation
- Dokumentation for OpenTracing
- Dokumentation for Jaeger
- Tilslutning af Jaeger Java
- Tilslutning af Spring OpenTracing
Artikler
- Jaeger OpenTracing og Microservices i et rigtig projekt på PHP og Golang
- Evolving Distributed Tracing at Uber Engineering
- Kørsel af Jaeger Agent på bare metal
Video
- How We Used Jaeger and Prometheus to Deliver Lightning-Fast User Queries — Bryan Boreham
- Intro: Jaeger — Yuri Shkuro, Uber & Pavol Loffay, Red Hat
- Serghei Iakovlev, “En lille historie om en stor sejr: OpenTracing, AWS og Jaeger”
Kilde: habr.com
