

I dag er det næppe nogen, der stiller spørgsmålstegn ved, hvorfor det er vigtigt at indsamle metrics for tjenester. Det næste logiske skridt er at sætte alarmer op for de indsamlede metrics, som vil informere om eventuelle afvigelser i dataene til de kanaler, du foretrækker (e-mail, Slack, Telegram). I tjenesten til online booking af hoteller strømmer alle metrics fra vores tjenester ind i InfluxDB og vises i Grafana, hvor den grundlæggende alarmering også er opsat. Til opgaver som 'vi skal beregne noget og sammenligne med dette' bruger vi Kapacitor.
Kapacitor er en del af TICK-stakken, der kan behandle metrics fra InfluxDB. Den kan sammenkæde flere målinger (join), beregne noget nyttigt fra de indsamlede data, gemme resultatet tilbage i InfluxDB og sende alarmer til Slack/Twitter/e-mail.
Hele stakken har en fed og detaljeret , men der vil altid være nyttige ting, der ikke er nævnt i manualerne. I denne artikel har jeg besluttet at samle en række sådanne nyttige, men ikke åbenlyse tips (den grundlæggende syntaks for TICKscript er beskrevet ) og vise, hvordan de kan anvendes ved at løse en af vores opgaver.
Lad os komme i gang!
float & int, beregningsfejl
Et helt standardproblem, der løses ved at konvertere:
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
Brug af default()
Hvis tag/felt ikke er udfyldt, vil der opstå fejl i beregningerne:
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill i join (inner vs outer)
Som standard vil join kaste de punkter væk, hvor der ikke er data (inner).
Med fill('null') vil der blive udført outer join, hvorefter der skal laves default() for at udfylde de tomme værdier:
var data = res1
    |join(res2)
        .as('res1', 'res2)
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Der er dog et nuance her. Hvis en af serierne (res1 eller res2) er tom i ovenstående eksempel, vil den samlede serie (data) også være tom. Der er flere tickets om dette emne på GitHub (, , ) – vi venter på rettelser og lidt lider.
Brug af betingelser i beregninger (if i lambda)
|eval(lambda: if("value" > 0, true, false)
De sidste fem minutter fra pipelinen over perioden
For eksempel skal du sammenligne værdierne fra de sidste fem minutter med den forrige uge. Du kan tage to grupper data med to separate batcher eller trække en del data fra en større periode:
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
Et alternativ til de sidste fem minutter kan være at bruge BarrierNode, som afskærer data tidligere end den angivne tid:
|barrier()
        .period(5m)
Eksempler på brug af Go's skabeloner i message
Skabelonerne følger formatet fra pakken , nedenfor er nogle ofte forekommende opgaver.
if-else
Lad os rydde op, uden at trigge folk unødigt med teksten:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Det er fint nu{{ else }}Chef, alt er i stykker{{end}}'
    )
To decimaler efter kommaet i message
Forbedrer læsbarheden af meddelelsen:
|alert()
    ...
    .message(
        'nu værdien er {{ index .Fields "value" | printf "%0.2f" }}'
    )
Udvikling af variabler i message
Vi viser flere oplysninger i meddelelsen for at besvare spørgsmålet "Hvorfor skriger den?"
var warnAlert = 10
  |alert()
    ...
    .message(
       'I dag er værdien mindre end '+string(warnAlert)+'%'
    )
Unikt identifikationsnummer for alert
Nyttigt, når der er mere end én gruppe i dataene, ellers vil der kun blive genereret én alert:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Custom handler's
I den store liste af håndterere er der exec, som gør det muligt at udføre dit eget script med de givne parametre (stdin) – kun kreativitet!
En af vores tilpasninger er et lille Python-script til at sende meddelelser til Slack.
Først ønskede vi at sende et billede fra Grafana, som var beskyttet med godkendelse. Derefter – skrive OK i tråden til den tidligere alert fra samme gruppe, og ikke som en separat meddelelse. Senere – tilføje den mest almindelige fejl i meddelelsen for de seneste X minutter.
Et separat emne – forbindelser til andre tjenester og handlinger, der initieres af en alert (kun hvis din overvågning fungerer godt nok).
Eksempel på beskrivelse af handler, hvor slack_handler.py – er vores egne script:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
Hvordan debugger man?
Mulighed med logudskrivning
|log()
      .level("error")
      .prefix("noget")
Se (cli): kapacitor -url :9092 logs lvl=error
Mulighed med httpOut
Viser data i den nuværende pipeline:
|httpOut('noget')
Se (get): :9092\/kapacitor\/v1\/tasks\/task_name\/noget
Udførelsesskema
- Hver opgave returnerer et udførelsestræ med nyttige tal i formatet .
- Vi tager blokken .
- Indsætter den i viewer, .
Hvor ellers kan man få timestamps i influxdb ved tilbageførsel
timestamp i influxdb ved tilbageføring
For example, we set up an alert for the number of requests per hour (groupBy(1h)) and want to log the occurring alert in influxdb (to nicely show the fact of an existing problem on the graph in grafana).
influxDBOut() will record the time value from the alert in the timestamp, accordingly, the point on the graph will be recorded earlier/later than the alert arrived.
When precision is required: we bypass this issue by calling a custom handler that will log the data in influxdb with the current timestamp.
docker, build and deploy
When starting, kapacitor can load tasks, templates, and handlers from the directory specified in the config, in the [load] block.
For correct task creation, the following items are needed:
- File name – expands into id/name of the script
- Type – stream/batch
- dbrp – keyword to specify which database + policy the script operates in (dbrp "supplier"."autogen")
If there is no dbrp line in some batch task, the entire service will refuse to start and will honestly write about it in the log.
In chronograf, on the contrary, this line should not be present, it is not accepted through the interface and results in an error.
A hack while building the container: the Dockerfile exits with -1 if there are lines with //.+dbrp, which will immediately indicate the cause of the build failure.
join one to many
Example task: we need to take the 95th percentile of the service's response time for the week, compare each minute of the last 10 with this value.
You cannot do a join one to many, last/mean/median by group of points turns the node into a stream, it will return an error "cannot add child mismatched edges: batch -> stream."
The result of the batch, as a variable in a lambda expression, is also not substituted.
There is an option to save the required numbers from the first batch in a file through udf and load this file through sideload.
What did we solve with this?
We have about 100 hotel suppliers, each of them may have several connections, let’s call it a channel. There are about 300 of these channels, each of which can drop out. Of all logged metrics, we will monitor the error rate (requests and errors).
Why not grafana?
Alerts on errors set in grafana have several downsides. Some are critical, and some can be overlooked, depending on the situation.
Grafana does not support calculations between measurements + alerting, and we need the rate (requests-errors)/requests.
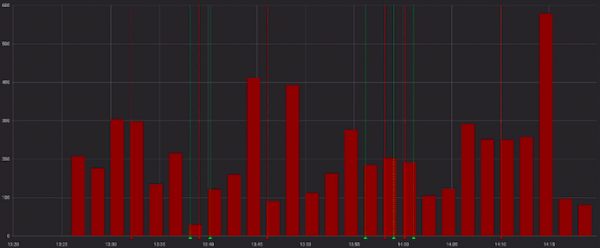
Errors look nasty:
And less nasty when looking at successful requests:
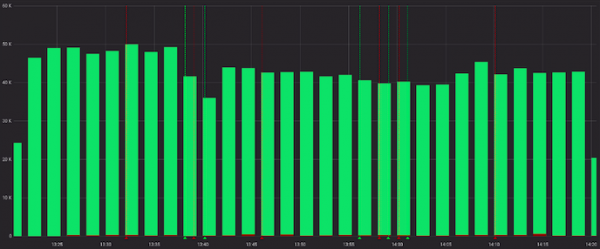
Okay, vi kan forudberegne raten i servicen før Grafana, og i nogle tilfælde vil det være passende. Men ikke i vores, da forholdet for hver kanal betragtes som "normalt", og alarmer fungerer på statiske værdier (vi søger med øjnene, ændrer dem, hvis der alarmes ofte).
Her er eksempler på "normalt" for forskellige kanaler:
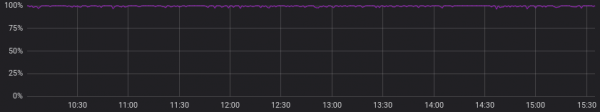
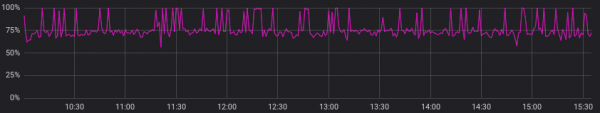
Lad os ignorere det tidligere punkt og antage, at alle leverandører har et "normalt" billede, der ligner hinanden. Er alt godt nu, og kan vi klare os med alarmer i Grafana?
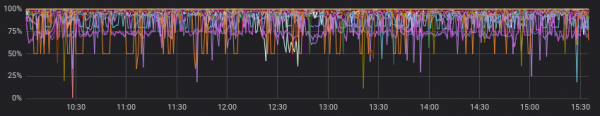
Vi kan, men vi ønsker det virkelig ikke, fordi vi skal vælge en af mulighederne:
a) lave mange grafer for hver kanal separat (og plage os selv med at vedligeholde dem)
b) lade én graf inkludere alle kanaler (og miste os i farverige linjer og indstillede alarmer)
Hvordan har vi gjort?
Igen findes der et godt start eksempel i dokumentationen (), vi kan kigge på eller tage som grundlag i lignende opgaver.
Hvad gjorde vi i slutningen:
- sammenflettede to serier over et par timer, gruppering efter kanaler;
- fylder serierne op efter grupper, hvis der ikke var data;
- sammenligner medianen for de seneste 10 minutter med tidligere data;
- råber, hvis vi finder noget;
- skriver de beregnede rater og de forekomne alarmer til influxdb;
- sender en nyttig besked til Slack.
Efter min mening er vi lykkedes maksimalt med alt, hvad vi gerne ville have output af (og endda lidt mere med brugerdefinerede håndterere).
På github.com kan man se og af det opnåede script.
Eksemplet på den resulterende kode:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // fyld værdier med nul, hvis de ikke var til
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // if i lambda: beregn raten kun hvis der var fejl
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// skriv de beregnede værdier til influx
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// vælg data for de sidste 10 minutter, beregn medianen
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // samler i message link til grafana dashboard grafik
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} err/req ratio ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}Det er ok nu{{ else }}
'+string(todayPeriod)+' median er {{ index .Fields "today.median" | printf "%0.2f" }}%, fra tidligere '+string(period)+' er {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+
'?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }}\/{{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" dublere som "value", og skriv også de andre felter af alarmen til influx (keep)
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
Hvad er resultatet?
Kapacitor kan udføre overvågning og alarmering med mange grupperinger, udføre yderligere beregninger på allerede indtastede målinger, udføre brugerdefinerede handlinger og køre scripts (udf).
Indgangsterskelen er ikke særlig høj – prøv det, hvis grafana eller andre værktøjer ikke helt opfylder dine ønsker.
Kilde: habr.com
