

Hvad ville du føle, hvis datacenteret med dit udstyr pludselig så sådan her ud en dejlig sommerdag?
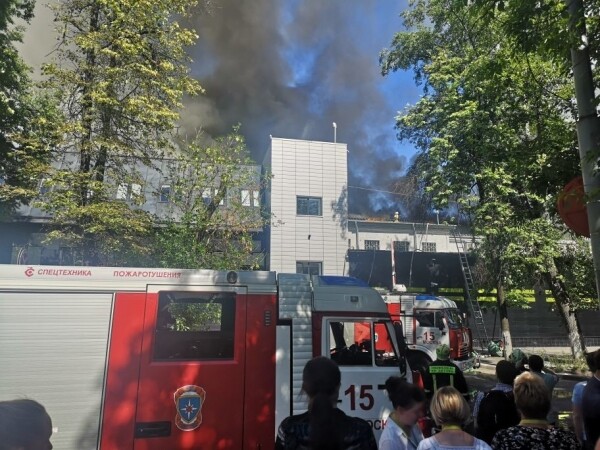
Hej alle sammen! Mit navn er Dmitrij Samsonov, jeg arbejder som chef systemadministrator hos “”. På billedet ses et af de fire datacentre, hvor udstyret til vores projekt er installeret. Bag disse vægge findes der omkring 4000 enheder: servere, datalagringssystemer, netværksudstyr osv. — næsten ⅓ af alt vores udstyr.
De fleste servere kører på Linux. Der er også et par dusin servere på Windows (MS SQL) — vores arv, som vi har arbejdet på at udfase i mange år.
Den 5. juni 2019 kl. 14:35 meldte ingeniørerne fra et af vores datacentre om brandalarm.
Benægtelse
14:45. Små hændelser med røg i datacentrerne sker oftere, end man skulle tro. Målene inde i hallen var normale, så vores første reaktion var relativt rolig: vi indførte et forbud mod arbejde med produktionen, dvs. mod enhver ændring af konfigurationer, udrulning af nye versioner osv., undtagen for arbejdet med at reparere noget.
Vrede
Har du nogensinde forsøgt at finde ud af fra brandfolk, præcis hvor på taget branden var, eller selv komme op på det brændende tag for at vurdere situationen? Hvor meget tillid kan man have til informationen, der er kommet gennem fem personer?
14:50. Der kom oplysninger om, at ilden nærmer sig kølesystemet. Men når det kommer til stykket? Den vagthavende systemadministrator skifter det eksterne trafik fra fronten af dette datacenter.
I øjeblikket er fronten for alle vores tjenester distribueret på tre datacentre, der anvendes DNS-balancering, hvilket gør det muligt at fjerne adresserne fra et datacenter i DNS og dermed beskytte brugerne mod potentielle problemer med adgang til tjenesterne. I tilfælde af at der allerede er opstået problemer i datacentret, fjernes det automatisk fra rotationen. Du kan læse mere her:
Branden har endnu ikke haft nogen indflydelse på os — hverken brugerne eller udstyret har lidt skade. Er det en nødsituation? Den første sektion i dokumentet “Nødhåndteringsplan” definerer begrebet “Nødsituation”, og sektionen slutter med:
«Hvis der er tvivl om, hvorvidt det er en nødsituation eller ej, så er det en nødsituation!»
14:53. Udnævnes katastrofekoordinator.
Koordinatoren er den person, der kontrollerer kommunikationen mellem alle deltagere, vurderer omfanget af katastrofen, anvender 'Handlingsplanen for nødsituationer', tilkalder nødvendig personale, overvåger afslutningen af reparationer, og, vigtigst af alt, delegerer enhver opgave. Med andre ord er det personen, der styrer hele processen for at afhjælpe katastrofen.
Forhandling
15:01. Vi begynder at slukke serverne, som ikke er knyttet til produktion.
15:03. Vi slukker alle reserverede tjenester korrekt.
Dette inkluderer ikke kun front-end (som brugerne på dette tidspunkt ikke længere tilgår) og deres støttefunktioner (forretningslogik, caches osv.), men også forskellige databaser med en replikationsfaktor på 2 eller mere (, , , og andre).
15:06. Der er kommet oplysninger om, at en brand truer et af datacenterets rum. I dette rum har vi ikke noget udstyr, men at ilden kan sprede sig fra taget til rummene ændrer drastisk situationen.
(Senere viste det sig, at der ikke var nogen fysisk trussel mod rummet, da det var hermetisk isoleret fra taget. Truslen var kun for kølesystemet i dette rum.)
15:07. Vi tillader hurtig udførelse af opgaver på serverne uden yderligere tjek ().
15:08. Temperaturen i rummene er inden for normen.
15:12. Der er registreret en temperaturstigning i rummene.
15:13. Mere end halvdelen af serverne i datacentret er slukket. Vi fortsætter.
15:16. Der er truffet beslutning om at slukke alt udstyr.
15:21. Vi begynder at slukke for strømmen på stateless-servere uden korrekt at lukke applikationen og operativsystemet.
15:23. Der udpeges en gruppe ansvarlige for MS SQL (de er få, afhængigheden af tjenesterne fra dem er ikke stor, men genopretning tager længere tid og er mere kompleks end f.eks. for Cassandra).
Depression
15:25. Der er kommet oplysninger om afbrydelse af strømmen i fire rum ud af 16 (nr. 6, 7, 8, 9). I rum 7 og 8 er vores udstyr. Vi har stadig ikke information om to af vores rum (nr. 1 og 3).
Normalt slukker man strømmen straks ved brande, men i dette tilfælde, takket være det koordinerede arbejde mellem brandmænd og teknisk personale i datacentret, blev det ikke slukket overalt og ikke straks, men efter behov.
(Senere viste det sig, at strømmen i sale 8 og 9 ikke var blevet afbrudt.)
15:28. Vi begynder at gendanne MS SQL-databaser fra backups i andre datacentre.
Hvor lang tid vil det tage? Er der tilstrækkelig båndbredde til netværket hele vejen?
15:37. Der er registreret et afbrudt netværk på nogle strækninger.
Ledelsen og produktionsnetværket er fysisk adskilt fra hinanden. Hvis produktionsnetværket er tilgængeligt, kan du få adgang til serveren, stoppe applikationen og lukke OS. Hvis det ikke er tilgængeligt, kan du få adgang via IPMI, stoppe applikationen og lukke OS. Hvis ingen af netværkene er tilgængelige, kan du ikke gøre noget. "Tak, kaptajn!", vil du måske tænke.
"Og generelt, hvorfor er det så hektisk?", vil du måske også tænke.
Det hele skyldes, at serverne, selv uden brand, genererer en enorm mængde varme. Mere præcist, når der er køling, genererer de varme, men når der ikke er, skaber de et helvede, der i bedste fald smelter dele af udstyret og slukker andre dele, og i værste fald... forårsager en brand inde i salen, som praktisk talt garanterer at ødelægge alt.
15:39. Vi registrerer problemer med conf-databasen.
Conf-databasen er backend for den samme tjeneste, som bruges af alle produktionsapplikationer til hurtigt at ændre indstillinger. Uden denne database kan vi ikke styre portalen, men selve portalen kan stadig fungere.
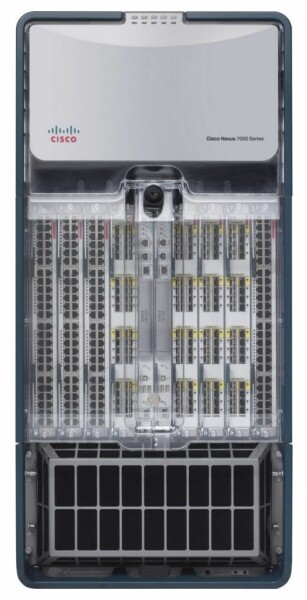
15:41. Temperaturfølere på Core netværksudstyr registrerer målinger, der ligger tæt på de maksimalt tilladte værdier. Det er en boks, der fylder en hel rack og sikrer driften af alle netværk inde i datacentret.
15:42. Issue tracker og wiki er utilgængelige, vi skifter til standby.
Dette er ikke produktion, men ved en nødsituation kan tilgængeligheden af enhver knowledge base være kritisk.
15:50. Et af overvågningssystemerne er faldet ud.
Der er flere af dem, og de dækker forskellige aspekter af serviceydelser. Nogle af dem er indstillet til autonom drift inden for hvert datacenter (de monitorerer kun deres eget datacenter), mens andre består af distribuerede komponenter, der problemfrit håndterer tabet af ethvert datacenter.
I dette tilfælde er , som arbejder i master-standby-tilstand, stoppet. Vi har skiftet til standby.
Accept
15:51. Via IPMI har vi slukket alle servere uden korrekt nedlukning, undtagen MS SQL.
Er I klar til massestyring af servere via IPMI, hvis det bliver nødvendigt?
Det øjeblik, hvor redningen af udstyret i datacenteret på dette stadium er afsluttet. Alt, hvad der kunne gøres, er gjort. Nogle kolleger kan tage en pause.
16:13. Der er kommet information om, at der er sprunget kølestofferør fra klimaanlægget på taget - dette vil forsinke åbningen af datacenteret efter branden.
16:19. Ifølge de oplysninger, der er modtaget fra datacenterets tekniske personale, er temperaturstigningen i rummene stoppet.
17:10. Driften af conf-databasen er blevet genoprettet. Vi kan nu ændre appindstillinger.
Hvorfor er det så vigtigt, hvis alt er redundant og fungerer selv uden et datacenter?
For det første er ikke alt redundant. Der er forskellige sekundære tjenester, som endnu ikke klarer nedbruddet af datacentret godt nok, og der er databaser i master-standby tilstand. Muligheden for at styre indstillingerne giver mulighed for at gøre alt nødvendigt for at minimere konsekvenserne af ulykken for brugerne, selv under vanskelige forhold.
For det andet er det blevet klart, at datacenterets drift ikke vil blive fuldstændig genoprettet i de kommende timer, så der var behov for at træffe foranstaltninger for at undgå, at langvarig utilgængelighed af replikerne førte til yderligere problemer som overfyldte diske i de resterende dataceter.
17:29. Tid til pizza! Vi har folk, der arbejder, ikke robotter.
Rehabilitering
18:02. Temperaturen er stabiliseret i rum 8 (vores), 9, 10 og 11. I et af de rum, der er blevet slået fra (nr. 7), står vores udstyr, og temperaturen fortsætter med at stige.
18:31. Godkendelse til at starte udstyret i rum 1 og 3 er givet - disse rum blev ikke påvirket af branden.
Vi er i øjeblikket ved at starte serverne i rum 1, 3 og 8, startende med de mest kritiske. Der kontrolleres for korrekt drift af alle kørende tjenester. Der er stadig problemer med rum 7.
18:44. Datacenterets tekniske personale har opdaget, at mange servere i rum 7 (hvor kun vores udstyr står) ikke er slukket. Ifølge vores oplysninger er 26 servere stadig tændte. Efter en ny kontrol opdager vi 58 servere.
20:18. Datacenterets tekniske personale blæser luft i rummet uden klimaanlæg via mobile luftkanaler, der er lagt gennem gangene.
23:08. Den første administrator blev sendt hjem. Nogen skal sove i nat, så vi kan fortsætte arbejdet i morgen. Derefter sender vi flere administratorer og udviklere hjem.
02:56. Vi har startet alt, hvad der kunne startes. Vi laver en grundlæggende kontrol af alle tjenester med automatiserede tests.
03:02. Ventilationen i den sidste, 7. sal, er genoprettet.
03:36. Vi har inkluderet fronten i datacenteret i DNS-rotation. Fra dette tidspunkt begynder brugertrafikken at komme.
Vi sender hovedparten af teamet af administratorer hjem. Men vi beholder et par personer.
Lille FAQ:
Q: Hvad skete der fra 18:31 til 02:56?
A: I henhold til 'Handlingsplanen ved nødsituationer' starter vi alle tjenester, begyndende med de mest kritiske. Koordinatoren i chatten tildeler tjenester til en ledig administrator, som kontrollerer, om OS og applikationen er startet korrekt, om der er fejl, og om indikatorerne er normale. Efter afslutning af opstarten meddeler han i chatten, at han er ledig, og modtager en ny tjeneste fra koordinatoren.
Processen forsinkes yderligere af defekt hardware. Selvom nedlukningen af OS og slukningen af serverne gik korrekt, vender nogle servere ikke tilbage på grund af pludselige hardwarefejl i diske, hukommelse eller chassiser. Ved strømsvigt stiger fejlraten.
Q: Hvorfor kan vi ikke bare starte alt på én gang og så reparere det, der viser sig i overvågningen?
A: Alt skal gøres gradvist, fordi der er afhængigheder mellem tjenesterne. Og vi skal kontrollere alt med det samme, i stedet for at vente på overvågningen — for med problemer er det bedre at få dem løst med det samme, i stedet for at vente på, at de bliver værre.
7:40. Den sidste administrator (koordinatoren) gik i seng. Arbejdet den første dag er afsluttet.
8:09. De første udviklere, ingeniører i datacenteret og administratorer (inklusive den nye koordinator) er begyndt med genoprettelsesarbejdet.
09:37. Vi er begyndt at hæve sal №7 (den sidste).
Samtidig fortsætter vi med at genoprette det, vi ikke fik færdiggjort i de andre sale: udskiftning af diske/hukommelse/servere, reparation af alt, der 'brænder' i overvågningen, tilbagevenden af roller i master-standby ordninger og andre småting, som dog stadig er mange.
17:08. Vi tillader alle planlagte arbejder med produktionen.
21:45. Arbejdet den anden dag er afsluttet.
09:45. I dag er det fredag. Der er stadig ret mange små problemer i overvågningen. Weekenden nærmer sig, og alle vil have lidt fri. Vi fortsætter med massivt at reparere alt, hvad vi kan. De administrative opgaver, der kunne udsættes, er blevet udsat. Den nye koordinator.
15:40. Pludselig blev halvdelen af Core-netværksudstyrets stak genstartet i EN ANDEN datacenter. Vi tog frontene ud af rotation for at minimere risiciene. Ingen effekt for brugerne. Senere viste det sig, at det var en defekt chassis. Koordinatoren arbejder på at reparere to fejl samtidig.
17:17. Netværksarbejdet i det andet datacenter er genoprettet, alt er tjekket. Datacenteret er blevet taget tilbage i rotation.
18:29. Arbejdet fra den tredje dag og generelt genopretning efter uheldet er afsluttet.
Efterord
04.04.2013, , "Odnoklassniki" — i løbet af tre dage var portalen helt eller delvist utilgængelig. I hele denne periode reparerede over 100 mennesker fra forskellige byer og virksomheder (igen mange tak!), både fjernbetjent og direkte i datacenterne, tusinder af servere manuelt og automatisk.
Vi har draget konklusioner. For at undgå lignende situationer har vi gennemført og fortsætter med at gennemføre omfattende arbejder.
Hvad er hovedforskellene mellem det nuværende nedbrud og 404?
- Vi har fået en "Nedbruds handlingsplan". En gang i kvartalet gennemfører vi øvelser — vi simulerer en nedbrudssituation, som en gruppe administratorer (alle på skift) skal løse ved hjælp af "Nedbruds handlingsplan". Ledende systemadministratorer optræder på skift som koordinator.
- Kvartalsvis isolerer vi datacentrene (alle på skift) fra LAN og WAN, hvilket giver os mulighed for at opdage flaskehalse i tide.
- Mindre defekte diske, fordi vi har strammet normerne: færre drifttimer, strengere tærskelværdier for S.M.A.R.T.,
- Vi er helt blevet fri for BerkeleyDB — den gamle og ustabile database, der tog lang tid at gendanne efter servergenstart.
- Vi har reduceret antallet af servere med MS SQL og mindske afhængigheden af de resterende.
- Vi har vores egen , hvor vi i over to år aktivt migrerer alle vores tjenester. Skyen forenkler hele arbejdsprocessen med applikationen, og i tilfælde af en nedbrud giver den unikke værktøjer såsom:
- korrekt stop af alle applikationer med et enkelt klik;
- simpel migrering af applikationer fra nedbrudte servere;
- automatisk prioriteret (i rækkefølge af serviceprioritet) opstart af et helt datacenter.
Den ulykke, der er beskrevet i denne artikel, var den største siden den 404. Selvfølgelig gik ikke alt glat. For eksempel, under nedetiden for det brændte datacenter, gik en disk i stykker på en af serverne i et andet datacenter, hvilket betød, at kun en af de tre replikaer i Cassandra-klyngen var tilgængelig, hvilket førte til, at 4,2% af brugerne af mobilapplikationer ikke kunne logge ind. De brugere, der allerede var tilsluttet, kunne dog fortsætte med at arbejde. I alt blev der identificeret over 30 problemer som følge af ulykken - fra banale fejl til utilstrækkeligheder i arkitekturen af tjenesterne.
Men den vigtigste forskel mellem den nuværende ulykke og den 404. er, at mens vi håndterede konsekvenserne af branden, fortsatte brugerne med at skrive og lave videoopkald i , spillede spil, hørte musik, gav gaver til hinanden, så videoer, serier og tv-kanaler i , og streamede i .
Hvordan håndterer I jeres ulykker?
Kilde: habr.com
