

Hello, Habr!
I lyset af de nuværende omstændigheder på grund af coronaviruset har en række internettjenester oplevet øget belastning. For eksempel fordi kapaciteten ikke var tilstrækkelig. Det er ikke altid muligt at hurtigere servere ved blot at tilføje mere kraftfuldt udstyr, men kundeforespørgsler skal behandles (ellers vil de tage til konkurrenterne).
I denne artikel vil jeg kort gennemgå populære praksisser, der kan skabe en hurtig og fejltolerant service. Jeg har dog kun udvalgt de udviklingsskemaer, som man i øjeblikket let kan bruge.For hvert punkt har du enten allerede eksisterende biblioteker eller muligheder for at løse opgaven med en cloud-platform.
Horiskontalt skalerings
Den mest enkle og velkendte tilgang. Betinget mødes der oftest to strategier for belastningsfordeling - horisontal og vertikal skalerings. giver du tjenesterne mulighed for at arbejde parallelt, hvilket fordeler belastningen mellem dem. bestiller du mere kraftfulde servere eller optimerer koden.
For eksempel vil jeg tage en abstrakt cloud-lagringstjeneste, som er en analog til OwnCloud, OneDrive og så videre.
Det standardbillede af et sådant system er nedenfor, men det viser kun systemets kompleksitet. For vi skal finde en måde at synkronisere tjenesterne på. Hvad sker der, hvis en bruger gemmer en fil fra sin tablet, og derefter ønsker at se den på sin telefon?
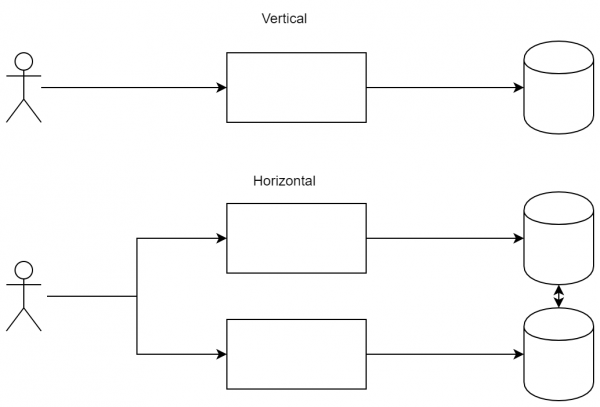
Forskellen mellem metoderne: i vertikal skalerings er vi villige til at øge kapaciteten af noderne, mens vi i horisontal skalering tilføjer nye noder for at fordele belastningen.
CQRS
er et ret vigtigt mønster, da det gør det muligt for forskellige klienter ikke kun at tilslutte sig forskellige tjenester, men også at modtage de samme strømme af begivenheder. Dets fordele er ikke så åbenlyse for en simpel applikation, men det er ekstremt vigtigt (og enkelt) for en overbelastet service. Dets essens er: indgående og udgående datastreams må ikke krydse hinanden. Det vil sige, du kan ikke sende en forespørgsel og forvente et svar, i stedet sender du en forespørgsel til tjeneste A, men modtager svaret i tjeneste B.
Den første fordel ved denne tilgang er muligheden for at afbryde forbindelsen (i ordets brede forstand) under udførelsen af en lang anmodning. Lad os tage en mere eller mindre standard sekvens som eksempel:
- Klienten har sendt en anmodning til serveren.
- Serveren har startet en lang behandling.
- Serveren svarede klienten med resultatet.
Forestill dig, at der i punkt 2 opstod et forbindelsesbrud (eller netværket genoprettede forbindelsen, eller brugeren gik til en anden side og afbrød forbindelsen). I dette tilfælde vil det være svært for serveren at sende et svar til brugeren med oplysninger om, hvad der blev behandlet. Ved at anvende CQRS vil sekvensen være lidt anderledes:
- Klienten har tilmeldt sig opdateringer.
- Klienten har sendt en anmodning til serveren.
- Serveren svarede: «Anmodning modtaget».
- Serveren svarede med resultatet gennem kanalen fra punkt «1».
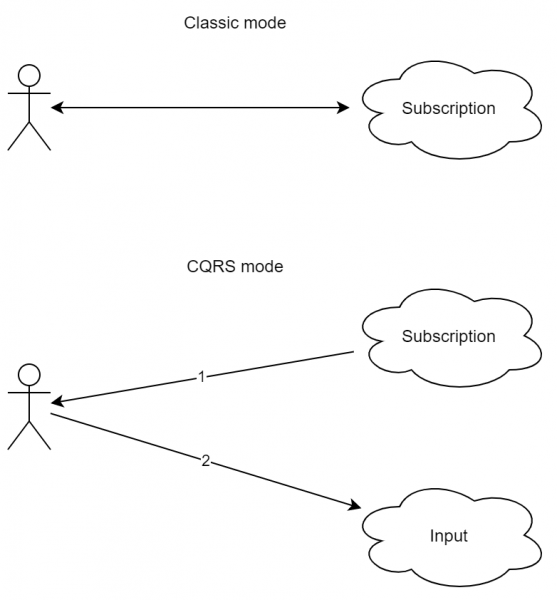
Som det fremgår, er skemaet lidt mere komplekst. Desuden er den intuitive anmodnings-svar tilgang fraværende her. Men som det ses, vil et forbindelsesbrud under behandlingen af anmodningen ikke føre til en fejl. Mere end det, hvis brugeren faktisk er tilsluttet tjenesten fra flere enheder (f.eks. fra en mobiltelefon og en tablet), kan man sørge for, at svaret kommer til begge enheder.
Det interessante er, at koden til behandling af indkommende meddelelser bliver ensartet (ikke 100%) både for de begivenheder, som kunden selv har påvirket, samt for de øvrige begivenheder, herunder dem fra andre kunder.
Men i praksis får vi yderligere fordele, da den envejskommunikation kan behandles funktionelt (ved hjælp af RX og lignende). Og dette er allerede en betydelig fordel, da applikationen i princippet kan gøres helt reaktiv, og endda anvende en funktionel tilgang. For større programmer kan dette betydeligt spare ressourcer på udvikling og vedligeholdelse.
Hvis man kombinerer denne tilgang med horisontal skalering, får vi muligheden for at sende anmodninger til én server, men modtage svar fra en anden. På den måde kan klienten selv vælge den tjeneste, der er mest praktisk for dem, og systemet kan stadig korrekt behandle begivenhederne internt.
Event Sourcing
Som du ved, er en af de centrale egenskaber ved et distribueret system fraværet af en fælles tid og en fælles kritisk sektion. For en enkelt proces kan du lave synkronisering (på de samme mutexer), hvor du er sikker på, at ingen andre udfører denne kode. Men for et distribueret system er det farligt, da det vil kræve overhead, og hele skønheden ved skalerbarhed vil gå tabt — alle komponenter vil stadig vente på den samme.
Derfor får vi en vigtig konklusion — det er ikke muligt at synkronisere et hurtigt distribueret system, for da vil vi reducere ydeevnen. På den anden side har vi ofte brug for en vis konsistens mellem komponenterne. Og til dette kan vi anvende en tilgang med , hvor det garanteres, at i fravær af dataændringer over en vis periode efter den seneste opdatering ("i sidste ende") vil alle forespørgsler returnere den senest opdaterede værdi.
Det er vigtigt at forstå, at der ofte anvendes , hvor hver node ejer den samme information (dette opnås ofte, når en transaktion kun betragtes som bekræftet efter et svar fra den anden server). Der er dog nogle lempelser på grund af isolationsniveauer, men den overordnede idé forbliver den samme — du kan leve i en helt konsistent verden.
Men lad os vende tilbage til det oprindelige problem. Hvis en del af systemet kan bygges med , kan vi bygge følgende skema.
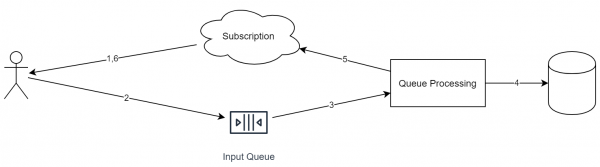
Vigtige egenskaber ved denne tilgang:
- Hver indkommende forespørgsel placeres i en kø.
- Under behandlingen af en forespørgsel kan tjenesten også placere opgaver i andre køer.
- Hver indkommende hændelse har et identifikationsnummer (der er nødvendigt for deduplicering).
- Køen fungerer ideologisk efter "append only"-princippet. Der kan ikke slettes eller omarrangeres elementer i den.
- Køen arbejder efter FIFO-princippet (undskyld for tautologien). Hvis der er behov for parallel eksekvering, skal objekterne flyttes til forskellige køer i en af faserne.
Lad mig minde om, at vi ser på tilfælde af online filopbevaring. I dette tilfælde vil systemet se omtrent sådan ud:
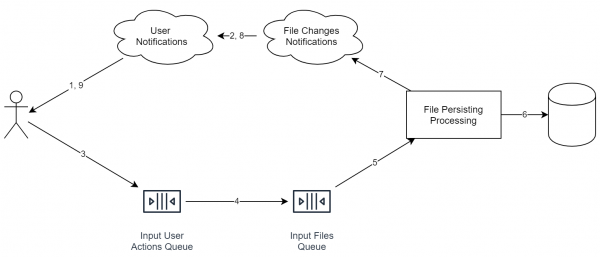
Det er vigtigt at bemærke, at tjenesterne på diagrammet ikke nødvendigvis betyder en separat server. Selv processen kan være den samme. Det vigtigste er dog, at ideologisk er disse ting opdelt på en sådan måde, at det er nemt at anvende horisontal skalerbarhed.
Og for to brugere vil skemaet se sådan ud (tjenester, der er designet til forskellige brugere, er angivet med forskellige farver):
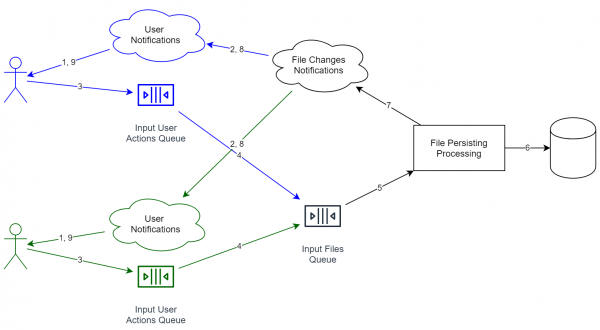
Fordele ved en sådan kombination:
- Tjenesterne til behandling af information er opdelt. Køerne er også opdelt. Hvis vi skal øge systemets kapacitet, skal vi blot starte flere tjenester på et større antal servere.
- Når vi modtager information fra brugeren, er vi ikke nødvendigvis nødt til at vente på, at dataene er gemt fuldt ud. Tværtimod er det nok at svare "ok", og så kan vi gradvist begynde arbejdet. Desuden udglatter køen spidserne, da tilføjelsen af et nyt objekt sker hurtigt, og brugeren behøver ikke at vente på en fuld gennemgang af hele cyklussen.
- For eksempel har jeg tilføjet en deduplikationstjeneste, der forsøger at kombinere identiske filer. Hvis den kører længe i 1% af tilfældene, vil kunden stort set ikke bemærke det (se ovenfor), hvilket er en stor fordel, da vi ikke længere kræver hundrede procent hastighed og pålidelighed.
Men der ses straks også ulemper:
- Vores system har mistet streng konsistens. Det betyder, at hvis man f.eks. abonnerer på forskellige tjenester, så kan man teoretisk set få forskellige tilstande (da en af tjenesterne måske ikke når at modtage meddelelsen fra den interne kø). Som en anden konsekvens har systemet nu ikke nogen fælles tid. Det vil sige, at man ikke kan sortere alle hændelser simpelthen efter modtagelsestidspunktet, da klokken mellem serverne muligvis ikke er synkroniseret (mere end det, så er det en utopi at have samme tid på to servere).
- Ingen hændelser kan nu simpelthen blive rullet tilbage (som man kunne gøre med en database). I stedet er det nødvendigt at tilføje en ny hændelse — , som vil ændre den sidste tilstand til den ønskede. Som et eksempel fra et lignende område: uden at overskrive historien (hvilket er skidt i mange tilfælde) kan man i git ikke rulle et commit tilbage, men man kan lave et specielt , som i bund og grund blot vil gendanne den gamle tilstand. Dog vil både den fejlagtige commit og rollback stadig være gemt i historikken.
- Dataskemaet kan ændre sig fra version til version, men gamle hændelser kan nu ikke opdateres til den nye standard (da hændelser i princippet ikke kan ændres).
Som det kan ses, passer Event Sourcing glimrende sammen med CQRS. Desuden er det generelt svært at implementere et system med effektive og brugervenlige køer uden at adskille datastreams, da der så skal tilføjes synkroniseringspunkter, der vil neutralisere hele den positive effekt af køerne. Ved at anvende begge tilgange samtidig skal programkode justeres en smule. I vores tilfælde, når en fil sendes til serveren, modtages der kun en ‘ok’-besked som svar, hvilket blot betyder, at ‘operationen med filtilføjelsen er blevet gemt’. Formelt set betyder dette ikke, at dataene allerede er tilgængelige på andre enheder (f.eks. kan deduplication service omstrukturere indekset). Men efter noget tid vil klienten modtage en meddelelse af typen ‘fil X er gemt’.
Resultatet bliver:
- Antallet af statusser for filoverførsler stiger: i stedet for den klassiske ‘fil sendt’, får vi to: ‘fil tilføjet til serverens kø’ og ‘fil gemt i lageret’. Sidstnævnte betyder, at andre enheder allerede kan begynde at modtage filen (med forbehold for, at køerne arbejder med forskellig hastighed).
- Da informationen om afsendelsen nu kommer via forskellige kanaler, er vi nødt til at finde løsninger for at modtage status for filbehandlingen. Som følge heraf, i modsætning til det klassiske request-response, kan klienten genstartes under filbehandlingen, men status for denne behandling vil være korrekt. Og dette punkt fungerer i bund og grund out-of-the-box. Som resultat: vi er nu mere tolerante over for fejl.
Sharding
Som allerede beskrevet, har systemer med event sourcing ikke streng konsistens. Det betyder, at vi kan anvende flere lagre uden nogen form for synkronisering mellem dem. Når vi nærmer os vores opgave, kan vi:
- Opdele filer efter typer. For eksempel kan billeder/videoer dekodes og vælges til en mere effektiv format.
- Adskil konti efter lande. På grund af mange love kan dette være nødvendigt; men dette arkitekturdesign giver mulighed for automatisk at gøre det.
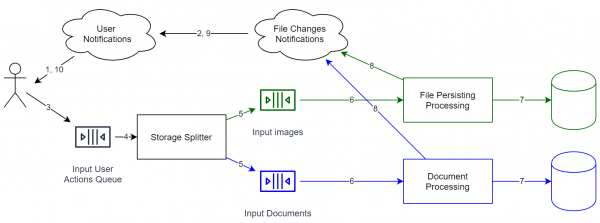
Hvis du ønsker at overføre data fra et lager til et andet, kan du ikke blot bruge de standardværktøjer, der er tilgængelige. Desværre skal køen stoppes, migrationen udføres, og derefter genstartes den. Generelt kan data ikke overføres 'on the fly', men hvis begivenhedskøen er fuld og du har snapshots af de tidligere tilstande af lageret, kan vi genafspille begivenhederne på følgende måde:
- I Event Source har hver begivenhed sit eget id (ideelt set ikke-faldende). Det betyder, at vi kan tilføje et felt i lageret - id'et for det sidst behandlede element.
- Vi duplikerer køen, så alle begivenheder kan behandles for flere uafhængige lagre (det første er det, hvor data allerede er gemt, og det andet er nyt, men endnu tomt). Den anden kø behandles naturligvis endnu ikke.
- Vi starter den anden kø (det vil sige, vi begynder at genafspille begivenheder).
- Når den nye kø er relativt tom (dvs. den gennemsnitlige tidsforskel mellem tilføjelsen af et element og dets udtrækning er acceptabel), kan vi begynde at skifte læserne til det nye lager.
Som det fremgår, har vi i systemet aldrig haft og har aldrig streng konsistens. Der eksisterer kun eventual consistency, hvilket giver en garanti for, at begivenheder behandles i den samme rækkefølge (dog muligvis med forskellige forsinkelser). Ved at udnytte dette kan vi relativt nemt overføre data uden at stoppe systemet til den anden ende af kloden.
Dermed, fortsætter vi med vores eksempel på et online lagring for filer, giver denne arkitektur os allerede en række fordele:
- Vi kan flytte objekter tættere på brugerne, hvilket kan ske dynamisk. På den måde kan kvaliteten af tjenesten øges.
- Vi kan opbevare en del af dataene internt hos virksomhederne. For eksempel kræver Enterprise-brugere ofte, at deres data opbevares i kontrollerede datacentre (for at undgå datalæk). Gennem sharding kan vi nemt understøtte dette. Og opgaven bliver endnu lettere, hvis kunden har en kompatibel sky (for eksempel, ).
- Og det vigtigste er, at vi ikke nødvendigvis skal gøre det. For i starten ville det være tilstrækkeligt med et enkelt lager til alle konti (så vi kan komme hurtigere i gang). Og nøglefunktionen ved dette system er, at det, selvom det er skalerbart, i udgangspunktet er ret simpelt. Man skal bare ikke straks skrive kode, der arbejder med en million separate uafhængige køer osv. Hvis det bliver nødvendigt, kan det gøres senere.
Statisk Indhold Hosting
Dette punkt kan virke helt åbenlyst, men det er stadig nødvendigt for et mere eller mindre standard belastet applikation. Dets essens er enkel: al statisk indhold leveres ikke fra samme server, som applikationen er på, men fra særlige, der er dedikeret til dette formål. Som følge heraf udføres disse operationer hurtigere (en typisk nginx leverer filer både hurtigere og billigere end en Java-server). Plus, CDN-arkitekturen () gør det muligt at placere vores filer tættere på slutbrugerne, hvilket positivt påvirker brugervenligheden af servicen.
Det simpleste og mest standard eksempel på statisk indhold er en samling af scripts og billeder til en hjemmeside. Det er ret enkelt — de er i forvejen kendte, hvorefter arkivet uploades til CDN-serverne, hvorfra det leveres til slutbrugerne.
Men i praksis kan en lignende tilgang anvendes for statisk indhold, som ligner lambda-arkitektur. Lad os gå tilbage til vores opgave (online filopbevaring), hvor vi skal levere filer til brugerne. Den enkleste løsning er at lave en service, der for hver brugerforespørgsel foretager alle nødvendige kontroller (autorisation osv.), og derefter downloader filen direkte fra vores lager. Hovedproblemet ved denne tilgang er, at det statiske indhold (og en fil med en bestemt revision er i princippet statisk indhold) leveres af den samme server, der indeholder forretningslogikken. I stedet kan man lave følgende skema:
- Serveren giver en URL til download. Den kan være i formatet file_id + key, hvor key er en mini-digitalskilt, der giver ret til adgang til ressourcen i de næste 24 timer.
- Udleveringen af filen håndteres af en simpel nginx med følgende indstillinger:
- Cache af indhold. Da denne tjeneste kan befinde sig på en separat server, har vi givet os selv en fremtidig mulighed for at gemme alle de senest downloaded filer på disken.
- Kontrol af nøglen i forbindelse med oprettelsen af forbindelsen
- Valgfrit: streaming af indhold. For eksempel, hvis vi komprimerer alle filer i tjenesten, kan vi udføre udpakkningen direkte i denne modul. Som følge heraf: IO-operationer foretages, hvor de hører hjemme. En Java-arkiverer kan nemt allokere meget unødig hukommelse, men at omskrive tjenesten med forretningslogik i betinget Rust/C++ kan også vise sig at være ineffektivt. I vores tilfælde anvendes der forskellige processer (eller endda tjenester), og derfor kan forretningslogik og IO-operationer opdeles ret effektivt.
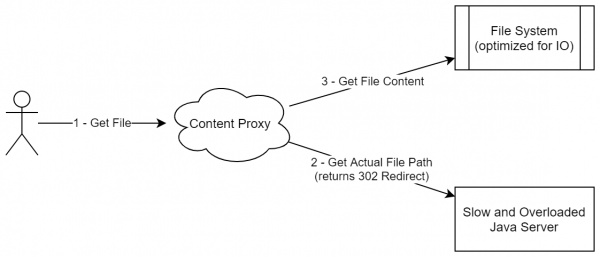
Denne skema ligner ikke meget en distribution af statisk indhold (da vi ikke uploader hele pakken af statik et sted hen), men i realiteten beskæftiger denne tilgang sig netop med distribution af uforanderlige data. Desuden kan dette skema generaliseres til andre tilfælde, hvor indhold ikke blot er statisk, men kan præsenteres som et sæt uforanderlige og utradérbare blokke (selvom de kan tilføjes).
Som et andet eksempel (for at forstærke): hvis du har arbejdet med Jenkins/TeamCity, ved du, at begge løsninger er skrevet i Java. Begge er Java-processer, der håndterer både orkestrering af builds og indholdshåndtering. Især har de begge opgaver som "overfør en fil/mappe fra serveren". For eksempel: udlevering af artefakter, overførsel af kildekode (når agenten ikke downloader koden direkte fra repository, men serveren gør det), adgang til logfiler. Alle disse opgaver har forskellige belastninger på IO. Det vil sige, at den server, der er ansvarlig for kompleks forretningslogik, samtidig skal være i stand til effektivt at presse store datastreams igennem sig. Og det mest interessante er, at en sådan operation kan delegeres til nginx på præcis samme måde (bortset fra at der i forespørgslen skal tilføjes en datanøgle).
Men hvis vi vender tilbage til vores system, får vi følgende skema:
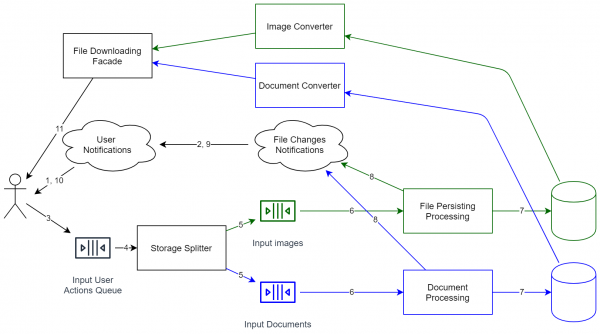
Som det ses, er systemet blevet radikalt mere komplekst. Det er ikke længere bare en mini-proces, der gemmer filer lokalt. Der kræves nu ikke bare simpel support, men også kontrol over API-versioner osv. Derfor, når alle diagrammer er tegnet, er det bedst at vurdere nøje, om omkostningerne til skalerbarhed er værd. Men hvis du ønsker at kunne skalere systemet (inklusive til at håndtere flere brugere), må du gå på sådanne løsninger. Til gengæld er systemets arkitektur klar til at håndtere øget belastning (næsten hver komponent kan klones til horisontal skalering). Systemet kan opdateres uden at stoppe det (bare nogle operationer vil midlertidigt blive lidt langsommere).
Som jeg allerede nævnte i begyndelsen, oplever mange internet-tjenester nu en øget belastning. Og nogle af dem er faktisk begyndt at fungere dårligt. I realiteten svigtede systemerne lige præcis, når virksomhederne skulle tjene penge. I stedet for at planlægge leveringer i de kommende måneder, sagde systemet simpelthen "gå til konkurrenterne". Det er prisen for lav ydeevne: tabene opstår netop når fortjenesten ville være højest.
Konklusion
Alle disse tilgange var kendte tidligere. VK bruger allerede længe ideen om Static Content Hosting til udlevering af billeder. Mange online-spil bruger en Sharding-ordning til at opdele spillere efter regioner eller til at opdele spilområder (hvis verden er samlet). Event Sourcing metoden anvendes aktivt i e-mail. De fleste trader-apps, hvor data kontinuerligt kommer ind, er faktisk bygget på CQRS-metoden for at kunne filtrere de indkomne data. Og horisontal skalering er blevet anvendt i mange tjenester i et stykke tid.
Men det vigtigste er, at alle disse mønstre nu er meget lettere at anvende i moderne applikationer (hvis de er relevante, selvfølgelig). Cloud-løsninger tilbyder sharding og horisontal skalerbarhed med det samme, hvilket er meget lettere end selv at bestille forskellige dedikerede servere i forskellige datacentre. CQRS er blevet meget lettere, ikke mindst på grund af udviklingen af biblioteker som RX. For ti år siden ville sjældne websteder kunne understøtte noget sådant. Event sourcing konfigureres også utrolig nemt takket være færdige containere med Apache Kafka. For ti år siden ville det have været en innovation; nu er det almindelighed. Tilsvarende med statisk indhold hosting: på grund af mere brugervenlige teknologier (herunder detaljeret dokumentation og et stort spørgeskema) er denne tilgang blevet endnu enklere.
Som resultat er implementeringen af en række ret komplekse arkitekturmønstre nu blevet meget lettere, og derfor er det bedst at kigge nærmere på dem på forhånd. Hvis et ti-årigt program har forkastet en af løsningerne ovenfor på grund af de høje omkostninger ved implementering og drift, kan man nu i en ny applikation eller efter refaktorering skabe en service, som arkitektonisk allerede vil være både skalerbar (i forhold til ydeevne) og klar til nye anmodninger fra kunderne (for eksempel til lokalisering af persondata).
Og det vigtigste: brug venligst ikke disse tilgange, hvis du har en simpel applikation. Ja, de er smukke og interessante, men for en hjemmeside med et spidsbelastning på 100 besøgende, kan man ofte klare sig med en klassisk monolit (i det mindste udefra; indeni kan alt opdeles i moduler osv.).
Kilde: habr.com
