

Oversigt over Bruce Momjian's rapport fra 2020 "Unlocking the Postgres Lock Manager".
(Bemærk: Alle SQL-forespørgsler fra diasene kan hentes via dette link: )
Hej! Det er fantastisk at være tilbage her i Rusland. Jeg beklager, at jeg ikke kunne komme sidst år, men i år har Ivan og jeg store planer. Jeg håber, at jeg vil være her meget oftere. Jeg elsker at besøge Rusland. Jeg vil besøge Tyumen og Tver. Jeg er meget glad for, at jeg får mulighed for at være i disse byer.
Mit navn er Bruce Momjian. Jeg arbejder hos EnterpriseDB og har arbejdet med Postgres i over 23 år. Jeg bor i Philadelphia, USA. Jeg rejser ca. 90 dage om året og deltager i omkring 40 konferencer. Min , som indeholder de dias, jeg snart vil vise jer. Så efter konferencen kan I downloade dem fra min personlige hjemmeside. Der er også omkring 30 præsentationer samt videoer og et stort antal blogindlæg, over 500. Det er en ret omfattende ressource. Og hvis I er interesserede i dette materiale, inviterer jeg jer til at bruge det.
Jeg har tidligere været underviser, professor før jeg begyndte at arbejde med Postgres. Og jeg er meget glad for at få mulighed for at fortælle jer det, jeg vil dele nu. Det er en af de mest interessante præsentationer, jeg har lavet. Denne præsentation indeholder 110 dias. Vi vil starte med simple emner, og jo længere vi kommer ind i foredraget, desto sværere bliver det, og til sidst bliver det temmelig komplekst.
Det er et ret ubehageligt emne. Låse er ikke det mest populære emne. Vi ønsker, at det skal forsvinde et sted. Det er ligesom at gå til tandlægen.
- Låse er et problem for mange mennesker, der arbejder med databaser, hvor flere processer kører samtidigt. De har brug for låsning. Dvs. i dag vil jeg give jer grundlæggende kendskab til låsning.
- Transaktionsidentifikatorer. Dette er en ret kedelig del af præsentationen, men de er nødvendige at forstå.
- Derefter vil vi tale om låsetyper. Dette er en ret mekanisk del.
- Og derefter vil vi give nogle eksempler på låse. Og det vil være ret svært at forstå.
Lad os tale om låse.
Terminologien er ret komplicerede. Hvor mange af jer ved, hvor dette citat er fra? To personer. Det er fra et spil, der hedder "Kolosalt eventyr i hulen". Det var et tekstbaseret computerspil i 80'erne, synes jeg. Man skulle gå ind i en hule, i en labyrint, og teksten ændrede sig, men indholdet var cirka det samme hver gang. Sådan husker jeg dette spil.
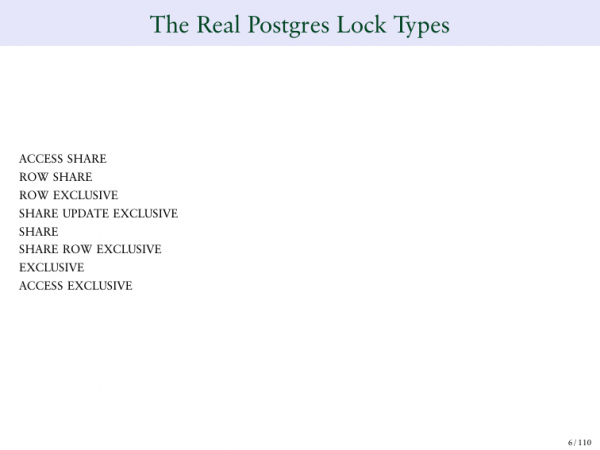
Her ser vi navnet på låse, der kommer fra Oracle. Vi bruger dem.
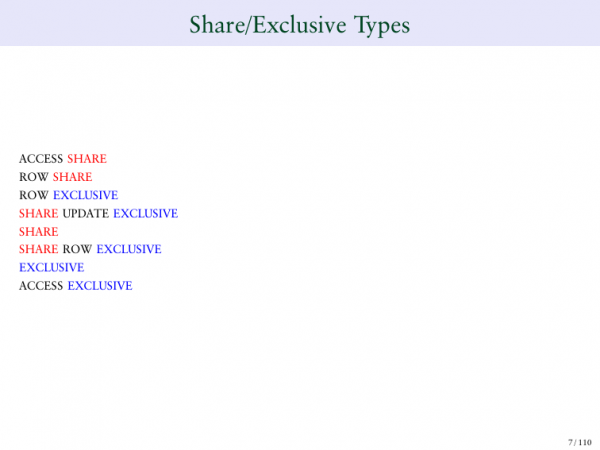
Her ser vi termer, der forvirrer mig. For eksempel SHARE UPDATE EXCLUSIVE. Derudover SHARE RAW EXCLUSIVE. Ærligt talt er disse navne ikke særlig klare. Vi vil forsøge at undersøge dem mere detaljeret. Nogle indeholder ordet "share", som betyder – at dele. Nogle indeholder ordet "exclusive" – eksklusiv. I nogle indeholder begge disse ord. Jeg vil gerne begynde med, hvordan disse låse fungerer.
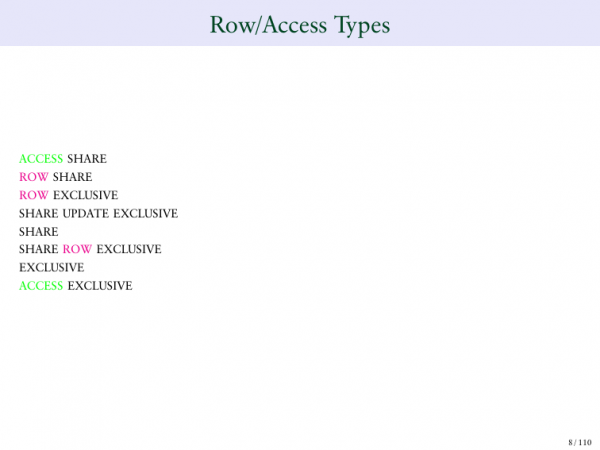
Og det er også meget vigtigt med ordet "adgang" – access. Og ordet "row" – række. Det vil sige, adgangsfordeling, rækkefordeling.
Et andet problem, der skal forstås i Postgres, som jeg desværre ikke kan forklare i min præsentation, er MVCC. Jeg har en separat præsentation om dette emne på min hjemmeside. Og hvis du synes, at denne præsentation er svær, så er MVCC nok den sværeste for mig. Og hvis du er interesseret, kan du se den på hjemmesiden. Du kan se videoen.
En anden ting, vi skal forstå – er transaktionsidentifikatorer. Mange transaktioner kan ikke fungere uden unikke identifikatorer. Og her forklarer vi, hvad en transaktion er. I Postgres er der to systemer til nummerering af transaktioner. Jeg ved, det er ikke en særlig pæn løsning.
Vær også opmærksom på, at slides vil være ret svære at forstå, så det, der er fremhævet med rødt, er det, man virkelig skal lægge mærke til.
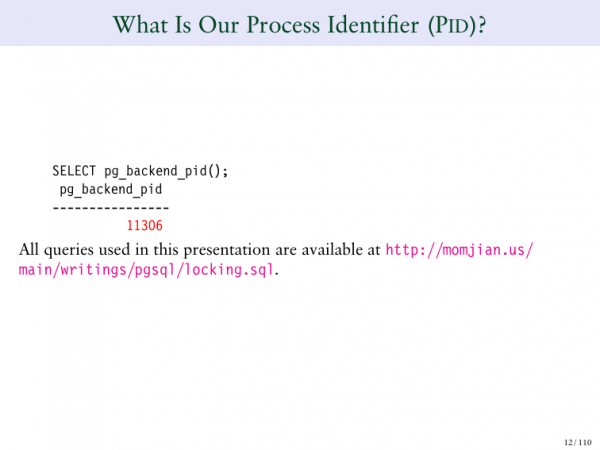
Lad os se. Nummeret på transaktionen er fremhævet med rødt. Her vises funktionen SELECT pg_back. Den returnerer min transaktion og ID'en på denne transaktion.
En anden ting, hvis du kan lide denne præsentation, og du vil have den i din database, kan du følge dette link, der er fremhævet i pink, og downloade SQL til denne præsentation. Du kan bare køre det i dit PSQL, og hele præsentationen vises på din skærm øjeblikkeligt. Den vil ikke indeholde farver, men i det mindste vil vi kunne se den.
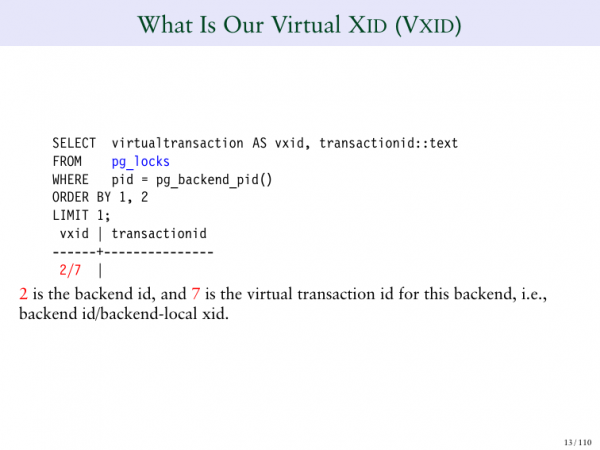
I dette tilfælde ser vi transaktions-ID'et. Det er det nummer, vi har tildelt det. Og der er en anden type transaktions-ID i Postgres, som kaldes virtuel transaktions-ID.
Og vi skal forstå dette. Det er meget vigtigt, ellers kan vi ikke forstå låsningen i Postgres.
Virtuel transaktions-ID er et transaktions-ID, der ikke indeholder permanente værdier. For eksempel, hvis jeg kører en SELECT-kommando, så ændrer jeg sandsynligvis ikke databasen, jeg vil ikke låse noget. Derfor, når vi kører en simpel SELECT, tildeler vi ikke denne transaktion et permanent ID. Vi giver den kun et virtuelt ID.
Og det forbedrer ydeevnen i Postgres, forbedrer mulighederne for oprydning, så det virtuelle transaktions-ID består af to tal. Det første tal før skråstregen er backend-id'et. Og til højre ser vi bare en tæller.
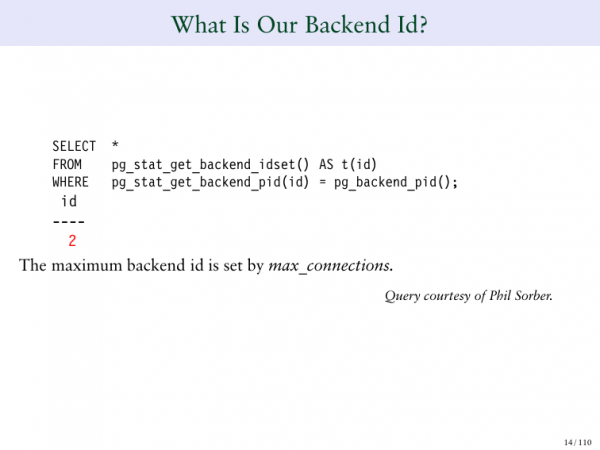
Så hvis jeg kører en forespørgsel, siger den, at backend-id'et er 2.
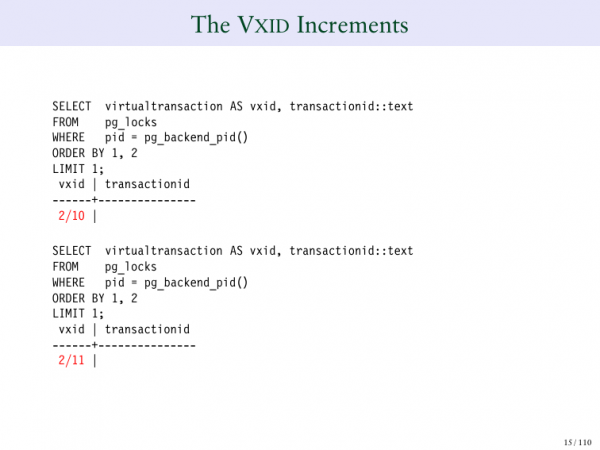
Og hvis jeg kører en serie af sådanne transaktioner, ser vi, at tælleren hver gang øges, når jeg kører forespørgslen. For eksempel når jeg kører forespørgslerne 2/10, 2/11, 2/12 osv.
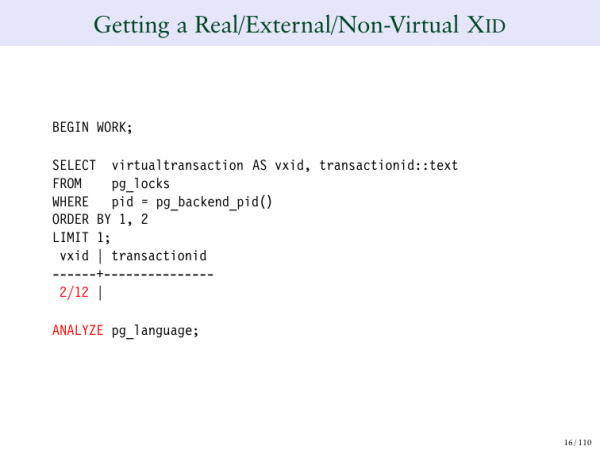
Vær opmærksom på, at der her er to kolonner. Til venstre ser vi det virtuelle transaktions-ID – 2/12. Og til højre har vi det permanente transaktions-ID. Og dette felt er tomt. Denne transaktion ændrer ikke databasen. Derfor tildeler jeg ikke et permanent transaktions-ID til den.
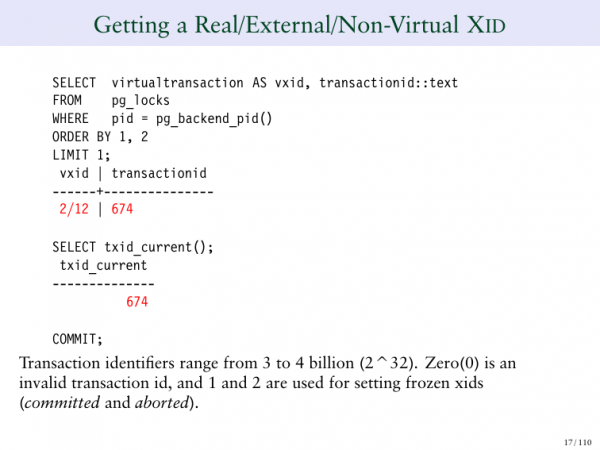
Så snart jeg kører analysér-kommandoen (ANALYZE), giver den samme forespørgsel mig et permanent transaktions-ID. Se hvordan det har ændret sig. Jeg havde ikke dette ID før, nu er det til stede.
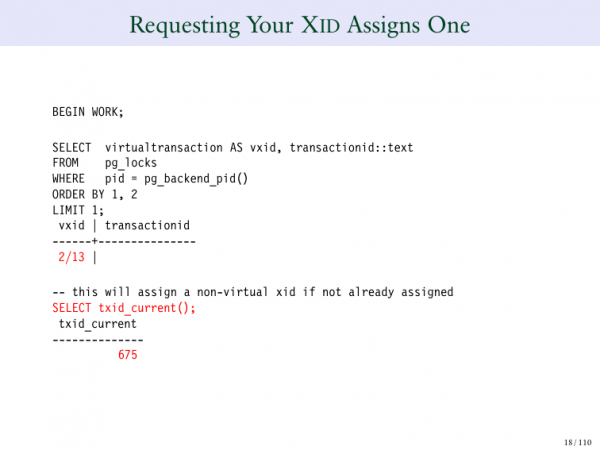
Så her er endnu en forespørgsel, endnu en transaktion. Det virtuelle transaktionsnummer er 2/13. Og hvis jeg beder om det permanente transaktions-ID, så vil jeg få det, når jeg kører forespørgslen.
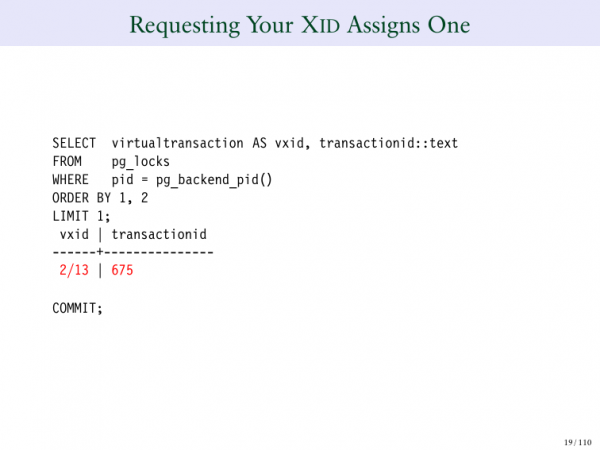
Så endnu en gang. Vi har det virtuelle transaktions-ID og det permanente transaktions-ID. Bare forstå dette punkt for at forstå Postgres' adfærd.
Vi går videre til det tredje afsnit. Her vil vi kort gennemgå de forskellige typer af låsninger i Postgres. Det er ikke meget interessant. Det sidste afsnit bliver langt mere interessant. Men vi skal tage de grundlæggende ting i betragtning, for ellers vil vi ikke forstå, hvad der kommer næste gang.
Vi vil dække dette afsnit, vi vil se på hver type låsning. Og jeg vil vise jer eksempler på, hvordan de etableres, hvordan de fungerer, og vise jer nogle forespørgsler, som kan bruges til at se, hvordan låsning fungerer i Postgres.
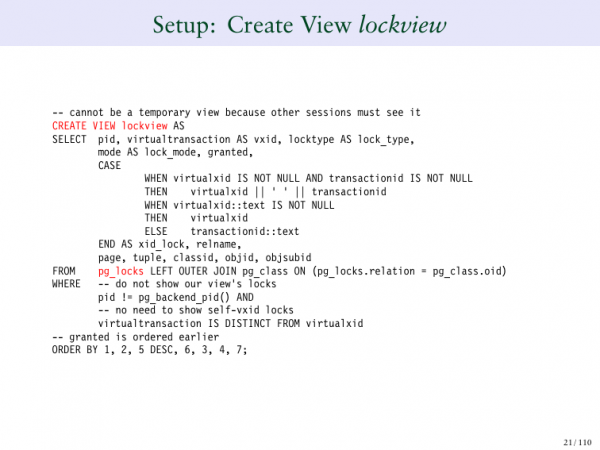
For at oprette en forespørgsel og se, hvad der sker i Postgres, skal vi køre en forespørgsel på systemvisningen. I dette tilfælde er pg_lock markeret med rødt. Pg_lock er en systemtabel, der fortæller os, hvilke låsninger der i øjeblikket er aktive i Postgres.
Det er dog meget svært for mig at vise jer pg_lock i sig selv, fordi det er ret komplekst. Derfor har jeg oprettet en visning, der viser pg_locks. Og det udfører også noget arbejde for mig, som gør det lettere for mig at forstå. Det vil sige, at det udelukker mine egne låsninger, min egen session osv. Dette er blot standard SQL, og det giver mig bedre mulighed for at vise jer, hvad der foregår.
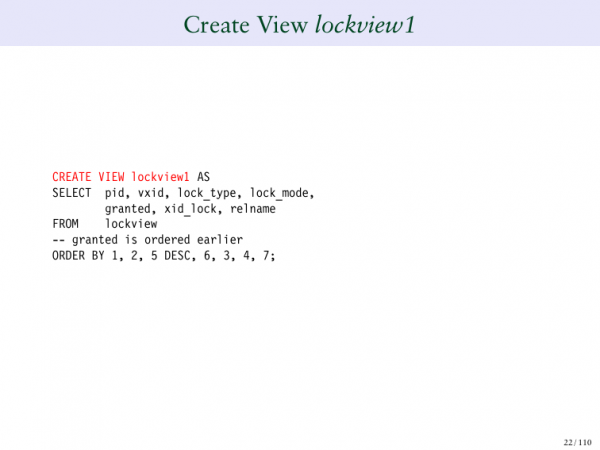
En anden udfordring er, at denne visning er meget bred, så jeg må oprette en anden – lockview2.
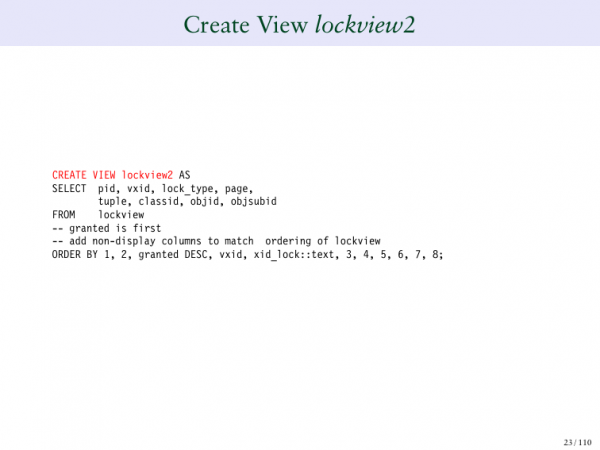 Og den viser mig flere kolonner fra tabellen. Og endnu en, der viser mig de øvrige kolonner. Det er temmelig kompliceret, så jeg har forsøgt at præsentere det så simpelt som muligt.
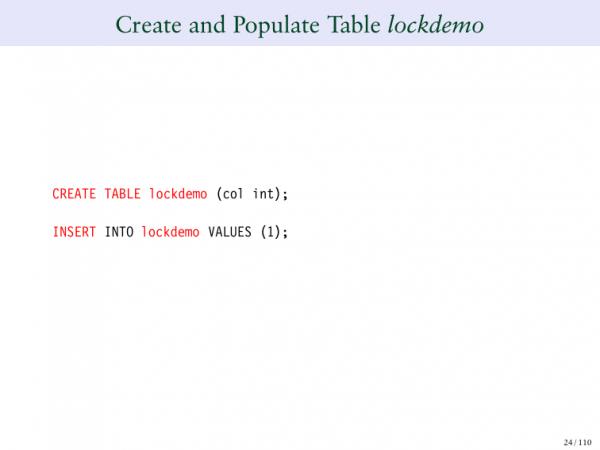
Så vi har oprettet en tabel kaldet Lockdemo. Og vi har oprettet én række der. Det er vores eksempel tabel. Og vi vil oprette afsnit for blot at vise jer eksempler på låsninger.
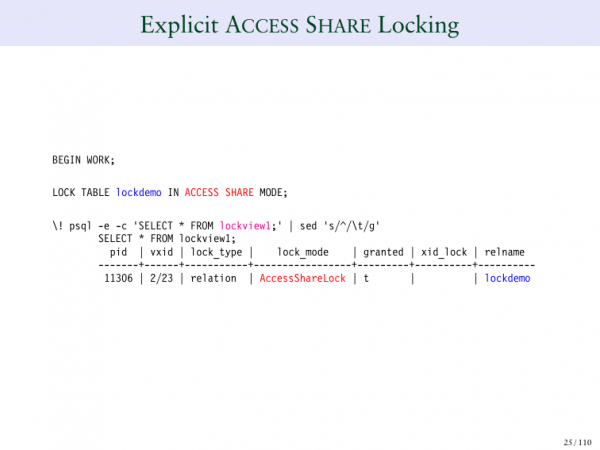
Så en række, en kolonne. Den første type låsning kaldes ACCESS SHARE. Dette er den mindst begrænsende låsning. Det betyder, at den næsten ikke konflikter med andre låsninger.
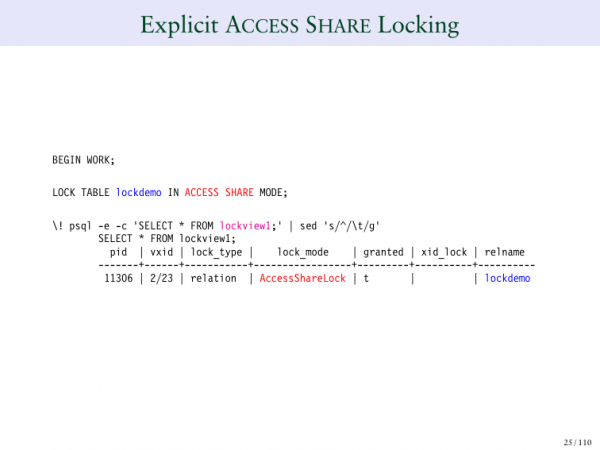
Og hvis vi vil eksplicit definere låsningen, kører vi kommandoen «lock table». Den vil tydeligt låse, dvs. i ACCESS SHARE-tilstand kører vi lock table. Hvis jeg kører PSQL i baggrunden, starter jeg dermed en anden session fra min første session. Hvad gør jeg her? Jeg skifter til den anden session og siger til den «vis mig lockview for denne forespørgsel». Her har jeg AccessShareLock i denne tabel. Det er lige præcis, hvad jeg bad om. Og den siger, at låsen er tildelt. Meget enkelt.
Derefter, hvis vi ser på den anden kolonne, er der intet. De er tomme.
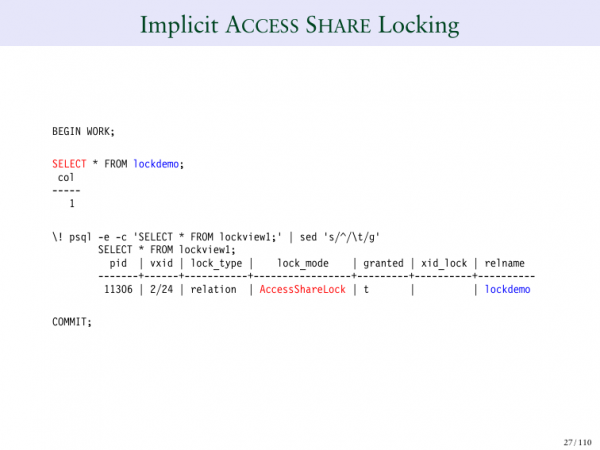
Og hvis jeg kører kommandoen «SELECT», er det en implicit (explicit) måde at anmode om AccessShareLock. Så jeg låser min tabel og kører forespørgslen, og forespørgslen returnerer flere rækker. Og i en af rækkerne ser vi AccessShareLock. Således udløser SELECT AccessShareLock i tabellen. Og den konflikter stort set med ingenting, fordi det er en lav-niveau lås.
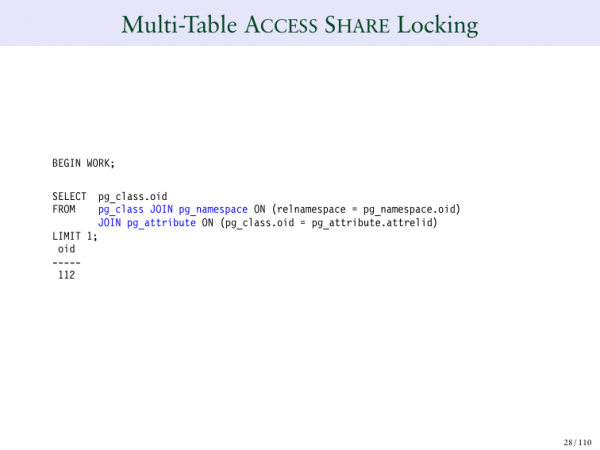
Hvad hvis jeg kører SELECT, og jeg har tre forskellige tabeller? Tidligere kørte jeg kun en tabel, nu kører jeg tre: pg_class, pg_namespace og pg_attribute.
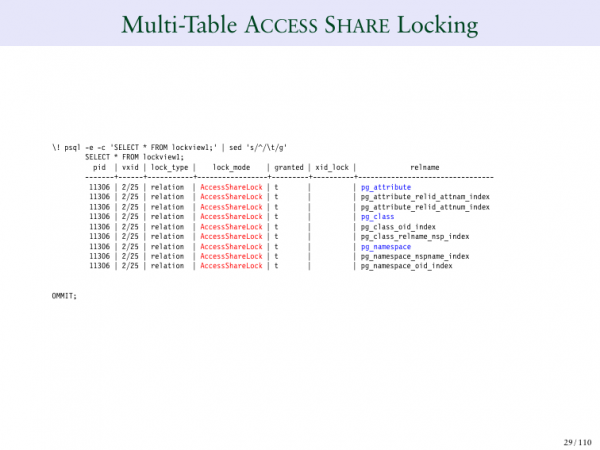
Og nu, når jeg ser på forespørgslen, ser jeg 9 AccessShareLocks i de tre tabeller. Hvorfor? Tre tabeller er fremhævet med blå: pg_attribute, pg_class, pg_namespace. Men du kan også se, at alle indekser, der er defineret gennem disse tabeller, også har AccessShareLock.
Og det er en lås, der stort set ikke konflikter med andre. Alt, hvad den gør, er at forhindre os i at nulstille tabellen, mens vi vælger den. Det giver mening. Dvs. hvis vi vælger en tabel, så forsvinder den på det tidspunkt, hvilket ville være forkert, derfor AccessShare er en lav-niveau lås, der siger "slet ikke denne tabel, mens jeg arbejder". I bund og grund er det alt, hvad den gør.
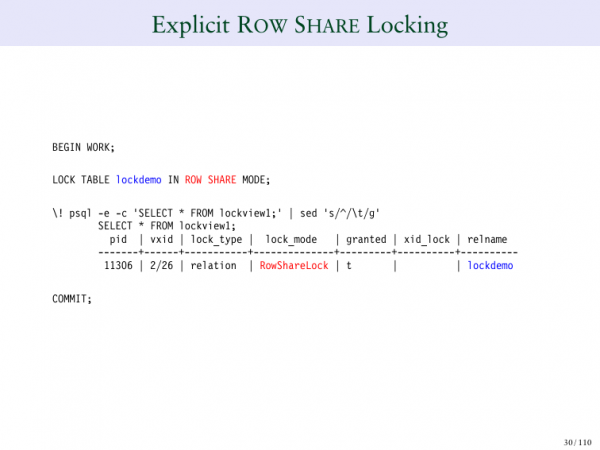
ROW SHARE er en lidt anderledes lås.
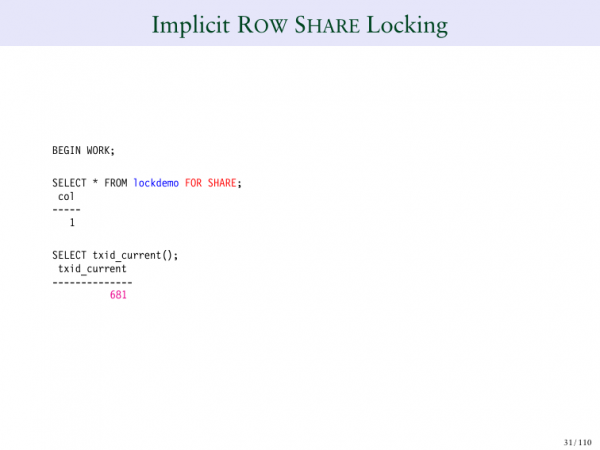
Lad os tage et eksempel. SELECT ROW SHARE er en måde at låse hver række enkeltvis på.. Således kan ingen slette eller ændre dem, mens vi ser på dem.
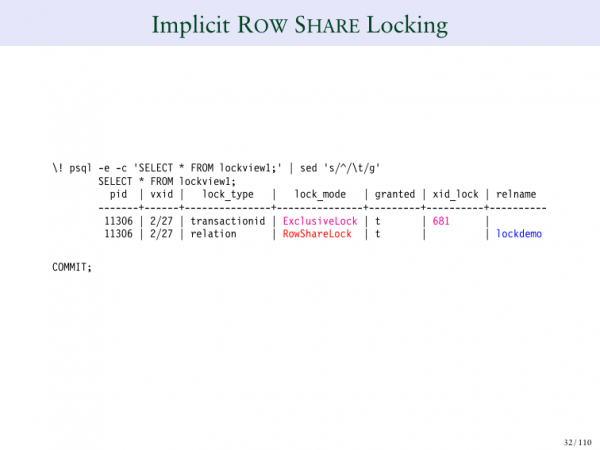 Så, hvad gør SHARE LOCK? Vi ser, at transaktions-ID 681 er brugt til SELECT. Og det er interessant. Hvad er der sket her? For første gang ser vi et nummer i 'Lock'-feltet. Vi tager transaktions-ID'et, og det siger, at det låser den eksklusivt. Alt, hvad det gør, er at sige, at jeg har en række, der teknisk set er låst et sted i tabellen. Men det siger ikke, hvor præcist. Senere vil vi se nærmere på dette.
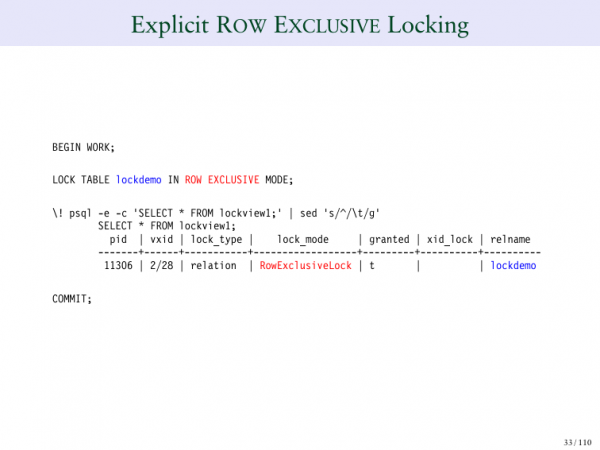
Her siger vi, at låsningen bruges af os.
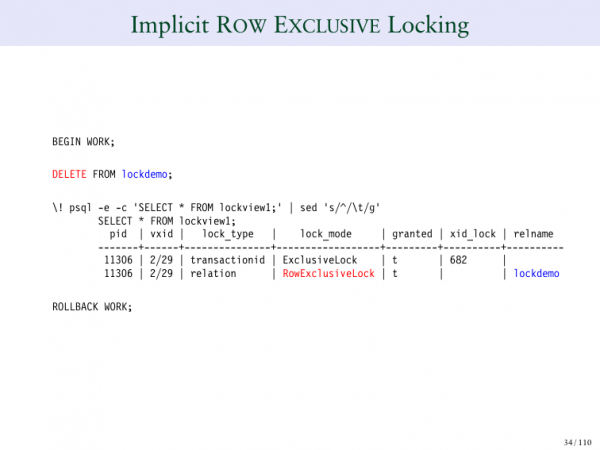
Så den eksklusive lås siger eksplicit, at den er eksklusiv. Og hvis du sletter en række i denne tabel, så vil det også ske, som du kan se.
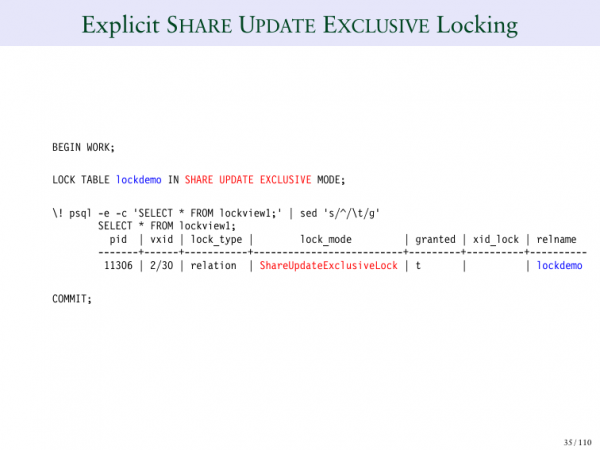
SHARE EXCLUSIVE – det er en længere lås.
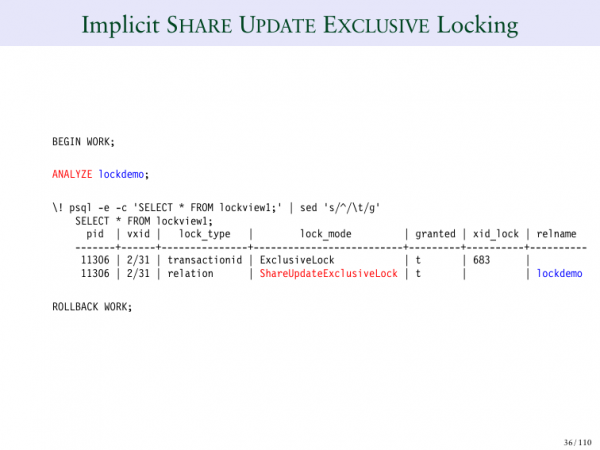
Dette (ANALYZE) er en analysekommando, der vil blive brugt.
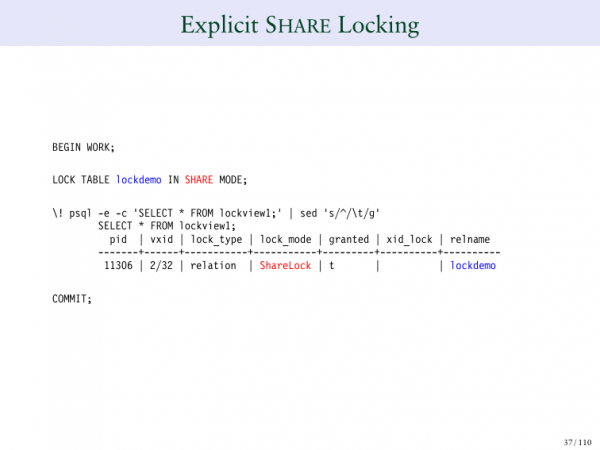
SHARE LOCK – du kan eksplicit låse i delingsmode.
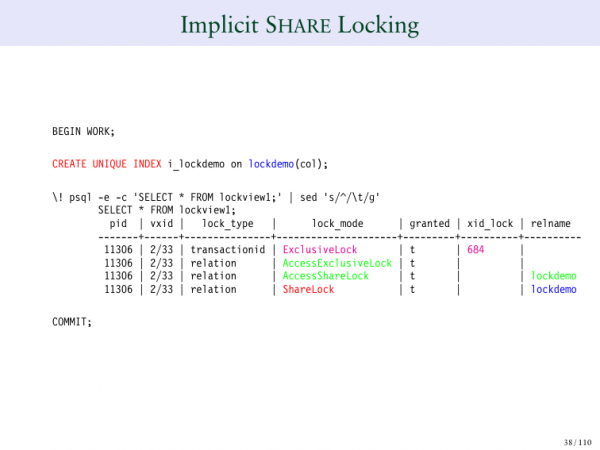
Du kan også oprette en unik indeks. Og der kan du se SHARE LOCK, som er en del af dem. Og den låser tabellen og sætter en SHARE LOCK på den.
Som standard betyder SHARE LOCK på tabellen, at andre kan læse tabellen, men ingen kan ændre den. Og det er præcis, hvad der sker, når du opretter en unik indeks.
Hvis jeg opretter en unik concurrently indeks, så vil jeg have en anden type lås, fordi, som du husker, reducerer brugen af concurrently indekser låsekravene. Og hvis jeg bruger normal lås, normal indeks, så forhindrer jeg dermed skrivning til indeks-tabellen under dens oprettelse. Hvis jeg bruger concurrently indeks, så skal jeg bruge en anden type lås.
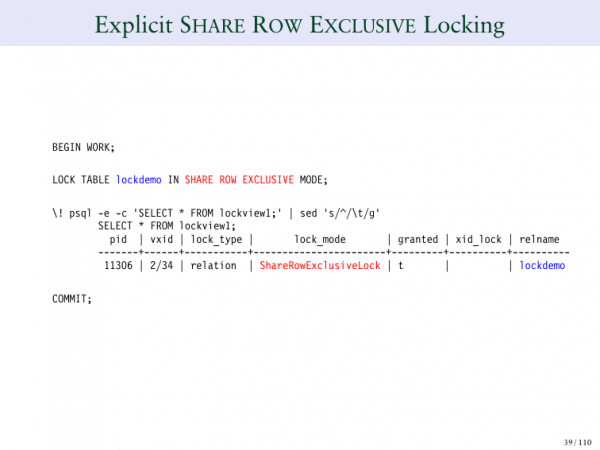
SHARE ROW EXCLUSIVE – den kan igen angives eksplicit.
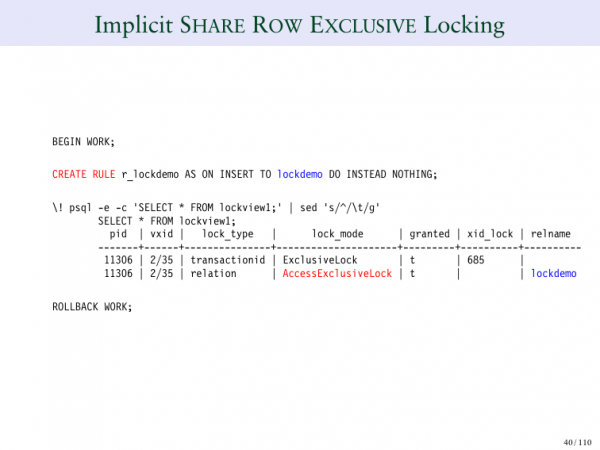
Eller vi kan oprette en regel, dvs. tage en bestemt situation, hvor den vil blive brugt.
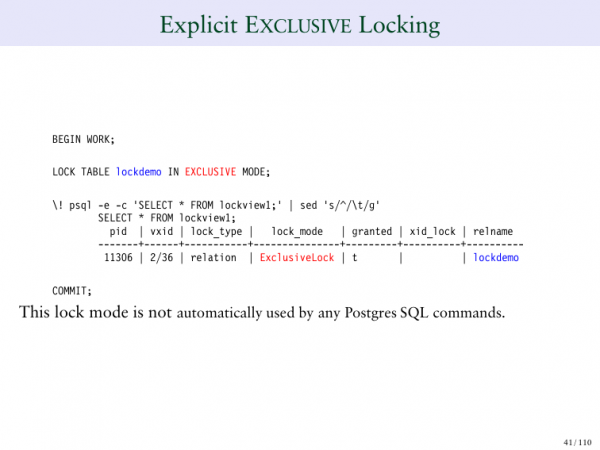
EXCLUSIVE-lås betyder, at ingen andre kan ændre tabellen.
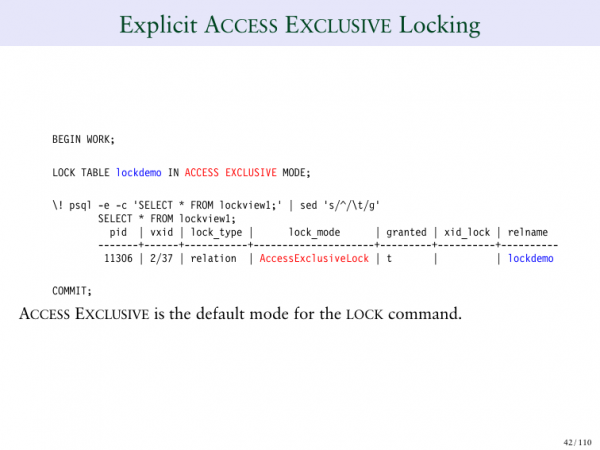
Her ser vi forskellige typer låse.
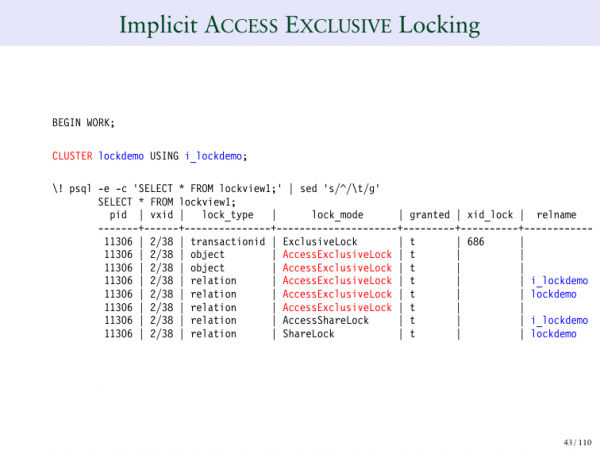
ACCESS EXCLUSIVE, for eksempel, er en låsekommando. For eksempel, hvis du laver CLUSTER table, så betyder det, at ingen vil kunne skrive til det. Og den låser ikke kun selve tabellen, men også indeksene.
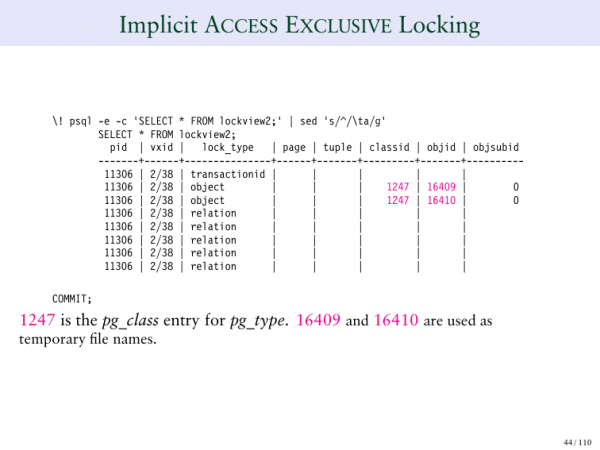
Dette er den anden side af ACCESS EXCLUSIVE-lås, hvor vi præcist ser, hvad den låser i tabellen. Den låser individuelle rækker i tabellen, hvilket er ret interessant.
Dette er alle de grundlæggende oplysninger, jeg ønskede at give. Vi har talt om blokeringer, om transaktions-ID'er, vi talte om virtuelle transaktions-ID'er, om permanente transaktions-ID'er.
Og nu vil vi gennemgå eksempler på blokeringer. Dette er den mest interessante del. Vi vil se på meget interessante tilfælde. Og mit mål med denne præsentation er at give dig en bedre forståelse af, hvad Postgres faktisk gør, når det forsøger at blokere visse ting. Jeg synes, det klarer at blokere individuelle dele meget godt.
Lad os se på nogle konkrete eksempler.
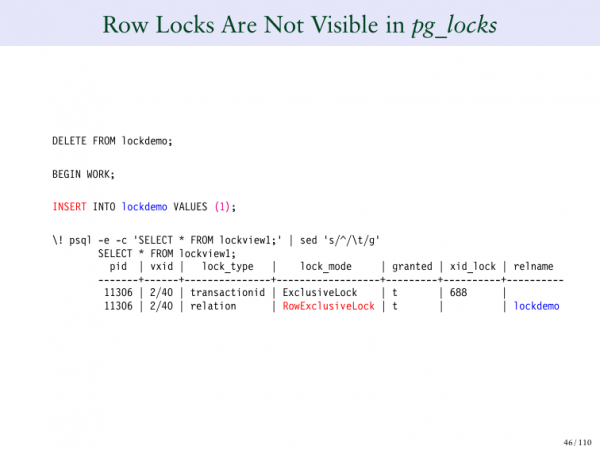
Vi starter med tabeller og en enkelt række i tabellen. Når jeg indsætter noget, får jeg vist ExclusiveLock, transaktions-ID'et og ExclusiveLock på tabellen.
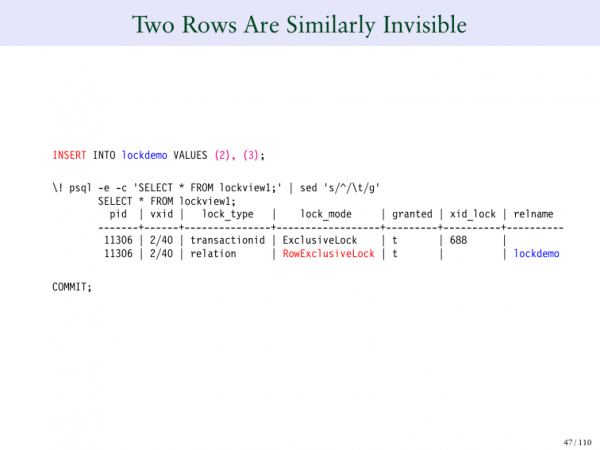
Hvad sker der, hvis jeg indsætter to rækker mere? Og nu har vi tre rækker i vores tabel. Jeg indsatte én række og fik dette som output. Og hvis jeg indsætter to rækker mere, hvad er der så mærkeligt ved dette? Der er en underlighed, fordi jeg har tilføjet tre rækker til denne tabel, men jeg har stadig to rækker i blokeringstabellen. Og det er i bund og grund det grundlæggende adfærdsmønster i Postgres.
Mange tror, at hvis du i databasen blokerer 100 rækker, så skal du lave 100 blokeringer. Hvis jeg blokerer 1.000 rækker på én gang, så er jeg nødt til at lave 1.000 sådanne forespørgsler. Og hvis jeg har brug for at blokere en million eller milliard. Men hvis vi gør det, vil det ikke fungere særlig godt. Hvis du har brugt et system, der opretter blokeringer for hver enkelt række, kan du se, at det er kompliceret. Fordi du skal definere blokeringstabellen på én gang, som kan løbe over, men Postgres gør ikke sådan.
Og på denne slide er det meget vigtigt, at det her tydeligt viser, at der er et andet system, der arbejder indenfor MVCC, som blokerer individuelle rækker. Derfor, når du blokerer milliarder af rækker, skaber Postgres ikke en milliard separate blokeringer. Og det påvirker ydeevnen meget positivt.
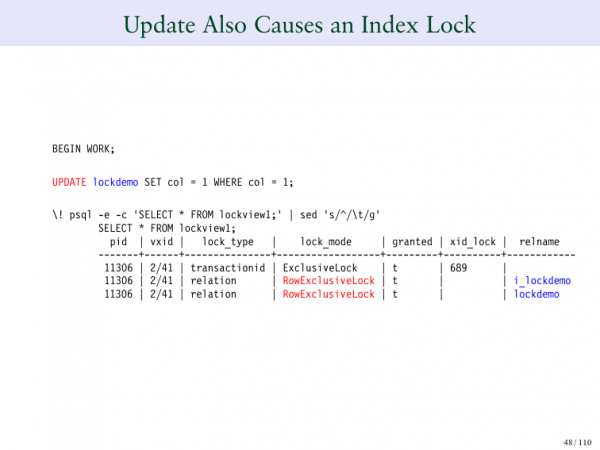
Hvordan er det med opdatering? Jeg opdaterer lige nu en række, og du kan måske bemærke, at den straks udførte to forskellige operationer. Den har samtidig låst tabellen, men den har også låst indekset. Og den skulle låse indekset, fordi der er unikke begrænsninger på denne tabel. Vi vil sikre os, at ingen ændrer det, derfor låser vi det.
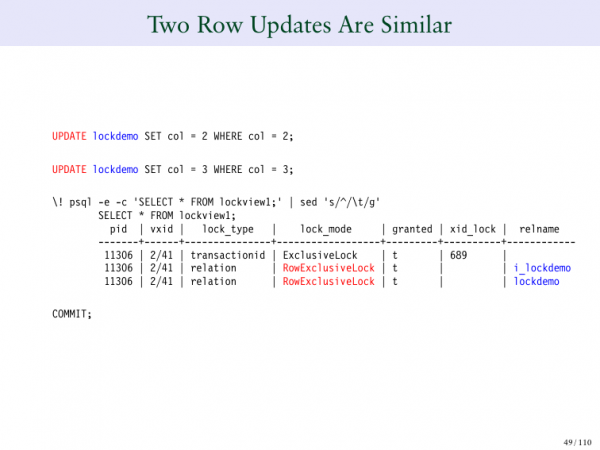
Hvad hvis jeg vil opdatere to rækker? Og vi ser, at den opfører sig det samme. Vi udfører dobbelt så mange opdateringer, men det samme antal låserækker.
Hvis du er interesseret i, hvordan Postgres gør det, skal du lytte til mine præsentationer om MVCC for at lære, hvordan Postgres internt markerer de rækker, den ændrer. Og Postgres har en måde, hvorpå den gør det, men den gør det ikke på tabelniveau, men på et lavere og mere effektivt niveau.
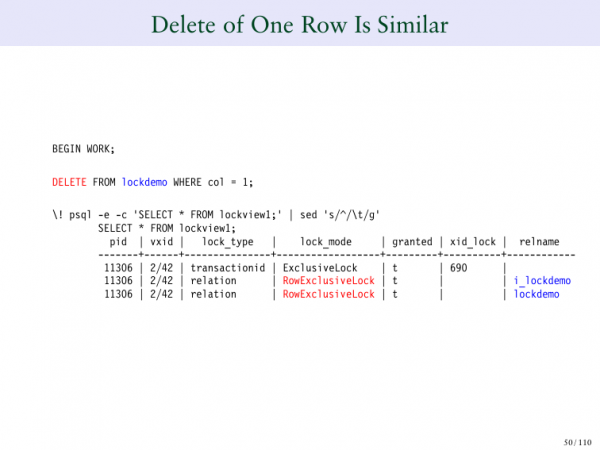
Og hvis jeg vil slette noget? Hvis jeg sletter for eksempel én række, og jeg stadig har mine to låseindgange, så selvom jeg ønsker at slette dem alle, er de stadig der.
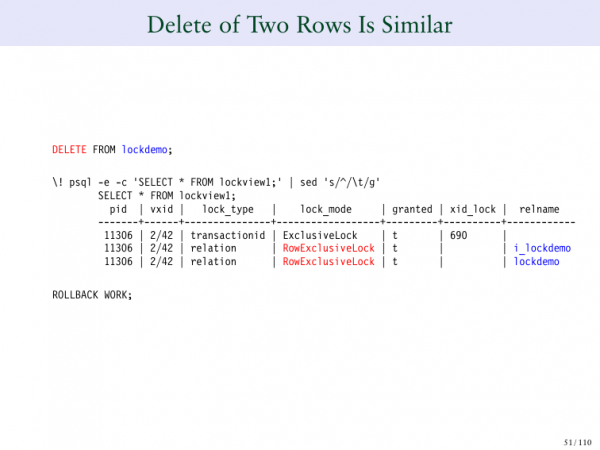
For eksempel, hvis jeg vil indsætte 1.000 rækker, og derefter slette eller tilføje 1.000 rækker, så registreres de individuelle rækker, jeg tilføjer eller ændrer, ikke her. De registreres på et lavere niveau inden i selve rækken. Og under præsentationen om MVCC talte jeg om dette i detaljer. Men det er meget vigtigt, når du analyserer låse, at sikre, at du har en lås på tabelniveau, og at du ikke ser, hvordan individuelle rækker registreres her.
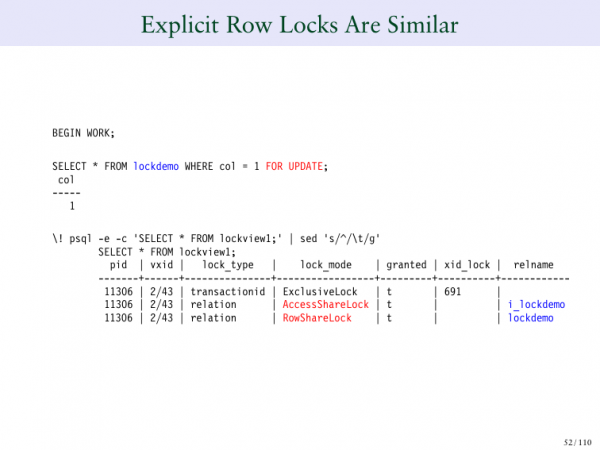
Hvad med eksplicit låsning?
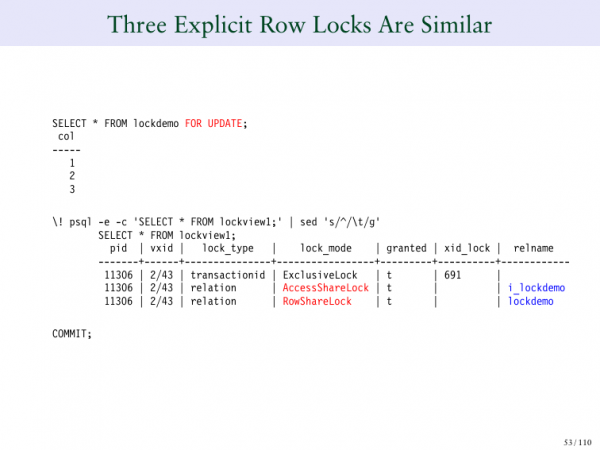
Hvis jeg trykker på 'opdater', har jeg to låste rækker. Og hvis jeg markerer dem alle og trykker på 'opdater alle', har jeg stadig to låseposter tilbage.
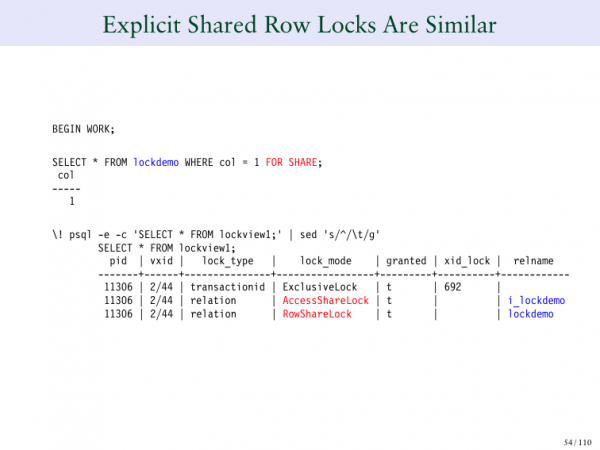
Vi opretter ikke separate poster for hver enkelt række. For ellers falder ydeevnen, der kan blive for meget af det. Og vi kan havne i en uheldig situation.
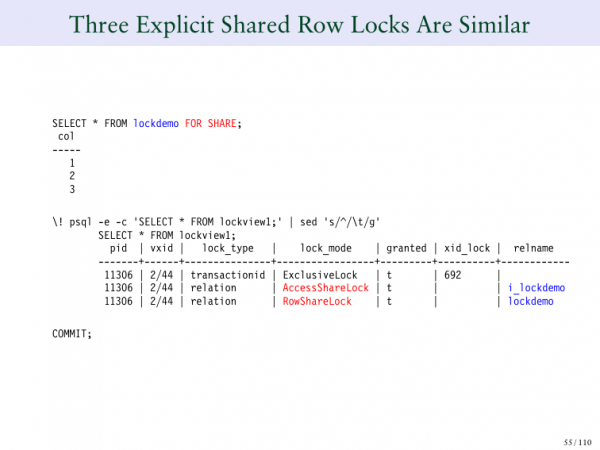
Og det samme, hvis vi gør det shared, kan vi gøre det på alle 30 gange.
Vi gendanner vores tabel, sletter alt, og så indsætter vi én række igen.
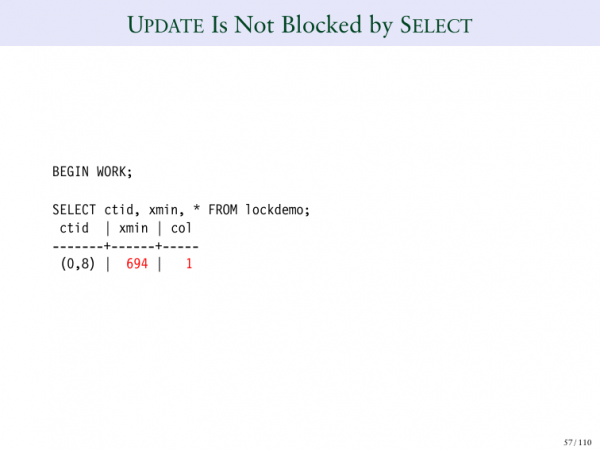
En anden opførsel, som du ser i Postgres, er en meget velkendt og ønsket adfærd – det vil sige, at du kan udføre update eller select. Og du kan gøre det samtidigt. Og select blokerer ikke update, og det samme gælder omvendt. Vi siger, at læseren ikke blokerer for den, der skriver, og den, der skriver, blokerer ikke læseren.
Jeg vil vise dig et eksempel på dette. Jeg vil nu lave et valg. Vi vil senere lave et INSERT. Og du vil derefter kunne se – 694. Du vil kunne se ID for den transaktion, der udførte denne indsættelse. Og det er sådan, det fungerer.
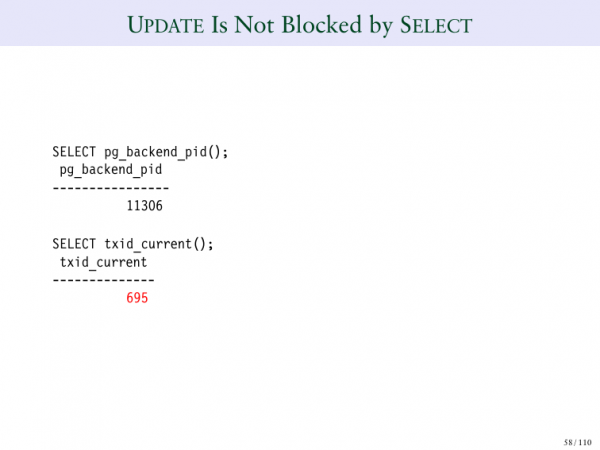
Og hvis jeg nu kigger på mit backend ID, så er det blevet – 695.
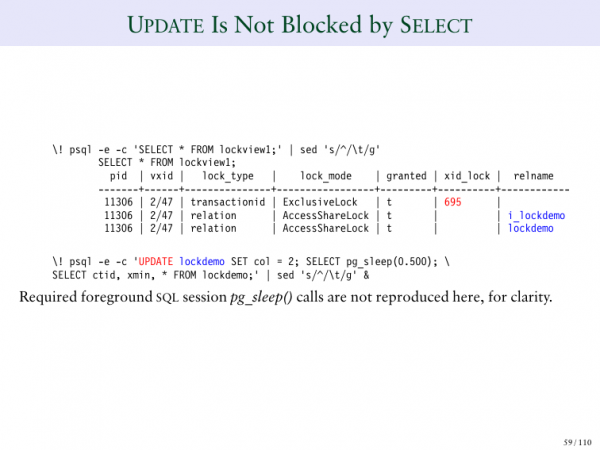
Og jeg kan se, at 695 vises i min tabel.
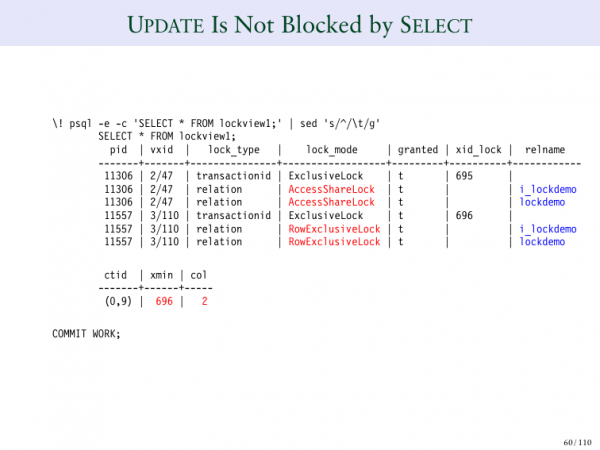
Og hvis jeg udfører en opdatering her på denne måde, så får jeg et andet tilfælde. I dette tilfælde er 695 en eksklusiv lås, og opdateringen har samme adfærd, men der opstår ikke konflikt mellem dem, hvilket er ret usædvanligt.
Og du kan bemærke, at øverst – det er ShareLock, og nederst – det er ExclusiveLock. Og begge transaktioner blev gennemført.
Og du bør lytte til mit foredrag om MVCC for at forstå, hvordan det sker. Men dette er en illustration af, at du kan gøre dette samtidigt, dvs. både udføre SELECT og UPDATE.
Lad os nulstille og lave en operation én gang til.
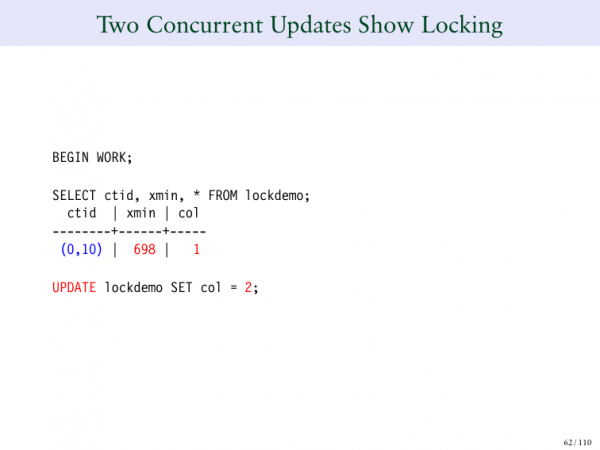
Hvis du prøver at køre to updates på samme række samtidigt, så vil det blive låst. Og husk, jeg sagde, at læseren ikke blokerer for skribenten, men skribenten blokerer for læseren, men én skribent blokerer en anden skribent. Det vil sige, at vi ikke kan have to personer, der samtidig opdaterer den samme række. Vi skal vente, indtil en af dem er færdig.
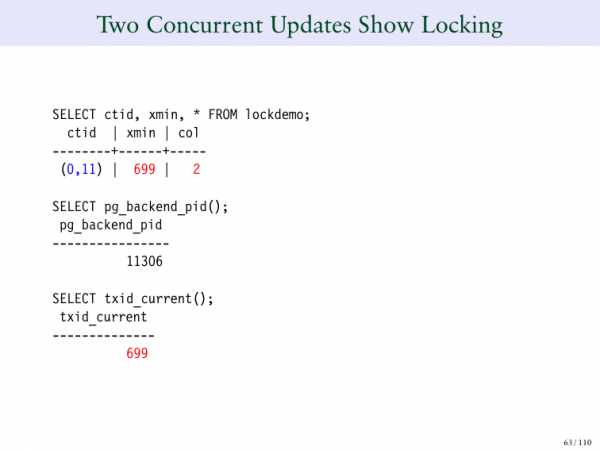
Og for at illustrere dette vil jeg kigge på Lockdemo-tabellen. Og vi vil se på én række. På transaktion 698.
Vi opdaterede det til 2. 699 – det første opdatering. Og det blev gennemført med succes, eller det er i en ventende transaktion og venter på, at vi bekræfter eller annullerer.
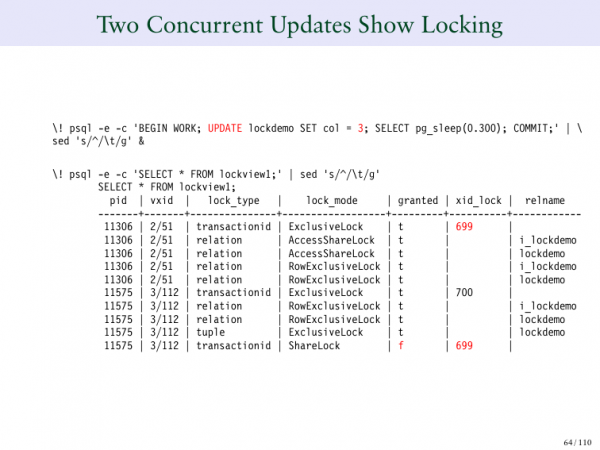
Men se på noget andet – 2/51 – det er vores første transaktion, vores første session. 3/112 – det er den anden forespørgsel, der dukkede op ovenfor og som ændrede denne værdi til 3. Og hvis du bemærker, så blokerede den øverste sig selv, som er 699. Men 3/112 gav ikke nogen blokering. I kolonnen Lock_mode står der, at den venter. Den venter på 699. Og hvis du ser, hvor 699 er, er det ovenover. Og hvad gjorde den første session? Den oprettede en eksklusiv blokering på sin egen transaktions-ID. Det er sådan, Postgres gør det. Den blokerer sin egen transaktions-ID. Og hvis du vil vente på, at nogen bekræfter eller annullerer, skal du vente, indtil der er en ventende transaktion. Og derfor kan vi se den mærkelige linje.
Lad os se på det igen. Til venstre ser vi vores behandlings-ID. I den anden kolonne ser vi vores virtuelle transaktions-ID, og i den tredje ser vi lock_type. Hvad betyder det? I bund og grund siger den, at den blokerer transaktions-ID'et. Men bemærk, at der i alle rækkerne nedenunder står relation. Og derfor har du to slags blokering i tabellen. Der er relation blokering. Og der er også transactionid blokering, hvor du blokerer dig selv, det er netop hvad der sker i den første række eller i bunden, hvor transationid er, hvor vi venter på, at 699 afslutter sin operation.
Jeg ser, hvad der sker her. Og der sker to ting på én gang. Du ser på blokeringen af transaktions-ID'et i den første række, som blokerer sig selv. Og den blokerer sig selv for at få folk til at vente.
Hvis du ser på den 6. række, så er det samme optegnelse som den første. Og derfor blokeres transaktion 699. 700 blokerer også sig selv. Og så vil du i den nederste række se, at vi venter på, at 699 afslutter sin operation.
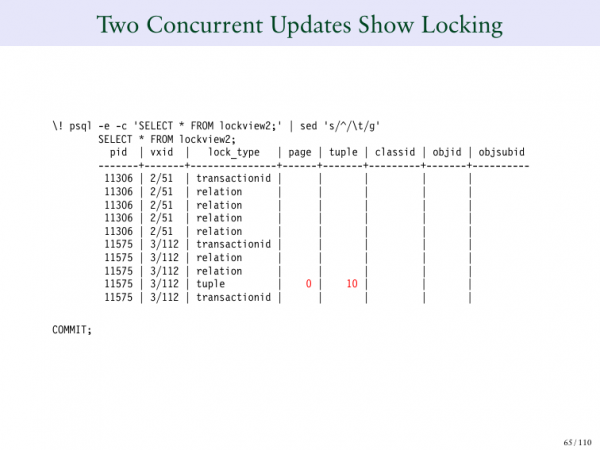
Og i lock_type, tuple kan du se numrene.
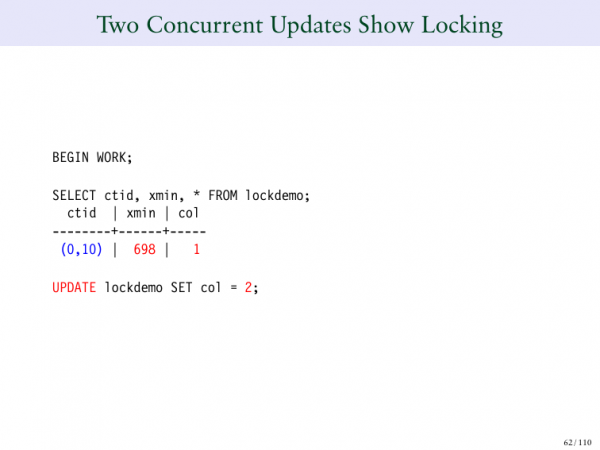
Du kan se, at det er 0/10. Og det er sidenummeret, og også offset for denne specifikke række.
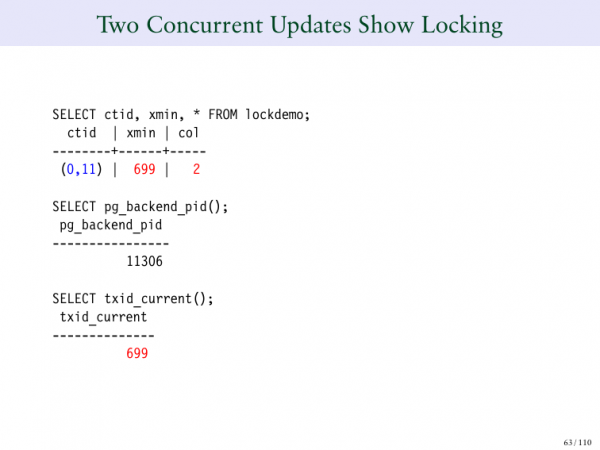
Og du ser, at det bliver 0/11, når vi opdaterer.
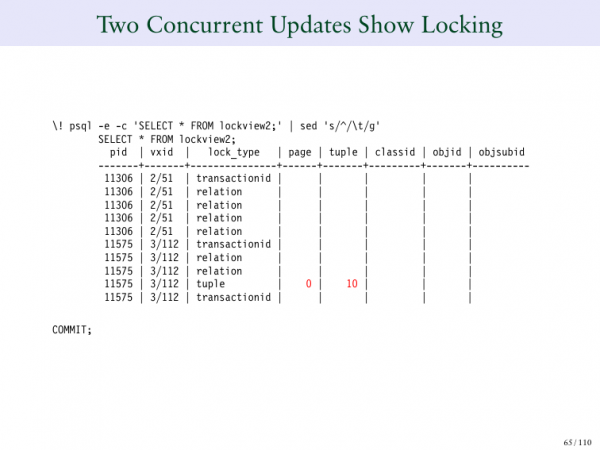
Men i virkeligheden – det er 0/10, fordi denne operation venter. Vi har mulighed for at se, at det er den række, som jeg venter på at bekræfte.
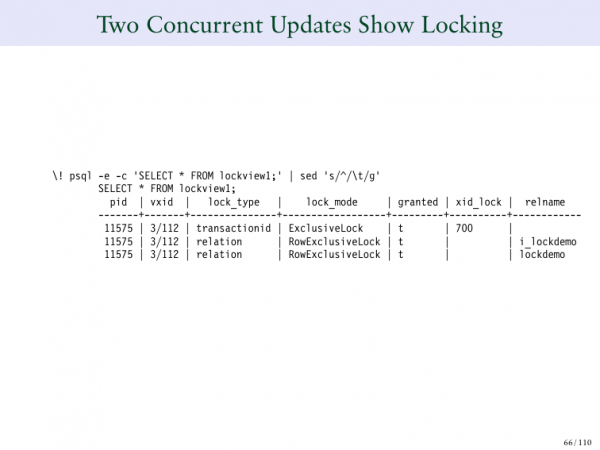
Så snart vi bekræfter det og klikker på commit, og når opdateringen er færdig, er dette, hvad vi får tilbage. Transaktion 700 er den eneste lås, den venter ikke på nogen, fordi den er blevet bekræftet. Den venter blot på, at transaktionen afsluttes. Så snart 699 er færdig, venter vi ikke længere. Og nu siger transaktion 700, at alt er i orden, at alle de nødvendige låse er tilgængelige i alle tilladte tabeller.
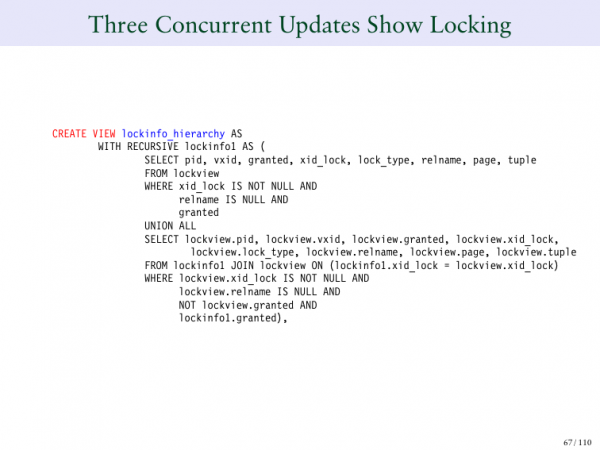
Og for at gøre det hele endnu mere kompliceret, opretter vi endnu en view, der denne gang vil give os hierarkiet. Jeg forventer ikke, at du forstår denne forespørgsel. Men det vil give os et klarere billede af, hvad der foregår.
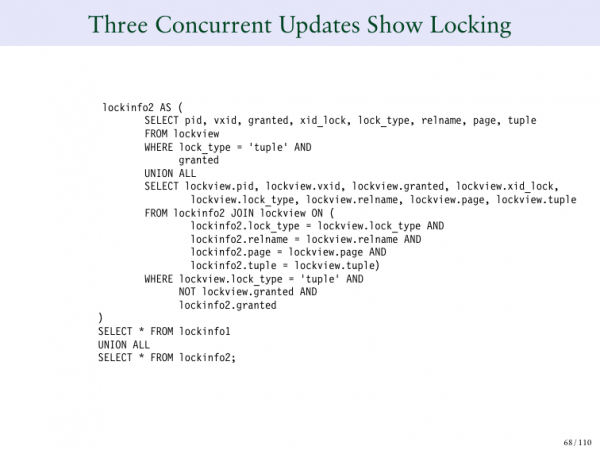
Dette er et rekursivt view, som også har endnu en sektion. Og det samler så alt sammen igen. Lad os bruge det.
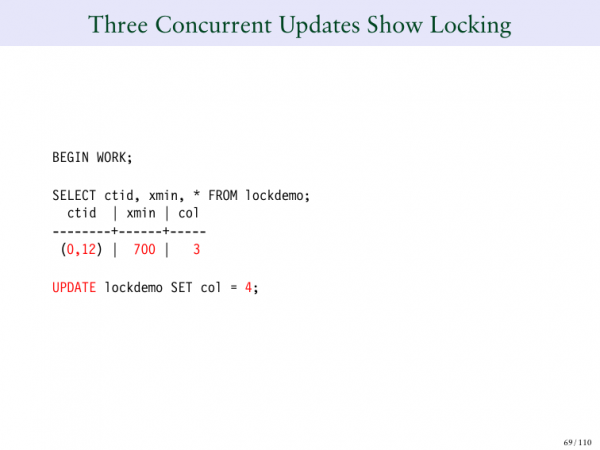
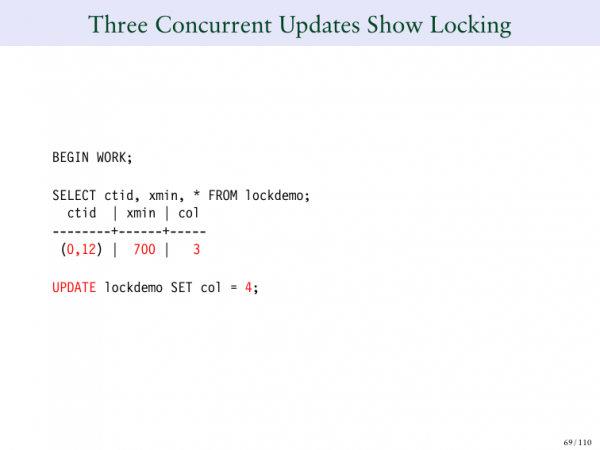
Hvad hvis vi laver tre samtidige opdateringer og siger, at rækken nu er lig med tre. Og vi ændrer 3 til 4.
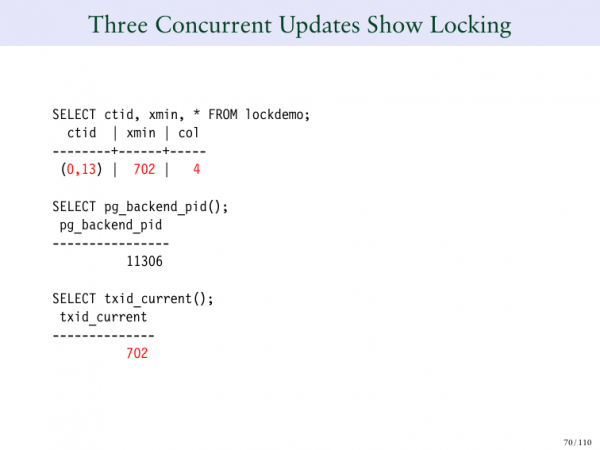
Og her ser vi 4. Og transaktions-ID 702.
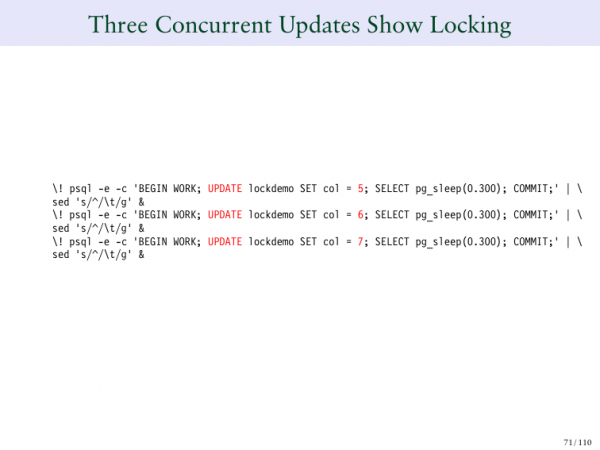
Og så ændrer jeg 4 til 5. Og 5 til 6, og 6 til 7. Og jeg stiller en række mennesker i kø, der venter på, at denne ene transaktion bliver afsluttet.
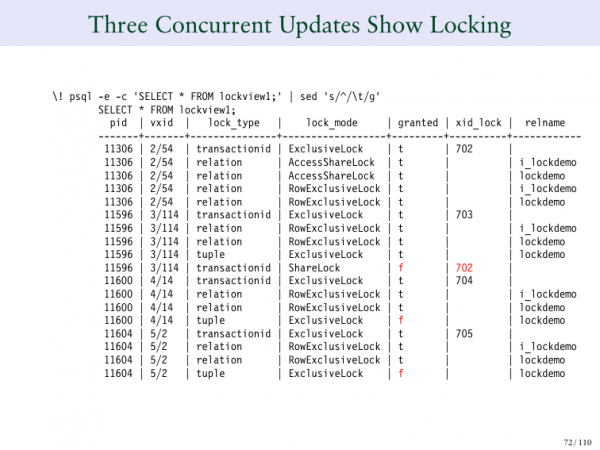
Og alt bliver klart. Hvad er den første række? Det er 702. Det er transaktions-ID'et, der oprindeligt satte denne værdi. Og hvad står der i kolonnen Granted? Jeg har bemærkninger f. Det er mine opdateringer, der (5, 6, 7) ikke kan godkendes, fordi vi venter på, at transaktions-ID 702 afslutter. Der har vi en lås på transaktions-ID. Og der resulterer i 5 transaktionslås-ID'er.
Og hvis du ser på 704, på 705, så er der stadig ikke skrevet noget, fordi de stadig ikke ved, hvad der foregår. De skriver bare, at de ikke aner, hvad der sker. Og de vil bare gå i dvale, fordi de venter på, at nogen afslutter og vækker dem, når det bliver muligt at ændre rækken.
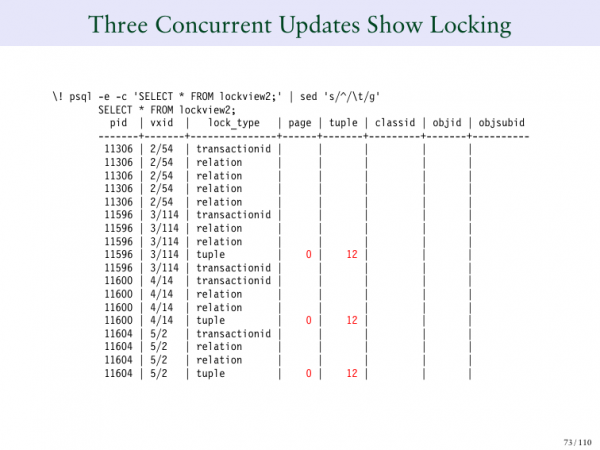
Sådan ser det ud. Det er klart, at de alle venter på række 12.
Det er hvad vi så her. Her er 0/12.
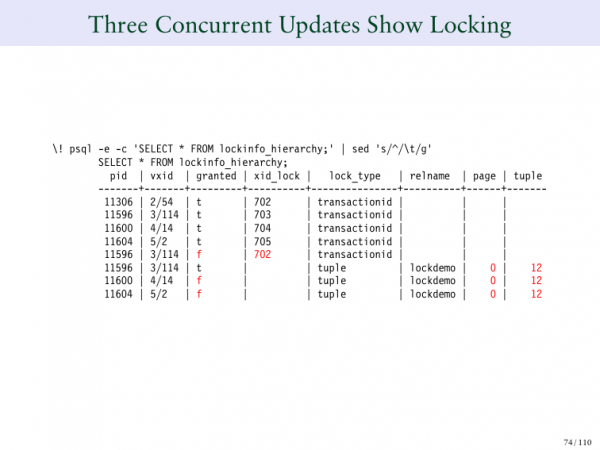
Og så snart den første transaktion er godkendt, kan du her se, hvordan hierarkiet fungerer. Og nu bliver alt klart. De alle bliver rene. Og de er faktisk stadig i venteposition.
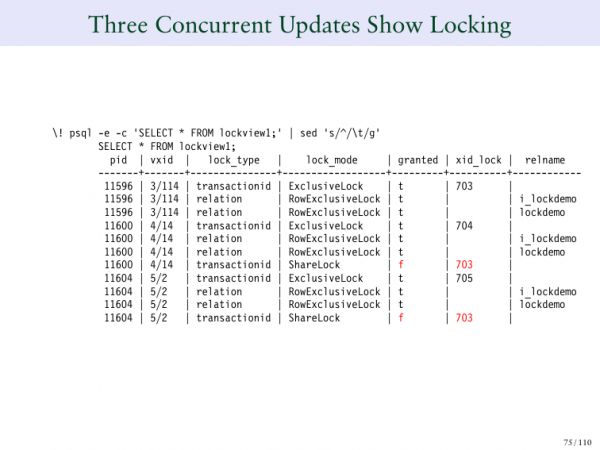
Dette er, hvad der sker. 702 begynder at committe. Og nu får 703 denne række-lås, og så begynder 704 at vente på, at 703 committer. 705 venter også på dette. Og når det hele afsluttes, rydder de selv op. Jeg vil gerne påpege, at alle stiller sig i kø. Det ligner meget en trafikprop, hvor alle venter på den første bil. Den første bil stopper, og alle stiller sig i en lang række. Så bevæger den sig, hvorefter den næste bil kan køre frem og få sin lås osv.
Og hvis du syntes, det var ikke kompliceret nok, så skal vi nu tale om deadlocks. Jeg ved ikke, hvem af jer der har oplevet dette. Det er et ret almindeligt problem i databasesystemer. Men deadlocks opstår, når en session venter på, at en anden session udfører noget. I mellemtiden venter den anden session på, at den første session udfører noget.
For eksempel, hvis Ivan siger: “Giv mig noget”, og jeg siger: “Nej, jeg giver dig kun dette, hvis du giver mig noget andet”. Og han siger: “Nej, jeg giver dig ikke dette, medmindre du giver mig”. Så ender vi i en død låsesituation. Jeg er sikker på, at Ivan ikke ville gøre det, men du forstår pointen, at vi har to personer, der ønsker at få noget, og de er ikke villige til at give det, før den anden person giver dem, hvad de ønsker. Og der er ingen løsning.
I det væsentlige skal din database opdage dette. Og så skal den lukke eller afslutte en af sessionerne, fordi ellers bliver de hængende der for evigt. Dette ser vi i databaser, vi ser det i operativsystemer. Og alle steder, hvor vi har parallelle processer, kan dette ske.
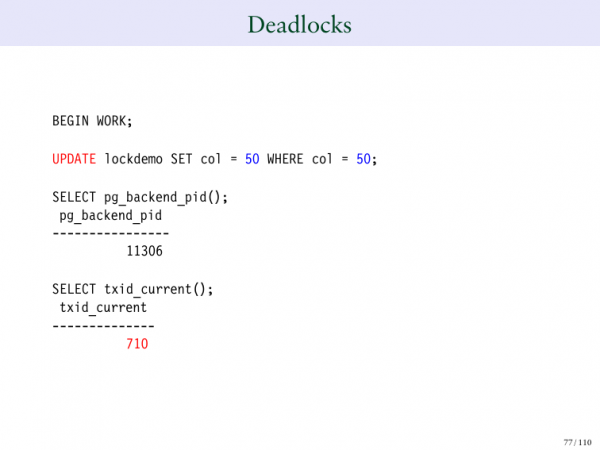
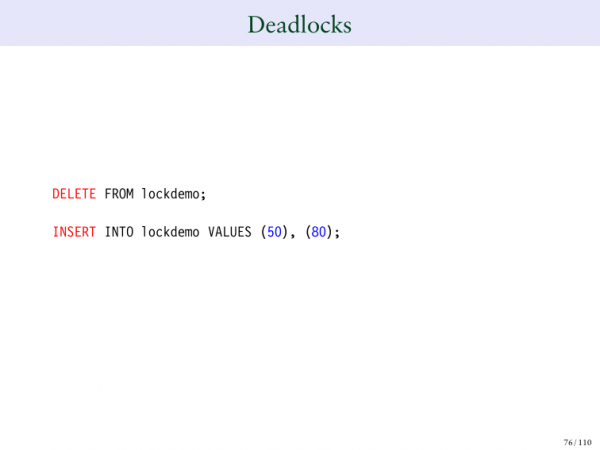
Og nu vil vi sætte to deadlocks. Vi vil sætte 50 og 80. I første række vil jeg udføre en opdatering fra 50 til 50. Jeg får transaktionsnummeret 710.
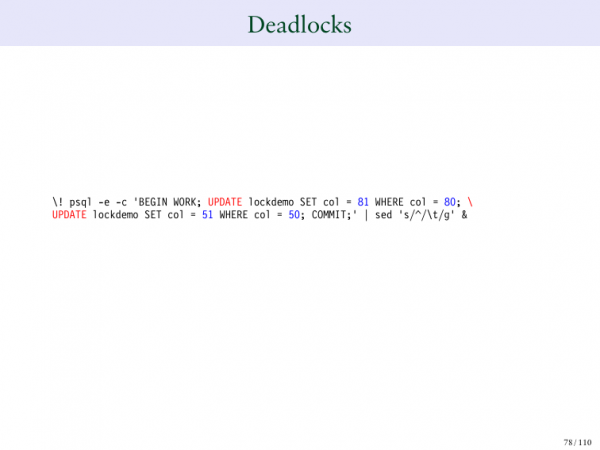
Og så vil jeg ændre 80 til 81, og 50 til 51.
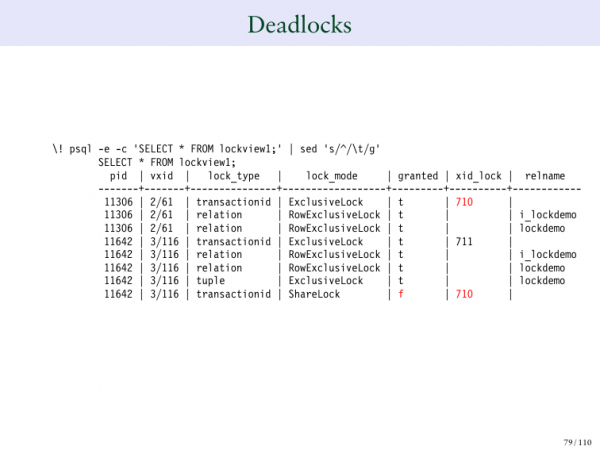
Og sådan vil det se ud. Derfor har 710 en række-lås, og 711 venter på bekræftelse. Vi så det, da vi opdaterede. 710 er ejer af vores række. Og 711 venter på, at 710 afslutter transaktionen.
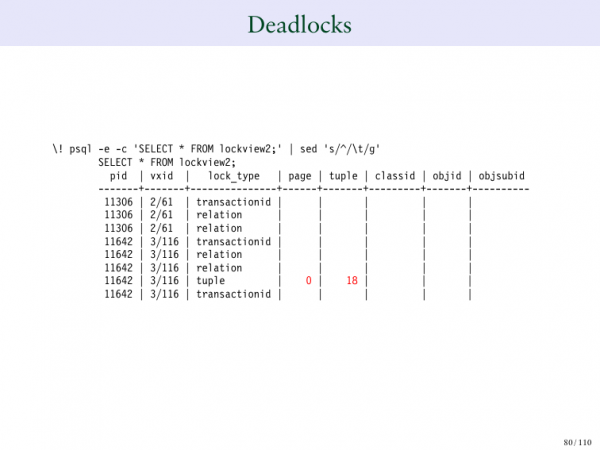
Og der står endda angivet præcist på hvilken række, vi oplever deadlocks. Og det er her, det begynder at blive mærkeligt.
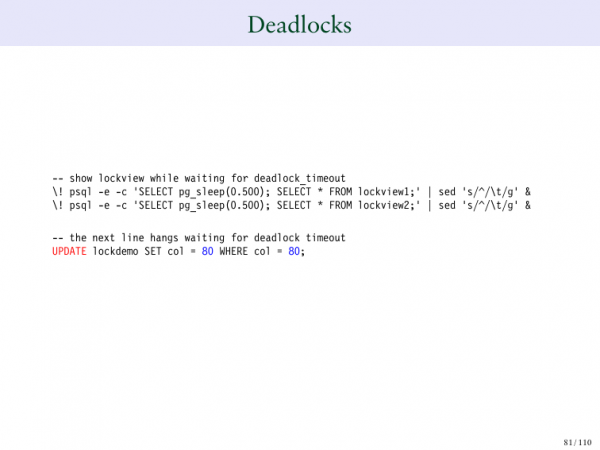
Nu opdaterer vi 80 til 80.
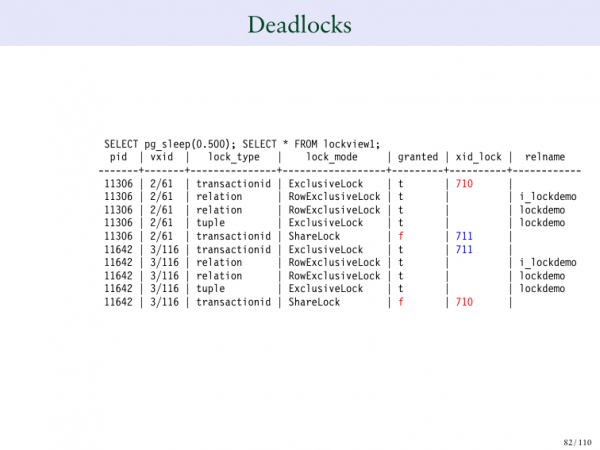
Og her begynder deadlocks. 710 venter på respons fra 711, mens 711 venter på 710. Og dette vil ikke ende godt. Der er ingen vej ud. De vil vente på hinanden.
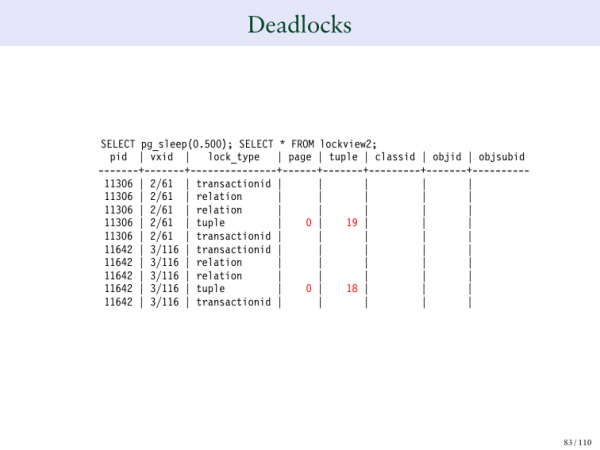
Og det vil bare begynde at forsinke det hele. Det ønsker vi ikke.
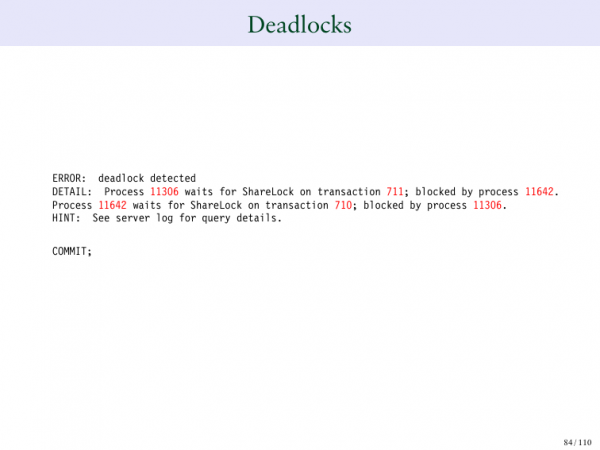
Og i Postgres er der måder at opdage, når dette sker. Når det sker, får du en fejl som denne. Det bliver klart, at en proces venter på en SHARE LOCK fra en anden proces, der blokkeres af proces 711. Den proces ønskede en SHARE LOCK på en given transaktions-ID og blev blokkeret af en anden proces. Så her er der tale om en deadlock.
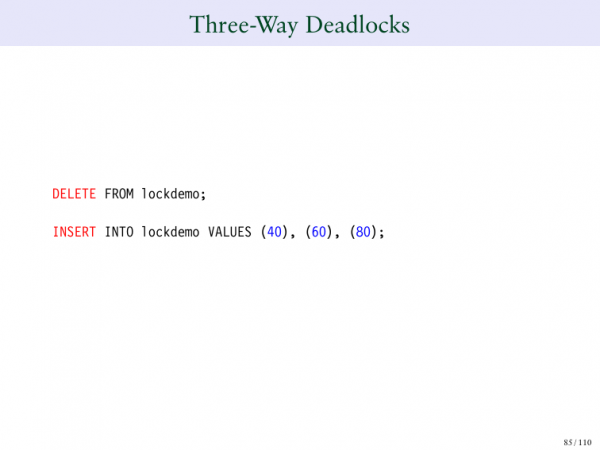
Kan der være en trevej deadlock? Er det muligt? Ja.
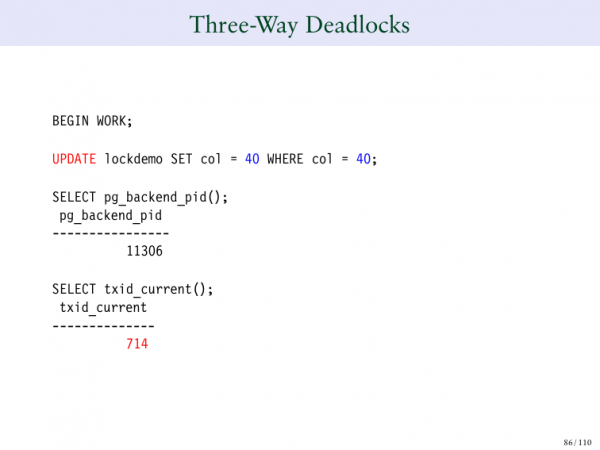
Vi indtaster disse tal i tabellen. Vi ændrer 40 til 40, vi laver en blokering.
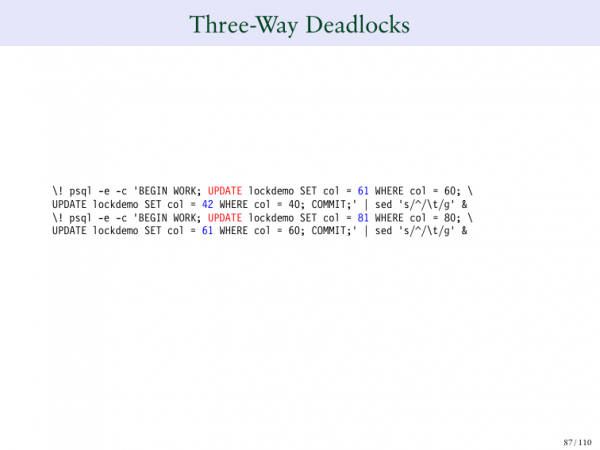
Ændrer 60 til 61, 80 til 81.
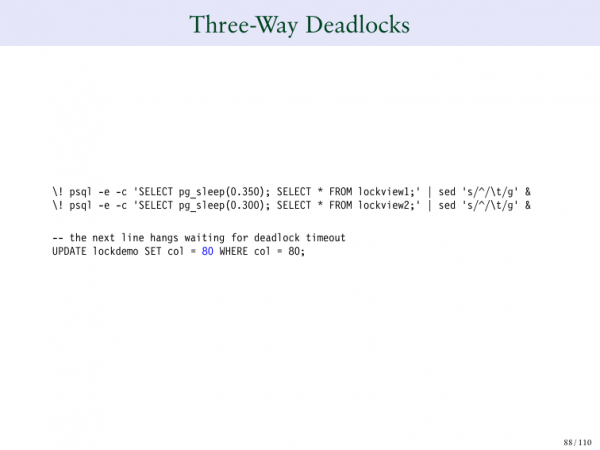
Og så ændrer vi 80, og så – bam!
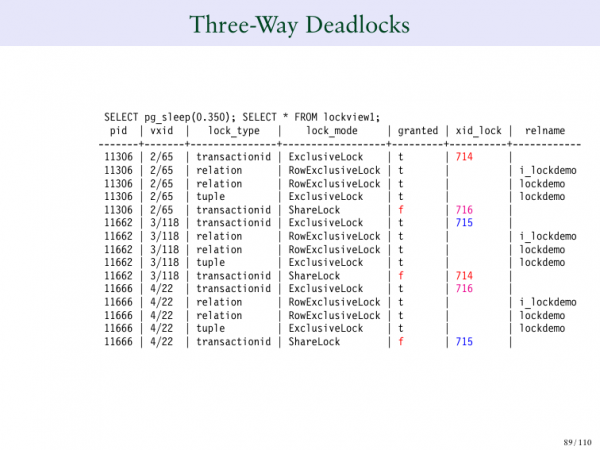
Og 714 venter nu på 715. 716 venter på 715. Og der er ikke noget at gøre ved det.
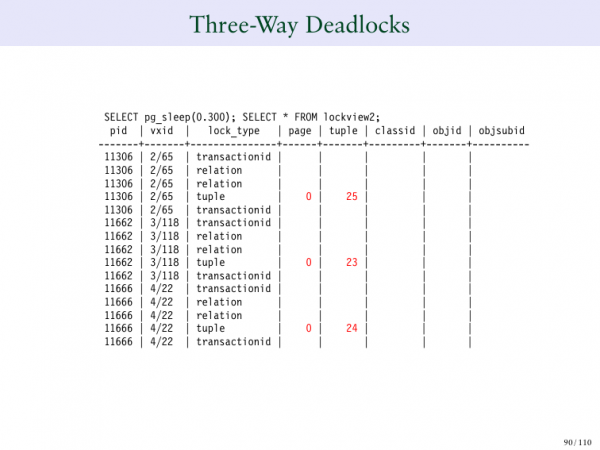
Her er der ikke blot to personer, men tre. Jeg ønsker noget fra dig, denne ønsker noget fra den tredje person, og den tredje person ønsker noget fra mig. Og vi ender i en trevejsventesituation, fordi vi alle venter på, at den anden skal færdiggøre, hvad de skal gøre.
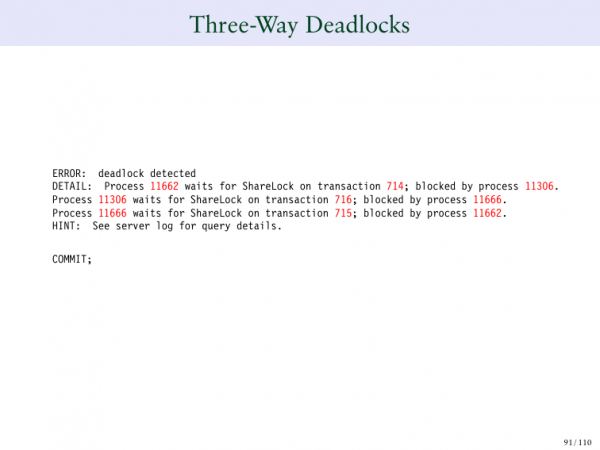
Og Postgres ved, hvilken række dette sker i. Derfor giver den dig den følgende besked, der viser, at du har et problem, hvor tre input blokerer hinanden. Og der er ingen begrænsninger. Dette kan være i tilfælde, hvor 20 optegnelser blokerer hinanden.
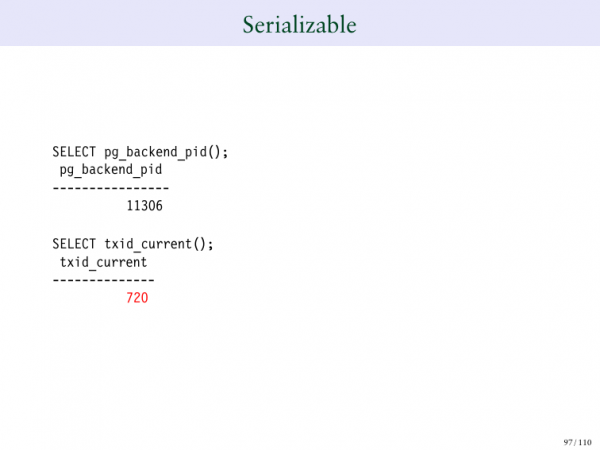
Det næste problem er serializable.
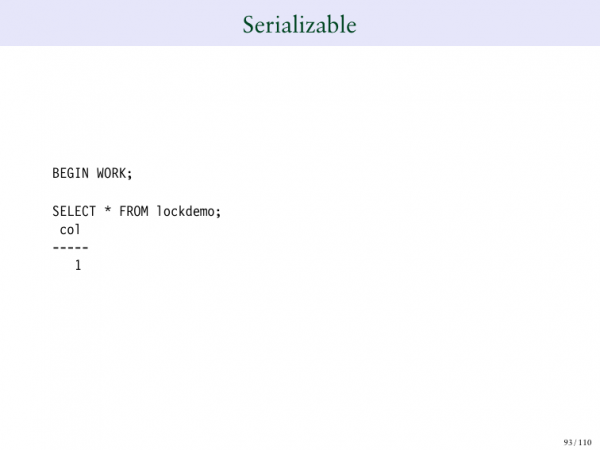
Hvis der er en særlig serializable blokering.
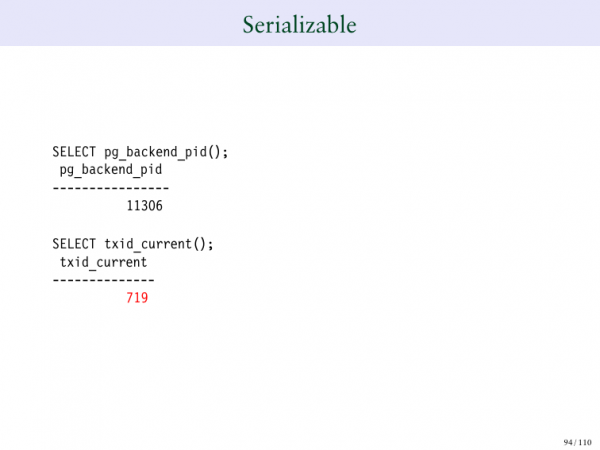
Og vi vender tilbage til 719. Den har en helt normal udgave.
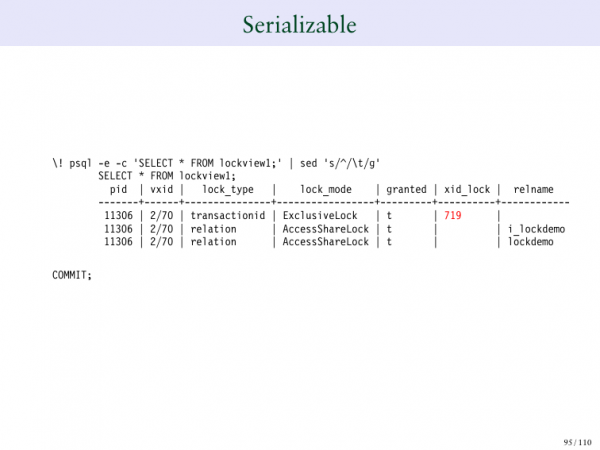
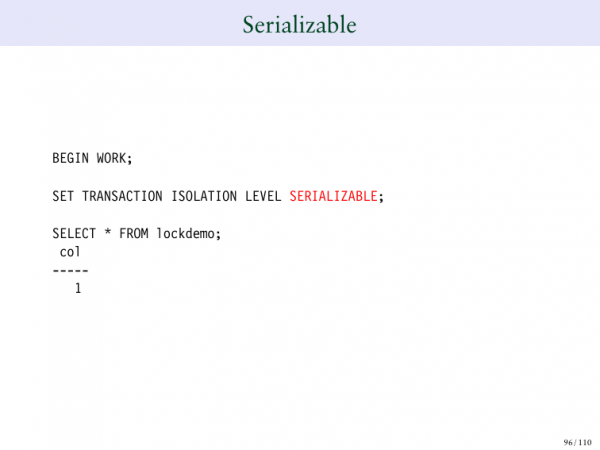
Og du kan klikke for at gøre transaktionen serializable.
Og du forstår, at du nu har en anden form for blokering SA – det betyder serializable.
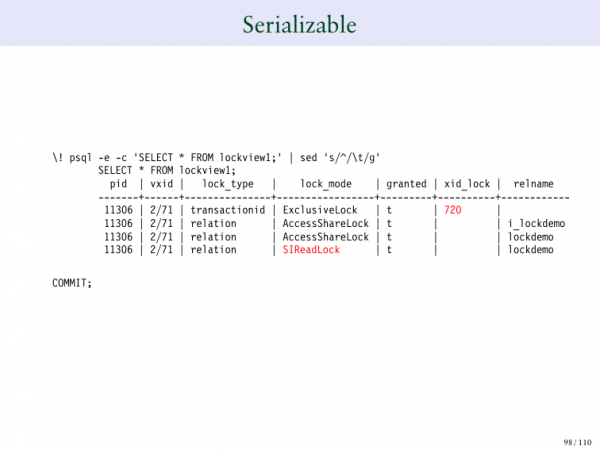
Derfor har vi en ny form for blokering, der kaldes SARieadLock, som er en serieblokering og tillader indtægt af serier.
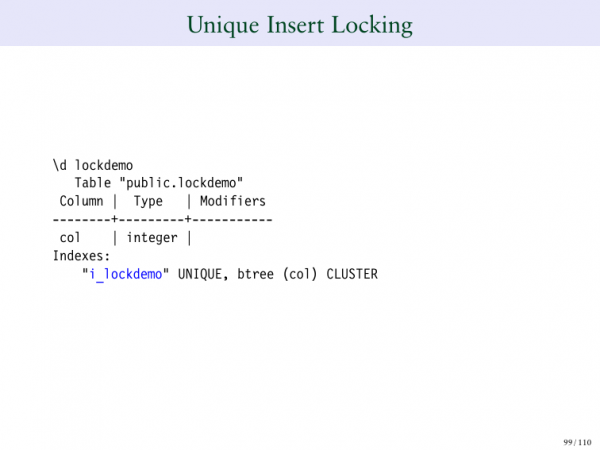
Og du kan også indsætte unikke indekser.
I denne tabel har vi unikke indekser.
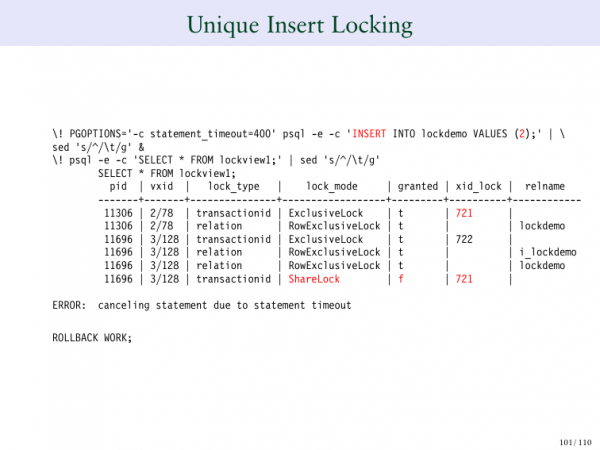
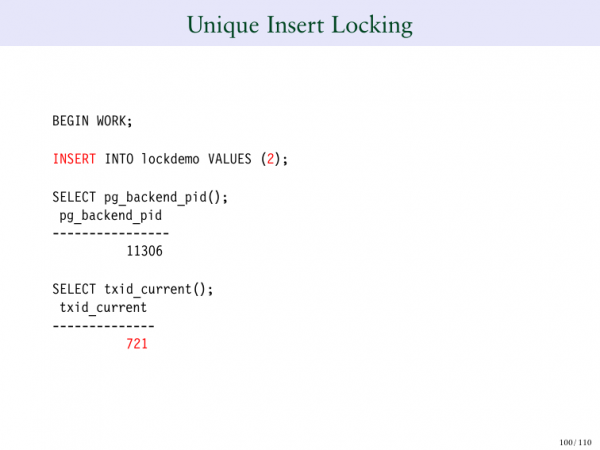
Så hvis jeg indtaster tallet 2 her, har jeg 2. Men helt øverst indsætter jeg endnu et 2. Og du kan se, at 721 har en eksklusiv lås. Men nu venter 722 på, at 721 skal færdiggøre sin operation, fordi den ikke kan indsætte 2, før den ved, hvad der sker med 721.
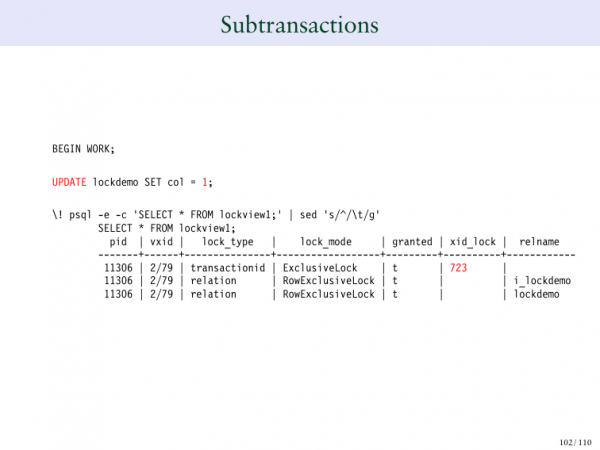
Og hvis vi laver en subtransaction.
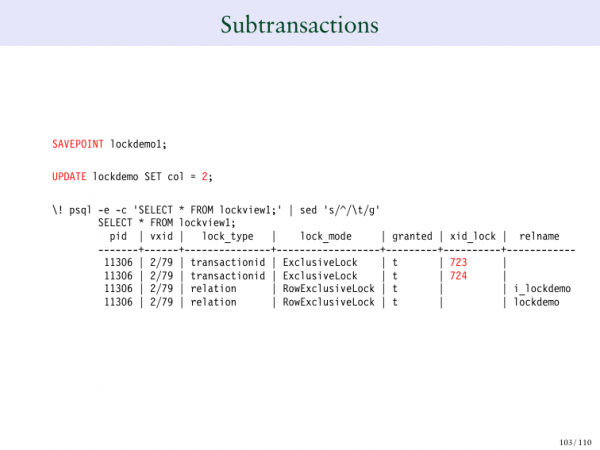
Her har vi 723.
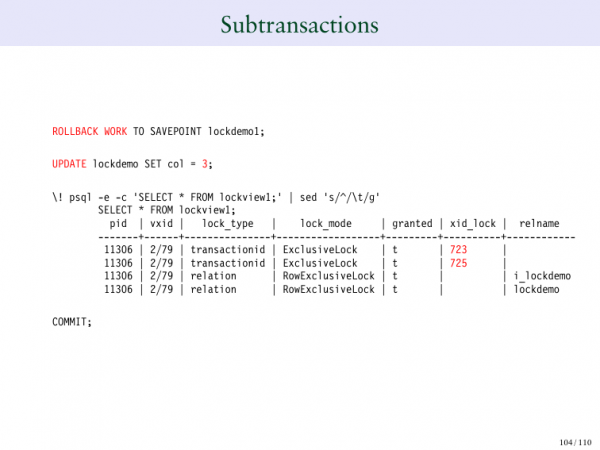
Og hvis vi gemmer punktet og derefter opdaterer det, får vi et nyt transaktions-ID. Dette er endnu en adfærd, du skal kende til. Hvis vi returnerer dette, forsvinder transaktions-ID'et. 724 forsvinder. Men nu har vi 725.
Og hvad prøver jeg at gøre her? Jeg prøver at vise dig eksempler på usædvanlige låse, som du kan finde: uanset om det er serializable låse eller SAVEPOINT – disse er forskellige typer låse, der vil blive vist i låsetabellen.
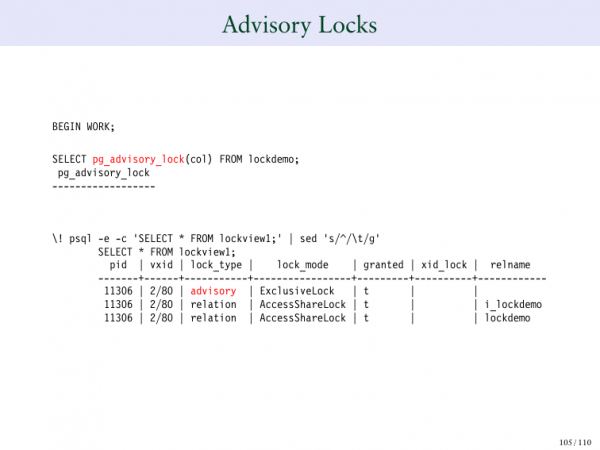
Dette er oprettelsen af eksplicitte (åbne) låse, hvor pg_advisory_lock.
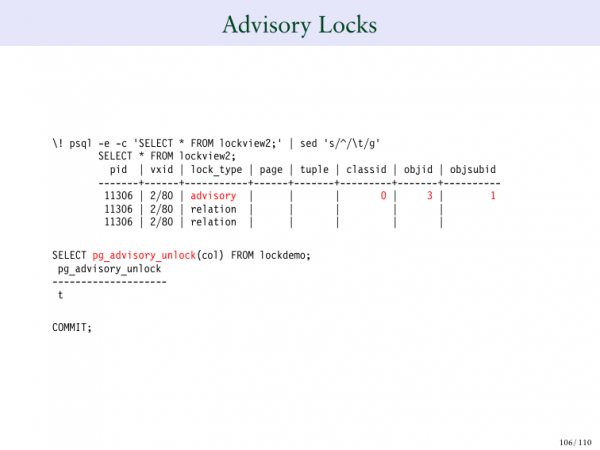
Og du kan se, at låsetypen her er angivet som advisory. Og det står med rødt 'advisory'. Og du kan samtidig låse med pg_advisory_unlock.
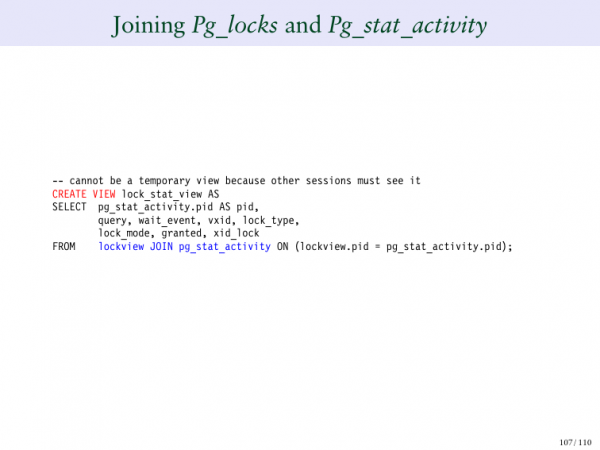
Og for at afslutte vil jeg gerne vise dig endnu en fantastisk ting. Jeg vil lave en anden type. Men jeg vil forbinde tabellen pg_locks med tabellen pg_stat_activity. Og hvorfor vil jeg gøre dette? Fordi det vil give mig mulighed for at se og overvåge alle nuværende sessioner og se, hvilke specifikke låse de venter på. Og det er ret interessant, når vi samler låsetabellen og forespørgsels-tabellen.
Og her opretter vi pg_stat_view.
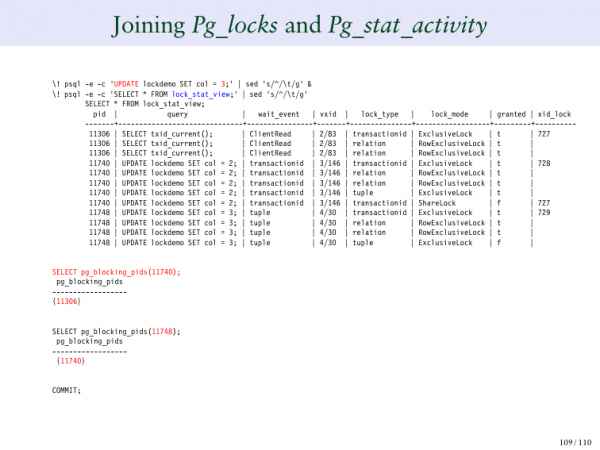
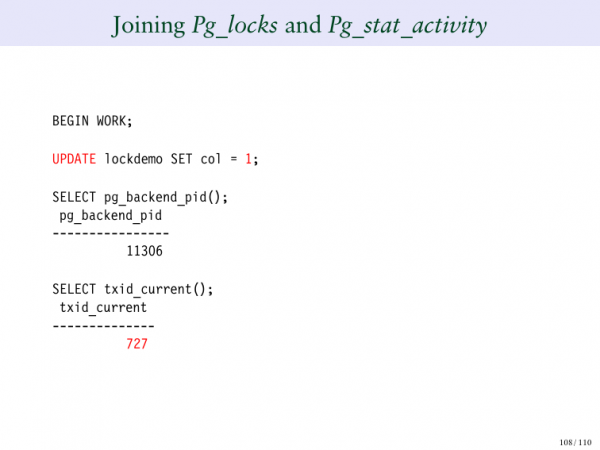
Og vi opdaterer rækken med én. Og her ser vi 724. Og derefter opdaterer vi vores række til tre. Og hvad ser du her nu? Dette er forespørgsler, altså ser du hele listen over forespørgsler, der er angivet i den venstre kolonne. Og derefter kan du se låsene og hvad de skaber på højre side. Og dette kan være mere forståeligt for dig, så du ikke behøver at vende tilbage til hver session hver gang for at se, om du skal tilslutte dig eller ej. Dette gør de for os.
En anden funktion, der er meget nyttig – er pg_blocking_pidsDu har nok aldrig hørt om det. Hvad gør det? Det tillader os at sige, at for denne session 11740, hvilke specifikke proces-ID'er den forventer. Og du kan se, at 11740 forventer 724. Og 724 er øverst. Mens 11306 er dit proces-ID. I bund og grund går denne funktion igennem din låntabel. Jeg ved, det er lidt svært, men du får det til at forstå. I bund og grund går denne funktion gennem denne låntabel og forsøger at finde, hvor dette proces-ID er, baseret på de låsninger, den venter på. Og det forsøger også at beregne, hvilket specifikt proces-ID der tilhører den proces, der venter på låsninger. Derfor kan du køre denne funktion. pg_blocking_pids.
Og det kan være meget nyttigt. Vi tilføjede det først med version 9.6, så denne funktion er kun fem år gammel, men den er meget, meget nyttig. Det samme gælder for den anden forespørgsel. Den viser præcist det, vi har brug for at se.
Det er, hvad jeg ville tale med dig om. Og som jeg forventede, brugte vi al vores tid, fordi der var så mange dias. Diasene kan downloades. Jeg vil gerne takke dig for at du var her. Jeg er sikker på, at du vil nyde resten af konferencen, tusind tak!
Spørgsmål:
For eksempel, hvis jeg prøver at opdatere rækkerne, mens den anden session prøver at slette hele tabellen. Så vidt jeg forstår, burde der være noget som en intent lock. Findes der noget sådan i Postgres?
Lad os gå tilbage til begyndelsen. Måske husker du, at når du laver hvad som helst, for eksempel når du laver en SELECT, så giver vi en AccessShareLock. Og det forhindrer sletning af tabellen. Derfor, hvis du for eksempel vil opdatere en række i tabellen eller slette en række, så kan nogen ikke slette hele tabellen samtidig, fordi du holder denne AccessShareLock over hele tabellen og over rækken. Og så snart du er færdig, kan de slette det. Men mens du direkte ændrer noget der, kan de ikke gøre det.
Lad os gøre det igen. Lad os gå til eksemplet med sletning. Og du ser, hvordan der er en eksklusiv lock over hele tabellen på rækken.
Det vil se ud som en eksklusiv lås, ikke?
Ja, det lyder som det. Jeg forstår, hvad du siger. Du siger, at hvis jeg udfører SELECT, så får jeg ShareExclusive, og hvis jeg derefter ændrer det til Row Exclusive, bliver det et problem? Men overraskende nok skaber det ikke et problem. Det ligner en stigende låsningsgrad, men i bund og grund har jeg en lås, der forhindrer sletning. Og nu, når jeg gør denne lås stærkere, forhindrer den stadig sletning. Så det er ikke sådan, at jeg hæver det. Det vil sige, den forhindrede det, selv da den var på et lavere niveau, så når jeg hæver den, forhindrer den stadig sletning af tabellen.
Jeg forstår, hvad du siger. Der er ikke et tilfælde af stigende låsningsgrad, hvor du prøver at afgive én lås for at indføre en mere kraftfuld. Her øger det bare generelt forhindringen, så det forårsager ingen konflikt. Men det er et godt spørgsmål. Tak fordi du stillede det!
Hvad skal vi gøre for at undgå deadlock-situationer, når vi har mange sessioner og et stort antal brugere?
Postgres registrerer automatisk deadlock-situationer. Og vil automatisk fjerne en af sessionerne. Den eneste måde at undgå deadlock-situationen på er at låse folk i den samme rækkefølge. Så når du ser på din applikation, er årsagen til deadlocks ofte... Lad os forestille os, at jeg vil låse to forskellige ting. Én applikation låser tabel 1, mens en anden applikation låser tabel 2 og derefter tabel 1. Den nemmeste måde at undgå deadlocks på er at se på din applikation og sørge for, at låsningen sker i den samme rækkefølge i alle applikationer. Og det fjerner som regel 80 % af problemerne, fordi meget forskellige mennesker skriver disse applikationer. Og hvis du låser dem i den samme rækkefølge, så står du ikke over for en deadlock-situation.
Mange tak for dit indlæg! Du talte om vacuum full, og hvis jeg forstår det korrekt, omformer vacuum full rækkefølgen af poster i det enkelte opbevaringsområde, så de nuværende poster forbliver uændrede. Men hvorfor tager vacuum full en eksklusiv lås, og hvorfor kommer det i konflikt med skriveoperationer?
Det er et godt spørgsmål. Årsagen er, at vacuum full tager tabellen. Og vi skaber i princippet en ny version af tabellen. Tabellen vil være ny. Det resulterer i, at det bliver en helt ny version af tabellen. Og problemet er, at når vi gør det, vil vi ikke have, at folk læser det, fordi vi har brug for, at de ser den nye tabel. Og derfor hænger det sammen med det tidligere spørgsmål. Hvis vi kunne læse samtidig, ville vi ikke kunne flytte det og dirigere folk til den nye tabel. Vi ville være nødt til at vente, indtil alle færdiggjorde med at læse denne tabel, og derfor, i princippet, er det en eksklusiv låsesituation.
Vi siger bare, at vi låser fra starten, fordi vi ved, at vi i slutningen har brug for en eksklusiv lås for at flytte alle til den nye kopi. Derfor kan vi potentielt løse det. Og vi gør det med samtidig indeksering. Men det er meget mere kompleks at gøre. Og det relaterer meget til dit tidligere spørgsmål om eksklusiv lås.
Er det muligt at tilføje locking timeout i Postgres? I Oracle kan jeg for eksempel skrive 'vælg til opdatering' og vente 50 sekunder før opdateringen. Det var godt for applikationen. Men i Postgres skal jeg enten gøre det med det samme og slet ikke vente, eller vente i en vis tid.
Ja, du kan vælge timeout for dine lås. Du kan også give kommandoen no way, som vil være ..., hvis du ikke kan få låsen med det samme. Så enten lock timeout eller noget andet, der giver dig mulighed for at gøre det. Det gøres ikke på syntaksniveau. Det gøres som en variabel på serveren. Nogle gange kan det ikke bruges.
Kan du åbne 75. slide?
Ja.
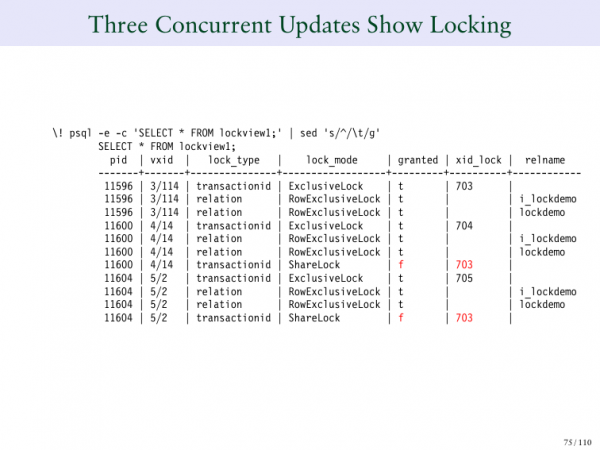
Og mit spørgsmål er følgende. Hvorfor venter begge opdateringsprocesser på 703?
Og det er et fantastisk spørgsmål. Jeg forstår ikke, hvorfor Postgres gør det. Men da 703 blev oprettet, forventede den 702. Og når 704 og 705 dukker op, ser det ud til, at de ikke ved, hvad de venter på, fordi der ikke er noget der endnu. Og Postgres gør det sådan: når du ikke kan få en lås, så siger den "Hvad er meningen med at behandle dig?", fordi du allerede venter på nogen. Så lad os bare lade det hænge i luften, det opdaterer slet ikke. Men hvad skete der her? Så snart 702 afsluttede processen, og 703 fik sin lås, gik systemet tilbage. Og sagde, at nu har vi to personer, der venter. Så lad os opdatere dem sammen. Og indikere, at begge venter.
Jeg ved ikke, hvorfor Postgres gør det. Men der er et problem, der kaldes f…. Jeg tror, det ikke er et term på russisk. Det er, når alle venter på en lås, selvom der er 20 instanser, der venter på låsen. Og pludselig vågner de alle op samtidigt. Og alle begynder at forsøge at reagere. Men systemet gør det sådan, at alle venter på 703. Fordi de alle venter, så stiller vi dem straks i kø. Og hvis der dukker en anden ny anmodning op, som blev dannet efter dette, for eksempel 707, så vil der igen være tomhed.
Og jeg tror, det gøres, så vi kan sige, at på dette tidspunkt venter 702 på 703, og alle dem, der kommer efter dette, vil ikke have nogen registrering i dette felt. Men så snart den første ventende forlader, får alle dem, der ventede på det tidspunkt op til opdateringen, den samme markør. Og derfor tror jeg, det er gjort, så vi kan behandle i rækkefølge, så de bliver korrekt ordnet.
Jeg har altid set på dette som et ret mærkeligt fænomen. Fordi her nævner vi for eksempel slet ikke dem. Men jeg føler, hver gang vi giver en ny lock, ser vi på alle dem, der er i ventemodus. Så stiller vi dem alle i kø. Og derefter kommer enhver ny, som ankommer, kun i kø, når den næste person er færdig med at blive behandlet. Meget godt spørgsmål. Tak fordi du stillede spørgsmålet!
Jeg synes, det er meget mere logisk, når 705 venter på 704.
Men problemet er følgende. Teknisk set kan du vække enten den ene eller den anden. Og derfor vækker vi den ene eller den anden. Men hvad sker der i systemets arbejde? Du kan se, at 703 øverst har låst sin egen transaktions-ID. Det er, hvordan Postgres fungerer. Og 703 låses af sin egen transaktions-ID, så hvis nogen vil vente, så venter de på 703. Og i det væsentlige afslutter 703. Og først efter at den er afsluttet, bliver en af processerne vækket. Og vi ved ikke, hvilken proces det bliver. Derefter behandler vi langsomt alle. Men det er uklart, hvilken proces der vækkes først, fordi det kan være en hvilken som helst af disse processer. I bund og grund havde vi en scheduler, der sagde, at vi nu kan vække en hvilken som helst af disse processer. Vi vælger bare en tilfældigt. Derfor skal begge markeres, fordi vi kan vække en hvilken som helst af dem.
Og problemet er, at vi har CP-uendelighed. Og derfor kan vi meget vel vække den senere. Og hvis vi for eksempel vækker den senere, så vil vi vente på den, der netop har fået låsen, så vi kan ikke bestemme, hvem der præcist bliver vækket først. Vi skaber simpelthen en sådan situation, og systemet vil vække dem i vilkårlig rækkefølge.
Der er . Se, de er også interessante og nyttige. Emnet er selvfølgelig skræmmende komplekst. Mange tak, Bruce!
Kilde: habr.com
