

Legitim trafik på DDoS-Guard-netværket har for nylig oversteget hundrede gigabit i sekundet. I øjeblikket genererer 50% af al vores trafik webtjenester fra kunderne. Det drejer sig om mange titusinder af domæner, der er meget forskellige og ofte kræver en individuel tilgang.
Under fanen — hvordan vi styrer front-noderne og leverer SSL-certifikater til hundrede tusinder af hjemmesider.
At konfigurere fronten for ét website, selvom det er meget stort, er enkelt. Vi tager nginx eller haproxy eller lighttpd, konfigurerer det efter vejledningerne og glemmer det. Hvis der er behov for ændringer, foretager vi en reload og glemmer det igen.
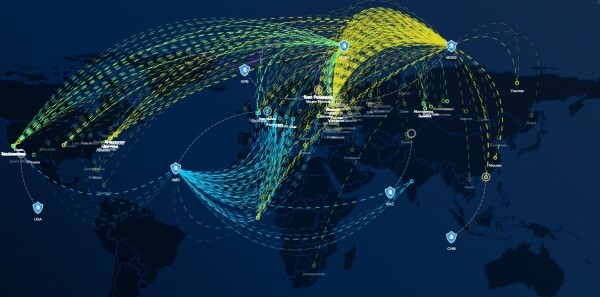
Alt ændrer sig, når du håndterer store trafikmængder i realtid, vurderer legitimiteten af anmodningerne, komprimerer og cacher brugerindhold, og samtidig ændrer parametrene flere gange i sekundet. Brugeren ønsker at se resultaterne på alle eksterne noder med det samme, efter at han har ændret indstillingerne i sin konto. Desuden kan brugeren via API’en uploade flere tusinde (og nogle gange titusinder) af domæner med individuelle trafikbehandlingsparametre. Alt dette skal også fungere med det samme både i Amerika, Europa og Asien — det er ikke en triviel opgave, især når der kun i Moskva er flere fysisk spredte filtreringsnoder.
Hvorfor mange store, pålidelige noder rundt om i verden?
- Kvaliteten af servicen for kundernes trafik — anmodninger fra USA skal behandles netop i USA (herunder angreb, parsing og andre anomalier) og ikke transporteres til Moskva eller Europa, hvilket uforudsigeligt øger behandlingsforsinkelsen.
- Angrebstrafik skal lokaliseres — transitoperatører kan degradere under angreb, hvis volumen ofte overstiger 1Tbps. At transportere angrebstrafik via transatlantiske eller transasiatiske links er ikke den bedste idé. Vi har haft reelle tilfælde, hvor Tier-1 operatører sagde: "De angrebsmængder, I modtager, er farlige for os." Derfor accepterer vi indstrømninger så tæt på deres kilder som muligt.
- Strenge krav til driftskontinuitet - rensecentrene må ikke være afhængige af hinanden eller af lokale hændelser i vores hastigt foranderlige verden. Hvis alle 11 etager af MMT-9 mister strøm i en uge? - ikke noget problem. Ingen kunder, der ikke har fysisk tilslutning netop i denne placering, vil lide under det, og webtjenesterne vil ikke påvirkes under nogen omstændigheder.
Hvordan styrer man alt dette?
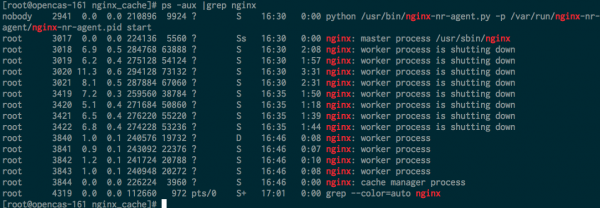
Servicekonfigurationer skal så hurtigt som muligt (ideelt set med det samme) distribueres til alle front-noder. Man kan ikke blot tage og ombygge tekstkonfigurationer og genstarte dæmoner ved hver ændring - selv nginx holder færddiggjorte processer (worker shutting down) i flere minutter (eller måske timer, hvis der er lange websocket-sessioner).
Ved genstart af konfigurationen er følgende billede helt normalt:
Angående hukommelsesforbruget:
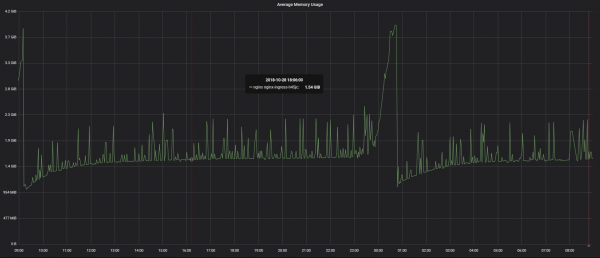
Gamle arbejdere bruger hukommelse, herunder noget, der ikke er lineært afhængigt af antallet af forbindelser - det er normalt. Når klientforbindelserne lukkes, vil denne hukommelse blive frigivet.
Hvorfor var dette ikke et problem, da nginx lige begyndte at udvikle sig? Der var hverken HTTP/2, WebSocket, eller masser af lange keep-alive forbindelser. 70% af vores webtrafik er HTTP/2, som er meget langvarige forbindelser.
Løsningen er enkel - ikke at bruge nginx, ikke at administrere fronten baseret på tekstfiler, og slet ikke at sende komprimerede tekstkonfigurationer over transatlantiske kanaler. Kanalerne er selvfølgelig garanterede og reserverede, men de er ikke mindre transkontinentale.
Vi har vores egen frontserver-belaster, om hvis indre liv jeg vil fortælle i de følgende artikler. Det vigtigste, den kan, er at anvende tusindvis af konfigurationsændringer i sekundet i realtid, uden genstart, genindlæsning, pludselige stigninger i hukommelsesforbruget og alt det der. Dette minder meget om Hot Code Reload, for eksempel i Erlang. Data opbevares i en geo-redundant key-value database og hentes straks af de eksekverende mekanismer foran. Det vil sige, at du har uploadet SSL-certifikatet via webgrænseflade eller API i Moskva, og efter få sekunder er det allerede klar til brug i vores rensecenter i Los Angeles. Hvis der pludselig skulle opstå verdenskrig og internettet forsvandt i hele verden, ville vores noder fortsætte med at fungere autonomt og reparere split-brain, så snart en af de dedikerede kanaler Los Angeles-Amsterdam-Moskva, Moskva-Amsterdam-Hongkong-Los Angeles eller i det mindste en af de backup overlay GRE er tilgængelige.
Denne mekanisme gør det også muligt for os at udstede og forlænge Let’s Encrypt certifikater øjeblikkeligt. Meget simplificeret fungerer det sådan her:
- Når vi ser mindst én HTTPS-anmodning til vores klients domæne uden certifikat (eller med et udløbet certifikat), informerer den eksterne node, som modtog anmodningen, det interne certifikatcenter.

- Hvis brugeren ikke har forhindret udstedelsen af Let’s Encrypt, genererer certifikatcentret CSR, får et bekræftelsestoken fra LE og sender det til alle fronter via en krypteret kanal. Nu kan enhver node bekræfte den validerende anmodning fra LE.
- Efter få øjeblikke modtager vi det korrekte certifikat og den private nøgle og sender det på samme måde til fronten. Igen uden genstart af dæmoner.
- Syv dage før udløbsdatoen initieres proceduren for at genanskaffe certifikatet.
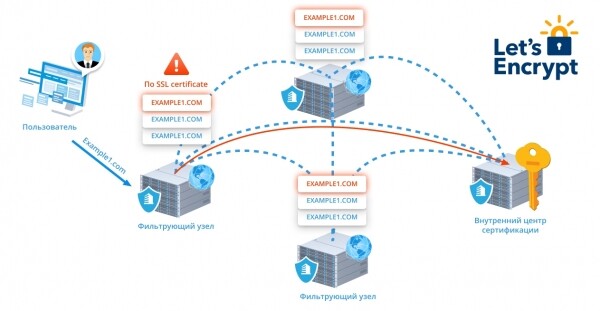
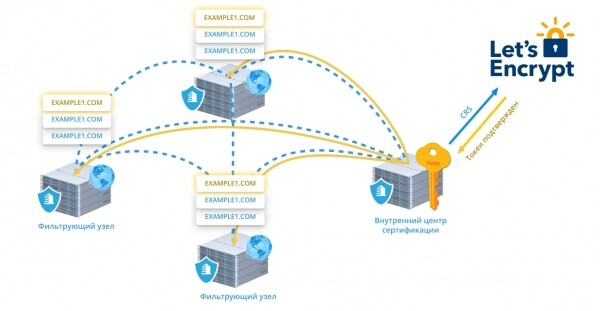
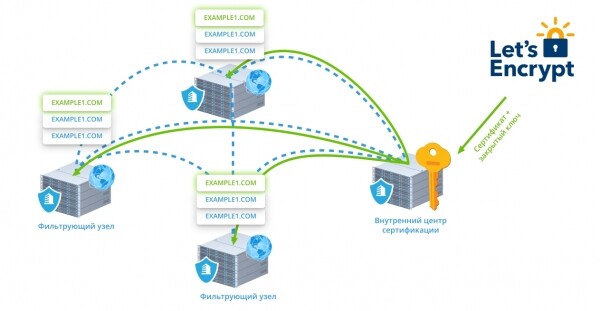
Lige nu roterer vi i realtid 350.000 certifikater, helt gennemsigtigt for brugerne.
I de næste artikler i rækken vil jeg fortælle om andre funktioner ved realtidsbehandling af stort webtrafik — for eksempel analyse af RTT baseret på ufuldstændige data for at forbedre servicekvaliteten for transitkunder og generelt om beskyttelse af transittrafik mod terabitangreb, om levering og aggregering af trafikinformation, om WAF, næsten ubegribelig CDN og mange mekanismer til optimering af indholdslevering.
Kun registrerede brugere kan deltage i undersøgelsen. Log ind, please.
Hvad vil du gerne vide først?
- 14,3%Algoritmer til klustering og analyse af webtrafik<3
- 33,3%Inden i DDoS-Guard7 balancerer
- 9,5%Beskyttelse af transit L3/L4 trafik2
- 0,0%Beskyttelse af websteder på transit trafik0
- 14,3%Web Applikations Firewall3
- 28,6%Beskyttelse mod parsing og klikbedrag6
21 brugere har stemt. 6 brugere har undladt at stemme.
Kilde: habr.com
