

VictoriaMetrics — en hurtig og skalerbar database til lagring og behandling af data i form af tidsserier (en optagelse udgør tid og et sæt af værdier, der svarer til dette tidspunkt, for eksempel opnået gennem periodiske forespørgsler af sensorernes tilstand eller indsamling af målinger).
Mit navn er Kolobaev Pavel. DevOps, SRE, LeroyMerlin, alt som kode – det handler alt sammen om os: om mig og andre medarbejdere hos LeroyMerlin.
Der er en sky baseret på OpenStack. Her er et lille link til teknologiradar.
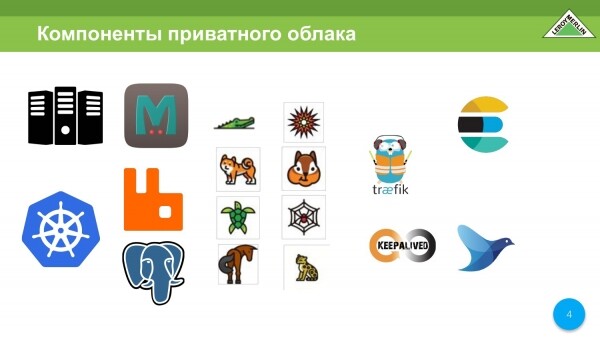
Det er bygget på hardware fra Kubernetes, samt alle tilknyttede tjenester til OpenStack og logning.
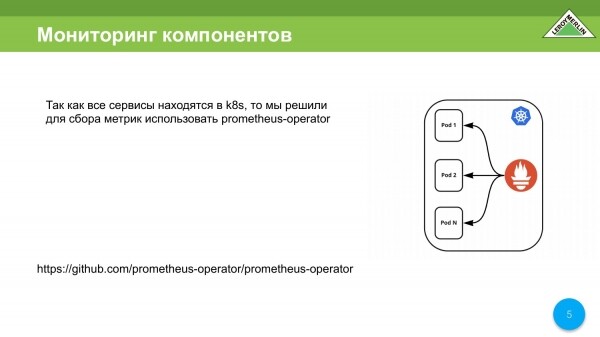
Skemaet var således, da vi udviklede det. Da vi udviklede alt dette, havde vi en Prometheus-operator, der opbevarede data inden for selve K8s-klyngen. Den finder automatisk det, der skal scrapes, og lægger det for sig selv, groft sagt.
Alle data skal vi flytte ud af Kubernetes-klyngen, fordi hvis noget går galt, skal vi forstå, hvad der er sket og hvor.
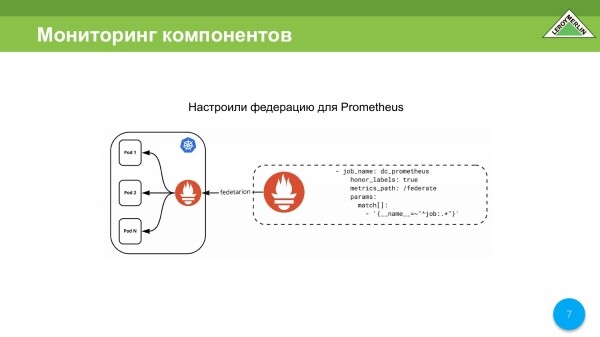
Den første løsning – vi bruger federation, når vi har en ekstern Prometheus, når vi tilgår klyngen Kubernetes gennem federation-mekanismen.
Men der opstår små problemer. I vores tilfælde startede problemerne, da vi havde 250.000 målinger, og da der blev 400.000 målinger, indså vi, at vi ikke kunne arbejde på denne måde. Vi øgede scrape_timeout til 25 sekunder.
Hvorfor måtte vi gøre dette? Prometheus begynder at tælle timeout-tiden fra det øjeblik, dataene indsamles. Og det betyder ikke noget, at dataene stadig strømmer. Hvis dataene ikke er blevet indsamlet, og sessionen ikke lukkes via http i den angivne tidsperiode, betragtes sessionen som mislykket, og dataene kommer ikke ind i selve Prometheus.
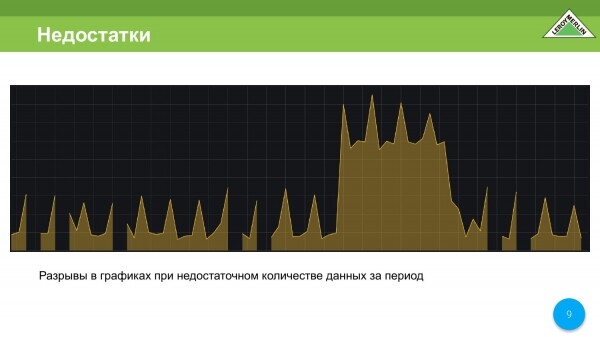
Alle er bekendt med de grafer, vi får, når nogle data mangler. Graferne er ujævne, og det er ikke acceptabelt for os.
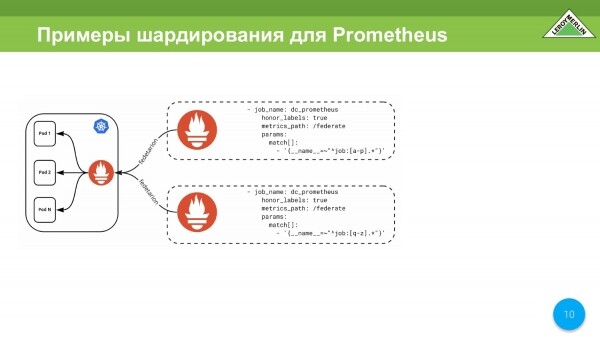
Den næste mulighed – det er sharding baseret på to forskellige Prometheus gennem den samme federation-mekanisme.
For eksempel bare tage dem og shardere dem efter navn. Det kan også bruges, men vi besluttede at tage et skridt videre.
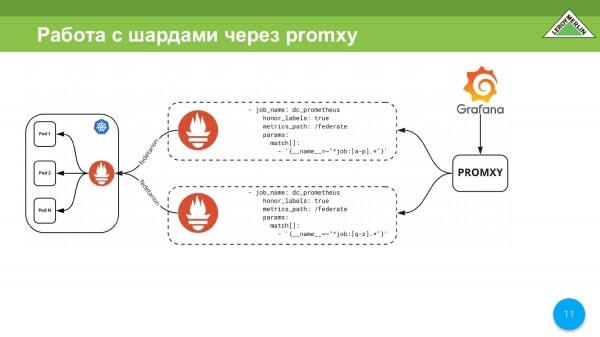
Vi bliver nu nødt til at håndtere disse shards på en eller anden måde. Vi kan tage promxy, som går ind i shardområdet og multiplerer data. Den fungerer med to shards som et enkelt adgangspunkt. Det kan realiseres gennem promxy, men er stadig for kompliceret.
Den første mulighed – vi ønsker at afstå fra federation-mekanismen, fordi den er meget langsom.
Udviklerne af Prometheus siger tydeligt: „Folk, brug andre TimescaleDB, fordi vi ikke vil støtte langvarig opbevaring af målinger.“ Det er ikke deres opgave. 
Vi noterer på papir, at vi faktisk har brug for en ekstern eksport, så vi ikke opbevarer alt på ét sted.
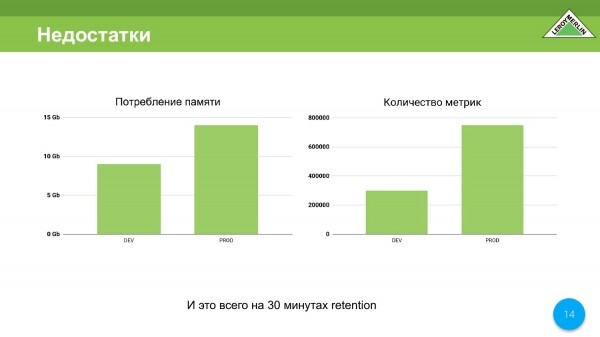
Den anden ulempe er hukommelsesforbruget. Ja, jeg forstår, at mange vil sige, at et par gigabyte hukommelse i 2020 er billigere, men det er stadigvæk.
I øjeblikket har vi et udviklings- og produktionsmiljø. I udviklingen er der omkring 9 gigabyte for 350.000 målinger. I produktion er der lidt over 14 gigabyte for 780.000 målinger. Samtidig har vi kun 30 minutters retention-tid. Det er ikke godt. Og jeg vil nu forklare hvorfor.
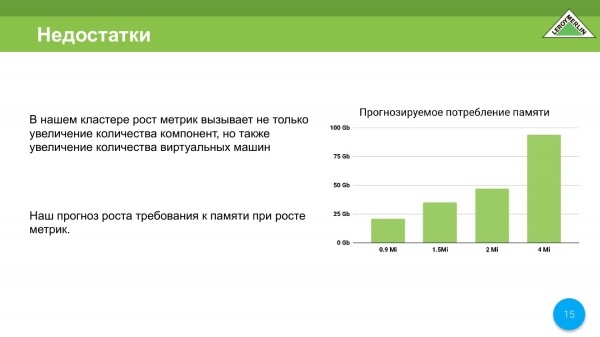
Vi laver beregninger, dvs. med halvanden million målinger, som vi allerede næsten er ved at nå, har vi under designfasen beregnet 35-37 gigabyte hukommelse. Men allerede ved 4 millioner målinger kræves der omkring 90 gigabyte hukommelse. Dvs. dette er blevet beregnet ud fra den formel, som udviklerne af Prometheus giver. Vi har set på korrelationen og indset, at vi ikke ønsker at betale et par millioner for en server bare til overvågning.
Vi får ikke bare flere maskiner, vi overvåger også de virtuelle maskiner. Derfor, jo flere virtuelle maskiner, jo flere målinger af forskellige arter osv. Vi vil have en specifik vækst af vores klynge i forhold til målinger.
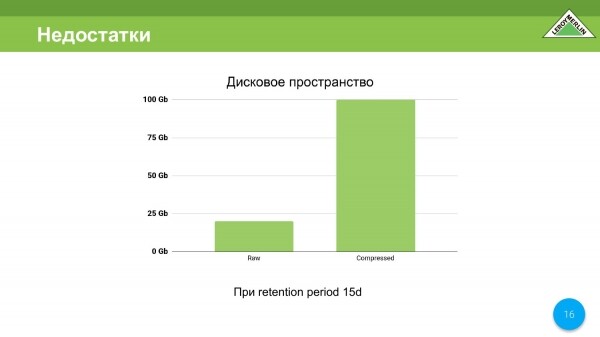
Med diskpladsen er der ikke så meget galt, men vi ville gerne se en forbedring. Vi har samlet 120 gigabyte over 15 dage, hvoraf 100 er komprimerede data, 20 er ukomprimerede data, men man ønsker altid mindre.
Derfor skriver vi også et punkt ned – der er et stort forbrug af ressourcer, som vi gerne vil spare, fordi vi ikke ønsker, at vores overvågningsklynge bruger flere ressourcer end vores klynge, der håndterer OpenStack.
Der er en anden ulempe ved Prometheus, som vi har identificeret, og det er et eller andet begrænsning på hukommelsen. Med Prometheus er det meget værre, fordi der faktisk ikke er sådanne indstillinger. At bruge begrænsninger i Docker er heller ikke en løsning. Hvis din RAF falder og der er 20-30 gigabyte, vil det tage meget lang tid at komme op igen.
Det er endnu en grund til, at Prometheus ikke er passende for os, dvs. man kan ikke begrænse hukommelsesforbruget.
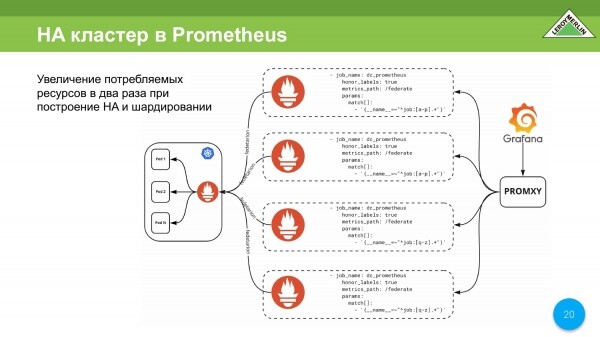
Man kunne gå tilbage til denne ordning. Denne ordning er nødvendig for at organisere et HA-kluster. Vi ønsker, at vores målinger altid skal være tilgængelige, selv hvis serveren, der gemmer disse målinger, går ned. Derfor er vi nødt til at bygge en sådan ordning.
Denne ordning betyder, at vi vil have duplikater af shards og dermed også duplikation af de ressourcer, der forbruges. Den kan næsten skaleres horisontalt, men forbruget af ressourcer vil stadig være enormt.
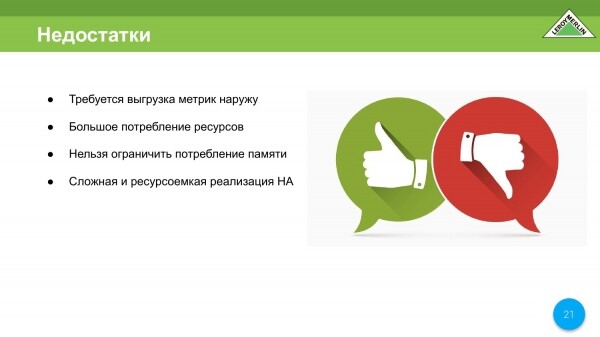
Ulemperne i den rækkefølge, som vi har skrevet dem ned:
- Der er behov for at eksportere målinger udad.
- Høj ressourceforbrug.
- Kan ikke begrænse hukommelsesforbruget.
- Kompleks og ressourcekrævende implementering af HA.
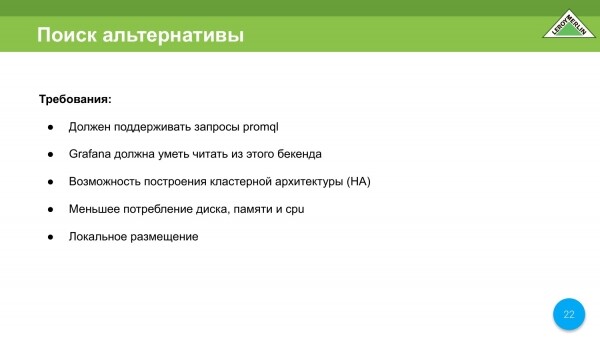
Vi har besluttet os for at gå væk fra Prometheus som datalager.
Vi har også defineret yderligere krav, som vi har brug for. Det er:
- Støtte til promql, fordi der allerede er skrevet meget til Prometheus: forespørgsler, alarmer.
- Og videre har vi Grafana, som også er skrevet til Prometheus som backend. Vi vil helst ikke genoptage dashboards.
- Vi ønsker at opbygge en korrekt HA-arkitektur.
- Vi ønsker at reducere forbruget af enhver art ressourcer.
- Der er en lille detalje. Vi kan ikke bruge diverse cloud-metric indsamling systemer. Vi ved ikke, hvad der vil flyve ind i disse målinger endnu. Og da der kan komme alt muligt ind, må vi begrænse os til lokal hosting.
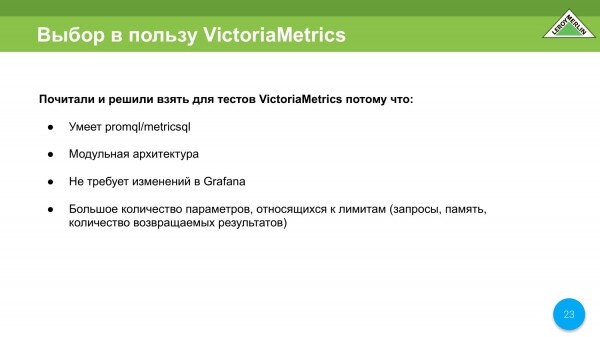
Valget var begrænset. Vi samlede alt, hvad vi havde erfaring med. Vi så på Prometheus' integrationsside, læste en masse artikler, så hvad der egentlig er. Og vi valgte VictoriaMetrics som erstatning for Prometheus.
Hvorfor? Fordi:
- Den understøtter promql.
- Den har en modulær arkitektur.
- Den kræver ingen ændringer i Grafana.
- Og vigtigst af alt – vi vil måske levere opbevaring af målinger internt i vores virksomhed som en service, så vi ser allerede i retning af begrænsninger, så brugerne kan bruge alle ressourcerne fra klyngen i et begrænset omfang, da der er en chance for, at det vil være multitenancy.
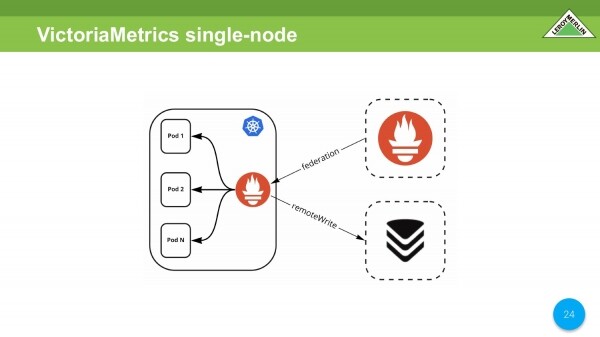
Vi laver den første sammenligning. Vi tager den samme Prometheus inden for klyngen, hvor en ekstern Prometheus forbindes til. Vi tilføjer via remoteWrite VictoriaMetrics.
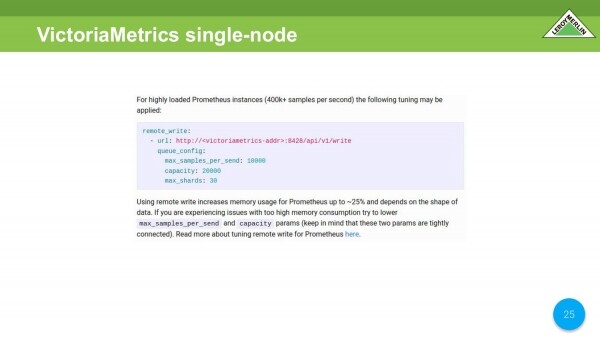
Jeg vil straks nævne, at vi her har oplevet en lille stigning i CPU-forbruget fra VictoriaMetrics. På VictoriaMetrics wiki står der, hvilke parametre der passer bedst. Vi har testet dem. De reducerede CPU-forbruget meget effektivt.
I vores tilfælde er hukommelsesforbruget fra Prometheus, som kører i Kubernetes-klyngen, ikke steget betydeligt.
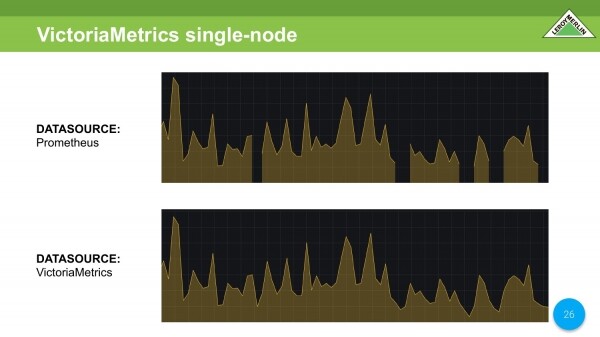
Vi sammenligner to datakilder med de samme data. I Prometheus ser vi stadig alle de manglende data. I VictoriaMetrics ser alt fint ud.
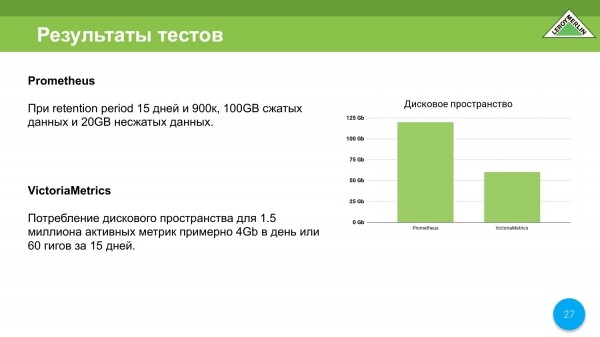
Testresultaterne for diskplads. I Prometheus fik vi i alt 120 gigabyte. I VictoriaMetrics får vi allerede 4 gigabyte om dagen. Der er en lidt anderledes mekanisme end hvad vi er vant til at se i Prometheus. Det betyder, at dataene allerede bliver godt komprimeret inden for en dag og på en halv time. De er allerede godt komprimeret inden for en dag og på en halv time, selvom der senere vil være en sammensmeltning af data. I sidste ende har vi sparet på diskplads.
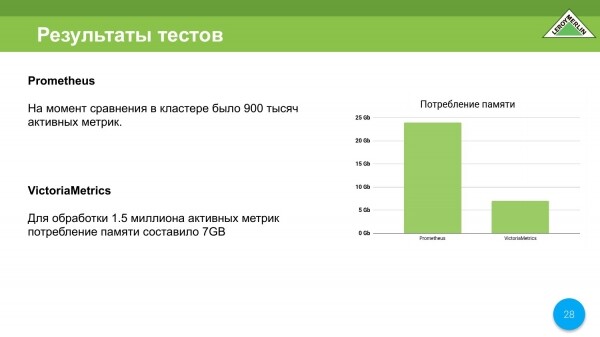
Vi sparer også på hukommelsesressourcer. På tidspunktet for testene var Prometheus installeret på en virtuel maskine – 8 kerner, 24 gigabyte. Prometheus tog stort set alt. Det faldt under OOM Killer. Der var kun 900.000 aktive metrics blevet indlæst. Det er omkring 25.000-27.000 metrics i sekundet.
VictoriaMetrics blev kørende på en to-kernet virtuel maskine med 8 gigabyte RAM. Vi fik VictoriaMetrics til at fungere godt ved at justere nogle indstillinger på den 8-gigabyte maskine. I sidste ende holdt vi os inden for 7 gigabyte, samtidig med at vi opnåede en hurtigere dataoverførsel, dvs. metrics, end Prometheus.
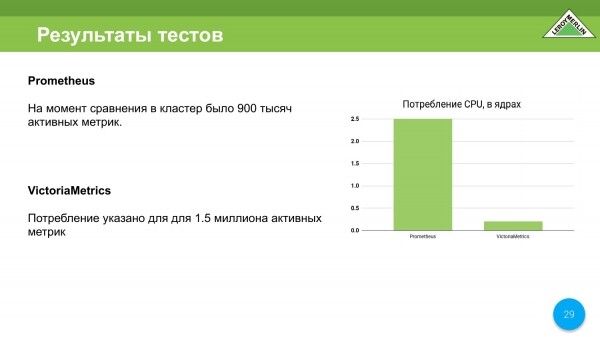
CPU-forbruget er blevet meget bedre i forhold til Prometheus. Her bruger Prometheus 2,5 kerner, mens VictoriaMetrics kun bruger 0,25 kerner. Ved opstart – 0,5 kerner. Mens der er en sammensmeltning, når den når op på en kerne, men det sker ekstremt sjældent.
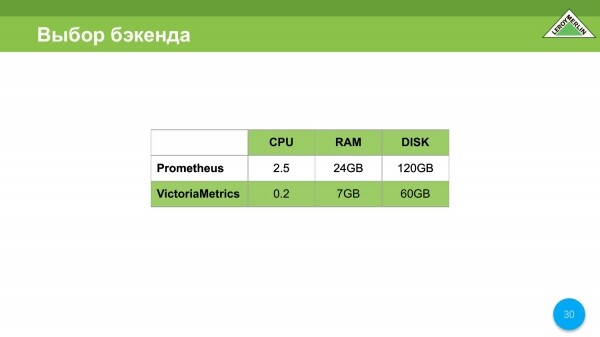
I vores tilfælde valgte vi VictoriaMetrics af åbenlyse grunde, vi ønskede at spare penge, og det lykkedes.
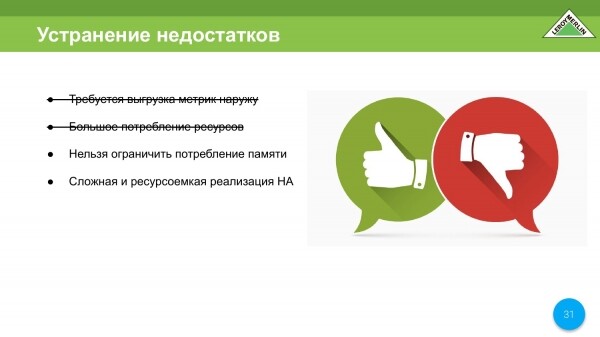
Vi udelader straks to punkter – det er udtrækning af metrics og høj ressourceforbrug. Og vi skal stadig løse to punkter, som vi har tilbage.
Her vil jeg straks nævne, at vi betragter VictoriaMetrics som et metrics-lager. Men da vi sandsynligvis vil tilbyde VictoriaMetrics som lager for hele Leroy, er vi nødt til at begrænse dem, der vil bruge denne klynge, så de ikke ødelægger den.
Der er en fantastisk parameter, der gør det muligt at begrænse efter tid, datamængde og udførelsestid.
Der er også en fremragende mulighed, der giver os mulighed for at begrænse hukommelsesforbruget, hvilket gør det muligt for os at finde den balance, der sikrer en normal driftshastighed og hensigtsmæssigt ressourceforbrug.
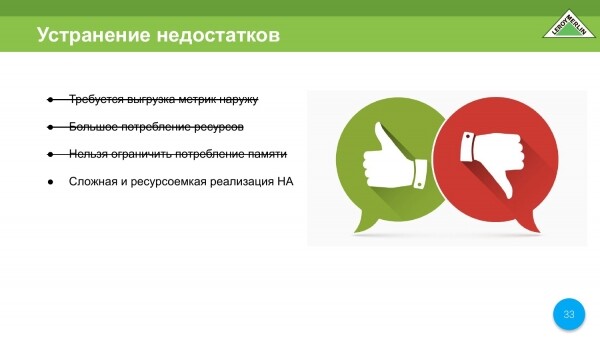
Endnu et minus, således at vi kan strege det punkt – man kan ikke begrænse hukommelsesforbruget.
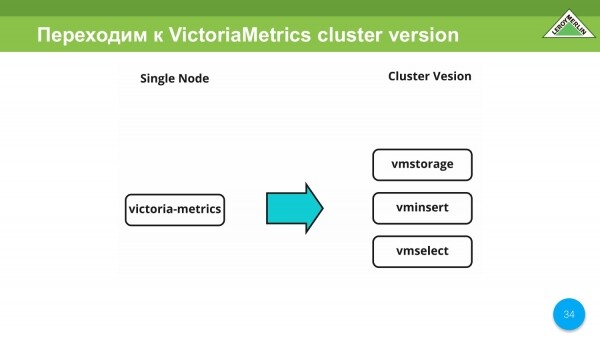
I de første iterationer testede vi VictoriaMetrics Single Node. Dernæst går vi videre til VictoriaMetrics Cluster Version.
Her har vi frihed til at fordele forskellige tjenester i VictoriaMetrics afhængigt af, hvad de kører på, og hvilke ressourcer de forbruger. Det er en meget fleksibel og praktisk løsning. Vi har selv anvendt det.
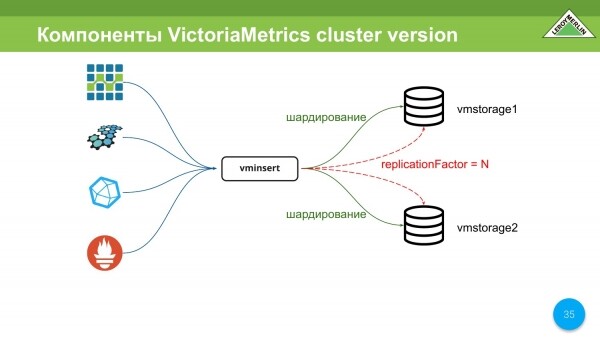
De grundlæggende komponenter i VictoriaMetrics Cluster Version er vmstorage. Der kan være N antal. I vores tilfælde har vi indtil videre 2.
Og der er vminsert. Det er en proxy-server, der gør det muligt for os at: udføre sharding mellem alle storages, som vi har fortalt den om, og den muliggør også replikering, således at du får både sharding og replikation.
Vminsert understøtter OpenTSDB, Graphite, InfluxDB-protokoller og remoteWrite fra Prometheus.
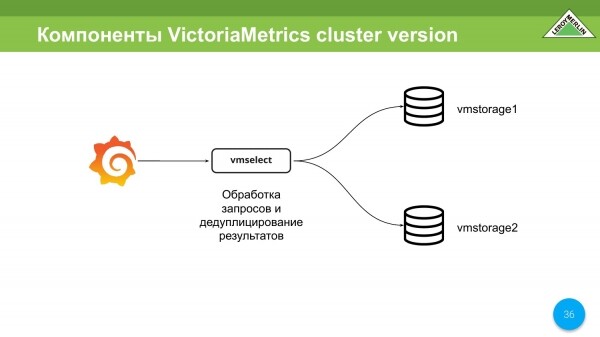
Der er også vmselect. Dens primære opgave er at gå til vmstorage, hente data derfra, deduplikere disse data og returnere dem til klienten.
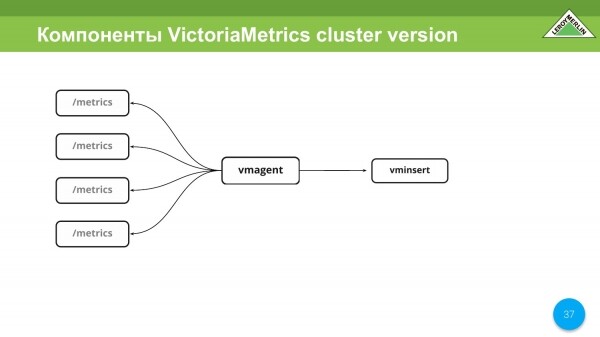
Der er også en fantastisk ting som vmagent. Vi holder virkelig af den. Den gør det muligt at konfigurere på samme måde som Prometheus og gøre alt præcist som Prometheus. Det vil sige, at den indsamler målinger fra forskellige enheder, tjenester og sender dem til vminsert. Herefter afhænger det hele af dig.
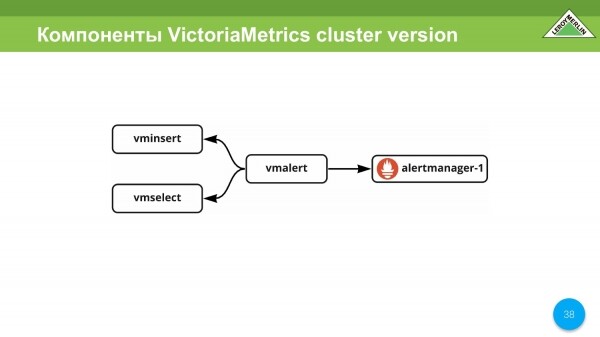
En anden fantastisk service er vmalert, som gør det muligt at bruge VictoriaMetrics som backend, modtage data fra vminsert og sende de behandlede data til vmselect. Den behandler selv alerter og regler. I tilfælde af alerter modtager vi alerter gennem alertmanager.
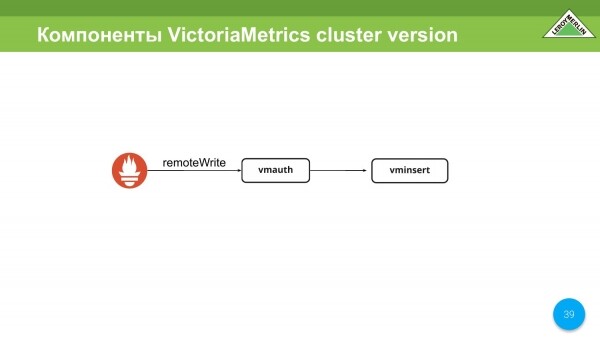
Der er en komponent, wmauth. Den vil muligvis blive brugt af os, eller måske ikke (vi har ikke besluttet os for dette endnu) som et autorisationssystem ved multitenancy-versionerne af klyngen. Den understøtter remoteWrite til Prometheus og kan autorisere baseret på URL, nærmere bestemt den anden del af den, hvor du kan eller ikke kan skrive.
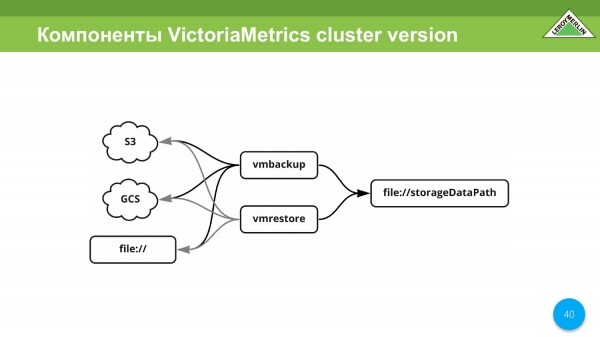
Der er også vmbackup, vmrestore. Det er i bund og grund gendannelse og backup af alle data. Den kan håndtere S3, GCS, fil.
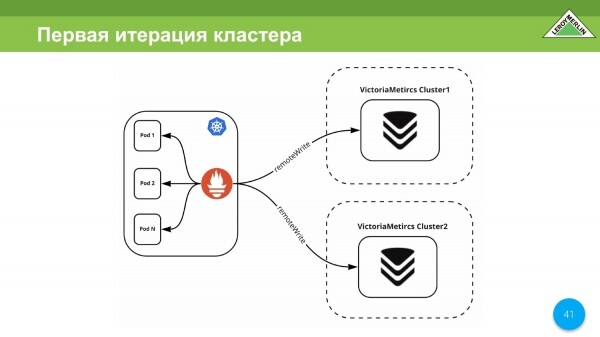
Den første iteration af vores klynge blev gennemført under lockdown. På det tidspunkt havde vi ikke en replika, så vores iteration bestod af to forskellige og uafhængige klynger, hvor vi fik data gennem remoteWrite.
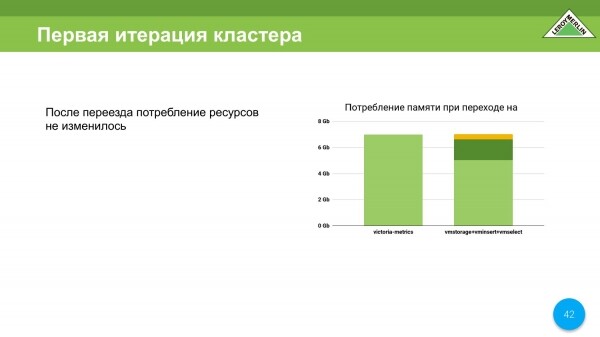
Jeg vil understrege, at da vi skiftede fra VictoriaMetrics Single Node til VictoriaMetrics Cluster Version, forblev vi stadig inden for de samme ressourceforbrug, dvs. primært hukommelse. Vores data blev fordelt omkring på denne måde, dvs. ressourceforbruget.
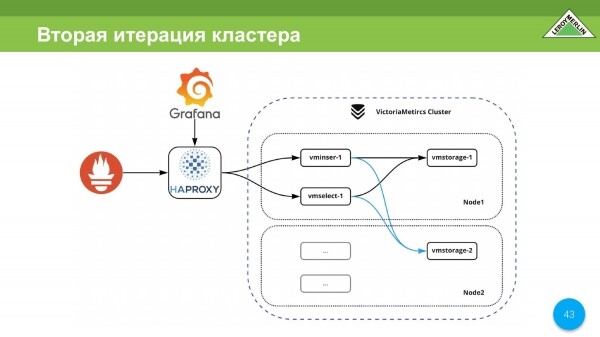
Her blev der allerede tilføjet en replika. Vi samlede det hele i en relativt stor klynge. Alle vores data både sharder og replikeres.
Hele klyngen har N indgangspunkt, dvs. Prometheus kan tilføje data gennem HAPROXY. Her har vi dette indgangspunkt. Gennem dette indgangspunkt kan man få adgang til Grafana.
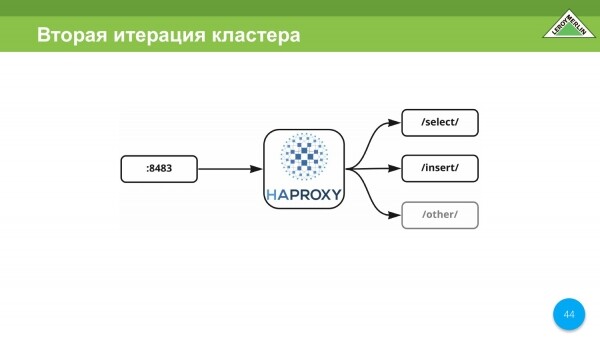
I vores tilfælde er HAPROXY den eneste port, der proxy'er select, insert og andre tjenester ind i denne klynge. Vi kunne ikke lave én adresse, vi blev nødt til at lave flere indgange, fordi de virtuelle maskiner, der kører VictoriaMetrics-klyngen, ligger i forskellige zoner hos en cloud-udbyder, dvs. ikke inden i vores cloud, men udenfor.
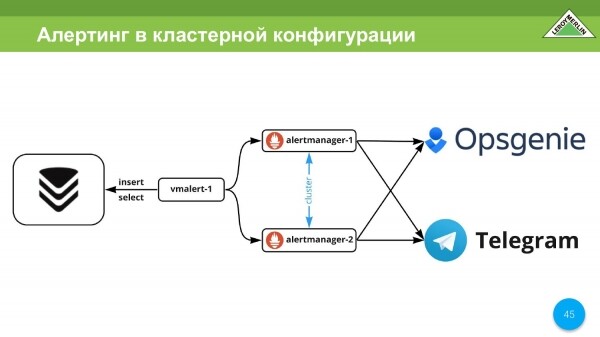
Vi har alerting. Vi bruger det. Vi bruger alertmanager fra Prometheus. Som leveringskanal til alerter bruger vi Opsgenie og Telegram. I Telegram kom der nogle fra dev, måske noget fra prod, men mere statistisk information, der er nyttig for ingeniørerne. Opsgenie er kritisk. Dette omfatter opkald og incident management.
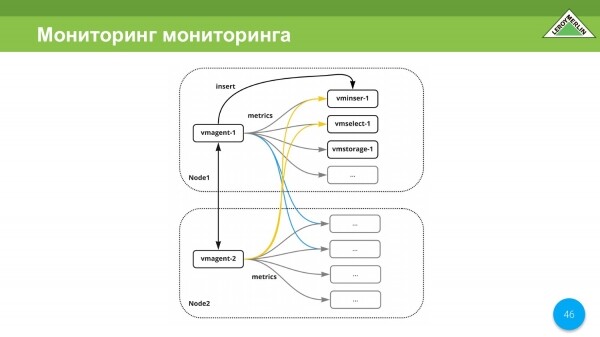
Det evige spørgsmål: 'Hvem monitorerer monitoreringen?'. I vores tilfælde overvåger monitoreringen sig selv, fordi vi bruger vmagent på hver node. Og da vores noder er fordelt på forskellige datacentre hos én udbyder, har hvert datacenter sin egen kanal, de er uafhængige, og selv hvis der opstår split brain, vil vi stadig modtage alerter. Ja, de vil være flere, men det er bedre at få flere alerter end ingen.
Vi afslutter vores liste med implementeringen af HA.
Og jeg vil gerne fremhæve erfaringen med at interagere med VictoriaMetrics-fællesskabet. Det har været meget positivt. Folkene er imødekommende. De forsøger at forstå hver sag, der bliver præsenteret.
Jeg har oprettet issues på GitHub. De blev løst meget hurtigt. Der er et par issues, der ikke er helt afsluttet, men jeg kan allerede se på koden, at der arbejdes i den retning.
Den primære udfordring for mig under iterationerne var, at hvis jeg slukkede en node, kunne vminsert ikke forstå i de første 30 sekunder, at backend'en ikke var til stede. Dette er nu løst. Og på blot et sekund eller to hentes dataene nu fra alle de resterende noder, og forespørgslen stopper med at vente på den manglende node.
Vi ønskede på et tidspunkt fra VictoriaMetrics, at det skulle være VictoriaMetrics operatoren. Vi har endelig fået den. Vi er nu i aktiv opbygning af et lag over VictoriaMetrics operatoren for at tage alle de præ-beregning regler osv. fra Prometheus, fordi vi bruger reglerne, som følger med Prometheus operatoren, ret aktivt.
Der er forslag til forbedringer af den klyngebaserede implementering. Jeg har præsenteret dem ovenfor.
Og jeg ønsker også downsampling meget. I vores tilfælde er downsampling udelukkende nødvendigt for at se trends. Groft sagt vil jeg kun have én metrik i løbet af dagen. Disse trends skal være for et år, tre, fem, ti år. Og én værdi af metrikken er helt tilstrækkelig.
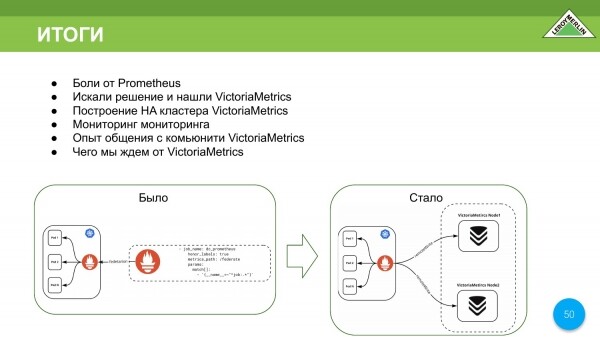
- Vi har erfaret smerte, ligesom nogle af vores kolleger, når vi har brugt Prometheus.
- Vi har valgt VictoriaMetrics til os selv.
- Den skalerer ganske godt både vertikalt og horisontalt.
- Vi kan fordele forskellige komponenter over forskellige mængder noder i klyngen, begrænse dem efter hukommelsesforbrug, tilføje mere hukommelse osv.
Vi vil bruge VictoriaMetrics, fordi vi virkelig kan lide den. Det var hvad der var, og hvad der er blevet til.
Et par qr-koder på VictoriaMetrics chatten, mine kontaktdetaljer, teknologiradar LeroyMerlin.
Kilde: habr.com
