

At skrive denne artikel blev jeg opmuntret af det store antal materialer om statisk analyse, som jeg oftere støder på. For det første er det , som aktivt promoverer sig selv på Habr ved hjælp af anmeldelser af fejl, som deres værktøj har fundet i open source-projekter. For nylig implementerede PVS-studio , og selvfølgelig kunne udviklerne af IntelliJ IDEA, hvis indbyggede analyserer i dag sandsynligvis er den mest avancerede for Java, .
Når man læser sådanne anmeldelser, får man indtryk af, at der er tale om en magisk elixir: tryk på knappen, og voila — listen over defekter dukker op foran en. Det virker som om, at efterhånden som analysatorerne forbedres, vil fejl blive fundet i større og større omfang, og de produkter, der er scannet af disse robotter, vil blive bedre og bedre uden nogen anstrengelse fra vores side.
Men der findes ikke nogen magiske elixirer. Jeg vil gerne tale om, hvad der normalt ikke nævnes i indlæg som «her er hvad vores robot kan finde»: hvad analyseværktøjer ikke kan, hvilken reel rolle de spiller, og hvordan man implementerer dem korrekt i softwareleveringsprocessen.
Katalysator (kilde: ).
Hvad statiske analysatorer aldrig vil kunne gøre
Hvad er, set fra et praktisk synspunkt, analysen af kildekoden? Vi indsender nogle kildefiler, og på kort tid (voldsomt hurtigere end at køre tests) får vi nogle oplysninger om vores system. Det grundlæggende og matematisk uoverkommelige begrænsning er, at vi kun kan få en relativt smal klasse af oplysninger på denne måde.
Det mest berømte eksempel på et problem, der ikke kan løses ved hjælp af statisk analyse — : det er en sætning, der beviser, at det er umuligt at udvikle en generel algoritme, der kan bestemme på baggrund af kildekoden, om et program vil køre i en uendelig løkke eller afslutte på et begrænset tidsrum. En udvidelse af denne sætning er , der for ethvert ikke-trivielt egenskab ved beregnelige funktioner angiver, om et vilkårligt program beregner en funktion med denne egenskab, er en algoritmisk uopslåelig opgave. For eksempel er det umuligt at skrive en analyser, der for enhver kildekode kan bestemme, om det analyserede program er en implementering af en algoritme, der beregner for eksempel kvadratet af et helt tal.
Dermed har funktionaliteten af statiske analyseværktøjer uoverkommelige begrænsninger. En statisk analysator vil aldrig kunne bestemme sådanne ting i alle tilfælde, som for eksempel forekomsten af “null pointer exception” i sprog, der tillader null-værdier, eller i alle tilfælde bestemme forekomsten af “attribute not found” i sprog med dynamisk typificering. Alt, hvad den mest avancerede statiske analysator kan gøre, er at fremhæve særtilfælde, antallet af hvilke blandt alle mulige problemer med din kildekode er, uden overdrivelse, en dråbe i havet.
Statisk analyse er ikke fejlfinding
Af det ovenstående følger konklusionen: statisk analyse er ikke et redskab til at reducere antallet af defekter i programmet. Jeg vover at påstå, at når det først anvendes på dit projekt, vil det finde 'interessante' steder i koden, men sandsynligvis ikke finde nogen defekter, der påvirker kvaliteten af dit programs drift.
Eksempler på defekter, der automatisk er fundet af analyser, er imponerende, men man skal ikke glemme, at disse eksempler er fundet ved at scanne et stort sæt store kodebaser. På samme måde som hackere, der har mulighed for at gennemgå flere enkle adgangskoder på et stort antal konti, til sidst finder de konti, hvor der er en simpel adgangskode.
Betyder det, at statisk analyse ikke skal anvendes? Naturligvis ikke! Og netop af den samme grund, som det er vigtigt at kontrollere hver ny adgangskode mod listen over 'simple' adgangskoder.
Statisk analyse er mere end fejlfinding
I virkeligheden er de praktisk løselige opgaver, der kan analyseres, meget bredere. For statisk analyse er generelt enhver kontrol af kildekoden, der udføres inden deres kørsel. Her er nogle ting, man kan gøre:
- Kontrol af kodestil i ordets brede forstand. Dette inkluderer både kontrol af formatering samt søgning efter brug af tomme/unødvendige parenteser, fastsættelse af tærskelværdier for metrikker som antal linjer / cyklo-matisk kompleksitet af metoden osv. — alt, hvad der potentielt kan gøre koden vanskeligere at læse og vedligeholde. I Java er et sådant værktøj Checkstyle, i Python er det flake8. Programmer af denne type kaldes normalt "linters."
- Ikke kun eksekverbar kode kan analyseres. Resursefiler som JSON, YAML, XML, .properties kan (og bør!) automatisk kontrolleres for gyldighed. Det er bedre at opdage, at strukturen i JSON er brudt på grund af uparrede citationstegn på et tidligt stadium af automatisk kontrol af Pull Request end ved testeksekvering eller runtime. De relevante værktøjer findes: for eksempel, , .
- Kompilering (eller parsing for dynamiske programmeringssprog) er også en form for statisk analyse. Generelt er compilere i stand til at give advarsler, der signalerer problemer med kvaliteten af kildekoden, og disse bør ikke ignoreres.
- Nogle gange er kompilering ikke kun kompilering af eksekverbar kode. For eksempel, hvis du har dokumentation i formatet , så kan ved transformationen til HTML/PDF behandleren AsciiDoctor () generere advarsler, fx om brudte interne links. Og dette er en vægtig grund til ikke at acceptere en Pull Request med ændringer i dokumentationen.
- Stavekontrol er også en form for statisk analyse. Værktøjet kan kontrollere stavemåden ikke kun i dokumentationen, men også i kildekode (kommentarer og litteraler) på forskellige programmeringssprog, herunder C/C++, Java og Python. En stavefejl i brugergrænsefladen eller i dokumentationen er også en defekt!
- Konfigurationstest (om hvad det er — se og foreslår), selvom de udføres i runtime-miljøet for modulærtest som pytest, er de faktisk også en form for statisk analyse, da de ikke eksekverer kildekoden under deres udførelse.
Som vi kan se, spiller fejlfindingsprocessen den mindst vigtige rolle i denne liste, mens alt det andet er tilgængeligt ved hjælp af gratis open source-værktøjer.
Hvilke typer statisk analyse skal anvendes i dit projekt? Selvfølgelig alle, jo flere desto bedre! Det vigtigste er at implementere det korrekt, hvilket vi vil tale om senere.
Leveringspipeline som et flertrinsfilter og statisk analyse som dets første kaskade
Den klassiske metafor for kontinuerlig integration er en pipeline, hvor ændringer strømmer fra ændringen af kildekoden til levering til produktion. Standard rækkefølge af trin i denne pipeline ser således ud:
- statisk analyse
- kompilering
- modultests
- integrationstests
- UI-tests
- manuel kontrol
Ændringer, der afvises på N-te trin af pipelinen, overføres ikke til trin N+1.
Hvorfor netop sådan og ikke anderledes? I den del af pipelinen, der vedrører test, opdager testere den velkendte testpyramide.
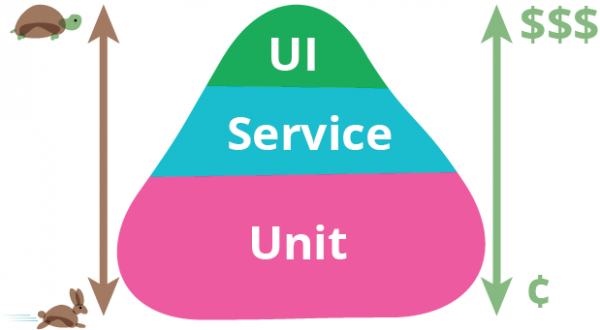
Testpyramiden. Kilde: Martin Fowler.
I bunden af denne pyramide findes tests, der er lettere at skrive, hurtigere at udføre og har færre falske alarmer. Derfor bør der være flere af dem, de bør dække mere kode og udføres først. I toppen af pyramiden er situationen den stik modsatte, så antallet af integrations- og UI-tests bør reduceres til et nødvendigt minimum. Mennesker i denne kæde er den dyreste, langsomste og mest usikre ressource, derfor er de placeret bagerst og udfører kun arbejde, hvis de tidligere trin ikke har opdaget nogen defekter. Men samme principper gælder for pipelinen også i de dele, der ikke er direkte relateret til test!
Jeg vil gerne foreslå en analogi i form af et flertrins vandfiltreringssystem. Den indkommende vand er beskidt (ændringer med defekter), og vi skal få rent vand ud, hvor alle uønskede forurenende stoffer er blevet filtreret fra.
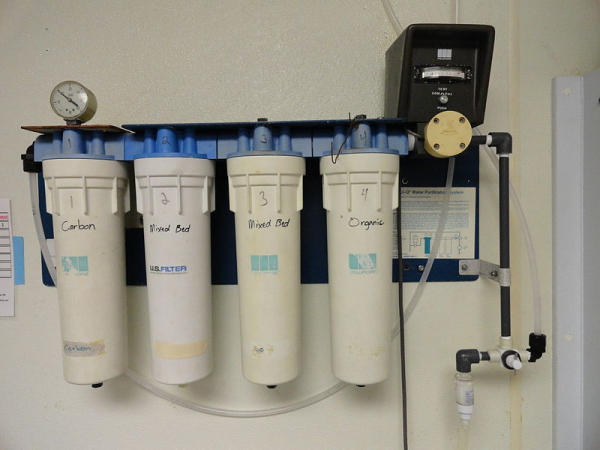
Multitrinsfilter. Kilde:
Som bekendt designes rengøringsfiltre således, at hvert efterfølgende niveau kan sortere stadig finere fraktioner af forurening. Dette betyder, at grovere oprydningsniveauer har en højere kapacitet og lavere omkostninger. I vores analogi betyder det, at indgangsquality gates har større ydeevne, kræver mindre indsats for at blive aktiveret og i sig selv er mere ubesværede i drift — og de er organiseret i netop denne rækkefølge. Rollen af statisk analyse, som vi nu forstår, kun er i stand til at filtrere de groveste fejl — er ligesom en gitter-"snavsefanger" i starten af filtrenes cascade.
Statisk analyse forbedrer ikke kvaliteten af det endelige produkt i sig selv, ligesom en snavsefanger ikke gør vandet drikkeligt. Ikke desto mindre er dens betydning åbenlys i den samlede sammenhæng med andre elementer i produktionslinjen. Selvom den udgående cascade i en multicascade-filterpotentiale er i stand til at opfange det samme, som indgangene gør — er det klart, hvilke konsekvenser det vil have at forsøge at klare sig kun med finere oprydningsniveauer uden de indgående niveauer.
Målet med "snavsefanger" er at lette de efterfølgende cascades for at opfange de mest grove fejl. For eksempel bør en person, der udfører code review, ikke blive distraheret af forkert formateret kode og overtrædelse af fastsatte kodestandarder (som unødvendige parenteser eller for dybe indlejrede forgreninger). Fejl som NPE bør fanges af enhedstest, men hvis analysatoren allerede viser os, at fejlen uundgåeligt vil ske, inden testen — vil det klart fremskynde reparationen.
Jeg mener, det er klart nu, hvorfor statisk analyse ikke forbedrer produktkvaliteten, hvis den anvendes sporadisk, og at det skal anvendes konstant for at filtrere ændringer med grove fejl. Spørgsmålet om, hvorvidt anvendelsen af en statisk analysator vil forbedre kvaliteten af dit produkt, svarer omtrent til spørgsmålet "vil drikkevandskvaliteten forbedres, hvis vandet fra en beskidt dam passes gennem en sigte?"
Implementering i legacy-projekt
Et vigtigt praktisk spørgsmål: hvordan implementerer man statisk analyse i processen for kontinuerlig integration som en "quality gate"? Når det kommer til automatiserede tests, er det klart: der er et sæt tests, og hvis en af dem fejler, er det en tilstrækkelig grund til at anse, at bygningen ikke har bestået quality gate. At forsøge at etablere en gate baseret på resultaterne af statisk analyse mislykkes: på legacy-kode er der alt for mange advarsler fra analysen, man vil ikke helt ignorere dem, men det er umuligt at stoppe leveringen af produktet bare fordi der er advarsler fra analysatoren.
Når analysatoren anvendes for første gang på et hvilket som helst projekt, genererer den et enormt antal advarsler, hvoraf de fleste ikke har noget at gøre med produktets korrekte funktion. Det er umuligt at rette alle disse bemærkninger på én gang, og mange er ikke engang nødvendige at rette. I sidste ende ved vi jo, at vores produkt fungerer generelt, selv før vi implementerer statisk analyse!
Som et resultat begrænser mange sig til sporadisk brug af statisk analyse, eller de bruger det kun i informationsmode, hvor der blot genereres en rapport fra analysatoren ved bygning. Dette er det samme som at have ingen analyse overhovedet, fordi hvis vi allerede har mange advarsler, forbliver forekomsten af endnu en (uanset hvor alvorlig) ved kodemodifikation uset.
Følgende måder til at indføre quality gates er kendt:
- Indstilling af en grænse for det samlede antal advarsler eller antallet af advarsler divideret med antallet af kodelinjer. Dette fungerer dårligt, da sådan en gate let tillader ændringer med nye fejl, så længe deres grænse ikke er overskredet.
- Registrering af alle tidligere advarsler i koden som ignorerede på et bestemt tidspunkt og afvisning af opbygning ved nye advarsler. Denne funktionalitet tilbydes af PVS-studio og nogle online-resurser, såsom Codacy. Jeg har ikke arbejdet med PVS-studio, men med hensyn til min erfaring med Codacy er deres største problem, at det er ret kompliceret at afgøre, hvad der er en "gammel" og hvad der er en "ny" fejl — især når filer ændres eller omdøbes kraftigt. Efter min hukommelse kunne Codacy overse nye advarsler i en pull request, mens de samtidig kunne afvise pull requesten på grund af advarsler, der ikke relaterede sig til ændringerne i denne PR.
- Efter min mening er den mest effektive løsning beskrevet i bogen metoden med tandhjul ("ratcheting"). Hovedideen er, at egenskaben ved hver udgivelse er antallet af advarsler fra statisk analyse, og at kun ændringer, der ikke øger det samlede antal advarsler, er tilladt.
Tandhjul
Det fungerer på den måde:
- I den indledende fase registreres antallet af advarsler i koden, der er fundet af analyserne, i metadatasystemet om udgivelsen. Således registreres ikke blot "udgivelse 7.0.2", men "udgivelse 7.0.2, der indeholder 100500 Checkstyle-advarsler" i din repositories manager. Hvis du bruger en avanceret repositories manager (såsom Artifactory), er det let at gemme sådanne metadata om din udgivelse.
- Nu sammenligner hver pull request ved opbygning antallet af opnåede advarsler med det antal, der findes i den aktuelle udgivelse. Hvis PR'en fører til en stigning i dette antal, passerer koden ikke quality gate ved den statiske analyse. Hvis antallet af advarsler mindskes eller ikke ændres — så består den.
- Ved næste udgivelse vil det genberegnede antal advarsler igen blive registreret i metadataene for udgivelsen.
Sådan set, men stille og roligt (som ved brug af en tandhjul), vil antallet af advarsler til gradvist nærme sig nul. Selvfølgelig kan systemet narres ved at tilføje en ny advarsel, mens man retter en andens. Det er i orden, da det på lang sigt giver resultater: advarsler rettes som regel ikke enkeltvis, men i grupper af en bestemt type, og alle let-udrettede advarsler bliver ret hurtigt løst.
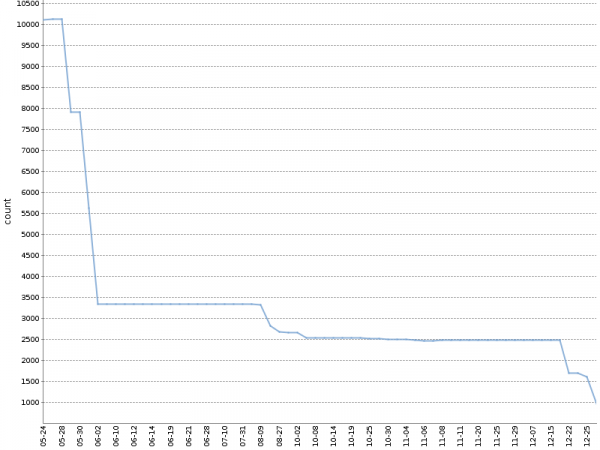
På denne graf ses det samlede antal Checkstyle-advarsler over et halvt års drift af en sådan "tandhjul" på . Antallet af advarsler er faldet med en orden, og dette skete på en naturlig måde, parallelt med produktudviklingen!
Jeg anvender en modificeret version af denne metode, hvor jeg separat tæller advarsler opdelt efter projektmoduler og analyseværktøjer. Den genererede YAML-fil med metadata om buildet ser cirka sådan ud:
celesta-sql:
  checkstyle: 434
  spotbugs: 45
celesta-core:
  checkstyle: 206
  spotbugs: 13
celesta-maven-plugin:
  checkstyle: 19
  spotbugs: 0
celesta-unit:
  checkstyle: 0
  spotbugs: 0
I ethvert avanceret CI-system kan "tandhjulet" implementeres for enhver statisk analyseværktøj, uden at man er afhængig af plugins og tredjeparts værktøjer. Hver af analyserne giver sin rapport i et simpelt tekst- eller XML-format, som er let at analysere. Det kræver kun at skrive den nødvendige logik i CI-scriptet. Man kan se, hvordan dette er implementeret i vores open source-projekter baseret på Jenkins og Artifactory, eller . Begge eksempler afhænger af biblioteket : metoden countWarnings() tæller almindeligvis xml-tags i de filer, som Checkstyle og Spotbugs genererer, og compareWarningMaps() implementerer det nævnte tandhjul, hvilket kaster en fejl, hvis antallet af advarsler i en hvilken som helst kategori stiger.
En interessant implementeringsmulighed for 'ratchet'-systemet er til analyse af stavning i kommentarer, tekstliteraler og dokumentation ved hjælp af aspell. Som bekendt er det ikke alle ord, der ikke er anerkendt af standardordbogen, der er forkerte; de kan tilføjes til brugerordbogen. Hvis du gør brugerordbogen til en del af projektets kode, kan kvalitetsticketet for stavning formuleres således: udføre aspell med både standard- og brugerordbogen. finde nogen stavefejl.
Om vigtigheden af at fastlåse versionen af analysatoren
Afslutningsvis skal det bemærkes, at uanset hvordan du implementerer analysen i din leveringslinje, bør versionen af analysatoren være fastlåst. Hvis analysatoren opdateres af sig selv, kan der 'opstå' nye defekter ved sammensætningen af en pull request, som ikke er relateret til kodeændringer, men til at den nye analysator simpelthen er i stand til at finde flere defekter - hvilket vil forstyrre din proces med godkendelse af pull requests. Opgradering af analysatoren skal være en bevidst handling. For øvrigt er fastlåsning af versionen af hver komponent i bygningen i det hele taget et nødvendigt krav og emnet for en separat samtale.
Konklusioner
- Statisk analyse finder ikke bugs og forbedrer ikke kvaliteten af dit produkt ved blot at blive anvendt én gang. Den positive effekt på kvaliteten opnås kun ved dens konstante anvendelse i leveringsprocessen.
- At finde bugs er slet ikke hovedopgaven for analysen; stort set alle nyttige funktioner er tilgængelige i open source-værktøjer.
- Implementer kvalitetsgate ved resultaterne af statisk analyse i den allerførste fase af leveringslinjen ved at bruge 'ratchet' til legacy-kode.
Links
- en rapport om forskellige metoder til kodeanalyse (ikke kun statisk!)
Kilde: habr.com
