

Background
Det skete, at serveren blev angrebet af et ransomware-virus, som ved "held" delvist efterlod .ibd-filerne (filer med rå data fra InnoDB-tabeller), men samtidig krypterede .fpm-filerne (struktur-filer) fuldstændigt. Her kunne .idb opdeles i:
- filer, der kan genskabes via standardværktøjer og guider. Til sådanne tilfælde er der en fremragende ;
- delvist krypterede tabeller. Primært er dette store tabeller, som (som jeg forstod det), angriberne ikke havde tilstrækkelig RAM til at fuldføre krypteringen af;
- og helt krypterede tabeller, der ikke kan genskabes.
At bestemme, hvilken kategori tabellerne tilhører, kunne gøres ved simpelt at åbne filen i en hvilken som helst teksteditor med den passende kodning (i mit tilfælde UTF8) og blot se filen for tekstfelter, f.eks.:
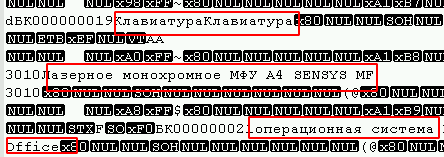
Derudover kan man i starten af filen observere et stort antal nulbyte, og vira, der bruger blokke-krypteringsalgoritmer (som er de mest almindelige), berører normalt dem.

I mit tilfælde efterlod angriberne i slutningen af hver krypteret fil en sekvens af 4 byte (1, 0, 0, 0), hvilket gjorde opgaven lettere. Til at finde de ikke-smittede filer var det tilstrækkeligt med et script:
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) - 4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
På den måde lykkedes det at finde filer, der tilhørte den første type. Den anden indebærer lang manuel behandling, men det fundne var allerede tilstrækkeligt. Alt ville være godt, men det er nødvendigt at vide den præcise struktur og (selvfølgelig) opstod der et tilfælde, hvor jeg var nødt til at arbejde med en ofte ændrende tabel. Ingen kunne huske, om felttypen blev ændret, eller om der blev tilføjet en ny kolonne.
Desværre kunne Databasedebrag hjælpe i sådan et tilfælde, derfor skrives denne artikel.
Lad os komme til sagen
Der er en tabelstruktur fra tre måneder siden, som ikke stemmer overens med den nuværende (måske kun et felt, eller muligvis flere). Tabelstrukturen er:
CREATE TABLE `table_1` (
    `id` INT (11),
    `date` DATETIME ,
    `description` TEXT ,
    `id_point` INT (11),
    `id_user` INT (11),
    `date_start` DATETIME ,
    `date_finish` DATETIME ,
    `photo` INT (1),
    `id_client` INT (11),
    `status` INT (1),
    `lead__time` TIME ,
    `sendstatus` TINYINT (4)
);
der skal udtrækkes:
id_pointINT (11);id_userINT (11);date_startDATETIME ;date_finishDATETIME .
Til gendannelse anvendes byte-analyse af .ibd-filen, efterfulgt af en konvertering til et mere læsbart format. Da vi for at finde det nødvendige kun behøver at analysere datatyper som int og datetime, vil artiklen kun beskrive disse, men nogle gange vil jeg også henvise til andre datatyper, hvilket kan hjælpe i lignende situationer.
Problem 1: i felterne med datatyperne DATETIME og TEXT fandtes NULL værdi, og i filen bliver de simpelthen udeladt, hvilket gjorde det umuligt at bestemme strukturen for gendannelse i mit tilfælde. I de nye kolonner var standardværdien null, og en del af transaktionen kunne være tabt på grund af indstillingen innodb_flush_log_at_trx_commit = 0, så der ville være nødvendig at bruge ekstra tid på at bestemme strukturen.
Problem 2: det skal tages i betragtning, at rækker, der er slettet via DELETE, stadig vil være til stede i ibd-filen, men ved ALTER TABLE vil deres struktur ikke opdateres. Resultatet er, at datostrukturen kan variere fra starten til slutningen af filen. Hvis du ofte bruger OPTIMIZE TABLE, vil du sandsynligvis ikke støde på sådan et problem.
Vær opmærksom på, versionen af databasehåndteringssystemet påvirker, hvordan data gemmes, og dette eksempel kan muligvis ikke fungere for andre hovedversioner. I mit tilfælde blev windows-versionen af mariadb 10.1.24 brugt. Desuden, selvom du i mariadb arbejder med InnoDB-tabeller, er de i realiteten , hvilket udelukker anvendelse af metoden med InnoDB mysql.
Analyse af fil
I python repræsenterer datatypen vis data i Unicode i stedet for det almindelige talformat. Selvom filen kan ses i denne form, kan det for nemheds skyld være lettere at konvertere bytes til numerisk form ved at omdanne bytearrayet til et almindeligt array (list(example_byte_array)). Under alle omstændigheder vil begge metoder være nyttige til analysen.
Ved at gennemgå flere ibd-filer kan man finde følgende:
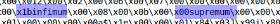
Og hvis man opdeler filen efter disse nøgleord, vil man hovedsageligt få jævne datablokke. Vi vil bruge infimum som divider.
table = table.split("infimum".encode())En interessant observation er, at for tabeller med et lille antal data er der en markør for antallet af rækker i blokken mellem infimum og supremum.
 — testtabel med 1 række
 — testtabel med 2 rækker
Det array af strenge table[0] kan overses. Efter at have gennemgået det, kunne jeg stadig ikke finde de rå tabeldata. Det er sandsynligvis, fordi dette blok tjener til at opbevare indekser og nøgler.
Fra table[1] og ved at konvertere den til et numerisk array, kan man allerede se nogle mønstre, nemlig:
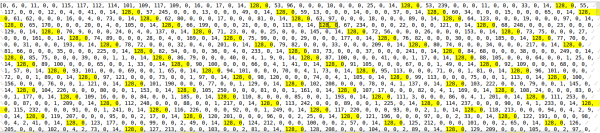
Dette er int-værdier gemt i strengen. Den første byte angiver, om tallet er positivt eller negativt. I mit tilfælde er alle tal positive. Fra de resterende 3 bytes kan tallet bestemmes ved hjælp af følgende funktion. Script:
def find_int(val: str):  # eksempel '128, 1, 2, 3'
    val = [int(v) for v in  val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
For eksempel, 128, 0, 0, 1 = 1, eller 128, 0, 75, 108 = 19308.
Der var en primær nøgle med auto-inkrement i tabellen, og her kan den også findes.
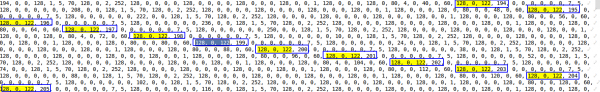
Ved at matche dataene fra testtabellerne blev det afsløret, at objektet DATETIME består af 5 bytes, der startede med 153 (sandsynligvis angiver årspænd). Da DATETIME-intervallet er ‘1000-01-01’ til ‘9999-12-31’, tror jeg, antallet af bytes kan variere, men i mit tilfælde falder dataene inden for intervallet fra 2016 til 2019, så vi antager, at 5 bytes er tilstrækkeligt.
For at bestemme tiden uden sekunder blev følgende funktioner skrevet. Script:
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    if x1 % 2 == 0:
        return x2 // 16
    elif x1 % 2 == 1:
        return x2 // 16 + 16
    else:
        raise ValueError

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
For år og måned kunne jeg ikke skrive en velfungerende funktion, så jeg måtte hardcode det. Script:
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 // 64 == value[2] // 64:
            return key
    return 0, 0
Jeg er sikker på, at hvis der bruges n antal timer, kan dette misforhold også rettes.
Dernæst en funktion, der returnerer et datetime-objekt fra en streng. Scriptet:
def find_data_time(val:str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Det lykkedes at finde ofte gentagne værdier fra int, int, datetime, datetime 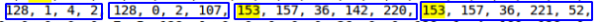 , det ser ud til, at dette er hvad der skal til. Derudover gentages en sådan sekvens ikke to gange i løbet af strengen.
Ved hjælp af regulære udtryk finder vi de nødvendige data:
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Bemærk, at når der søges med dette udtryk, vil det ikke være muligt at bestemme NULL-værdier i de krævede felter, men for mit vedkommende er det ikke kritisk. Efterfølgende gennemgår vi de fundne i en løkke. Scriptet:
result = []
for val in fined:
    pre_result = []
    bd_int  = re.findall(r"128, d*, d*, d*", val)
    bd_date= re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    for it in bd_int:
        pre_result.append(find_int(bd_int[it]))
    for bd in bd_date:
        pre_result.append(find_data_time(bd))
    result.append(pre_result)
Faktisk er alt, dataene fra arrayet result, det er de nødvendige oplysninger for os. ###PS.###
Jeg forstår, at denne metode ikke vil passe til alle, men hovedformålet med artiklen er mere at inspirere til handling end at løse alle dine problemer. Jeg tænker, det mest korrekte ville være at starte med at studere kildekoden selv , men på grund af begrænset tid synes den nuværende metode at være den hurtigste.
I nogle tilfælde kan du ved at analysere filen bestemme den omtrentlige struktur og gendan den ved hjælp af en af de standardmetoder, der er nævnt ovenfor. Det ville være meget mere korrekt og medføre færre problemer.
Kilde: habr.com
