

I dag vil vi tale om principperne og modellerne for GitOps samt hvordan disse modeller implementeres på OpenShift platformen. En interaktiv guide om emnet er tilgængelig. .
Kort sagt er GitOps et sæt praktiske metoder til at anvende Git pull-anmodninger til at styre konfigurationer af infrastruktur og applikationer. Git-repositoriet inden for GitOps betragtes som den eneste kilde til information om systemets tilstand, hvor enhver ændring af denne tilstand er fuldt sporbar og underlagt revision.
Ideen om at spore ændringer i GitOps er på ingen måde ny; denne tilgang har længe været og bruges i vid udstrækning til arbejdet med kildekoden til applikationer. GitOps implementerer blot lignende funktioner (review-checks, pull-anmodninger, tags osv.) ved administration af konfigurationer af infrastruktur og applikationer og giver de samme fordele som ved håndtering af kildekode.
Der findes ingen akademisk definition eller godkendte regler for GitOps, kun et sæt principper, som denne praksis bygger på:
- Den deklarative beskrivelse af systemet gemmes i et Git-repository (konfigurationer, overvågning osv.).
- Ændringer i tilstanden foretages gennem pull-anmodninger.
- Den nuværende tilstand af de fungerende systemer bringes i overensstemmelse med dataene i repositoriet ved hjælp af Git push-anmodninger.
GitOps-principper
- Systemdefinitionerne beskrives som kildekode
Systemkonfiguration betragtes som kode, hvilket betyder, at den kan gemmes og automatisk versionsstyres i et Git-repository, som fungerer som den eneste sandhedskilde. Denne tilgang gør det muligt at rulle (rollout) og tilbagekalde (rollback) ændringer i systemerne nemt.
- Den ønskede tilstand og konfiguration af systemerne defineres og versionsstyres i Git.
Ved at gemme og versionsstyre den ønskede tilstand af systemerne i Git, får vi muligheden for nemt at rulle og tilbagekalde ændringer i systemerne og applikationerne. Vi kan også bruge Git's sikkerhedsmekanismer til at kontrollere ejerskabet af koden og bekræfte dens ægthed.
- Ændringer i konfigurationerne kan anvendes automatisk ved hjælp af pull-anmodninger.
Ved at bruge Git pull-requests kan vi nemt styre, hvordan ændringer anvendes på konfigurationer i repositoryet. For eksempel kan de sendes til gennemsyn af andre teammedlemmer eller køre tests i CI.
Og samtidig er der ikke behov for at give administratorrettigheder til højre og venstre. For at kunne foretage commit af ændringer i konfigurationen skal brugerne have de relevante rettigheder i Git-repositoriet, hvor disse konfigurationer opbevares.
- Løsning på problemet med ukontrolleret konfigurationsdrift.
Når den ønskede tilstand af systemet opbevares i et Git-repository, skal vi blot finde software, der kan kontrollere, at den nuværende tilstand af systemet svarer til den ønskede tilstand. Hvis dette ikke er tilfældet, skal denne software – afhængigt af indstillingerne – enten selv løse uoverensstemmelsen eller underrette os om konfigurationsdriften.
GitOps-modeller til OpenShift.
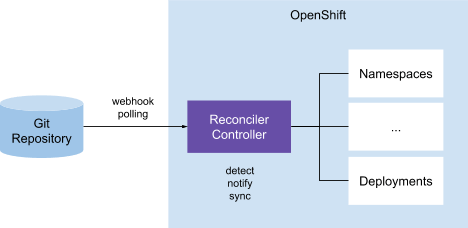
On-Cluster Resource Reconciller.
Ifølge denne model er der en controller i klyngen, som er ansvarlig for at sammenligne Kubernetes-ressourcer (YAML-filer) i Git-repositoriet med de reelle ressourcer i klyngen. Ved opdagelse af uoverensstemmelser udsender controllere underretninger og kan muligvis tage skridt til at løse uoverensstemmelserne. Denne GitOps-model bruges i Anthos Config Management og Weaveworks Flux.
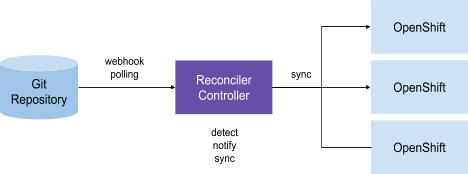
External Resource Reconciler (Push).
Denne model kan betragtes som en variant af den forrige, hvor vi har en eller flere controllere, der er ansvarlige for synkronisering af ressourcer mellem "Git-repository - Kubernetes-klynge". Forskellen her er, at der ikke er nødvendigvis behov for en separat controller i hver administreret klynge. Parene "Git - klynge k8s" defineres ofte som CRD-beskrivelser (custom resources definition), hvor det er muligt at angive, hvordan controlleren skal udføre synkroniseringen. Inden for denne model sammenligner controllerne Git-repositoryet, angivet i CRD, med Kubernetes-ressourcerne, som også er angivet i CRD, og foretager de relevante handlinger baseret på sammenligningen. Især bruges en sådan GitOps-model i ArgoCD.
GitOps på OpenShift-platformen.
Administration af multiklynge Kubernetes-infrastruktur.
Med udbredelsen af Kubernetes og den stigende popularitet af multi-cloud strategier og edge computing stiger det gennemsnitlige antal OpenShift-klynger per kunde.
For example, when using edge computing, a single customer's clusters can be deployed in hundreds or even thousands. As a result, they have to manage several independent or coordinated OpenShift clusters in both public cloud and on-premise environments.
In this context, a multitude of issues must be addressed, including:
- Ensuring that the clusters are in identical states (configs, monitoring, storage, etc.)
- Recreating (or restoring) clusters to a known state.
- Creating new clusters based on a known state.
- Deploying changes to multiple OpenShift clusters.
- Rolling back changes on multiple OpenShift clusters.
- Linking templated configurations with various environments.
Application configurations
Throughout their lifecycle, applications often pass through a series of clusters (dev, stage, etc.) before they reach the production cluster. Additionally, due to availability and scalability requirements, customers often deploy applications immediately across several on-premise clusters or in multiple regions of a public cloud platform.
In this context, several tasks must be resolved:
- Ensuring the movement of applications (binaries, configs, etc.) between clusters (dev, stage, etc.).
- Deploying changes in applications (binaries, configs, etc.) across multiple OpenShift clusters.
- Rolling back application changes to the previous known state.
OpenShift GitOps use cases
1. Applying changes from a Git repository
A cluster admin can store OpenShift cluster configurations in a Git repository and automatically apply them to effortlessly create new clusters and bring them to a state identical to the known state stored in the Git repository.
2. Synchronizing with Secret Manager
Admins will also benefit from the ability to synchronize OpenShift secret objects with corresponding software like Vault to manage them with specially designed tools.
3. Configuration drift control
An admin would welcome OpenShift GitOps identifying and alerting discrepancies between actual configurations and those specified in the repository, enabling prompt responses to drift.
4. Underretninger om konfigurationsdrift
Dette er nyttigt, når en administrator hurtigt ønsker at blive informeret om tilfælde af konfigurationsdrift, så de kan træffe de nødvendige foranstaltninger med det samme.
5. Manuel synkronisering af konfigurationer ved drift
Giver administratoren mulighed for at synkronisere OpenShift-klyngen med Git-repositoriet i tilfælde af konfigurationsdrift, så klyngen hurtigt kan tilbageføres til en tidligere kendt tilstand.
6. Autosynkronisering af konfigurationer ved drift
Administrator kan også konfigurere OpenShift-klyngen til automatisk synkronisering med repositoriet ved opdagelse af drift, så konfigurationen af klyngen altid svarer til konfigurationsfilerne i Git.
7. Flere klynger – ét repositorium
Administrator kan gemme konfigurationerne for flere forskellige OpenShift-klynger i ét Git-repositorium og anvende dem selektivt efter behov.
8. Hierarki af klyngekonfigurationer (arv)
Administrator kan definere et hierarki af klyngekonfigurationer i repositoriet (stage, prod, app portfolio osv. med arv). Med andre ord kan de bestemme, hvordan konfigurationer skal anvendes – til en eller flere klynger.
For eksempel, hvis administratoren definerer i Git-repositoriet et hierarki "Produktion klynger (prod) → System X klynger → Produktion klynger for system X", så anvendes en kombination af følgende konfigurationer for system X's produktionsklynger:
- Konfigurationer, der er fælles for alle produktionsklynger.
- Konfigurationer for system X's klynge.
- Konfigurationer for produktionsklyngen for system X.
9. Skabeloner og omdefinering af konfigurationer
Administrator kan omdefinere sættet af arvede konfigurationer og deres værdier for at finjustere konfigurationen til specifikke klynger, hvor de skal anvendes.
10. Selektive inkluderings- og ekskluderingsregler for konfigurationer, applikationskonfigurationer
Administrator kan angive betingelser for anvendelse eller ikke-anvendelse af bestemte konfigurationer til klynger med specifikke egenskaber.
11. Understøttelse af skabeloner
Udviklere vil finde det nyttigt at vælge, hvordan applikationsressourcerne skal defineres (Helm Chart, ren Kubernetes yaml osv.), så de kan bruge det mest hensigtsmæssige format for hver enkel applikation.
GitOps værktøjer på OpenShift-platformen
ArgoCD
ArgoCD implementerer modellen External Resource Reconcile og tilbyder en centraliseret UI til orkestrering af relationer mellem klynger og Git-repositorier i et 'én-til-mange' forhold. Ulempen ved dette program er, at det ikke er muligt at administrere applikationer, når ArgoCD ikke fungerer.
Flux
Flux implementerer modellen On-Cluster Resource Reconcile, og som konsekvens mangler der centraliseret styring af definitionsrepoet, hvilket er en svaghed. På den anden side, netop på grund af manglen på centralisering, bevares muligheden for at administrere applikationer, selv hvis en klynge fejler.
Installation af ArgoCD på OpenShift
ArgoCD tilbyder en fremragende kommandolinjeinterface og webkonsol, så vi vil ikke gennemgå Flux og andre alternativer her.
For at implementere ArgoCD på OpenShift 4, skal du udføre følgende trin som klyngeadministrator:
Implementering af ArgoCD-komponenter på OpenShift-platformen
# Create a new namespace for ArgoCD components
oc create namespace argocd
# Apply the ArgoCD Install Manifest
oc -n argocd apply -f https://raw.githubusercontent.com/argoproj/argo-cd/v1.2.2/manifests/install.yaml
# Get the ArgoCD Server password
ARGOCD_SERVER_PASSWORD=$(oc -n argocd get pod -l "app.kubernetes.io/name=argocd-server" -o jsonpath='{.items[*].metadata.name}')
Tilpasning af ArgoCD Server, så den kan ses af OpenShift Route
# Patch ArgoCD Server so no TLS is configured on the server (--insecure)
PATCH='{"spec":{"template":{"spec":{"$setElementOrder/containers":[{"name":"argocd-server"}],"containers":[{"command":["argocd-server","--insecure","--staticassets","/shared/app"],"name":"argocd-server"}]}}}}'
oc -n argocd patch deployment argocd-server -p $PATCH
# Expose the ArgoCD Server using an Edge OpenShift Route so TLS is used for incoming connections
oc -n argocd create route edge argocd-server --service=argocd-server --port=http --insecure-policy=Redirect
Implementering af ArgoCD Cli Tool
# Download the argocd binary, place it under /usr/local/bin and give it execution permissions
curl -L https://github.com/argoproj/argo-cd/releases/download/v1.2.2/argocd-linux-amd64 -o /usr/local/bin/argocd
chmod +x /usr/local/bin/argocd
Ændring af administratorens adgangskode til ArgoCD Server
# Get ArgoCD Server Route Hostname
ARGOCD_ROUTE=$(oc -n argocd get route argocd-server -o jsonpath='{.spec.host}')
# Login with the current admin password
argocd --insecure --grpc-web login ${ARGOCD_ROUTE}:443 --username admin --password ${ARGOCD_SERVER_PASSWORD}
# Update admin's password
argocd --insecure --grpc-web --server ${ARGOCD_ROUTE}:443 account update-password --current-password ${ARGOCD_SERVER_PASSWORD} --new-password
Efter at have udført disse trin kan du arbejde med ArgoCD Server via ArgoCD WebUI eller ArgoCD Cli kommandolinjeværktøjet.
GitOps – Det er aldrig for sent
"Toget er kørt" – sådan siger man om en situation, når muligheden for at gøre noget er gået tabt. I tilfældet med OpenShift skaber ønsket om straks at begynde at bruge denne nye fede platform ofte en sådan situation med administration og vedligeholdelse af ruter, deployments og andre OpenShift-ressourcer. Men er chancen altid helt gået tabt?
Vi fortsætter serien af artikler om , i dag viser vi, hvordan man omdanner en håndskabt applikation og dens ressourcer til en proces, hvor alt administreres af GitOps-værktøjet. Til dette vil vi først håndtere installationen af httpd-applikationen. I skærmbilledet nedenfor ses, hvordan vi opretter et namespace, deployment og service, og derefter eksponerer denne service for at oprette en rute.
oc create -f https://raw.githubusercontent.com/openshift/federation-dev/master/labs/lab-4-assets/namespace.yaml
oc create -f https://raw.githubusercontent.com/openshift/federation-dev/master/labs/lab-4-assets/deployment.yaml
oc create -f https://raw.githubusercontent.com/openshift/federation-dev/master/labs/lab-4-assets/service.yaml
oc expose svc/httpd -n simple-app
Så vi har en håndskabt applikation. Nu skal den overføres til at blive administreret af GitOps uden at miste tilgængeligheden. Kort sagt, dette gør man ved at:
- Oprette et Git-repositorium til koden.
- Eksporterer vores nuværende objekter og uploader dem til Git-repositoriet.
- Vælger og implementerer GitOps-værktøjer.
- Tilføjer vores repository til dette værktøj.
- Definerer applikationen i vores GitOps-værktøjer.
- Udfører en testkørsel af applikationen ved hjælp af GitOps-værktøjer.
- Synkroniserer objekter ved hjælp af GitOps-værktøjer.
- Aktiverer rengøring (pruning) og automatisk synkronisering af objekter.
Som nævnt før , i GitOps er der én og kun én kilde til oplysninger om alle objekter i Kubernetes-klynger – Git-repositoriet. Herefter går vi ud fra, at I allerede bruger et Git-repository i virksomheden. Det kan være offentligt eller privat, men det skal være tilgængeligt for Kubernetes-klynger. Dette kan være det samme repository, som bruges til applikationskoden, eller et separat repository oprettet specifikt til deployment. Det anbefales at have strenge tilladelser i repositoryet, da der vil blive opbevaret sensitive oplysninger som secrets, ruter og andre sikkerhedsfølsomme elementer.
I vores eksempel vil vi oprette et nyt offentligt repository på GitHub. Det kan navngives, hvad som helst, vi bruger navnet blogpost.
Hvis YAML-filerne ikke blev opbevaret lokalt eller i Git, skal vi bruge binærfilerne oc eller kubectl. På skærmbilledet nedenfor anmoder vi om YAML for vores namespace, deployment, service og rute. Før dette klonede vi det nyoprettede repository og navigerede ind i det med kommandoen cd.
oc get namespace simple-app -o yaml --export > namespace.yaml
oc get deployment httpd -o yaml -n simple-app --export > deployment.yaml
oc get service httpd -o yaml -n simple-app --export > service.yaml
oc get route httpd -o yaml -n simple-app --export > route.yaml
Nu retter vi deployment.yaml-filen for at fjerne det felt, som Argo CD ikke kan synkronisere.
sed -i '/sgeneration: .* /d' deployment.yamlDerudover skal ruten ændres. Først definerer vi en flermulig variabel, og derefter erstatter vi ingress: null med indholdet af denne variabel.
export ROUTE=" ingress:
    - conditions:
        - status: 'True'
          type: Admitted"

sed -i "s/  ingress: null/$ROUTE/g" route.yaml
Så har vi styr på filerne og skal blot gemme dem i Git-repositoriet. Herefter bliver dette repository den eneste kilde til oplysninger, og manuelt ændrede objekter skal være strengt forbudt.
git commit -am 'initial commit of objects'
git push origin master
Vi antager, at du allerede har implementeret ArgoCD (hvordan man gør det - se tidligere) ). Derfor tilføjer vi det repo, vi har oprettet i Argo CD, som indeholder koden fra vores eksempel. Sørg for, at du angiver netop det repo, du oprettede tidligere.
argocd repo add https://github.com/cooktheryan/blogpostNu opretter vi en applikation. Applikationen definerer værdier, så GitOps-værktøjet forstår, hvilket repo og stier der skal bruges, hvilken OpenShift der er nødvendig for at håndtere objekterne, samt hvilken specifik gren af repoet der er nødvendig, og om der skal udføres automatisk synkronisering af ressourcer.
argocd app create --project default
--name simple-app --repo https://github.com/cooktheryan/blogpost.git
--path . --dest-server https://kubernetes.default.svc
--dest-namespace simple-app --revision master --sync-policy none
Når applikationen er defineret i Argo CD, begynder dette værktøj at tjekke de allerede implementerede objekter for at sikre, at de stemmer overens med definitionerne i repoet. I vores eksempel er automatisk synkronisering og oprydning deaktiveret, så elementerne forbliver uændrede. Bemærk, at vores applikation i Argo CD-interfacet vil have status "Out of Sync", da der mangler en label, som ArgoCD allokerer.
Det er derfor, når vi senere starter synkroniseringen, vil der ikke blive udført genimplementering af objekterne.
Nu kører vi et prøveklip for at sikre, at der ikke er fejl i vores filer.
argocd app sync simple-app --dry-runHvis der ikke er fejl, kan vi gå videre til synkronisering.
argocd app sync simple-appEfter at have kørt kommandoen argocd get på vores applikation, skal vi se, at applikationens status er ændret til Healthy eller Synced. Dette vil betyde, at alle ressourcer i Git-repo nu stemmer overens med de ressourcer, der allerede er implementeret.
argocd app get simple-app
Name:               simple-app
Project:            default
Server:             https://kubernetes.default.svc
Namespace:          simple-app
URL:                https://argocd-server-route-argocd.apps.example.com/applications/simple-app
Repo:               https://github.com/cooktheryan/blogpost.git
Target:             master
Path:               .
Sync Policy:
Sync Status:        Synced to master (60e1678)
Health Status:      Healthy
...
Nu kan vi aktivere automatisk synkronisering og oprydning for at sikre, at der ikke oprettes noget manuelt, og at hver gang et objekt oprettes eller opdateres i repoet, vil der blive udført en implementering.
argocd app set simple-app --sync-policy automated --auto-prune Så vi har med succes overført en applikation til GitOps, der oprindeligt slet ikke brugte GitOps.
Kilde: habr.com
