

I anledning af starten på kurset vi har forberedt endnu en nyttig oversættelse til dig.
Grafdatabaser er en vigtig teknologi for databaseeksperter. Jeg forsøger at holde mig ajour med innovationer og nye teknologier inden for dette område, og efter at have arbejdet med relationelle og NoSQL databaser ser jeg, at grafdatabasers rolle bliver stadig større. Når det gælder arbejde med komplekse hierarkiske data, er både traditionelle databaser og NoSQL ofte ineffektive. Ofte ses en reduktion i ydeevnen, når antallet af niveauer af forbindelser og størrelsen af databasen øges. Jo mere komplekse relationerne bliver, jo flere JOINs er der også.
Selvfølgelig findes der løsninger til at arbejde med hierarkier i den relationelle model (f.eks. ved hjælp af rekursive CTE'er), men det forbliver alternative løsninger. Funktionaliteten i grafdatabaser i SQL Server gør det muligt at håndtere flere niveauer af hierarkier nemt. Både datamodellen og forespørgslerne forenkles, hvilket øger deres effektivitet. Mængden af kode reduceres betydeligt.
Grafdatabaser er et udtryksfuldt sprog til at repræsentere komplekse systemer. Denne teknologi anvendes allerede meget i IT-industrien inden for områder som sociale netværk, anti-fraud systemer, analyse af IT-netværk, sociale anbefalinger, samt produkt- og indholdsrekommandering.
Funktionaliteten i grafdatabaser i SQL Server er passende til scenarier, hvor dataene er stærkt forbundet med hinanden og har klart definerede relationer.
Grafdatamodel
Grafen er en samling af noder (knuder, node) og kanter (relationer, edge). Noderne repræsenterer entiteter, mens kanterne repræsenterer forbindelser, og i attributterne kan der være information.
Grafdatabasen modellerer entiteter i form af en graf, som det er defineret i grafteori. Datastrukturerne er noder og kanter. Attributterne er egenskaberne ved noderne og kanterne. Forbindelsen er en tilslutning af noder.
I modsætning til andre datamodeller prioriterer grafdatabaser relationerne mellem entiteterne. Derfor er der ikke behov for at beregne forbindelser ved hjælp af fremmede nøgler eller andre metoder. Man kan skabe komplekse datamodeller ved kun at bruge abstractionerne af noder og kanter.
I den moderne verden kræver modelleringen af relationer stadig mere komplekse metoder. Til modelleringen af forbindelser tilbyder SQL Server 2017 funktioner fra grafdatabaser. Noder og kanter i grafen fremstilles som nye tabeltyper: NODE og EDGE. En ny T-SQL-funktion kaldet MATCH() bruges til forespørgsler mod grafen. Da denne funktion er integreret i SQL Server 2017, kan den anvendes i dine eksisterende databaser uden behov for nogen konvertering.
Fordele ved grafmodellen
I dag kræver virksomheder og brugere applikationer, der arbejder med stigende datamængder, samtidig med at de forventer høj ydeevne og pålidelighed. At repræsentere data som en graf tilbyder praktiske værktøjer til håndtering af komplekse forbindelser. Denne tilgang kan løse mange problemer og hjælper med at opnå resultater inden for en given kontekst.
Ifølge oplysningerne i fremtiden vil mange applikationer kunne drage fordel af brugen af grafdatabaser.
Datamodelering: fra den relationelle model til grafmodellen
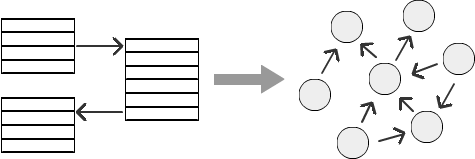
Eksempel
Lad os se på et eksempel på en organisationsstruktur med en hierarki af medarbejdere: en medarbejder rapporterer til en leder, lederen rapporterer til en seniorleder og så videre. Afhængigt af den specifikke virksomhed kan der være et vilkårligt antal niveauer i dette hierarki. Men med stigende antal niveauer bliver beregningen af forbindelser i en relationel database mere og mere kompleks. Det er ret vanskeligt at repræsentere hierarkiet af ansatte, marketinghierarkiet eller forbindelser i sociale netværk. Lad os se, hvordan SQL Graph kan hjælpe med at behandle forskellige niveauer af hierarki.
For dette eksempel vil vi lave en simpel datamodel. Vi opretter en tabel for medarbejdere EMP med en identifikator EMPNO og en kolonne MGR, der angiver identifikatoren for medarbejderens leder. Al information om hierarkiet opbevares i denne tabel og kan forespørges ved hjælp af kolonnerne. EMPNO og MGR.
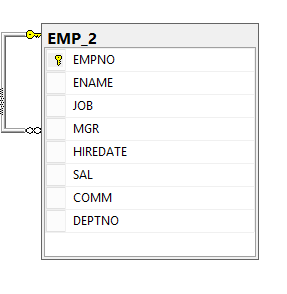
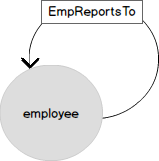
På den følgende diagramillustration ses den samme model af organisationsstrukturen med fire niveauer af indlejring i et mere velkendt format. Medarbejdere er noderne i grafen fra tabellen EMP. Entiteten 'medarbejder' er forbundet med sig selv gennem forbindelsen 'rapporterer til' (ReportsTo). I grafterminologi er forbindelsen en kant (EDGE), der forbinder noder (NODE) af medarbejdere.
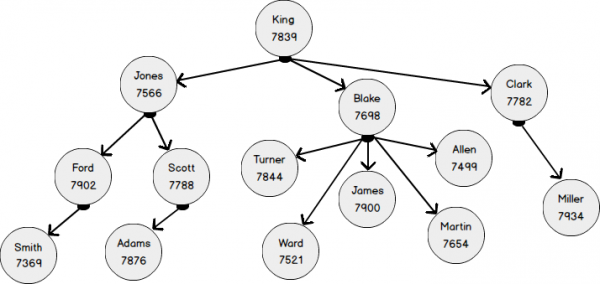
Lad os oprette en almindelig tabel EMP og tilføje værdier i overensstemmelse med ovenstående diagram.
CREATE TABLE EMP
(EMPNO INT NOT NULL,
ENAME VARCHAR(20),
JOB VARCHAR(10),
MGR INT,
JOINDATE DATETIME,
SALARY DECIMAL(7, 2),
COMMISIION DECIMAL(7, 2),
DNO INT)

INSERT INTO EMP VALUES
(7369, 'SMITH', 'CLERK', 7902, '02-MAR-1970', 8000, NULL, 2),
(7499, 'ALLEN', 'SALESMAN', 7698, '20-MAR-1971', 1600, 3000, 3),
(7521, 'WARD', 'SALESMAN', 7698, '07-FEB-1983', 1250, 5000, 3),
(7566, 'JONES', 'MANAGER', 7839, '02-JUN-1961', 2975, 50000, 2),
(7654, 'MARTIN', 'SALESMAN', 7698, '28-FEB-1971', 1250, 14000, 3),
(7698, 'BLAKE', 'MANAGER', 7839, '01-JAN-1988', 2850, 12000, 3),
(7782, 'CLARK', 'MANAGER', 7839, '09-APR-1971', 2450, 13000, 1),
(7788, 'SCOTT', 'ANALYST', 7566, '09-DEC-1982', 3000, 1200, 2),
(7839, 'KING', 'PRESIDENT', NULL, '17-JUL-1971', 5000, 1456, 1),
(7844, 'TURNER', 'SALESMAN', 7698, '08-AUG-1971', 1500, 0, 3),
(7876, 'ADAMS', 'CLERK', 7788, '12-MAR-1973', 1100, 0, 2),
(7900, 'JAMES', 'CLERK', 7698, '03-NOV-1971', 950, 0, 3),
(7902, 'FORD', 'ANALYST', 7566, '04-MAR-1961', 3000, 0, 2),
(7934, 'MILLER', 'CLERK', 7782, '21-JAN-1972', 1300, 0, 1)
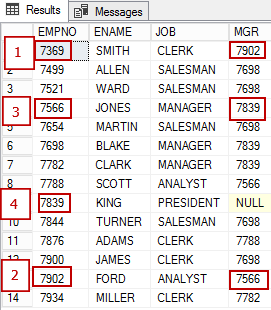
På det følgende billede ses medarbejderne:
- medarbejderen med EMPNO 7369 rapporterer til 7902;
- medarbejderen med EMPNO 7902 rapporterer til 7566
- medarbejderen med EMPNO 7566 rapporterer til 7839
Lad os nu se på repræsentationen af de samme data i form af en graf. Noden EMPLOYEE har flere attributter og er forbundet med sig selv gennem en relation "rapporterer til" (EmplReportsTo). EmplReportsTo er navnet på relationen.
I kant-tabellen (EDGE) kan der også være attributter.
Lad os oprette en node-tabel EmpNode
Syntaksen til oprettelse af en node er ganske enkel: til udtrykket CREATE TABLE tilføjes "AS NODE".
CREATE TABLE dbo.EmpNode(
ID Int Identity(1,1),
EMPNO NUMERIC(4) NOT NULL,
ENAME VARCHAR(10),
MGR NUMERIC(4),
DNO INT
) AS NODE;
Lad os nu konvertere data fra den almindelige tabel til grafen. Den følgende INSERT indsætter data fra den relationelle tabel EMP.
INSERT INTO EmpNode(EMPNO,ENAME,MGR,DNO) select empno,ename,MGR,dno from emp 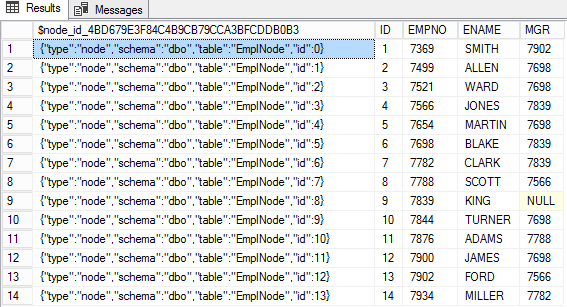
I node-tabellen opbevares identifikatoren for noden i form af JSON i en særlig kolonne $node_id_* de øvrige kolonner i denne tabel indeholder nodens attributter.
Opretter kanter (EDGE)
At oprette en kant-tabel ligner meget at oprette en node-tabel, undtagen at det bruges nøgleordet "AS EDGE".
CREATE TABLE empReportsTo(Deptno int) AS EDGE 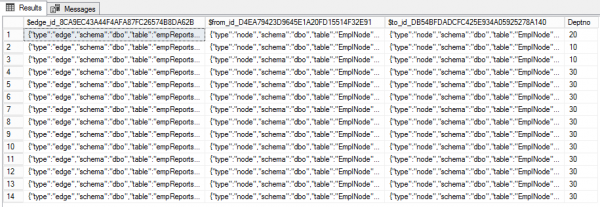
Lad os nu definere relationerne mellem medarbejderne ved hjælp af kolonnerne EMPNO og MGR. I organisationsdiagrammet kan man tydeligt se, hvordan man skriver INSERT.
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 1),
   	(SELECT $node_id FROM EmpNode WHERE id = 13),20);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 2),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),10);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 3),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),10);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 4),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 5),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 6),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 7),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 8),
   	(SELECT $node_id FROM EmpNode WHERE id = 4),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 9),
   	(SELECT $node_id FROM EmpNode WHERE id = 9),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 10),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 11),
   	(SELECT $node_id FROM EmpNode WHERE id = 8),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 12),
   	(SELECT $node_id FROM EmpNode WHERE id = 6),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 13),
   	(SELECT $node_id FROM EmpNode WHERE id = 4),30);
INSERT INTO empReportsTo VALUES ((SELECT $node_id FROM EmpNode WHERE ID = 14),
   	(SELECT $node_id FROM EmpNode WHERE id = 7),30);
Standardkanten-tabellen består af tre kolonner. Den første, $edge_id — identifikator for kanten i JSON-format. De to andre ($from_id og $to_id) repræsenterer forbindelsen mellem noderne. Derudover kan kanter have ekstra egenskaber. I vores tilfælde er det Deptno.
Systemvisninger
I systemvisningen sys.tables er der tilføjet to nye kolonner:
- is_edge
- is_node
SELECT t.is_edge,t.is_node,*
FROM sys.tables t
WHERE name like 'emp%' 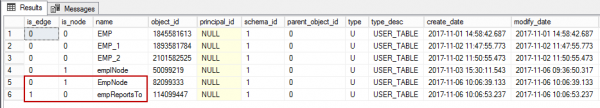
SSMS
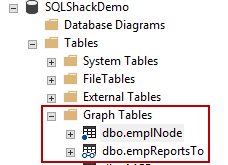
Objekter relateret til grafen findes i mappen Graf-tabeller. Ikonet for nodetabellen er markeret med et punkt, mens kanttabellerne er markeret med to forbundne cirkler (som minder lidt om briller).
MATCH-udtrykket
Udsagn MATCH stammer fra CQL (Cypher Query Language). Det er en effektiv måde at forespørge på grafens egenskaber. CQL begynder med udtrykket MATCH.
Syntaks
MATCH (<graph_search_pattern>)

<graph_search_pattern>::=
    {<node_alias> {
                 	{ <-( <edge_alias> )- }
               	| { -( <edge_alias> )-> }
             	<node_alias>
             	}
 	}
 	[ { AND } { ( <graph_search_pattern> ) } ]
 	[ ,...n ]

<node_alias>::=
    node_table_name | node_alias

<edge_alias>::=
    edge_table_name | edge_alias
Eksempler
Lad os se på nogle eksempler.
Den følgende forespørgsel viser medarbejdere, der rapporterer til Smith samt hans leder.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR
FROM
    empnode e, empnode e1, empReportsTo m
WHERE
    MATCH(e-(m)->e1)
and e.ENAME='SMITH' 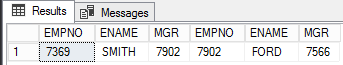
Den følgende forespørgsel er beregnet til at finde medarbejdere og mellemledere på andet niveau for Smith. Hvis vi fjerner sætningen, HVOR, vil alle medarbejdere blive vist som resultat.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2
WHERE
    MATCH(e-(m)->e1-(m1)->e2)
and e.ENAME='SMITH' 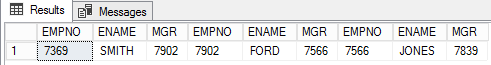
Og endelig forespørgslen for medarbejdere og mellemledere på tredje niveau.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
    MATCH(e-(m)->e1-(m1)->e2-(m2)->e3)
and e.ENAME='SMITH' 
Lad os nu ændre retningen for at få Smiths chefer.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
MATCH(e<-(m)-e1<-(m1)-e2<-(m2)-e3) 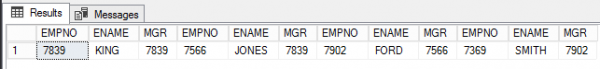
Konklusion
SQL Server 2017 har etableret sig som en komplet virksomheds løsning til forskellige IT-opgaver i erhvervslivet. Den første version af SQL Graph er meget lovende. Selvom der er visse begrænsninger, er der allerede nu tilstrækkelig funktionalitet til at udforske grafmulighederne.
Funktionaliteten i SQL Graph er helt integreret i SQL Engine. Men som nævnt er der følgende begrænsninger i SQL Server 2017:
Ingen støtte til polymorfi.
- Kun envejsforbindelser understøttes.
- Det er ikke muligt at opdatere kolonnerne $from_id og $to_id på kanterne via UPDATE.
- Transitive lukninger understøttes ikke, men de kan opnås via CTE.
- Understøttelsen af In-Memory OLTP-objekter er begrænset.
- Temporale tabeller (System-Versioned Temporal Table), temporære lokale og globale tabeller understøttes ikke.
- Tabeltyper og tabelvariabler kan ikke defineres som NODE eller EDGE.
- Forespørgsler mellem databaser (cross-database queries) understøttes ikke.
- Der er ingen direkte måde eller nogen wizard til at konvertere almindelige tabeller til grafer.
- Der er ingen GUI til at visualisere grafer, men Power BI kan bruges.
Læs mere:
Kilde: habr.com
