

Hej, først lidt lyrik. Jeg misundrer nogle gange mine kolleger, der arbejder remote - det må være fantastisk at kunne arbejde fra enhver del af verden, der er tilsluttet internettet, tage ferie når som helst, have ansvar for projekter og deadlines i stedet for at sidde på kontoret fra 8 til 17. Min stilling og mine arbejdsopgaver udelukker praktisk talt muligheden for langvarigt fravær fra datacentret. Men lejlighedsvis opstår der interessante sager, som den der er beskrevet nedenfor - og jeg forstår, at der er få stillinger, der giver så meget plads til kreativt udtryk for den indre troubleshooter.
En lille disclaimer - på tidspunktet for denne artikel er sagen ikke helt løst, men i betragtning af hastigheden på leverandørernes svar kan en fuld løsning tage flere måneder, og jeg vil gerne dele mine fund nu. Jeg håber, kære læsere, I tilgiver mig denne hast.
Først en introduktion: Der er et firma (hvor jeg arbejder som netværksingeniør), der hoster kundeløsninger i den private VMWare-cloud. De fleste nye løsninger tilsluttes VXLAN-segmenter, der administreres af NSX-V - jeg vil ikke vurdere, hvor meget tid dette har givet mig, men kort sagt - meget. Jeg har endda formået at uddanne kolleger i opsætning af NSX ESG, og små kundeløsninger implementeres uden min deltagelse. Vigtig bemærkning - kontrolplanet har vi med unicast-replikation. Hypervisorerne er forbundet redundat med to interfaces til forskellige fysiske Juniper QFX5100-switches (samlet i Virtual Chassis) og politik for timingen baseret på den oprindelige virtuelle port - dette er for at give et klart billede.
Kundeløsningerne er meget forskellige: fra Windows IIS, hvor alle komponenter i webserveren er installeret på én maskine, til ret store - for eksempel load-balanced Apache web-frontend + LB MariaDB i Galera + delte servere synkroniseret med GlusterFS. Praktisk taget hver server skal overvåges separat, og ikke alle komponenter har offentlige adresser - hvis du har stødt på denne udfordring og har en mere elegant løsning, ville jeg være glad for et råd.
Min løsning til overvågning består i at "tilslutte" firewallen (Fortigate) til hvert internt kundenetværk (+SNAT og selvfølgelig strenge begrænsninger på typen af tilladt trafik) og overvåge de interne adresser - på den måde opnås en form for ensartethed og forenkling af overvågningen. Selve overvågningen foregår fra et klyngeservermiljø med PRTG. Overvågningsskemaet er omtrent sådan her:
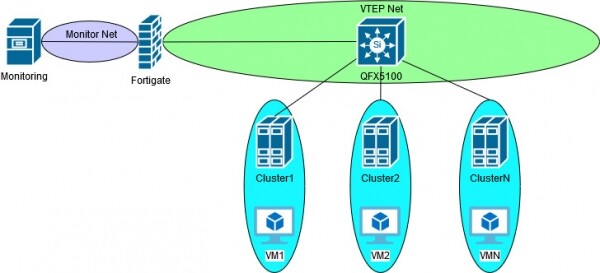
Indtil vi kun arbejdede med VLAN, fungerede alt meget almindeligt og forudsigeligt, som en klokke. Efter implementeringen af NSX-V og VXLAN stødte vi på spørgsmålet - kan vi fortsætte med at overvåge på den gamle måde? På tidspunktet for dette spørgsmål var den "hurtigste" løsning at implementere NSX ESG og tilslutte VXLAN trunk-interface til VTEP-netværket. Hurtig i citationstegn - da brugen af GUI til opsætning af kundenet, SNAT og firewallregler muligvis ensarterer styringen i et enkelt interface i vSphere, men efter min mening er det ret besværligt og begrænser desuden værktøjssættet til fejlfinding. De, der har brugt NSX ESG som en erstatning for en "rigtig" firewall, vil nok være enige. Selvom dette valg sikkert ville have været mere stabilt - for det hele foregår inden for en enkelt leverandør.
En anden løsning er at bruge NSX DLR i brotilstand mellem VLAN og VXLAN. Her tænker jeg, at alt er klart - man mister simpelthen fordelene ved at anvende VXLAN, da man alligevel skal trække VLAN til overvågningsinstallationen. For resten stødte jeg i processen med at implementere denne løsning på et problem, hvor DLR-broen ikke sendte pakker til den virtuelle maskine, den var på samme vært som. Jeg ved, jeg ved - i bøger og guider om NSX-V står der klart, at der skal tildeles en separat klynge til NSX Edge, men det er i bøgerne... Under alle omstændigheder, efter et par måneder med supporten fandt vi ikke en løsning. I princippet forstod jeg logikken bag – kerne-modulet i hypervisoren, der er ansvarligt for VXLAN-enkapsulering, blev ikke aktiveret, hvis DLR og den overvågede server var på samme vært, da trafikken ikke forlader værten og logisk set burde være tilsluttet til VXLAN-segmentet - enkapsulering er ikke nødvendig. Med supporten stoppede vi ved den virtuelle interface vdrPort, som logisk forbinder uplinks, og som også udfører bro-enkapsuleringen - dér blev der observeret en uoverensstemmelse i den indgående trafik, som jeg tog med i den nuværende sag. Men som nævnt, færdiggjorde jeg ikke denne sag, da jeg blev omplaceret til et andet projekt, og den bane var oprindeligt en blind vej, så jeg havde ikke rigtig lyst til at udvikle den. Hvis jeg ikke tager fejl, blev problemet observeret i versionerne NSX 6.1.4 og 6.2.
Og her - bingo! Fortinet annoncerer indførelse af . Og ikke bare point-to-point eller VXLAN-over-IPSec, ikke softwarebro VPS-VXLAN - alt dette begyndte de at implementere allerede fra version 5.4 (og er også præsenteret hos andre ), og den faktiske support til unicast control plane. Da jeg implementerede løsningen, stødte jeg på endnu et problem - de overvågede servere
Efter at have kørt testtrafik med succes, blev det besluttet at implementere denne løsning. Og i produktionen fandt vi ud af, at efter et par dage begyndte alt overvåget over VXLAN gradvist at falde ud. Deaktivering/aktivering af interfacet hjalp, men kun midlertidigt. I lyset af producentens langsommelige support begyndte jeg at fejlsøge på min side - trods alt er mit netværk og min virksomhed mit ansvar.
Under spoileren er min fejlsøgningsproces. Hvis du er træt af bogstaver og praleri - spring over og gå videre til efteranalysen.
Forløb af fejlsøgningTak fordi du fortsatte med at læse - lad os fortsætte!
Så, overvågningen fungerer et stykke tid, så falder den ud af sig selv. Det betyder, at der sandsynligvis ikke er nogen problemer i firewall-politikkerne. Men da jeg har stødt på problemer med hængende systemprocesser i Fortigate versioner 5.6+, skal vi først kigge på "diagnose debug flow" - som forventet tillades trafikken og forlader interfacet, og som forventet kommer der intet svar. Så vi graver videre i stakken. Jeg bliver desværre nødt til at skjule adresser, selvom de er RFC1918, men jeg håber at give processen en tilstrækkelig beskrivelse til forståelse. Serveren inde i VXLAN har adressen x.x.x.15, Fortigate-interfacet har adressen x.x.x.254, og alle andre adresser tilhører VTEP-netværket.
For successful transmission of VXLAN encapsulated packets, correct information is required in several tables. For overlay, this is ARP and OVSDB; for underlay, it's ARP and CAM. In the case of Fortigate, VXLAN FDB is the OVSDB. Let's start there:
 fortigate (root) #diag sys vxlan fdb list vxlan-LS
mac=00:50:56:8f:3f:5a state=0x0002 flags=0x00 remote_ip=у.у.у.47 port=4789 vni=5008 ifindex=7
Everything here is quite simple — the MAC address of the virtual machine must be located on the VTEP with the address у.у.у.47. Looking at the contents and settings of the ESXi cluster, I find that the MAC of the virtual machine is correct, and so is the VTEP address. I check the CAM/ARP table on the Fortigate — again, everything matches the settings of the ESXi host:
fortigate (root) #get sys arp | grep у.у.у.47
у.у.у.47 0 00:50:56:65:f6:2c dmz
The tables are correct and traffic is leaving — maybe the problem isn’t with Fortigate? I intentionally skipped the traffic switching analysis on Juniper — logically, this should be where the next step of troubleshooting is conducted, but my network is simple — just one VLAN for the VTEP and all components are directly connected. Plus, I recall a case with the DLR bridge, VDR, and disappearing traffic — I go to sniff on the ESXi host, and at the same time I create a case for VMware. Below, the MAC "97:6e" belongs to Fortigate, vmnic1 — is the interface that has a VTEP with the address у.у.у.47, I will sniff in both directions "—dir 2":
pktcap-uw --uplink vmnic1 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
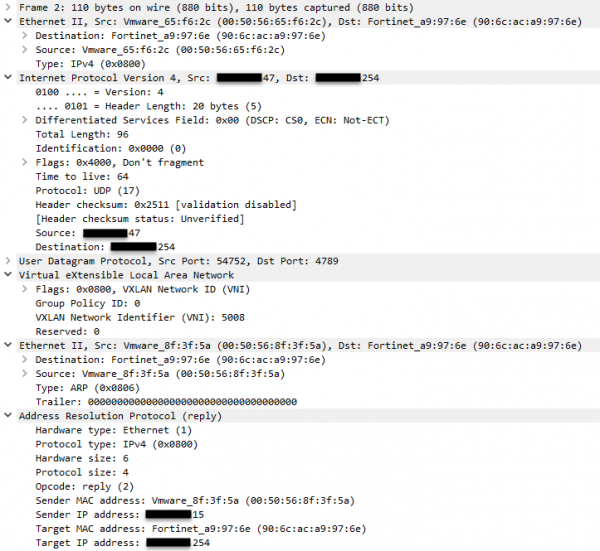
Progress — in the sniff, I see an ARP request and the incoming response. I only show the ARP response, and everything there is correct. I didn't mention, but all this time, the monitoring server is pinging the address х.х.х.15 — where is the ICMP traffic? I recall that I have two uplinks. One might argue that the source virtual port is the same (my teaming policy), meaning that for the same vNIC, one and the same uplink should be selected, but since I'm at the host, checking the other uplink is no problem:
pktcap-uw --uplink vmnic4 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
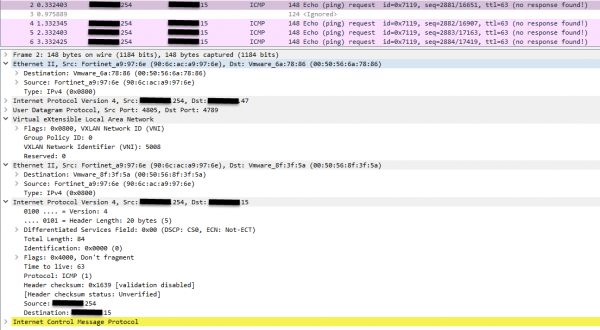
Forespørgsler kommer fra Fortigate, men der er ingen svar. Det vil sige, problemet ligger ikke hos Fortigate. Nå, tænker jeg, igen det samme problem med forsvindende trafik på VDR, igen et par måneder for at få sagen i den rette retning. Efter et par dage, efter at jeg kølet ned, og ikke ville acceptere dødtid, besluttede jeg mig for at finde nogle flere sniffere til supporten for at fremskynde processen. Og her falder mit blik "tilfældigvis" på Ethernet-inkapslingen underlay. Kongen er ikke ægte, og MAC-adressen for VTEP stemmer ikke overens med dens IP. Jeg nulstiller, sniffer, graver – korrekt, hvad der ikke er korrekt. Jeg vil føre ARP-tabellen ved siden af, så det er nemmere at sammenligne. Bemærk den første Ethernet-inkapsling på billedet ovenfor:
fortigate (root) #get sys arp | grep u.u.u.47
u.u.u.47 0 00:50:56:65:f6:2c dmz
fortigate (root) #get sys arp | grep u.u.u.42
u.u.u.42 0 00:50:56:6a:78:86 dmz
Så hvad har vi i sidste ende – efter migreringen af den virtuelle maskine, forsøger Fortigate at sende trafik til VTEP fra (korrekt) VXLAN FDB, men bruger den forkerte DST MAC, og trafikken bliver selvfølgelig afvist af den interface, der modtager den. I én ud af fire tilfælde tilhørte denne MAC den oprindelige hypervisor, som vi startede migreringen af maskinen fra.
I går modtog jeg en e-mail fra Fortinets support – der blev åbnet en fejl 615586 i min sag. Jeg ved ikke helt, om jeg skal være glad eller trist: på den ene side er problemet ikke i indstillingerne, på den anden side kommer fixet kun med en firmwareopdatering, i bedste fald i den næste. Mine fornemmelser forstærkes også af en anden fejl, som jeg opdagede i sidste måned, dog denne gang i HTML5 GUI vSphere. Det føles som et lokalt QA-team for leverandører...
Jeg tager chancen for at antage følgende:
1 — multicast kontrolplanen vil sandsynligvis ikke være udsat for det beskrevne problem — for MAC-adresserne for VTEP udledes fra IP-adressen for den gruppe, som interfacet abonnerer på.
2 — problemet med Fortigate ligger sandsynligvis i offloadingen af sessioner til Network Processor (tilnærmelsesvis svarende til CEF) — hvis hver pakke sendes gennem CPU'en, vil der blive brugt tabeller med de korrekte — i det mindste visuelt — oplysninger. Til støtte for denne antagelse går der, at det hjælper at lukke/åbne interfacet eller vente et stykke tid — mere end 5 minutter.
3 — ændring af teaming-politik, for eksempel til explicit failover, eller implementering af LAG vil ikke løse problemet, da der er observeret "fastlåsning" af MAC-adressen for den oprindelige hypervisor i inkapslede pakker.
I lyset af dette kan jeg dele, at jeg for nylig har opdaget , hvor det i en af artiklerne blev hævdet, at stateful firewalls og cachebare metoder til dataoverførsel er nødforanstaltninger. Nå, jeg er ikke så erfaren inden for IT til at påstå sådanne ting, og jeg er heller ikke altid enig med alle udsagn i blogartikler. Men noget fortæller mig, at der er en del sandhed i Ivans ord.
Tak for din opmærksomhed! Jeg vil være glad for at besvare spørgsmål og høre konstruktiv kritik.
Kilde: habr.com
