

Hej alle. Nedenfor er der en transskription .
– et system til overvågning af forskellige systemer og tjenester, som systemadministratorer kan bruge til at indsamle information om aktuelle systemparametre og konfigurere varsler til at modtage meddelelser om afvigelser i systemernes drift.
I præsentationen vil der være en sammenligning og – projekter til langtidsopbevaring af målinger fra Prometheus.
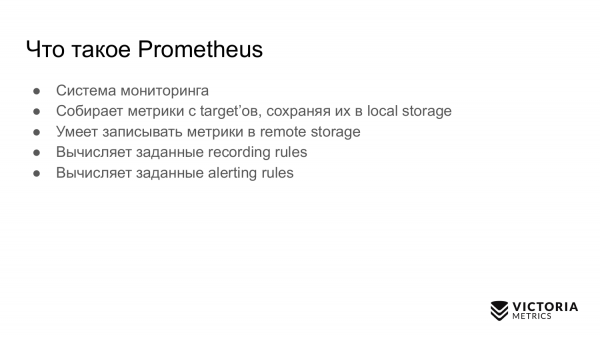
Først vil jeg fortælle om Prometheus. Det er et overvågningssystem, der indsamler målinger fra angivne mål og gemmer dem i lokal lagring. Prometheus kan gemme målinger i ekstern lagring, generere alarmer og optage regler.
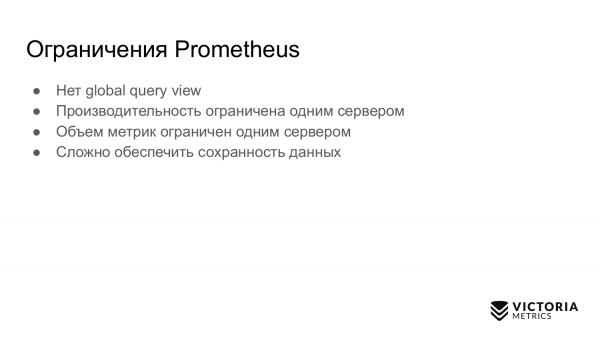
Begrænsninger ved Prometheus:
- Det har ikke global forespørgselsvisning. Det er, når du har flere uafhængige instanser af Prometheus. De indsamler målinger. Og du ønsker at lave en forespørgsel over alle disse målinger, indsamlet fra forskellige instanser af Prometheus. Det tillader Prometheus ikke.
- Prometheus' ydeevne er begrænset til kun én server. Prometheus kan ikke automatisk skaleres til flere servere. Du kan kun manuelt opdele dine mål mellem flere Prometheus-instanser.
- Mængden af målinger i Prometheus er kun begrænset til én server af den samme grund, som den ikke kan skaleres automatisk til flere servere.
- Det er ikke så let at organisere databeskyttelse i Prometheus.
Løsninger på disse problemer/opgaver?
Løsningerne er:
Alle disse løsninger er til ekstern lagring af data indsamlet af Prometheus. De løser problemet med ekstern lagring fra den tidligere slide på forskellige måder. I denne præsentation vil jeg kun tale om de første to løsninger: og .
Informationen om dette er første gang blev præsenteret i . Her beskrives arkitekturen og hvordan det fungerer.
Thanos tager data, som Prometheus har gemt på sin lokale disk, og kopierer dem til S3, til eller en anden objektlagring.
På den måde giver Thanos global forespørgselsvisning. Du kan anmode om data gemt i objektlagringen fra flere instanser af Prometheus.
Thanos understøtter PromQL og .
Thanos bruger Prometheus' kode til datalagring.
Thanos udvikles af de samme udviklere, der har lavet Prometheus.
Om . Her er , hvor vi første gang fortalte om .
VictoriaMetrics indsamler data fra flere Prometheus ved hjælp af protokollen, der understøttes af Prometheus.
VictoriaMetrics giver en global forespørgselsvisning, da flere instanser af Prometheus kan skrive data til én VictoriaMetrics. Derfor kan du foretage forespørgsler baseret på alle disse data.

VictoriaMetrics understøtter ligesom Thanos — PromQL og Prometheus forespørgsels-API.
I modsætning til Thanos er kildeteksten til VictoriaMetrics skrevet fra bunden og optimeret med henblik på hastighed og ressourcetræk.
VictoriaMetrics kan, i modsætning til Thanos, skalere både vertikalt og horisontalt. Der er , som skalerer vertikalt. Du kan starte med én processor og 1 GB hukommelse og gradvist vokse til hundrede processorer og 1 TB hukommelse. VictoriaMetrics kan udnytte alle disse ressourcer. Dens ydeevne vil stige med cirka 100 gange sammenlignet med et system med én kerne.
Historien om Thanos begyndte i november 2017, da den første offentlige commit blev lavet. Før dette blev Thanos udviklet internt i virksomheden .
I juni 2019 var der en bemærkelsesværdig udgivelse 0.5.0, hvori protokol. Den blev fjernet fra Thanos, fordi den ikke præsterede særlig godt. Ofte fungerede Thanos-klyngen ikke korrekt, og noder blev forkert tilsluttet på grund af gossip-protokollen. Derfor besluttede vi at fjerne den. Jeg mener, det var den rigtige beslutning.
I samme juni 2019 indsendte de ansøgning nummer i .
Og et par måneder senere blev Thanos accepteret i , som inkluderer Prometheus, Kubernetes og andre populære projekter.
I januar 2018 begyndte udviklingen af VictoriaMetrics.
I september 2018 nævnte jeg første gang offentligt VictoriaMetrics.
I december 2018 blev den enkelt-node-version offentliggjort.
I maj 2019 både kildekoden til enkelt-node- og klyngeversionen.
I juni 2019, ligesom Thanos, indsendte vi en ansøgning til CNCF-fundamentet under nummer . Vi indsende ansøgningen en dag før Thanos.
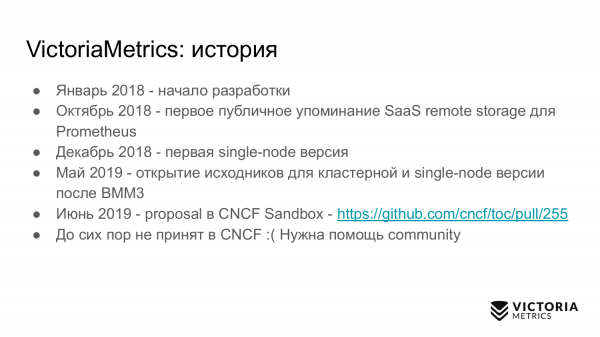
Men desværre er vi stadig ikke blevet accepteret der. Vi har brug for hjælp fra fællesskabet.
Lad os se på de vigtigste slides, der viser arkitekturen af Thanos og VictoriaMetrics.
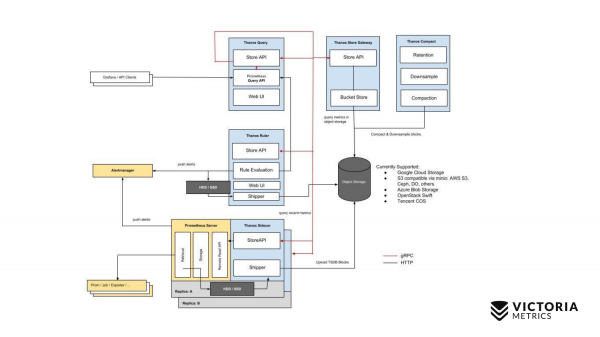
Lad os starte med Thanos. De gule komponenter er komponenter fra Prometheus. Alt andet er komponenter fra Thanos. Lad os starte med den vigtigste komponent. Thanos Sidecar — det er en komponent, der installeres ved siden af hver Prometheus. Den håndterer at uploade Prometheus-data fra lokal lagring til S3 eller en anden objektlagring.
Der er også en komponent kaldet Thanos Store Gateway, som kan læse disse data fra Object Storage ved indkommende anmodninger fra Thanos Query. Thanos Query implementerer PromQL og Prometheus API. Udefra ser det ud som Prometheus. Den modtager PromQL-anmodninger, sender dem til Thanos Store Gateway, som henter de nødvendige data fra Object Storage og sender dem tilbage.
Men vi har data i Object Storage uden de sidste to timer på grund af egenskaber ved implementeringen af Thanos Sidecar, som ikke kan uploade de sidste to timer til Object Storage S3, da Prometheus ikke har oprettet filer i det lokale lager for disse to timer.
Hvordan fik de løst dette? Thanos Query sender, udover anmodningerne til Thanos Store Gateway, samtidig anmodninger til hver Thanos Sidecar, der ligger tæt på Prometheus.
Og Thanos Sidecar, på sin side, proxyer anmodningerne videre til Prometheus og henter data for de sidste to timer.
Udover disse komponenter er der også en valgfri komponent, som er nødvendig for at Thanos kan fungere ordentligt. Det er Thanos Compact, som fusionerer små filer på Object Storage til større filer, der er blevet uploadet her af Thanos Sidecars. Thanos Sidecar uploader filer med data for to timer. Hvis disse filer ikke bliver slået sammen til større filer, kan antallet stige væsentligt. Jo flere sådanne filer, jo mere hukommelse kræves der for Thanos Store Gateway, og jo mere ressourcer kræves der til datatransmission og metadata. Thanos Store Gateways funktionalitet bliver ineffektiv. Derfor skal Thanos Compact nødvendigvis køres for at fusionere små filer til større for at reducere antallet af filer og mindske overheaden på Thanos Store Gateway.
Der er også en komponent kaldet Thanos Ruler. Den udfører Prometheus-alarmregler og kan beregne Prometheus-optegningsregler for at gemme data tilbage i Object Storage. Men denne komponent anbefales ikke at bruge, da den .
Sådan er den enkle struktur af Thanos.
Lad os nu sammenligne med strukturen af VictoriaMetrics.
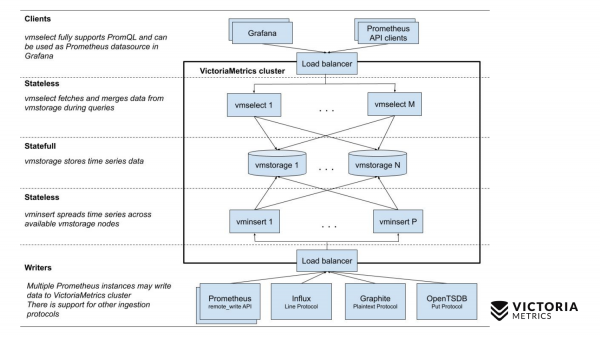
VictoriaMetrics leveres i 2 versioner: Single-node og en klyngeversion. Single-node kører på én computer. I Single-node er disse komponenter ikke til stede, der er blot en binær fil. Denne binære fil vises på lysbilledet som denne firkant. Alt inden for firkanten er indholdet af den binære fil til Single-node-versionen. Du behøver ikke at vide meget om det. Bare start binæren — og så fungerer det hele.
Den klusterbaserede version er mere kompleks. Den indeholder tre forskellige komponenter: vmselect, vminsert og vmstorage. Deres navne bør give en indikation af, hvad hver enkelt gør. Insert-komponenten modtager data i forskellige formater: fra Prometheus remote write API, Influx line-protokollen, Graphite-protokollen og fra OpenTSDB-protokollen. Insert-komponenten modtager dem, parser dem og fordeler dem mellem de eksisterende storage-komponenter, hvor dataene derefter gemmes. , samt Prometheus forespørgsels-API, og den kan bruges som en erstatning for Prometheus i Grafana eller andre Prometheus API-klienter. Select-modulet modtager promql-forespørgsler, parser dem, læser de nødvendige data for at udføre denne forespørgsel fra storage-noderne, bearbejder disse data og returnerer et svar.
Lad os sammenligne kompleksiteten ved installation af Thanos og VictoriaMetrics.
Vi starter med Thanos. Før du begynder at arbejde med Thanos, skal du oprette en bucket i Object Storage, såsom S3 eller GCS, så Thanos Sidecar kan skrive data til denne.
Derefter skal du installere Thanos Sidecar for hver Prometheus. Før dette skal du huske at deaktivere data compaction i Prometheus. Data compaction komprimerer periodisk data i Prometheus' lokale lager for at reducere ressourceforbruget.
Når du installerer Thanos Sidecar til dine Prometheus'er, skal du deaktivere denne data compaction, fordi Thanos Sidecar ikke fungerer korrekt med aktiveret data compaction. Dette betyder, at din Prometheus begynder at gemme data i blokke hver anden time og stopper med at sammenflette disse blokke til større. Derfor, hvis du udfører forespørgsler, der overstiger varigheden af de seneste to timer, vil de ikke fungere så effektivt som de kunne, hvis data compaction var aktiveret.
Derfor anbefaler Thanos at reducere opbevaringstiden for data i det lokale lager til 6-8 timer for at mindske denne overhead fra mange små blokke.
Efter at du har installeret Thanos Sidecar, skal du installere to komponenter for hver Object Storage Bucket. Disse er Thanos Compactor og Thanos Store Gateway.
Derefter skal du installere Thanos Query og konfigurere det, så det kan forbinde til alle de Thanos Store Gateways, du har, samt til alle de Thanos Sidecars.
Her kan der være et lille problem.
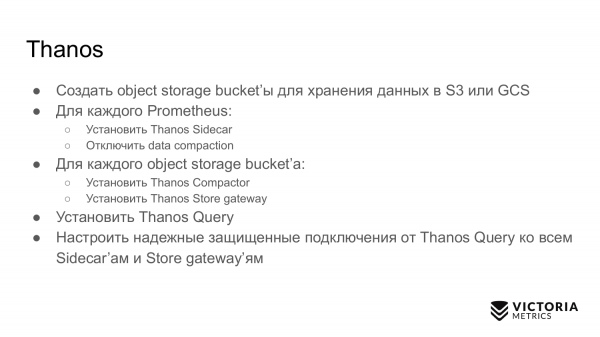
Du skal konfigurere en pålidelig og sikker forbindelse fra Thanos Query til disse komponenter. Og hvis jeres Prometheus’er befinder sig i forskellige datacentre eller i forskellige VPC'er, så er forbindelser udefra forbudte. Men for at få Thanos Query til at fungere, skal du finde en måde at konfigurere forbindelsen til disse på.
Hvis du har mange sådanne datacentre, falder systemets samlede pålidelighed. Da Thanos Query konstant skal holde forbindelser til alle Thanos Sidecar, der er placeret i forskellige datacentre. Ved hver indkommende anmodning vil det sende anmodninger til alle Thanos Sidecar. Hvis forbindelsen brydes, vil du enten få et ufuldstændigt datasæt eller et svar som "klusteret fungerer ikke".
I VictoriaMetrics er alt lidt enklere. For Single-node versionen er det tilstrækkeligt blot at starte en binærfil, og så fungerer alt.
I cluster-versionen er det tilstrækkeligt at starte alle de tre ovennævnte typer komponenter i det nødvendige antal, eller bruge til at automatisere opstarten af komponenterne i Kubernetes. Vi planlægger også at lave en Kubernetes-operator. Helm-chartet dækker ikke alle scenarier og kan føre til, at du skyder dig selv i foden. For eksempel tillader det at reducere antallet af storage nodes, hvilket vil resultere i datatab.
Efter at have startet en binærfil eller cluster-versionen, skal du blot tilføje i Prometheus' konfiguration , så den begynder at skrive data parallelt til lokal storage og remote storage. Som du har bemærket, bør denne konfiguration være meget mere pålidelig sammenlignet med Thanos-konfigurationen. Vi behøver ikke at holde forbindelse fra VictoriaMetrics til alle Prometheus’er, fordi Prometheus’erne selv opretter forbindelse til VictoriaMetrics og sender data.
Lad os se på vedligeholdelsen af Thanos og VictoriaMetrics.
Thanos skal holde øje med Sidecar for at sikre, at de ikke stopper med at overføre data til Object Storage. De kan stoppe denne dataoverførsel som følge af uploadfejl, f.eks. hvis din netværksforbindelse til Object Storage midlertidigt er afbrudt, eller hvis Object Storage midlertidigt er utilgængeligt. Thanos Sidecar vil på dette tidspunkt opdage dette, rapportere en fejl, muligvis gå ned og derefter stoppe med at fungere. Hvis du ikke overvåger det, vil der ikke overføres data til Object Storage. Hvis retention-tiden går (6-8 timer anbefalet), vil du miste data, der ikke er sendt til Object Storage.
Thanos compactorer kan stoppe med at fungere på grund af . Compactorer henter data fra Object Storage og samler dem i større datablokke. Da compactorer ikke er synkroniseret med Sidecar’erne, kan der ske følgende: Sidecar har endnu ikke skrevet blokken færdig, Compactor beslutter, at denne blok er helt skrevet. Compactor begynder at læse den. Den læser blokken ikke i fuld størrelse og stopper med at fungere. Se detaljer. .
Store Gateway kan returnere inkonsistente data på grund af race-tilstande mellem Compactoren og Sidecar’ene. Det er det samme problem, fordi Store Gateway ikke er synkroniseret med Compactorer og Sidecar’er. Følgelig kan der opstå race-tilstand, hvor Store Gateway ikke ser en del af dataene, eller ser ekstra data.
Spørgsmålskomponenten i Thanos returnerer som standard et delvist resultat, hvis nogle Sidecar’er eller Store Gateway ikke er tilgængelige på det tidspunkt. Du vil modtage en del af dataene og vil ikke engang vide, at du ikke har fået alle dataene. Det er, hvordan det fungerer som standard. I en lignende situation returnerer VictoriaMetrics markerede data som delvise.
I modsætning til Thanos taber VictoriaMetrics sjældent data. Selv hvis forbindelsen fra Prometheus til VictoriaMetrics er afbrudt, er det ikke et problem, da Prometheus fortsætter med at skrive de nye data, der kommer ind i Write Ahead Log, hvis størrelse svarer til 2 timer. Hvis du genopretter forbindelsen til VictoriaMetrics inden for to timer, vil dataene ikke gå tabt. Prometheus .
I modsætning til Thanos, som kun skriver data til object storage efter to timer, replikerer Prometheus automatisk data via remote write protokollen til remote storage, såsom VictoriaMetrics. Du behøver ikke bekymre dig om at miste local storage i Prometheus. Hvis den pludselig mister local storage, vil du i værste fald kun miste de sidste sekunder af data, der ikke blev skrevet til remote storage.
Kubernetes styrer automatisk klyngen i modsætning til Thanos. Alle Thanos-komponenter er svære at placere i én Kubernetes-klynge, i modsætning til de klyngekomponenter, der findes i VictoriaMetrics.
VictoriaMetrics har en meget simpel opgradering til en ny version. Du stopper bare VictoriaMetrics, opdaterer binærfilerne og starter den igen. Ved stop gennem SIGINT signalet sørger alle VictoriaMetrics binærfiler for en glidende nedlukning. De gemmer de nødvendige data korrekt og lukker indkommende forbindelser, så intet går tabt. Så du vil ikke miste noget ved opgraderingen.
Det er meget nemt at udvide klyngen i VictoriaMetrics. Du tilføjer blot de nødvendige komponenter og fortsætter arbejdet.
Om faldgruberne i Thanos og VictoriaMetrics.
Thanos har følgende faldgruber. Prometheus skal opbevare data i de seneste to timer. Hvis de går tabt, mister du dem helt, da de endnu ikke er blevet skrevet til Object Storage, såsom S3.
Store Gateway-komponenten og compactoren kan kræve meget hukommelse for at arbejde med stor Object Storage, hvis der gemmes mange små filer. Jo større antal og volumen af filer, jo mere RAM kræves der af Store Gateway og compactoren for at opbevare metadata. Thanos har mange problemer angående det, .
Thanos reklamerer med, at det kan skaleres uendeligt for antallet af dine Prometheus. I virkeligheden er det ikke sandt. Da alle forespørgsler går gennem Query-komponenten, der skal parallelt spørge alle Store Gateway-komponenter og alle Sidecar-komponenter, trække data derfra og derefter forbehandle dem. Det er åbenlyst, at forespørgsels hastighed er begrænset af det langsomste svage led, den langsomste Store Gateway eller den langsomste Sidecar.
Disse komponenter kan være ujævnt belastet. For eksempel har du Prometheus, der indsamler millioner af målinger i sekundet. Og der er en Prometheus, hvor der indsamles tusind målinger i sekundet. Prometheus, som indsamler millioner af målinger i sekundet, belaster serveren, som den kører på, meget mere. Følgelig arbejder Sidecar langsommere der. Og generelt fungerer alt langsommere der. Og Query-komponenten vil trække data derfra meget langsomt. Derfor vil ydeevnen for hele din klynge være begrænset af denne langsomme Sidecar.
Som standard giver Thanos delvise data, hvis nogle Sidecar'er eller Store Gateway ikke er tilgængelige. For eksempel, hvis du har Sidecar'er spredt over hele verden i forskellige datacentre, så stiger sandsynligheden for forbindelsesbrud og utilgængelighed af komponenter betydeligt. Følgelig vil du i de fleste tilfælde modtage delvise data, selv uden at vide det.
VictoriaMetrics har også faldgruber. Den første faldgrube er en indstilling, der begrænser mængden af RAM, der bruges til cache i VictoriaMetrics. Som standard er den sat til 60% af RAM'en på maskinen, hvor VictoriaMetrics kører, eller 60% af pod'ens RAM i Kubernetes, hvor VictoriaMetrics kører.
Hvis denne værdi ændres forkert, kan det nedbringe ydeevnen for VictoriaMetrics. For eksempel, hvis der sættes en for lav værdi, kan data stoppe med at passe ind i cache i VictoriaMetrics. Det vil føre til, at den skal udføre unødvendigt arbejde og belaste processoren og disken. Hvis du gør denne indstilling for høj, øger det for det første sandsynligheden for, at VictoriaMetrics crasher med en out of memory-fejl, og for det andet vil det efterlade meget lidt RAM til filcachen i operativsystemet. VictoriaMetrics er afhængig af filcachen for ydeevne. Hvis der ikke er nok, kan det øge belastningen på disken betydeligt. Derfor er rådet: ændre ikke parameteren uden tvingende grund.
Den anden indstilling er retentionPeriod — perioden, der som standard er sat til 1 måned. Dette er den tid, hvor VictoriaMetrics opbevarer data. Efter denne periode sletter VictoriaMetrics data.
Mange starter VictoriaMetrics uden denne parameter og gemmer data i en måned. Og så spørger de: hvorfor forsvandt dataene fra den forrige måned? Fordi retentionPeriod som standard er 1 måned. Derfor er det vigtigt at kende og indstille det korrekte retentionPeriod.
Lad os tage et kig på de unikke funktioner.
Thanos har en funktion kaldet downsampling: 5-minutters og timeintervaller, der ofte . Hvis du googler og ser deres issues på github, er der mange problemer relateret til denne downsampling, som nogle gange ikke fungerer korrekt, eller som ikke opfører sig som brugerne forventer.
Thanos har deduplicering af data for Prometheus HA par. Når to Prometheus’er indsamler de samme metrics fra de samme targets, og Thanos gemmer dem i Object Storage. Thanos kan korrekt deduplicere disse data, i modsætning til VictoriaMetrics.
Thanos har en alert-komponent, som viste sig i Thanos-diagrammet. Men den .
En fordel ved Thanos er, at koden til Thanos og Prometheus er fælles. Thanos og Prometheus er udviklet af de samme udviklere. Når der er forbedringer i Thanos eller Prometheus, vinder den anden part.
VictoriaMetrics' vigtigste funktion er MetricsQL. Det er en udvidelse af VictoriaMetrics til PromQL, som jeg talte om på det seneste big monitoring meetup.
VictoriaMetrics understøtter indlæsning af data via mange forskellige protokoller. VictoriaMetrics kan ikke kun modtage data fra Prometheus, men også via protokoller som Influx, OpenTSDB og Graphite.
Data i VictoriaMetrics optager generelt meget mindre plads sammenlignet med Thanos og Prometheus.
Hvis man optager reelle data, rapporterer brugerne om en 2-5 gange reduktion af datastørrelsen på disken sammenlignet med Prometheus og Thanos.
Endnu en fordel ved VictoriaMetrics er, at den er optimeret til hastighed.
Lad os se på omkostningerne ved infrastrukturen.
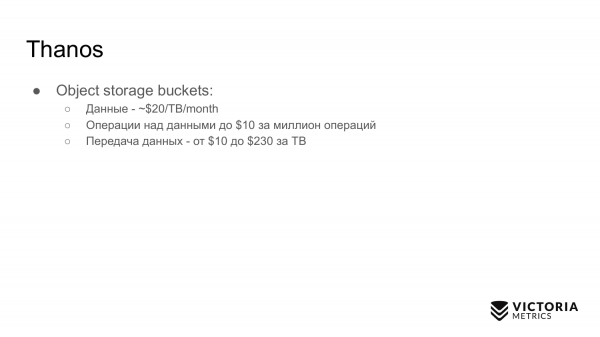
En fordel ved Thanos er, at det gemmer data i object storage, som er relativt billigt.
Når du gemmer data i object storage, skal du betale for skrive- og læseoperationer ($10 for en million operationer). Når du skriver data til object storage, betaler du for dine hostingomkostninger for at uploade data til internettet, hvis din klynge ikke er i AWS — det er gratis der. Når du læser data, betaler du fra $10 til $230 for 1TB. Dette kan være væsentligt, hvis du ofte anmoder om historiske data fra Thanos-klyngen.
For a Thanos cluster, you need to pay for servers for the Compact, Store Gateway, and Query components, which require a lot of memory and CPU for large amounts of data.
The costs for VictoriaMetrics are as follows. If you store data on GCE HDD disks, it amounts to $40 per 1TB. Ordinary HDD disks are sufficient for VictoriaMetrics; there is no need for SSDs, which are five times more expensive. VictoriaMetrics is optimized for HDD.
VictoriaMetrics requires servers for components: either single-node or for clustered components, which, unlike Thanos components, require significantly less CPU and RAM—thus, it will be cheaper.
Implementation examples.
An example of Thanos implementation is GitLab. GitLab runs entirely on Thanos. However, it's not all smooth sailing. If you look at their , you can see that they constantly encounter some : there is not enough memory for the Store Gateway or Query components. They constantly have to increase the memory.
Due to this, expenses related to solving these problems increase.
The second implementation, which may be more successful, is the company Improbable, which started the development of Thanos. They have published the source code of Thanos. Improbable is a company that develops game engines.
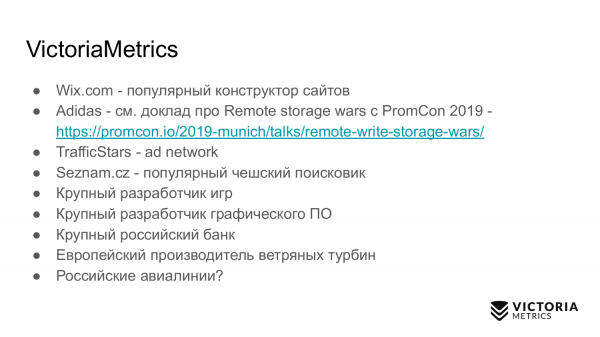
Public examples of VictoriaMetrics implementations include:
- wix.com website builder
- Adidas is implementing VictoriaMetrics and even presented a report at the last PromCon 2019
- TrafficStars — ad network
- Seznam.cz — a popular Czech search engine.
Then there are no-name companies that I cannot name right now. They did not give their consent.
- One major game developer. Bigger than Improbable.
- A large provider of graphic software.
- A large Russian bank.
- A European manufacturer of wind turbines that successfully tested VictoriaMetrics. This manufacturer implements VictoriaMetrics to monitor data obtained from wind turbines at a rate of 50 samples per second for each sensor. Each wind turbine has several hundred sensors. They have several hundred wind turbines.
- Russian airlines are looking to implement VictoriaMetrics but have not yet managed to do so. We are at the contract stage with them.
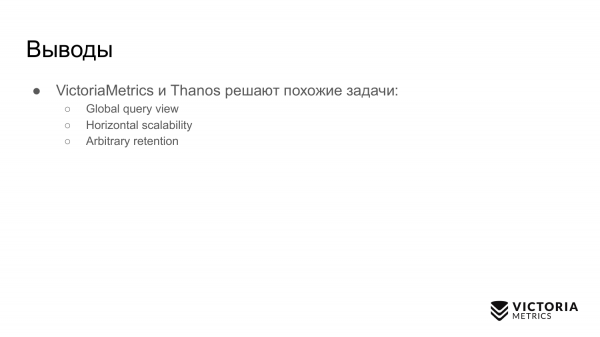 Konklusioner.
VictoriaMetrics and Thanos address similar tasks but in different ways:
- Global query view
- horizontal scaling
- arbitrary retention
Tak.
We look forward to seeing you on our .
Kun registrerede brugere kan deltage i undersøgelsen. , please.
What do you use as long-term storage for Prometheus?
35,3%Thanos6
0,0%Cortex0
0,0%M3DB0
41,2%VictoriaMetrics7
23,5%other4
17 brugere har stemt. 16 brugere har undladt at stemme.
Kilde: habr.com
