

VictoriaMetrics, TimescaleDB og InfluxDB blev sammenlignet i et datasæt med en milliard datapunkter, der tilhører 40K unikke tidsserier.
For nogle år siden var der en æra med Zabbix. Hver bare metal server havde ikke mere end et par målinger – CPU-udnyttelse, hukommelsesudnyttelse, diskudnyttelse og netværksudnyttelse. Således kan målinger fra tusinde servere passe ind i 40.000 unikke tidsserier, og Zabbix kan bruge MySQL som backend for disse tidsserier 🙂
I dag giver en med standardkonfigurationer mere end 500 målinger per gennemsnitlig vært. Der er mange for forskellige databaser, webservere, hardware og så videre. Alle giver en række nyttige målinger. Flere og flere applikationer Hvad er en stor mængde unikke tidsserier på nuværende tidspunkt? Måske 400K eller 4M? Eller 40M? Lad os sammenligne moderne TSDB'er med disse tal.
Opsætning af benchmark
TSBS
-scale -scale-var ). 10 er antallet af dimensioner (målinger), der genereres på hver vært, server. De følgende datasæt blev oprettet med TSBS til benchmark:400K unikke tidsserier, 60 sekunders interval mellem datapunkter, data dækker i alt 3 dage, ~1.7B totalt antal datapunkter.
- 4M unikke tidsserier, 600 sekunders interval, data dækker i alt 3 dage, ~1.7B totalt antal datapunkter.
- 40M unikke tidsserier, 1 times interval, data dækker i alt 3 dage, ~2.8B totalt antal datapunkter.
- Klient og server blev kørt på dedikerede instanser
n1-standard-16 i Google-skyen. Disse instanser havde følgende konfigurationer:
- vCPUs: 16
- RAM: 60 GB
- Lagring: standard hårddisk med 1 TB kapacitet. Den tilbyder en læse-/skrivebåndbredde på 120 Mbit/s, 750 læseoperationer pr. sekund og 1,5K skriveoperationer pr. sekund.
TSDB'er blev hentet fra de officielle docker-billeder og kørt i docker med følgende konfigurationer:
VictoriaMetrics:
docker run -it --rm -v /mnt/disks/storage/vmetrics-data:/victoria-metrics-data -p 8080:8080 valyala/victoria-metricsInfluxDB værdi (-e kræves for at understøtte høj kapacitet. Se detaljer i ):
docker run -it --rm -p 8086:8086
-e INFLUXDB_DATA_MAX_VALUES_PER_TAG=4000000
-e INFLUXDB_DATA_CACHE_MAX_MEMORY_SIZE=100g
-e INFLUXDB_DATA_MAX_SERIES_PER_DATABASE=0
-v /mnt/disks/storage/influx-data:/var/lib/influxdb influxdb
TimescaleDB (konfigurationen blev taget fra fil):
MEM=`free -m | grep "Mem" | awk ‘{print $7}’`
let "SHARED=$MEM/4"
let "CACHE=2*$MEM/3"
let "WORK=($MEM-$SHARED)/30"
let "MAINT=$MEM/16"
let "WAL=$MEM/16"
docker run -it — rm -p 5432:5432
--shm-size=${SHARED}MB
-v /mnt/disks/storage/timescaledb-data:/var/lib/postgresql/data
timescale/timescaledb:latest-pg10 postgres
-cmax_wal_size=${WAL}MB
-clog_line_prefix="%m [%p]: [%x] %u@%d"
-clogging_collector=off
-csynchronous_commit=off
-cshared_buffers=${SHARED}MB
-ceffective_cache_size=${CACHE}MB
-cwork_mem=${WORK}MB
-cmaintenance_work_mem=${MAINT}MB
-cmax_files_per_process=100
Databufferen blev kørt med 16 parallelle tråde.
Denne artikel indeholder kun resultaterne for indsættelsesmålinger. Resultaterne for det stikprøvebenchmark vil blive offentliggjort i en separat artikel.
400K unikke tidsserier
Lad os starte med de enkle elementer — 400K. Benchmarkresultater:
- VictoriaMetrics: 2,6M datapunkter pr. sekund; hukommelsesforbrug: 3 GB; slutlig datastørrelse på disken: 965 MB
- InfluxDB: 1,2M datapunkter pr. sekund; hukommelsesforbrug: 8,5 GB; slutlig datastørrelse på disken: 1,6 GB
- Timescale: 849K datapunkter pr. sekund; hukommelsesforbrug: 2,5 GB; slutlig datastørrelse på disken: 50 GB
Som du kan se fra ovenstående resultater, vinder VictoriaMetrics i indsætningsydelse og kompressionsgrad. Timescale vinder i hukommelsesforbrug, men det bruger meget diskplads — 29 byte pr. datapunkt.
Nedenfor er CPU-forbrugsdiagrammer (CPU) for hver af TSDB'erne under benchmarkingen:
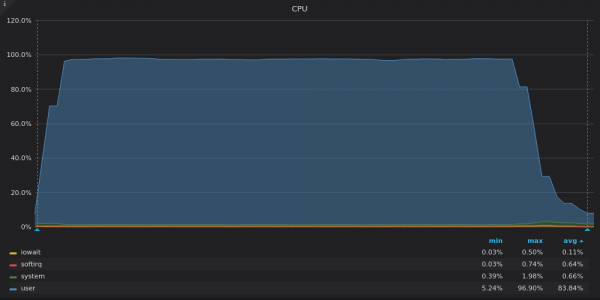
Ovenfor screenshot: VictoriaMetrics — CPU-belastning under indsætningstest for unik metrik 400K.
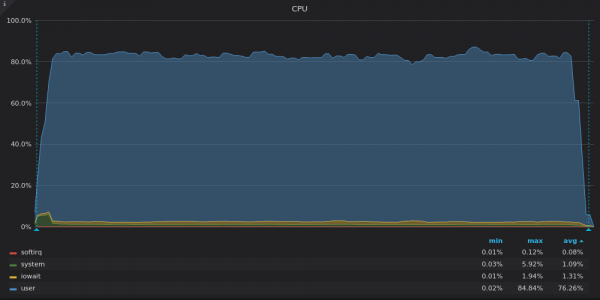
Ovenfor screenshot: InfluxDB — CPU-belastning under indsætningstest for unik metrik 400K.
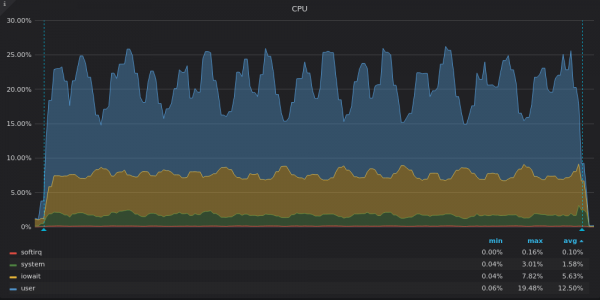
Ovenstående screenshot: TimescaleDB — CPU-belastning under indsættestesten for unik metrik 400K.
VictoriaMetrics bruger alle tilgængelige vCPUs, mens InfluxDB kun bruger ~2 ud af 16 vCPUs.
Timescale bruger kun 3-4 ud af 16 vCPUs. Høje andele af iowait og system på TimescaleDB's tidslinjegraf viser et flaskehalsproblem i I/O-underenheden. Lad os se på graferne for diskbåndbreddeforbrug:
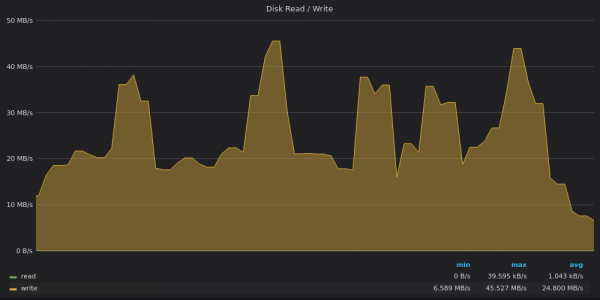
Ovenstående screenshot: VictoriaMetrics — Diskbåndbreddeforbrug under indsættestesten for 400K unikke metrics.
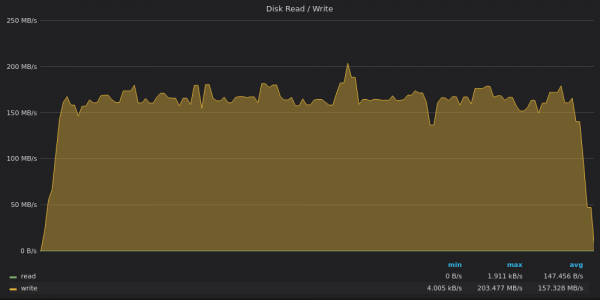
Ovenstående screenshot: InfluxDB — Diskbåndbreddeforbrug under indsættestesten for 400K unikke metrics.
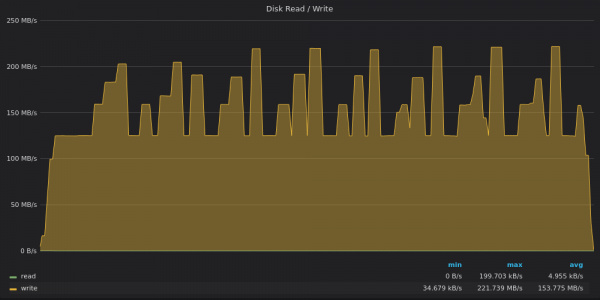
Ovenstående screenshot: TimescaleDB — Diskbåndbreddeforbrug under indsættestesten for 400K unikke metrics.
VictoriaMetrics registrerer data med en hastighed på 20 Mbit/s med toppe op til 45 Mbit/s. Toppe svarer til store delvise fusions i træet. .
InfluxDB registrerer data med en hastighed på 160 MB/s, mens 1 TB disk til en skrivebåndbredde på 120 MB/s.
TimescaleDB er begrænset til en skrivebåndbredde på 120 Mbit/s, men bryder nogle gange denne grænse og når op til 220 Mbit/s under topværdier. Disse toppe svarer til magre CPU-belastninger på det forrige diagram.
Lad os se på graferne for I/O-forbrug:
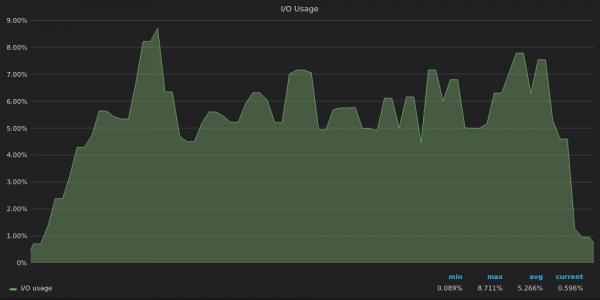
Ovenstående screenshot: VictoriaMetrics — I/O-forbrug under indsættestesten for 400K unikke metrics.
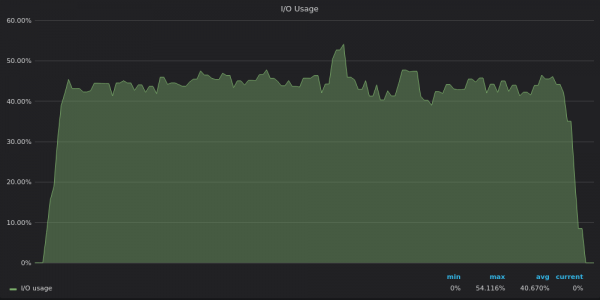
Ovenstående screenshot: InfluxDB — I/O-forbrug under indsættestesten for 400K unikke metrics.
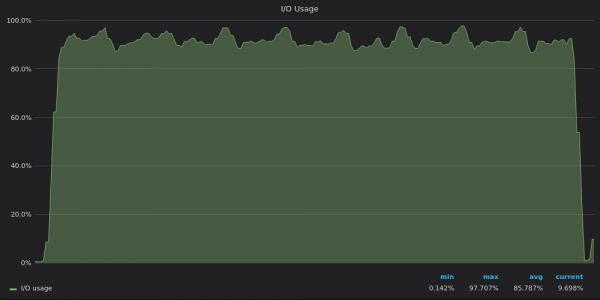
Ovenstående screenshot: TimescaleDB — I/O-forbrug under indsættestesten for 400K unikke metrics.
Det er nu klart, at TimescaleDB har nået I/O-grænsen, så den kan ikke udnytte de resterende 12 vCPUs.
4M unikke tidsserier
4M tidsserier ser lidt udfordrende ud. Men vores konkurrenter klarer denne test med succes. Benchmarkresultater:
- VictoriaMetrics: 2,2M datapunkter i sekundet; hukommelsesforbrug: 6 GB; endelig størrelsen af data på disk: 3 GB.
- InfluxDB: 330K datapunkter i sekundet; hukommelsesforbrug: 20,5 GB; endelig størrelsen af data på disk: 18,4 GB.
- TimescaleDB: 480K datapunkter pr. sekund; hukommelsesforbrug: 2,5 GB; endelig datastørrelse på disk: 52 GB.
InfluxDB's ydeevne faldt fra 1,2 millioner datapunkter pr. sekund for 400K tidsserier til 330.000 datapunkter pr. sekund for 4M tidsserier. Dette er et betydeligt fald i ydeevnen sammenlignet med andre konkurrenter. Lad os se på CPU-brugsdiagrammerne for at forstå årsagen til dette fald:
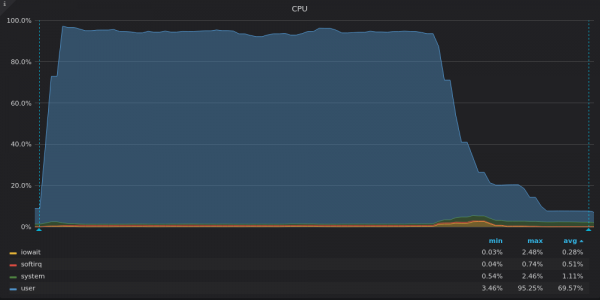
ovenfor skærmbillede: VictoriaMetrics – CPU-brug under indsættelsestest for unikke 4M tidsserier.
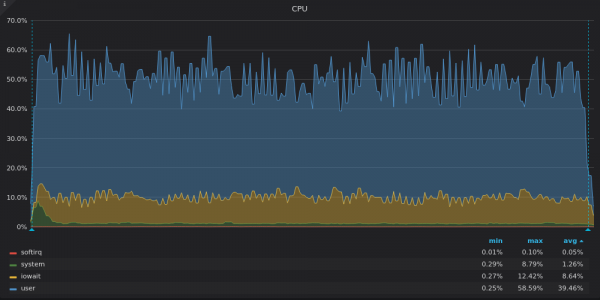
ovenfor skærmbillede: InfluxDB – CPU-brug under indsættelsestest for unikke 4M tidsserier.
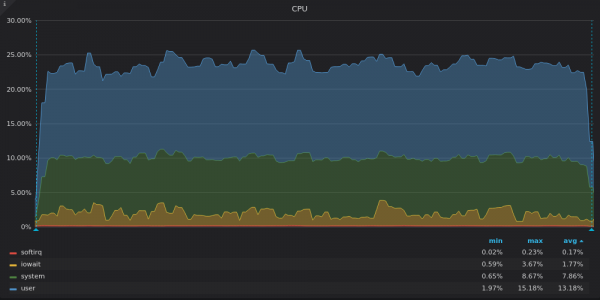
ovenfor skærmbillede: TimescaleDB – CPU-brug under indsættelsestest for unikke 4M tidsserier.
VictoriaMetrics bruger næsten hele CPU-kapaciteten. Faldet til sidst svarer til de resterende LSM-fusioner efter indsættelsen af alle data.
InfluxDB bruger kun 8 af 16 vCPUs, mens TimescaleDB bruger 4 af 16 vCPUs. Hvad har deres diagrammer til fælles? Høj andel iowait, som igen indikerer et flaskehalsproblem i input/output.
TimescaleDB har en høj andel system. Vi antager, at høj belastning førte til mange systemopkald eller mange .
Lad os se på diskens båndbredde-diagrammer:
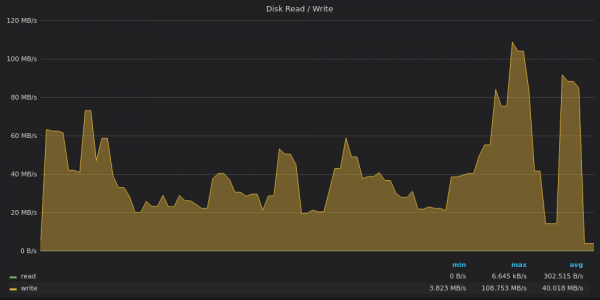
ovenfor skærmbillede: VictoriaMetrics – brug af diskbåndbredde til indsættelse af 4M unikke metrics.
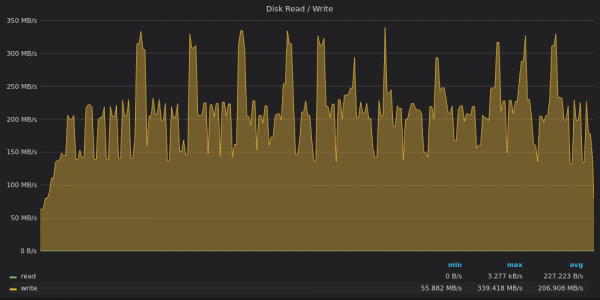
ovenfor skærmbillede: InfluxDB – brug af diskbåndbredde til indsættelse af 4M unikke metrics.
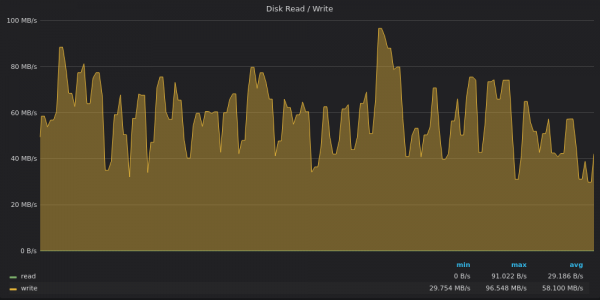
ovenfor skærmbillede: TimescaleDB – brug af diskbåndbredde til indsættelse af 4M unikke metrics.
VictoriaMetrics nåede en grænse på 120 MB/s i peak, mens den gennemsnitlige skrivehastighed var 40 MB/s. Sandsynligvis blev der udført flere tunge LSM-fusioner under peak.
InfluxDB presser igen en gennemsnitlig skrivekapacitet på 200 MB/s med toppe op til 340 MB/s på en disk med en skrivegrænse på 120 MB/s 🙂
TimescaleDB er ikke længere begrænset af disken. Det ser ud til, at det er begrænset af noget andet relateret til høj andel systembelastningen af CPU.
Lad os se på IO-brugsdiagrammerne:
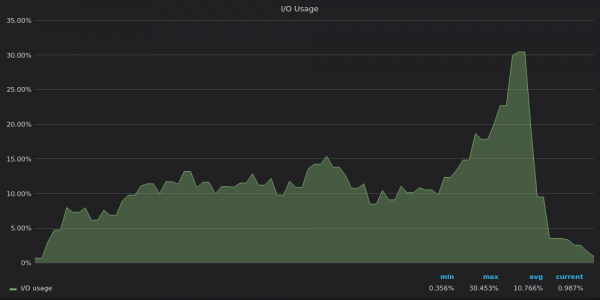
ovenfor skærmbillede: VictoriaMetrics – input/output-brug under indsættelsestesten for unikke 4M tidsserier.
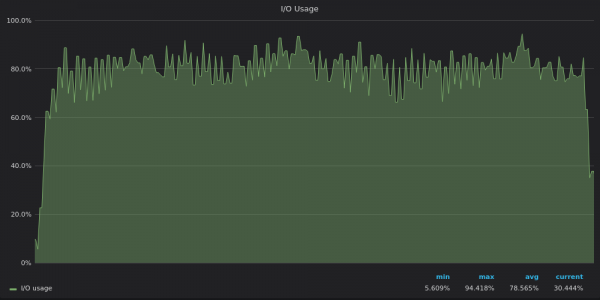
ovenfor skærmbillede: InfluxDB – input/output-brug under indsættelsestesten for unikke 4M tidsserier.
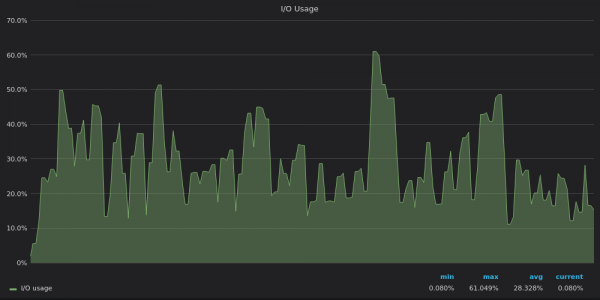
Her er skærmbilledet: TimescaleDB — Brug af I/O under tests af indsættelse for en unik tidsserie på 4M.
I/O-brugsdiagrammerne følger diagrammerne for diskbåndbredde — InfluxDB er begrænset af I/O, mens VictoriaMetrics og TimescaleDB har ækvivalente I/O-ressourcer.
40M unikke tidsserier
40M unikke tidsserier var for store til InfluxDB 🙁
Benchmarkresultater:
- VictoriaMetrics: 1,7M datapunkter pr. sekund; hukommelsesforbrug: 29 GB; diskkapacitetsforbrug: 17 GB.
- InfluxDB: afsluttede ikke, fordi det krævede mere end 60 GB hukommelse.
- TimescaleDB: 330K datapunkter pr. sekund, hukommelsesforbrug: 2,5 GB; diskkapacitetsforbrug: 84 GB.
TimescaleDB viser en usædvanligt lav og stabil hukommelsesbrug – 2,5 GB — det samme som for unikke målinger á 4M og 400K.
VictoriaMetrics steg langsomt med 100.000 datapunkter pr. sekund, indtil alle 40M metrisk navne med labels var blevet behandlet. Derefter opnåede den en stabil indsætningshastighed på 1,5-2,0M datapunkter pr. sekund, så det samlede resultat blev 1,7M datapunkter pr. sekund.
Diagrammerne for 40M unikke tidsserier ligner diagrammerne for 4M unikke tidsserier, så lad os springe dem over.
Konklusioner
- Moderne TSDB'er kan håndtere indsættelser for millioner af unikke tidsserier på én server. I den næste artikel vil vi undersøge, hvor godt TSDB'er udfører forespørgsler for millioner af unikke tidsserier.
- Utilstrækkelig CPU-belastning indikerer normalt et I/O-flaskehals. Derudover kan det tyde på for grov låsning, hvor kun få tråde kan køre samtidig.
- I/O-flaskehals eksisterer virkelig, især i lagre uden SSD'er, såsom virtualiserede blokenheder fra cloududbydere.
- VictoriaMetrics tilbyder den bedste optimering til langsomme lagre med lav I/O. Det giver den bedste hastighed og bedste komprimering.
Download og prøv det med dine data. Den relevante statiske binære fil er tilgængelig på .
Læs mere om VictoriaMetrics her .
Opdatering: offentliggjort med reproducerbare resultater.
Opdatering #2: Læs også .
Opdatering #3: !
Telegram chat:
Kilde: habr.com
