

Hej, jeg arbejder med at udvikle applikationer til databasesystemer. — det er en platform udviklet af Mail.ru Group, der kombinerer en højtydende databasesystem og en applikationsserver på Lua. Den høje hastighed af løsninger baseret på Tarantool opnås blandt andet ved at understøtte in-memory tilstand i databasesystemet og muligheden for at udføre applikationsforretningslogik i det samme adresseområde som dataene. Der sikres dataperstensen ved hjælp af ACID-transaktioner (der føres en WAL-log på disk). Tarantool har indbygget understøttelse af replikering og sharding. Fra version 2.1 understøttes forespørgsler på SQL. Tarantool har åbent kildekode og distribueres under Simplified BSD-licensen. Der findes også en kommerciel Enterprise-version.
Føl kraften! (…aka nyd ydelsen)
Alt nævnt ovenfor gør Tarantool til en attraktiv platform for oprettelse af højbemandede applikationer, der arbejder med databaser. I sådanne applikationer opstår der ofte behov for datareplikering.
Som nævnt ovenfor har Tarantool indbygget datareplication. Dens princip er at udføre alle transaktioner indeholdt i masterloggen (WAL) sekventielt på replikaerne. Normalt kalder vi denne replikation lavniveau) bruges til at sikre applikationens fejltolerance og/eller til at fordele læsebelastningen mellem klusterknudepunkterne.
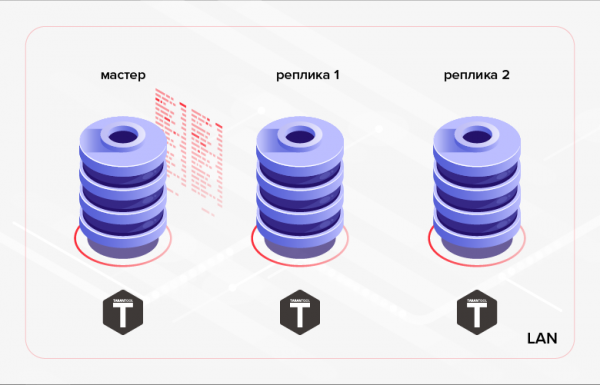
Fig. 1. Replikation inden for klustret
Et eksempel på et alternativt scenarie kan være overførsel af data, der er oprettet i én database, til en anden database til behandling/overvågning. I sidstnævnte tilfælde kan en mere praktisk løsning vise sig at være at anvende højniveau replikation — datareplication på niveauet for applikationsforretningslogikken. Det vil sige, at vi ikke bruger en eksisterende løsning, der er indbygget i databasesystemet, men vi implementerer replikationen inden for den applikation, vi udvikler. Denne tilgang har både fordele og ulemper. Lad os nævne fordelene.
1. Besparelse af båndbredde:
- man kan overføre ikke alle data, men kun en del af dem (for eksempel kan man overføre kun nogle tabeller, nogle af deres kolonner eller poster, der opfylder et bestemt kriterium);
- I modsætning til lavniveau-replikering, der udføres kontinuerligt i enten asynkron (implementeret i den nuværende version af Tarantool - 1.10) eller synkron tilstand (som vil blive implementeret i fremtidige versioner af Tarantool), kan højniveau-replikering udføres i sessioner (dvs. applikationen udfører først datasynkronisering - en dataudvekslingssession, hvorefter der opstår en pause i replikeringen, og derefter finder den næste udvekslingssession sted osv.);
- hvis en post er blevet ændret flere gange, kan kun den seneste version overføres (i modsætning til lavniveau-replikering, hvor alle ændringer, der er foretaget på masteren, vil blive afspillet sekventielt på replikaerne).
2. Der er ingen vanskeligheder ved implementering af udveksling over HTTP, hvilket muliggør synkronisering af fjerndatabaser.
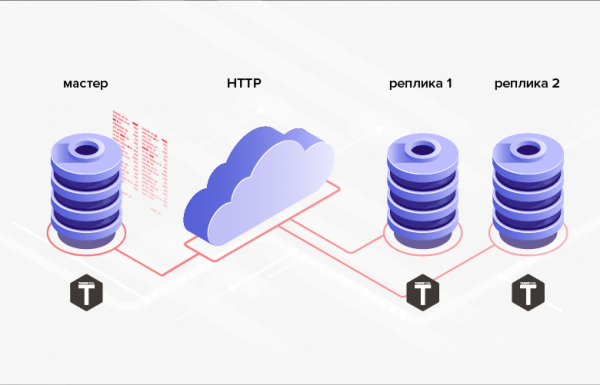
Fig. 2. Replikering over HTTP
3. Databasestrukturerne, mellem hvilke dataene overføres, behøver ikke at være ens (desuden er det generelt endda muligt at bruge forskellige DBMS'er, programmeringssprog, platforme osv.).
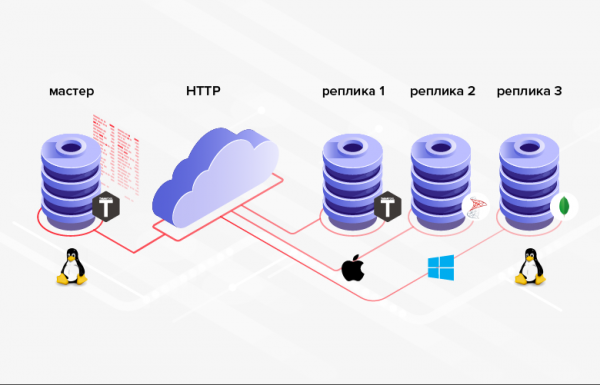
Fig. 3. Replikering i heterogene systemer
Ulempen er, at programmering i gennemsnit er mere kompliceret/omkostningsfuld end konfiguration, og i stedet for at indstille indbygget funktionalitet skal man implementere sin egen.
Hvis de nævnte fordele er afgørende i din situation (eller er en nødvendig betingelse), er det værd at overveje højniveau-replikering. Lad os se på nogle måder at implementere højniveau-replikering af data i Tarantool DBMS.
Minimering af trafik
Et af fordelene ved højniveau-replikering er derfor besparelsen på trafik. For at dette fordel kan udnyttes fuldt ud, er det nødvendigt at minimere mængden af data, der overføres pr. udvekslingssession. Selvfølgelig må man ikke glemme, at modtageren af dataene til slutningen af sessionen skal være synkroniseret med kilden (i det mindste omkring den del af dataene, der er involveret i replikeringen).
Hvordan kan man så minimere mængden af data, der overføres ved højniveau-replikering? En direkte løsning kan være at vælge data baseret på dato-tid. Til dette kan man bruge et eksisterende dato-tid felt i tabellen (hvis det findes). For eksempel kan en 'ordre'-post have et felt 'krævet leveringstidspunkt' — levering_tid. Problemet med denne løsning er, at værdierne i dette felt ikke nødvendigvis er i den rækkefølge, hvor ordrerne blev oprettet. Derfor kan vi ikke huske den maksimale værdi for feltet levering_tid, der blev sendt ved den tidligere udveksling, og ved den næste udveksling vælge alle poster med en højere værdi i feltet levering_tid. I mellemtiden mellem udvekslingerne kan der være blevet tilføjet poster med lavere værdier i feltet levering_tid. Desuden kan ordren have gennemgået ændringer, som dog ikke har påvirket feltet levering_tid. I begge tilfælde vil ændringerne ikke blive overført fra kilde til modtager. For at løse disse problemer kræver det, at vi overfører data "overlapper". Dvs. ved hver udveksling vil vi overføre alle data med en værdiværdi levering_tid, der overstiger et givet punkt i fortiden (for eksempel N timer fra det nuværende tidspunkt). Det er dog klart, at denne tilgang er meget overflødig for store systemer og kan annullere den trafikbesparelse, vi stræber efter. Desuden kan den overførte tabel mangle et felt relateret til dato-tid.
En anden løsning, mere kompleks i forhold til implementeringen, indebærer bekræftelse af modtagelse af data. I dette tilfælde overføres alle data ved hver udveksling, hvis modtagelse ikke er bekræftet af modtageren. For at implementere dette skal der tilføjes en boolesk kolonne i kildetabellen (for eksempel, is_transferred). Hvis modtageren bekræfter modtagelsen af posten, får det tilsvarende felt værdien true, hvorefter posten ikke længere deltager i udvekslingen. Denne implementeringsmulighed har følgende ulemper. For det første skal der genereres og sendes en bekræftelse for hver overført post. Groft sagt kan dette svare til en fordobling af mængden af overførte data og kan føre til en fordobling af antallet af roundtrips. For det andet er der ikke mulighed for at sende den samme post til flere modtagere (den første modtager, der modtager posten, bekræfter modtagelsen for sig selv og alle andre).
En metode uden de nævnte ulemper består i at tilføje en kolonne i den overførte tabel til at spore ændringer i dens rækker. En sådan kolonne kan have datatypen dato-tid og skal angives/opdateres af applikationen til det aktuelle tidspunkt hver gang der tilføjes/ændres poster (atomart med tilføjelse/ændring). Som eksempel vil vi kalde kolonnen update_time. Ved at gemme den maksimale værdi af feltet i denne kolonne for de overførte poster, kan vi begynde den næste udvekslingssession fra denne værdi (vælge poster med feltets værdi update_time, der overstiger den tidligere gemte værdi). Problemet med denne tilgang er, at dataændringer kan ske i batch. Som følge heraf kan værdierne i kolonnen update_time ikke være unikke. Dermed kan denne kolonne ikke bruges til sidevisning af data. Til sidevisning af data er vi nødt til at finde på yderligere mekanismer, som sandsynligvis vil have en meget lav effektivitet (for eksempel at hente alle poster fra databasen med en værdi update_time over den angivne og returnere et bestemt antal poster, startende fra et bestemt offset fra begyndelsen af udvælgelsen).
Det er muligt at forbedre effektiviteten af datatransmissionen ved lidt at forbedre den tidligere tilgang. Til dette vil vi bruge heltalstype (langt heltal) som værdierne for felterne i kolonnen til at spore ændringer. Lad os kalde kolonnen row_ver. Værdien af feltet i denne kolonne skal stadig angives/opdateres hver gang en post oprettes/ændres. Men i dette tilfælde vil feltet få tildelt ikke det aktuelle dato-tid, men værdien af en tæller, der øges med én. Som følge heraf vil kolonnen row_ver indeholde unikke værdier og kan bruges ikke kun til at returnere "delta"-data (data, der er blevet tilføjet/ændret efter afslutningen af den tidligere udvekslingssession), men også til en enkel og effektiv opdeling af dem i sider.
Den sidste foreslåede metode til at minimere mængden af data, der overføres inden for høj-niveau replikering, synes at være den mest optimale og universelle for mig. Lad os dykke dybere ned i den.
Datatransmission ved hjælp af versionsnummer tælleren
Implementering af serverdelen/masterdelen
I MS SQL Server findes der en specifik kolonne-type til implementering af en sådan tilgang — rowversion. Hver database har en tæller, der stiger med én hver gang en post tilføjes/ændres i en tabel, der har en kolonne af typen rowversion. Værdien af denne tæller tildeles automatisk feltet i den tilføjede/ændrede post. Databasehåndteringssystemet Tarantool har ikke en lignende indbygget mekanisme. Det er dog ikke svært at implementere det manuelt i Tarantool. Lad os se, hvordan dette gøres.
For at starte, lidt terminologi: tabeller i Tarantool kaldes rum (space), og poster kaldes tupler (tuple). I Tarantool kan man oprette sekvenser (sequence). Sekvenser er i bund og grund navngivne generatorer af sorterede værdier af heltal. Det vil sige, at dette er præcis hvad vi har brug for til vores formål. Nedenfor vil vi oprette en sådan sekvens.
Før du udfører en hvilken som helst operation med databasen i Tarantool, skal du køre følgende kommando:
box.cfg{}Som resultat vil Tarantool begynde at gemme snapshots af databasen (snapshot) og transaktionsjournalen i den nuværende katalog.
Lad os oprette sekvensen row_version:
box.schema.sequence.create('row_version',
    { if_not_exists = true })
Mulighed if_not_exists gør det muligt at køre oprettelsesskriptet flere gange: hvis objektet eksisterer, vil Tarantool ikke forsøge at oprette det igen. Denne mulighed vil blive brugt i alle følgende DDL-kommandoer.
Lad os oprette et rum til eksemplet.
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        },
        {
            name = 'row_ver',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})
Her har vi angivet navnet på rummet (goods), feltnavne og deres typer.
Auto-increment-felter i Tarantool oprettes også ved hjælp af sekvenser. Lad os oprette en auto-increment primær nøgle baseret på feltet id:
box.schema.sequence.create('goods_id',
    { if_not_exists = true })
box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Tarantool understøtter flere typer indekser. De mest brugte indekstyper er TREE og HASH, som er baseret på de tilsvarende navne. TREE er den mest alsidige type indeks. Det giver mulighed for at hente data i en sorteret rækkefølge. Men til lighedssøgning er HASH mere passende. Derfor er det hensigtsmæssigt at bruge HASH for den primære nøgle (som vi har gjort).
For at bruge en kolonne row_ver til at overføre ændrede data, skal værdierne for sekvensen knyttes til felterne i denne kolonne row_ver. Men i modsætning til den primære nøgle skal værdien af kolonnefeltet row_ver øges med én ikke kun ved tilføjelse af nye poster, men også ved ændringer af eksisterende. Til dette kan man bruge triggere. I Tarantool er der to typer triggere for rum: before_replace og on_replace. Triggere aktiveres ved hver ændring af data i rummet (for hver tuple, der berøres af ændringerne, aktiveres triggere-funktionen). I modsætning til on_replace, before_replace-triggere gør det muligt at modificere dataene i tuplen, som triggere udføres for. Derfor passer den sidste type triggere til vores behov.
box.space.goods:before_replace(function(old, new)
    return box.tuple.new({new[1], new[2], new[3],
        box.sequence.row_version:next()})
end)
Den nævnte trigger erstatter værdien af feltet row_ver i den gemte tuple med den næste værdi fra sekvensen row_version.
For at man kan hente data fra rummet goods baseret på kolonnen row_ver, lad os oprette et indeks:
box.space.goods:create_index('row_ver', {
    parts = { 'row_ver' },
    unique = true,
    type = 'TREE',
    if_not_exists = true
})
Indekstypen er træ (TREE), da vi har brug for at hente dataene i stigende rækkefølge efter værdierne i kolonnen. row_ver.
Lad os tilføje nogle data til rummet:
box.space.goods:insert{nil, 'pen', 123}
box.space.goods:insert{nil, 'pencil', 321}
box.space.goods:insert{nil, 'brush', 100}
box.space.goods:insert{nil, 'watercolour', 456}
box.space.goods:insert{nil, 'album', 101}
box.space.goods:insert{nil, 'notebook', 800}
box.space.goods:insert{nil, 'rubber', 531}
box.space.goods:insert{nil, 'ruler', 135}
Da det første felt er en auto-inkrementer, sender vi nil i stedet. Tarantool vil automatisk indsætte den næste værdi. På samme måde kan man sende nil som værdi for kolonnefelterne—eller slet ikke angive nogen værdi, da denne kolonne indtager den sidste plads i rummet. row_ver Lad os tjekke resultatet af indsættelsen:
Проверим результат вставки:
tarantool> box.space.goods:select()
---
- - [1, 'pen', 123, 1]
  - [2, 'pencil', 321, 2]
  - [3, 'brush', 100, 3]
  - [4, 'watercolour', 456, 4]
  - [5, 'album', 101, 5]
  - [6, 'notebook', 800, 6]
  - [7, 'rubber', 531, 7]
  - [8, 'ruler', 135, 8]
...
Som vi kan se, blev det første og sidste felt udfyldt automatisk. Nu vil det ikke være svært at skrive en funktion til sidevisning af ændringerne i rummet. goods:
local page_size = 5
local function get_goods(row_ver)
    local index = box.space.goods.index.row_ver
    local goods = {}
    local counter = 0
    for _, tuple in index:pairs(row_ver, {
        iterator = 'GT' }) do
        local obj = tuple:tomap({ names_only = true })
        table.insert(goods, obj)
        counter = counter + 1
        if counter >= page_size then
            break
        end
    end
    return goods
end
Funktionen tager som parameter den værdi, row_ver, som udtrækningen af ændringerne skal begynde fra, og returnerer en portion af ændrede data.
Dataudtræk i Tarantool udføres via indekser. Funktionen get_goods bruger en iterator over indekset row_ver til at hente ændrede data. Iteratorens type er GT (Greater Than, større end). Det betyder, at iteratoren vil udføre en sekventiel gennemgang af indeksværdierne begyndende fra den givne nøgle (værdien af feltet row_ver).
Iteratoren returnerer tuppler. For senere at kunne sende dataene via HTTP er det nødvendigt at konvertere tupplerne til en struktur, der er praktisk at serialisere. I eksemplet bruges standardfunktionen tomap. I stedet for at bruge tomap kan man skrive sin egen funktion. For eksempel kan vi have lyst til at omdøbe feltet name, ikke at sende feltet code og tilføje feltet comment:
local function unflatten_goods(tuple)
    local obj = {}
    obj.id = tuple.id
    obj.goods_name = tuple.name
    obj.comment = 'nogle kommentarer'
    obj.row_ver = tuple.row_ver
    return obj
end
Størrelsen på siden af de returnerede data (antal poster i en portion) bestemmes af variablen page_size. I eksemplet er værdien page_size lig med 5. I et reelt program har siden størrelsen ofte større betydning. Den afhænger af den gennemsnitlige størrelse af en tuple i rummet. Den optimale side størrelse kan bestemmes eksperimentelt ved at måle dataoverførselstiden. Jo større sidelængden er, desto færre runder der er mellem den sendende og modtagende side. Dette kan reducere den samlede tid til at udlæse ændringer. Dog, hvis sidelængden er for stor, vil vi tage for lang tid for serveren med at serialisere udvalget. Dette kan resultere i forsinkelser i behandlingen af andre anmodninger, der kommer til serveren. Parameteren page_size kan indlæses fra konfigurationsfilen. For hvert overført rum kan der angives en værdien. For de fleste rum kan standardværdien (f.eks. 100) være passende.
Lad os udføre funktionen get_goods:
tarantool> get_goods(0)

---
- - row_ver: 1
    code: 123
    name: pen
    id: 1
  - row_ver: 2
    code: 321
    name: pencil
    id: 2
  - row_ver: 3
    code: 100
    name: brush
    id: 3
  - row_ver: 4
    code: 456
    name: watercolour
    id: 4
  - row_ver: 5
    code: 101
    name: album
    id: 5
...
Lad os tage værdien af feltet row_ver fra den sidste række og kalde funktionen igen:
tarantool> get_goods(5)

---
- - row_ver: 6
    code: 800
    name: notebook
    id: 6
  - row_ver: 7
    code: 531
    name: rubber
    id: 7
  - row_ver: 8
    code: 135
    name: ruler
    id: 8
...
Og endnu en gang:
tarantool> get_goods(8)
---
- []
...
Som vi kan se, returnerer funktionen alle poster i rummet side for side på denne måde. goodsEfter den sidste side følger et tomt udvalg.
Lad os foretage ændringer i rummet:
box.space.goods:update(4, {{'=', 6, 'copybook'}})
box.space.goods:insert{nil, 'clip', 234}
box.space.goods:insert{nil, 'folder', 432}
Vi har ændret værdien af feltet name for én post og tilføjet to nye poster.
Lad os gentage det sidste funktionskald:
tarantool> get_goods(8)
---


- - row_ver: 9
    code: 800
    name: copybook
    id: 6
  - row_ver: 10
    code: 234
    name: clip
    id: 9
  - row_ver: 11
    code: 432
    name: folder
    id: 10
...
Funktionen returnerede de ændrede og tilføjede poster. På den måde get_goods muliggør funktionen at hente data, der er ændret siden det sidste kald, hvilket er grundlaget for den diskuterede replikationsmetode.
Vi lader resultatudsendelse over HTTP i form af JSON være uden for denne artikel. Om dette kan læses her:
Implementering af klient-/slave delen
Lad os se på, hvordan implementeringen på modtager siden ser ud. Vi opretter et rum til opbevaring af de indlæste data på modtager siden:
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})

box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Strukturen af rummet ligner strukturen af rummet i kilden. Men da vi ikke har til hensigt at overføre de modtagne data til nogen anden sted, findes kolonnen row_ver i modtagerens rum. Feltet id vil indeholde identifikatorer fra kilden. Derfor er der ikke behov for at gøre det auto-increment på modtagerens side.
Derudover har vi brug for et rum til at gemme værdierne row_ver:
box.schema.space.create('row_ver', {
    format = {
        {
            name = 'space_name',
            type = 'string'

        },
        {
            name = 'value',
            type = 'string'

        }
    },
    if_not_exists = true
})

box.space.row_ver:create_index('primary', {
    parts = { 'space_name' },
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
For hver indlæst rum (feltet space_name) gemmer vi her den senest indlæste værdi row_ver (feltet value). Kolonnen space_name.
Skab en funktion til at indlæse data fra rummet goods via HTTP. For dette har vi brug for et bibliotek, der implementerer en HTTP-klient. Den følgende linje indlæser biblioteket og opretter en instans af HTTP-klienten:
local http_client = require('http.client').new()Vi har også brug for et bibliotek til at deserialisere json:
local json = require('json')Det er nok til at oprette indlæsningsfunktionen:
local function load_data(url, row_ver)
    local url = ('%s?rowVer=%s'):format(url,
        tostring(row_ver))
    local body = nil
    local data = http_client:request('GET', url, body, {
        keepalive_idle =  1,
        keepalive_interval = 1
    })
    return json.decode(data.body)
end
Funktionen udfører en HTTP-forespørgsel til URL-adressen, sender den ind som parameter, og returnerer det deserialiserede resultat af forespørgslen. row_ver Funktionen til at gemme de indkomne data ser således ud:
local function save_goods(goods) local n = #goods box.atomic(function() for i = 1, n do local obj = goods[i] box.space.goods:put( obj.id, obj.name, obj.code) end end) end
Løkken for at gemme data i rummet er indeholdt i en transaktion (her bruges funktionen goods box.atomic ) for at minimere antallet af diskoperationer.Endelig kan funktionen til at synkronisere det lokale rum
med kilden implementeres sådan: goods Først læser vi den tidligere gemte værdi
local function sync_goods()
    local tuple = box.space.row_ver:get('goods')
    local row_ver = tuple and tuple.value or 0

    —— set your url here:
    local url = 'http://127.0.0.1:81/test/goods/list'

    while true do
        local goods = load_goods(url, row_ver)

        local count = #goods
        if count == 0 then
            return
        end

        save_goods(goods)

        row_ver = goods[count].rowVer
        box.space.row_ver:put({'goods', row_ver})
    end
end
for rummet row_ver . Hvis den ikke findes (første sessions udveksling), tager vi det som goods. Если оно отсутствует (первый сеанс обмена), то берем в качестве row_ver nul. Derefter indlæser vi de ændrede data fra kilden side for side ved den angivne url. Ved hver iteration gemmer vi de modtagne data i det relevante lokale rum og opdaterer værdien. row_ver (i rummet row_ver og i variablen row_ver) — vi tager værdien row_ver fra den sidste række af de indlæste data.
For at beskytte mod utilsigtet uendelig løkke (i tilfælde af en fejl i programmet) kan løkken while erstatte med til:
for _ = 1, max_req do ... Som resultat af funktionen sync_goods rummet goods i modtageren vil indeholde de nyeste versioner af alle posteringer i rummet goods i kilden.
Det er åbenlyst, at det på denne måde ikke er muligt at overføre sletning af data. Hvis der er behov for dette, kan man bruge en markering for sletning. Vi tilføjer til rummet goods et boolesk felt is_deleted og i stedet for fysisk at slette posterne bruger vi logisk sletning — vi sætter værdien for feltet is_deleted til værdien true. Nogle gange er det lettere at bruge et felt is_deleted , hvor dato og klokkeslæt for den logiske sletning af posten opbevares. Efter udførelsen af den logiske sletning vil den markerede post for sletning blive overført fra kilden til modtageren (ifølge den ovenfor beskrevne logik). deletedSekvensen
kan bruges til at overføre data fra andre rum: der er ikke behov for at oprette en separat sekvens for hvert overført rum. row_ver Vi har gennemgået en effektiv metode til høj-niveau replikation af data i applikationer, der bruger databasen Tarantool.
Databasen Tarantool er et attraktivt, lovende produkt til oprettelse af højtydende applikationer.
Konklusioner
- Høj-niveau replikation af data har flere fordele sammenlignet med lav-niveau replikation.
- Den metode til høj-niveau replikation, der omtales i artiklen, muliggør at minimere mængden af overførte data ved kun at overføre de optegnelser, der er ændret siden sidste udveksling.
- Hej, jeg arbejder med at lave applikationer til databasen Tarantool — det er en platform udviklet i Mail.ru Group, der kombinerer højtydende.
Kilde: habr.com
