

Siden 2019 har der været en lov i Rusland om obligatorisk mærkning. Loven gælder ikke for alle produktgrupper, og tidsplanen for indførelsen af obligatorisk mærkning varierer mellem forskellige produktgrupper. Først var tobaksprodukter, sko og medicin underlagt obligatorisk mærkning, og senere vil andre varer som parfume, tekstiler og mælk også blive omfattet. Denne lovgivning har ført til udviklingen af nye IT-løsninger, der gør det muligt at følge produktets livscyklus fra produktion til slutkunder, alle aktører i processen: både staten samt alle organisationer, der sælger varer med obligatorisk mærkning.
I X5 har systemet, der vil spore mærkede varer og udveksle data med staten og leverandører, fået navnet “Markus”. Lad os tage det trin for trin og se, hvem der har udviklet det, hvilket teknologisk stack det bruger, og hvorfor vi har grund til at være stolte.
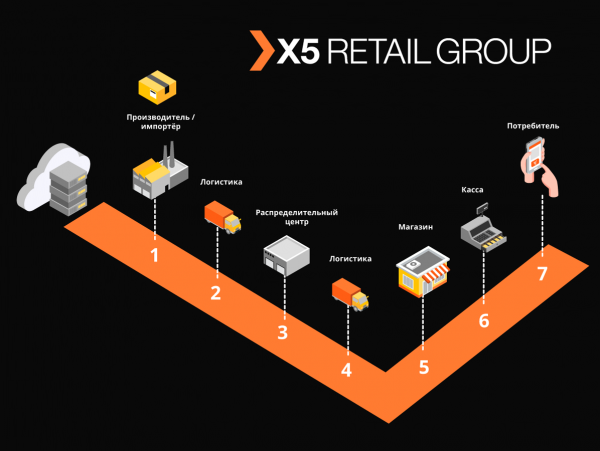
Virkelig HighLoad
“Markus” løser mange opgaver, den primære er integreret samhandling mellem X5s information systemer og den statslige informationssystem for mærkede produkter (GIS MP) for at spore bevægelsen af mærkede produkter. Desuden opbevarer platformen alle de ankomne mærkningskoder og hele historikken for bevægelsen af disse koder mellem objekter, hvilket hjælper med at eliminere fejl i sortimentet af mærkede produkter. For tobaksprodukter, som var de første under obligatorisk mærkning, indeholder en enkelt lastbil med cigaretter cirka 600.000 pakker, hvor hver pakke har sin egen unikke kode. Vores systems opgave er at spore og verificere lovligheden af hver sådan pakke, der bevæger sig mellem lagre og butikker, og til sidst bekræfte muligheden for at sælge dem til slutkunden. Vi registrerer omkring 125.000 kasseoperationer i timen, og det skal også registreres, hvordan hver pakke kom ind i butikken. Med alle bevægelser mellem objekterne forventer vi derfor at håndtere tiotals milliarder poster årligt.
Team M
Selv om "Markus" betragtes som et H5-projekt, implementeres det med en produktorienteret tilgang. Teamet arbejder i Scrum. Projektets start var i sommeren sidste år, men de første resultater kom først i oktober — et helt eget team blev oprettet, systemarkitekturen blev designet, og udstyr blev købt. I dag er teamet på 16 personer, hvoraf seks arbejder med backend- og frontend-udvikling, og tre med systemanalyse. Seks personer beskæftiger sig med manuel, belastnings- og automatiseret test samt produktsupport. Derudover har vi en SRE-specialist.
Koden i vores team skrives ikke kun af udviklerne; stort set alle medarbejdere kan programmere og skriver automatiserede test, belastningsscripts og scripts til automatisering. Vi lægger stor vægt på dette, da selv produktsupport kræver et højt niveau af automatisering. Vi forsøger altid at rådgive og hjælpe kolleger, der ikke tidligere har programmeret, ved at give dem små opgaver.
På grund af coronaviruspandemien har vi flyttet hele teamet til hjemmearbejde. Tilgængeligheden af alle værktøjer til at styre udviklingen og det opbyggede workflow i Jira og GitLab gjorde det muligt at klare denne fase let. Månederne på afstand viste, at teamets produktivitet ikke led under det, og for mange blev arbejdskomforten forbedret; det eneste, der manglede, var det personlige samvær.
Teammøde før hjemmearbejde
Møder under hjemmearbejde
Den teknologiske stak for løsningen
Standardlageret og CI/CD-værktøjet for H5 er GitLab. Vi bruger det til kodeopbevaring, kontinuerlig test og udrulning på test- og produktionsservere. Vi anvender også code review-praksis, hvor minimum to kolleger skal godkende ændringerne, som udvikleren ønsker at gennemføre i koden. Statisk kodeanalyse med SonarQube og JaCoCo hjælper os med at holde koden ren og sikre det krævede niveau af enhedstestdækning. Alle ændringer i koden skal nødvendigvis gennemgå disse kontroller. Alle testscenarier, der køres manuelt, automatiseres senere.
For at kunne udføre forretningsprocesserne i "Markus" var vi nødt til at løse en række teknologiske udfordringer, som vi vil gennemgå en ad gangen.
Opgave 1. Nødvendigheden af horisontal skalerbarhed i systemet
For at løse denne opgave valgte vi en mikrotjeneste-arkitektur. Det var meget vigtigt at forstå ansvarsområderne for tjenesterne. Vi forsøgte at opdele dem baseret på forretningsoperationer under hensyntagen til procespecifikationen. For eksempel er modtagelse på lageret en sjælden, men meget omfattende operation, hvor man hurtigt skal indhente information fra myndighederne om de modtagne enheder, hvor antallet i én levering kan nå op på 600.000, sikre, at modtagelse af varerne er tilladt og give al nødvendig information til lagers automatiseringssystem. Til gengæld har udskibning fra lagrene en meget højere intensitet, men opererer med mindre datamængder.
Alle tjenester implementerer vi efter princippet om stateless, og selv interne operationer forsøger vi at dele op i trin ved at bruge det, vi kalder, self-emner i Kafka. Det er, når en mikrotjeneste sender en meddelelse til sig selv, hvilket gør det muligt at balancere belastningen ved mere ressourcekrævende operationer og forenkler vedligeholdelse af produktet, men mere om det senere.
Vi besluttede at adskille modulerne til interaktion med eksterne systemer i separate tjenester. Dette løste problemet med ofte ændrede API’er for eksterne systemer, næsten uden at påvirke tjenesterne med forretningsfunktionalitet.
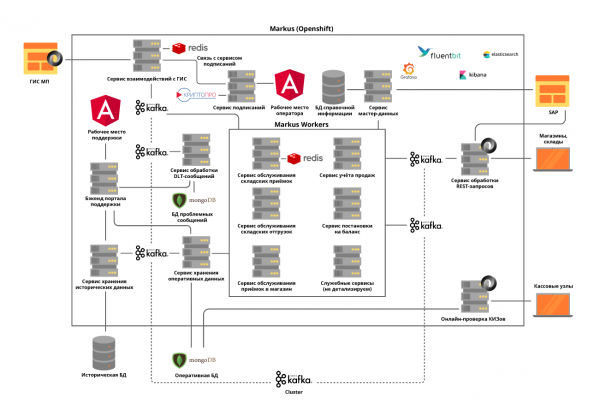
Alle mikrotjenester implementeres i et OpenShift-klynge, som både løser problemet med skalerbarhed for hver mikrotjeneste og gør det muligt for os at undgå at bruge tredjeparts værktøjer til service discovery.
Opgave 2. Behovet for at opretholde høj belastning og meget intensiv dataudveksling mellem platformens tjenester: kun i projektets startfase udføres der omkring 600 operationer pr. sekund. Vi forventer, at dette tal stiger til 5000 op/s, efterhånden som vi tilslutter handelsenheder til vores platform.
Denne opgave blev løst ved at implementere et Kafka-kluster og praktisk talt eliminere synkron interaktion mellem platformens mikrotjenester. Dette kræver en meget omhyggelig analyse af systemkravene, da ikke alle operationer kan være asynkrone. Samtidig sender vi ikke bare begivenheder via en broker, men overfører også al nødvendig forretningsinformation i meddelelsen. På den måde kan størrelsen på meddelelsen nå op på flere hundrede kilobyte. Behandlingen af meddelelsesstørrelser i Kafka kræver, at vi præcist forudsiger størrelsen på meddelelserne, og hvis nødvendigt, deler vi dem, men delingen er logisk og relateret til forretningsoperationer.
For eksempel, for varer ankommet med bil, deler vi dem efter kasser. Der er dedikerede mikrotjenester til synkrone operationer, og der udføres grundig belastningstestning. Brugen af Kafka stillede os over for en anden udfordring — test af vores servicers funktionalitet under hensyntagen til integrationen med Kafka gør alle vores enhedstest asynkrone. Denne udfordring løste vi ved at skrive vores egne utilities-methoder ved hjælp af Embedded Kafka Broker. Dette annullerer ikke behovet for at skrive enhedstest for hver enkelt metode, men i komplekse tilfælde foretrækker vi at teste med Kafka.
Vi har lagt stor vægt på logtracering for at sikre, at TraceId ikke går tabt, når der opstår undtagelser under drift af tjenesterne eller ved arbejde med Kafka batch. Og hvis der ikke var særlige spørgsmål til det første, så var vi i det andet tilfælde nødt til at registrere alle TraceId, som batch kom ind med, og vælge én til at fortsætte sporing. På den måde kan brugeren let finde sporingen ved at søge på det oprindelige TraceId.
Opgave 3. Behovet for at opbevare store mængder data: over 1 milliard mærkninger om året kun for tobaksprodukter modtages i X5. Disse kræver konstant og hurtig adgang. Systemet skal samle i alt omkring 10 milliarder poster om historikken for bevægelsen af mærkede varer.
For at løse den tredje opgave blev MongoDB NoSQL-database valgt. Vi har oprettet et sharded setup med 5 noder, og i hver node et Replica Set af 3 servere. Dette muliggør horisontal skalering af systemet ved at tilføje nye servere til klyngen og sikre dens fejltolerance. Her stødte vi på et andet problem — at sikre transaktionaliteten i Mongo-klyngen under hensyntagen til brugen af horisontalt skalerbare mikrotjenester. For eksempel er en af opgaverne i vores system at identificere forsøg på genudsalgs af varer med identiske mærkningskoder. Her opstår der problemer med fejlscanninger eller fejlagtige kasseoperationer. Vi har opdaget, at sådanne dubletter kan opstå både inden for et enkelt behandlet Kafka-batch og mellem to parallelt behandlede batch. Derfor gav en tjek for dubletter via en databaseforespørgsel ikke noget resultat. For hver af mikrotjenesterne løste vi problemet separat baseret på forretningslogikken for den pågældende tjeneste. For eksempel tilføjede vi en kontrol inden for batch for kassekvitteringer og en separat behandling for dubletter ved indsættelse.
For at brugernes arbejde med operationernes historik ikke skulle påvirke det vigtigste — funktionen af vores forretningsprocesser, har vi isoleret alle historiske data i en separat tjeneste med en særskilt database, som også modtager information gennem Kafka. På denne måde arbejder brugerne med en isoleret tjeneste uden at påvirke de tjenester, der behandler data for aktuelle operationer.
Opgave 4. Genbehandling af køer og overvågning:
I distribuerede systemer opstår der uundgåeligt problemer og fejl relateret til tilgængeligheden af databaser, køer og eksterne datakilder. I tilfælde af "Markus" er kilden til disse fejl integrationen med eksterne systemer. Det var nødvendigt at finde en løsning, der tillod gentagne anmodninger om fejlinformationer med en fastlagt timeout, uden at stoppe behandlingen af succesfulde anmodninger i den primære kø. Til dette blev den såkaldte koncept "topic based retry" valgt. For hvert hovedemne oprettes en eller flere retry-emner, hvortil fejlinformationer sendes, samtidig med at der ikke introduceres en forsinkelse i behandlingen af beskeder fra den primære emne. Interaktionsskemaet —
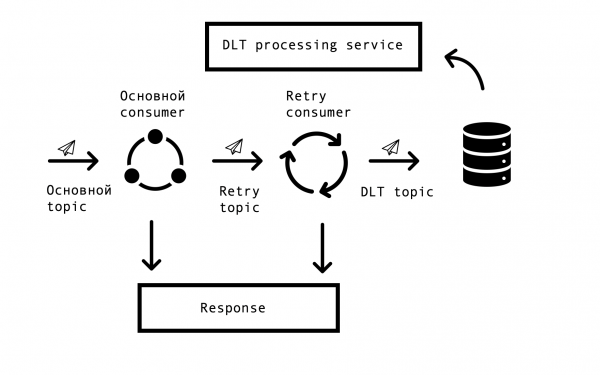
For implementing such a scheme, we required the following — integrating this solution with Spring and avoiding code duplication. In the vastness of the internet, we came across a similar solution based on Spring BeanPostProcessor, but it seemed excessively cumbersome to us. Our team developed a simpler solution that allows integration into the Spring cycle for creating consumers and additionally adding Retry Consumers. We proposed a prototype of our solution to the Spring team, which can be viewed here. The number of Retry Consumers and the number of attempts for each consumer can be configured through parameters, depending on the needs of the business process, and to make everything work, it is only necessary to use the familiar annotation for all Spring developers: org.springframework.kafka.annotation.KafkaListener.
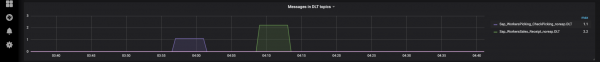
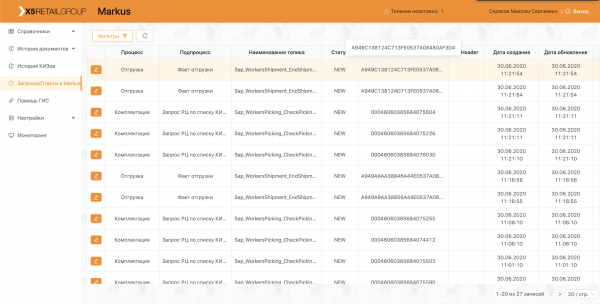
In the event that a message could not be processed after all retry attempts, it goes into the DLT (dead letter topic) using the Spring DeadLetterPublishingRecoverer. At the request of the support team, we extended this functionality and created a separate service that allows viewing the messages that have ended up in the DLT, along with stack traces, trace IDs, and other useful information about them. Furthermore, monitoring and alerts have been added for all DLT topics, and now, essentially, the appearance of a message in a DLT topic serves as a reason for investigation and defect creation. This is very convenient — based on the topic name, we immediately understand at which step of the process the problem occurred, significantly speeding up the search for its root cause.
Recently, we implemented an interface that allows our support team to resend messages after the reasons for their failure have been resolved (for instance, restoring the functionality of an external system) and, of course, recording the corresponding defect for analysis. Here, our self-topics came in handy; to avoid restarting a long processing chain, we can restart it from the desired step.
Platform Operation
The platform is already in productive operation; we conduct deliveries and shipments daily, connecting new distribution centers and stores. As part of the pilot, the system is working with product groups "Tobacco" and "Footwear."
Our entire team participates in conducting pilots, analyzes emerging issues, and makes proposals for improving our product, from enhancing logs to changes in processes.
For not repeating my mistakes, all cases found during the pilot are reflected in the automated tests. The presence of a large number of automated tests and unit tests allows for regression testing and implementing hotfixes literally within a few hours.
Currently, we are continuing to develop and improve our platform, constantly facing new challenges. If you are interested, we will share our solutions in upcoming articles.
Kilde: habr.com
