

Den 27. maj i hovedsalen på konferencen DevOpsConf 2019, der finder sted som en del af festivalen , i sektionen "Kontinuerlig levering", blev der præsenteret et foredrag "werf - vores værktøj til CI/CD i Kubernetes". I dette tale beskrives de problemer og udfordringer, som alle står over for, når man deployer i Kubernetes, samt de nuancer, der ikke altid er synlige med det samme. Ved at gennemgå mulige løsninger viser vi, hvordan dette er implementeret i et Open Source-værktøj .
Siden præsentationen har vores værktøj (tidligere kendt som dapp) passeret en milepæl på 1000 stjerner på GitHub — vi håber, at det voksende fællesskab af brugere vil gøre livet nemmere for mange DevOps-ingeniører.
Så præsenterer vi (~47 minutter, meget mere informativt end artiklen) og den vigtigste opsummering herfra i skriftlig form. Lad os komme i gang!
Levering af kode til Kubernetes
I foredraget vil fokus ikke længere være på werf, men på CI/CD i Kubernetes, idet vores software er pakket i Docker-containere (det har jeg talt om i ), og K8s vil blive brugt til at køre det i produktion (det omhandler — i ).
Hvordan ser levering ud i Kubernetes?
- Der er et Git-repositorium med koden og instruktionerne til opbygning. Applikationen bygges til et Docker-billede og publiceres i Docker Registry.
- I det samme repository er der også instruktioner om, hvordan applikationen deployes og startes. Under deployeringsprocessen sendes disse instruktioner til Kubernetes, som henter det relevante billede fra registry og starter det.
- Derudover er der normalt tests. Nogle af dem kan udføres, når billedet offentliggøres. Man kan også (ved hjælp af de samme instruktioner) deploye en kopi af applikationen (i et separat K8s-navnerum eller en separat klynge) og køre tests der.
- Sidst men ikke mindst, har vi brug for et CI-system, som modtager hændelser fra Git (eller knaptryk) og kalder alle fastlagte faser: build, publish, deploy, test.
Der er nogle vigtige bemærkninger her:
- Da vi har en uforanderlig infrastruktur (immutable infrastructure), skal billedet af applikationen, som bruges på alle faser (staging, produktion osv.), være det samme.. Mere om dette og med eksempler har jeg talt om .
- Da vi følger tilgangen infrastruktur som kode (IaC), skal kode for applikationen, instruktioner til dens opbygning og kørsel være netop i ét repository.. Mere om dette — se i .
- Leveringskæden (delivery) ser vi normalt således: applikationen er blevet bygget, testet, sluppet løs. (release stage) og det er det — leveringen er sket. Men i virkeligheden får brugeren det, som du har frigivet, ikke på det tidspunkt, hvor du har leveret det til produktion, og hvornår han kunne gå ind i det og se, at produktionen fungerede. Derfor mener jeg, at leveringens kæde slutter kun i driftsfasen (run), og hvis vi skal være mere præcise, så selv på det tidspunkt, hvor koden blev fjernet fra produktion (erstattet med en ny).
Lad os vende tilbage til den tidligere nævnte leveringsmodel i Kubernetes: den blev ikke kun opfundet af os, men af stort set alle, der beskæftigede sig med denne problemstilling. I bund og grund kaldes dette mønster nu GitOps (du kan læse mere om termen og de ideer, der ligger bag den ). Lad os se på faserne i modellen.
Bygningsstadiet (build)
Det kan virke, som om der ikke er meget at sige om bygning af Docker-billeder i 2019, når alle kan skrive Dockerfile og køre docker build?.. Вот нюансы, на которые хотелось бы обратить внимание:
- Billede størrelse betyder noget, så brug , for kun at have det, der virkelig er nødvendigt for applikationens drift, i billedet.
- Antallet af lag skal minimeres ved at kombinere kæderne af
RUN-kommandoer meningsfuldt. - Men det tilføjer problemer med fejlfinding, da det ved et sammenbrud af build-processen kan være nødvendigt at finde den rette kommando i kæden, der forårsagede problemet.
- Byggehastigheden er vigtig, fordi vi ønsker hurtigt at kunne implementere ændringer og se resultaterne. For eksempel vil man helst ikke skulle genopbygge afhængighederne i biblioteket ved hver build af applikationen.
- Ofte kræves mange billeder, hvilket kan løses med et sæt Dockerfile (eller navngivne stadier i en enkelt fil) og et Bash-script til sekventiel bygning.
Det var kun toppen af isfjellet, som alle støder på. Men der er også andre problemer, især:
- Ofte skal vi på byggestadiet noget montere (for eksempel cache resultatet af en apt-kommando til et eksternt bibliotek).
- Vi ønsker Ansible i stedet for at skulle skrive i shell.
- Vi ønsker bygge uden Docker (hvorfor have en ekstra virtuel maskine, hvor alt skal konfigureres, når der allerede er et Kubernetes-klynge, hvor man kan køre containere?).
- Parallel bygning, som kan forstås på forskellige måder: forskellige kommandoer fra Dockerfile (hvis multi-stage bruges), flere commits fra det samme repository, flere Dockerfile.
- Distribueret bygning: Vi ønsker at samle noget i pod'er, som er 'efemære', da de mister cache, og derfor skal det opbevares et andet sted.
- Endelig kaldte jeg ønskernes top automagi: Det ville være perfekt at gå ind i arkivet, skrive en kommando og få et klarlagt billede, der er samlet med forståelse for hvordan og hvad man skal gøre rigtigt. Men personligt er jeg ikke sikker på, at alle nuancer kan forudses på den måde.
Og her er projekterne:
- — en samler fra Docker Inc (allerede integreret i de aktuelle versioner af Docker), som forsøger at løse alle disse problemer;
- — en samler fra Google, der gør det muligt at samle uden Docker;
- — et forsøg fra CNCF på at gøre automagi og specielt en interessant løsning med rebase for lag;
- og en masse andre værktøjer såsom , …
… og se, hvor mange stjerner de har på GitHub. Altså, på den ene side, docker build der er og kan gøre noget, men i virkeligheden er spørgsmålet stadig ikke løst — et bevis herpå er den parallelle udvikling af alternative samlere, hver af dem løser et bestemt spørgsmål.
Bygning i werf
Så vi er nået til was previously som dapp) — et Open Source-værktøj fra 'Flant', som vi har arbejdet på i mange år. Det hele begyndte for cirka 5 år siden med Bash-scripts, der optimerede opbygningen af Dockerfiles, og de sidste 3 år har der været en fuld udvikling inden for et enkelt projekt med sit eget Git-repositorium (først i Ruby, og så til Go, og samtidig omdøbt). Hvilke opbygningsspørgsmål er løst i werf?
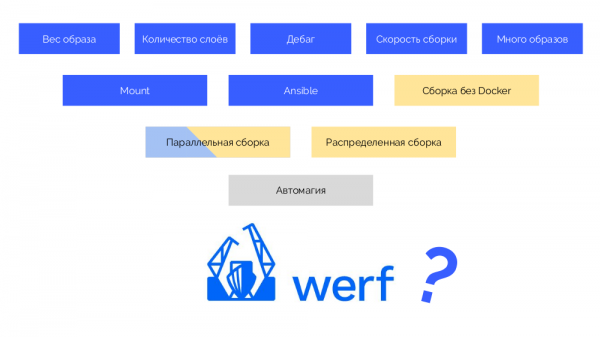
De blåmarkerede problemer er allerede implementeret, parallel byggeri er lavet inden for en enkelt vært, og de gule markerede spørgsmål planlægger vi at fuldføre inden slutningen af sommeren.
Publiceringsstadiet i registry (publish)
Vi har indsamlet docker push… — hvad kan være så svært ved at uploade et billede til registry? Og så opstår spørgsmålet: 'Hvilken tag skal gives til billedet?' Det opstår fordi vi har Gitflow (eller en anden Git-strategi) og Kubernetes, og industrien stræber efter, at det, der sker i Kubernetes, følger det, der gøres i Git. For Git er vores eneste sandhedskilde.
Hvad er der så svært ved det? At garantere reproducerbarhed: fra commit i Git, som i sin natur er uforanderlig (immutable), til Docker-billedet, der skal forblive det samme.
Det er også vigtigt for os at definere oprindelsen, fordi vi vil forstå, hvilken commit applikationen blev bygget fra, der kører i Kubernetes (så kan vi lave diffs og lignende ting).
Taggingstrategier
Den første er simpel git tag. Vi har et registry med et billede, der er tagget som 1.0. I Kubernetes er der stage og production, hvor dette billede er udtrukket. I Git laver vi commits, og på et tidspunkt sætter vi et tag 2.0. Vi bygger det i henhold til instruktionerne fra repositoryet og placerer det i registry med tagget 2.0. Udrul det på stage, og hvis alt går godt, derefter på production.
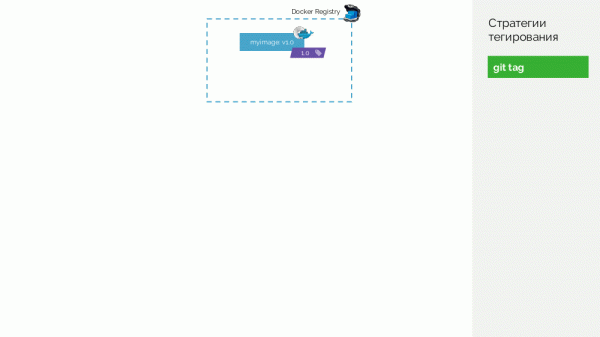
Problemet med denne tilgang er, at vi først satte et tag, og først derefter testede og udrullede. Hvorfor? For det første er det blot ulogisk: vi udsteder en version af softwaren, som vi endda ikke har testet (vi kan ikke gøre andet, da vi skal sætte et tag for at teste). For det andet kan denne tilgang ikke kombineres med Gitflow.
Den anden mulighed er git commit + tag. I master-grenen er der et tag 1.0; for dette er der i registry et billede, der er udrullet til production. Derudover er der i Kubernetes-klyngen preview og staging konturer. Derefter følger vi Gitflow: i den primære udviklingsgren (develop) laver vi nye funktioner, hvilket resulterer i et commit med идентификатор #c1. Vi samler det og publicerer det i registry, og bruger denne идентификатор (#c1). Med den samme идентификator udruller vi det på preview. Det samme gør vi med committerne #c2 og #c3.
Når vi har forstået, at der er tilstrækkeligt med funktioner, begynder vi at stabilisere alt. I Git opretter vi en gren release_1.1 (baseret på #c3 af develop). Det er ikke nødvendigt at bygge denne release, da det blev gjort i det tidligere trin. Derfor kan vi bare udrulle det til staging. Vi retter fejlene i #c4 og udruller dem på staging. Samtidig foregår der udvikling i develop, hvor ændringer fra release_1.1periodisk hentes. På et tidspunkt får vi et byggesæt, og det udrulles til staging, som vi er tilfredse med (#c25).
Så laver vi en merge (med fast-forward) af release-grenen (release_1.1) ind i master. Vi sætter et tag med den nye version på denne commit (1.1). Men dette billede er allerede bygget i registry, derfor, for ikke at bygge det igen, tilføjer vi bare et andet tag til det eksisterende billede (nu har det i registry tags #c25 og 1.1). Derefter udruller vi det til production.
Der er en ulempe ved, at der på staging er udrullet ét billede (#c25), mens der på production - som om - er et andet (1.1), men vi ved, at det 'fysisk' er det samme billede fra registry.
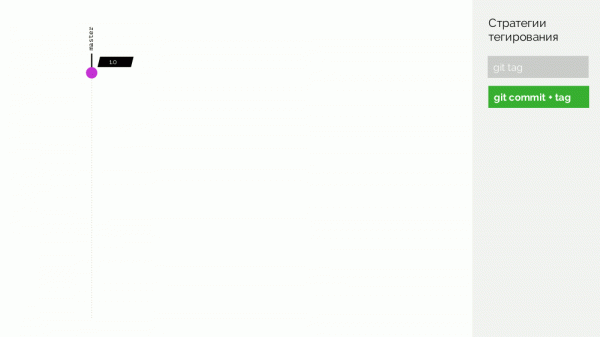
Den egentlige ulempe er, at der ikke er støtte til merge commits, der skal laves fast-forward.
Vi kan gå videre og lave et trick... Lad os se på et eksempel på en simpel Dockerfile:
FROM ruby:2.3 as assets
RUN mkdir -p /app
WORKDIR /app
COPY . ./
RUN gem install bundler && bundle install
RUN bundle exec rake assets:precompile
CMD bundle exec puma -C config/puma.rb

FROM nginx:alpine
COPY --from=assets /app/public /usr/share/nginx/www/public
Lad os opbygge en fil baseret på følgende princip:
- SHA256 fra ID'erne for de anvendte billeder (
ruby:2.3ognginx:alpine), som er kontrolsummerne af deres indhold; - alle kommandoer (
RUN,CMDog lignende); - SHA256 fra de filer, der blev tilføjet.
… og lad os tage kontrolsummen (igen SHA256) fra en sådan fil. Dette er signaturen af alt, der definerer indholdet af Docker-billedet.
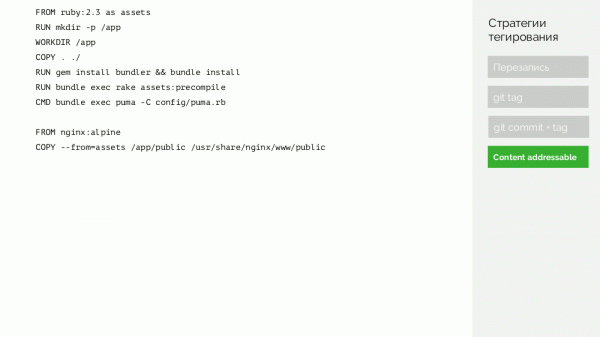
Lad os vende tilbage til skemaet og i stedet for commits bruger vi sådanne signaturer,, dvs. tagger billeder med signaturer.
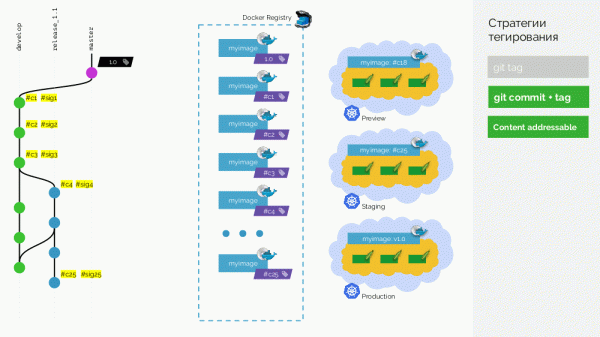
Nu, når der for eksempel skal merges ændringer fra en version til master, kan vi lave en rigtig merge commit: den vil have et andet ID, men den samme signatur. Med det samme ID kan vi udrulle billedet til produktionen.
Ulempen er, at vi nu ikke kan bestemme, hvilken commit der er blevet trukket til produktionen — kontrolsummer fungerer kun i den ene retning. Dette problem løses med et ekstra lag med metadata — jeg vil forklare det nærmere senere.
Tagging i werf
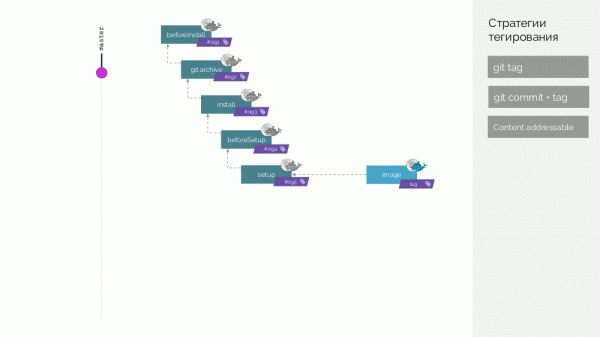
I werf er vi gået endnu længere og forbereder os på at lave en distribueret bygning med cache, der ikke gemmes på én maskine… Så vi opsamler Docker-billeder af to typer, som vi kalder stage og billede.
I Git-repositoriet werf opbevares specifikke instruktioner til byggningen, som beskriver de forskellige måder at bygge (beforeInstall, installation, beforeSetup, setup). Det første stage-billede opbygges med en signatur, der er defineret som kontrolsummen af de første trin. Derefter tilføjer vi kildekoden, for det nye stage-billede regner vi den kontrolsum… Disse operationer gentages for alle faser, og vi får et sæt af stage-billeder. Derefter laver vi det endelige image-billede, som også indeholder metadata om dets oprindelse. Dette billede tagger vi på forskellige måder (detaljer senere).
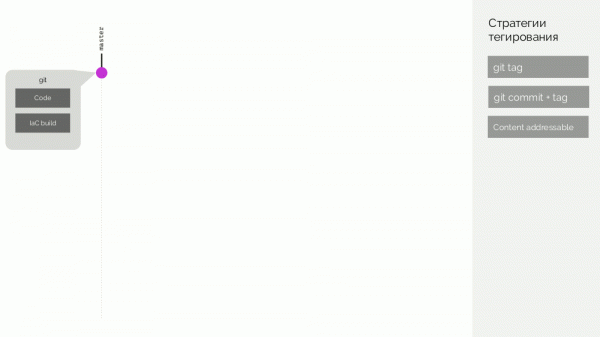
Lad os sige, at der efterfølgende kommer et nyt commit, hvor kun applikationskoden er ændret. Hvad vil der ske? Der vil blive oprettet et patch til kodeændringerne, og et nyt stage-image vil blive forberedt. Dets signatur vil blive defineret som kontrolsummen af det gamle stage-image og den nye patch. Fra dette image vil et nyt endeligt image blive dannet. En lignende adfærd vil forekomme ved ændringer på andre stadier.
Dermed er stage-images en cache, der kan opbevares distribueret, mens de images, der oprettes ud fra dem, uploades til Docker Registry.
Rydning af registry
Det handler ikke om at fjerne lag, der er tilbage efter slettede tags — dette er en standardfunktion i Docker Registry. Det handler om situationen, hvor mange Docker-tags ophobes, og vi indser, at en del af dem ikke længere er nødvendige, men de optager plads (og/eller vi betaler for dem).
Hvilke rydningsstrategier findes der?
- Man kan simpelthen vælge at ikke rydde. Nogle gange er det faktisk nemmere at betale for det ekstra plads, end at forsøge at få puljen af tags til at gå op. Men det fungerer kun op til et vist punkt.
- Total nulstilling. Hvis man sletter alle billeder og kun reconstruerer de aktuelle i CI-systemet, kan der opstå problemer. Hvis et container genstartes på produktion, vil et nyt image blive downloadet — som endnu ikke er blevet testet af nogen. Dette underminerer idéen om immutable infrastructure.
- Blue-green. Hvis én registry begynder at blive overfyldt — uploader vi billeder til en anden. Det samme problem som før: hvornår kan vi rydde den registry, der begyndte at blive overfyldt?
- Efter tid. Skal alle billeder, der er ældre end 1 måned, slettes? Men der vil helt sikkert være en service, der ikke er blevet opdateret i en hel måned...
- Manuelt definere, hvad der kan slettes.
De to virkelig levedygtige muligheder er: ikke rydde eller en kombination af blue-green + manuel. I det sidstnævnte tilfælde handler det om følgende: når du forstår, at det er tid til at rydde registry, opretter du en ny og tilføjer alle nye billeder til den i løbet af f.eks. en måned. Efter en måned ser du, hvilke pods i Kubernetes, der stadig bruger den gamle registry, og flytter dem også til den nye registry.
Hvor endte vi i werf? Мы собираем:
- Git head: alle tags, alle grene — antager at alt, hvad der er tagged i Git, også er nødvendigt i billederne (og hvis ikke, skal det slettes i selve Git).
- alle pods, der i øjeblikket er udtrukket i Kubernetes;
- gamle ReplicaSets (det, der for nylig er blevet udtrukket), samt planlægger at scanne Helm-udgivelser og udvælge de seneste billeder derfra.
… og laver en whitelist ud fra dette sæt — en liste over billeder, som vi ikke vil slette. Alt andet renses, hvorefter vi finder forældreløse stage-billeder og sletter dem også.
Deploy-stadiet
Pålidelig deklarativitet
Det første punkt, jeg gerne vil påpege i deploy-processen, er udrulningen af den opdaterede ressourcekonfiguration, som er erklæret deklarativt. Det originale YAML-dokument, der beskriver Kubernetes-ressourcer, varierer ofte betydeligt fra resultatet af det, der rent faktisk kører i klyngen. Fordi Kubernetes tilføjer til konfigurationen:
- identifikatorer;
- systemoplysninger;
- mange standardværdier;
- sektion med nuværende status;
- ændringer foretaget inden for admission webhook's arbejde;
- resultatet af arbejdet fra forskellige controllere (og scheduler).
Derfor, når en ny ressourcekonfiguration opstår (ny), kan vi ikke bare tage og overskrive den nuværende, "levende" konfiguration (live). For dette må vi sammenligne ny med den sidste anvendte konfiguration ("last-applied") og anvende den live fremkomne patch.
Denne tilgang kaldes 2-way merge. Den bruges for eksempel i Helm.
Der er også en 3-way merge, som adskiller sig ved at:
- ved sammenligning "last-applied" og ny, ser vi, hvad der er blevet slettet;
- ved sammenligning ny og live, ser vi, hvad der er blevet tilføjet eller ændret;
- den samlede patch anvendes på live.
Vi deployer 1000+ applikationer med Helm, så vi lever faktisk med 2-way merge. Dog har det en række problemer, som vi har løst med vores patches, der hjælper Helm med at fungere korrekt.
Den faktiske udrulningsstatus
Efter at vores CI-system har genereret en ny konfiguration for Kubernetes i forbindelse med et begivenhed, sender det den til anvendelse (apply) i klyngen — ved hjælp af Helm eller kubectl apply. Derefter foregår det allerede beskrevne N-way merge, hvortil Kubernetes API positivt svarer CI-systemet, og det — til sin bruger.
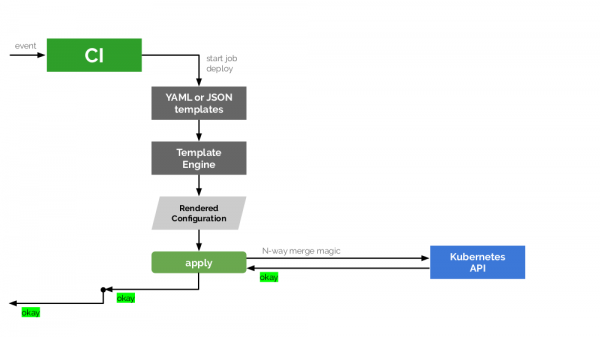
Men der er et stort problem: for lykkes anvendelse ikke nødvendigvis medfører en vellykket udrulning.. Hvis Kubernetes har forstået, hvilke ændringer der skal anvendes, og anvender dem — ved vi stadig ikke, hvad resultatet vil blive. For eksempel kan opdateringen og genstarten af pods i frontend'en forløbe uden problemer, mens det ikke gør det i backend'en, og vi får forskellige versioner af de kørende applikationsbilleder.
For everything to be done correctly, there is a need for an additional link in this scheme — a special tracker that will receive information about the status from the Kubernetes API and transmit it for further analysis of the real situation. We created an Open Source library in Go — (see its announcement ), — which solves this problem and is integrated into werf.
The behavior of this tracker at the level of werf is configured using annotations that are placed on Deployments or StatefulSets. The main annotation is fail-mode — understands the following values:
-
IgnoreAndContinueDeployProcess— ignore issues with the deployment of this component and continue the deploy; -
FailWholeDeployProcessImmediately— an error in this component stops the deploy process; -
HopeUntilEndOfDeployProcess— hoping that this component will work by the end of the deploy.
For example, such a combination of resources and annotation values. fail-mode:
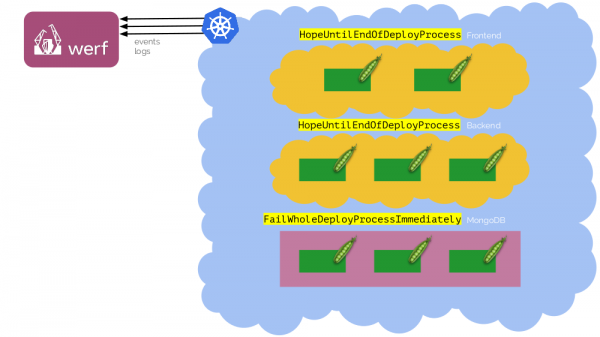
When deploying for the first time, the database (MongoDB) may not be ready yet — the Deployments will fail. But you can wait for it to start, and the deploy will still pass.
There are also two additional annotations for kubedog in werf:
-
failures-allowed-per-replica— the number of allowed failures per replica; -
show-logs-until— regulates the moment until which werf displays (in stdout) logs from all deploying pods. By default, this isPodIsReady(to ignore messages that we are unlikely to need when a pod starts receiving traffic), however, the valuesControllerIsReadyogEndOfDeploy.
What else do we want from the deploy?
In addition to the two points already described, we would like to:
- see logs — only the necessary ones, not all of them;
- track progress, because if a job is "silently" hanging for a few minutes, it's important to understand what's happening;
- have automatic rollback in case something goes wrong (and it's therefore critical to know the real status of the deploy). The rollout must be atomic: either it goes through to the end, or everything returns to the previous state.
Resumé
As a company, for implementing all the described nuances at different stages of delivery (build, publish, deploy), we only need a CI system and the utility .
In conclusion:
With werf, we have made good progress in solving a significant number of DevOps engineers' problems, and we would be happy if the broader community at least tries this utility in action. Achieving good results together will be easier.
Video og slides
Video of the presentation (~47 minutes):
Præsentation af oplægget:
P.S.
Andre rapporter om Kubernetes i vores blog:
- «» (Dmitrij Stoljarev; 27. april 2019 på «Stak»);
- «» (Andrej Polovov; 8. april 2019 på Saint HighLoad++);
- «» (Dmitrij Stoljarev; 8. november 2018 på HighLoad++);
- «» (Dmitry Stolyarov; 28. maj 2018 på RootConf);
- «» (Dmitry Stolyarov; 7. november 2017 på HighLoad++);
- «» (Dmitry Stolyarov; 6. juni 2017 på RootConf).
Kilde: habr.com
