

Pavel Selivanov, løsninger arkitekt ved Southbridge og lærer hos Slurm, holdt et foredrag på DevOpsConf 2019. Dette foredrag er en del af et af emnerne i det avancerede kursus om Kubernetes "Slurm Mega".
finder sted i Moskva den 18.-20. november.
— Moskva, 22.-24. november.
er altid tilgængelig.
Under cutten – transskription af foredraget.
Goddag, kolleger og sympathiserende. I dag vil jeg tale om sikkerhed.
Jeg kan se, at der i dag er mange sikkerhedsfolk i salen. Jeg undskylder på forhånd, hvis jeg bruger termer fra sikkerhedsverdenen ikke helt som I plejer.
Det skete således, at for omkring et halvt år siden fik jeg fat i en offentlig Kubernetes-klynge. Offentlig — betyder, at der er et antal namespaces, i disse namespaces er der brugere, isoleret i deres egen namespace. Alle disse brugere tilhører forskellige virksomheder. Nå, og det var meningen, at denne klynge skulle bruges som CDN. Det vil sige, at de giver dig en klynge, giver dig en bruger, du går ind i din namespace, og deployer dine frontend.
Mit tidligere firma forsøgte at sælge en sådan tjeneste. Og jeg blev bedt om at teste klyngen for at se, om denne løsning var passende eller ej.
Jeg kom ind i denne klynge. Jeg fik begrænsede rettigheder, begrænset namespace. Drenge der forstod, hvad sikkerhed var. De havde læst, hvad Role-based access control (RBAC) er i Kubernetes – og de havde sat det op sådan, at jeg ikke kunne starte pods adskilt fra deployments. Jeg kan ikke huske opgaven, jeg forsøgte at løse ved at starte en pod uden deployment, men jeg havde virkelig lyst til bare at starte en pod. Jeg besluttede at se, hvilke rettigheder jeg havde i klyngen, hvad jeg kunne, hvad jeg ikke kunne, og hvad de havde sat op. Samtidig vil jeg fortælle, hvad der var indstillet forkert i deres RBAC.
Det lykkedes mig, at to minutter senere fik jeg admin-rettigheder til deres klynge, kiggede i alle nabonamespaces, og så de kørende produktionsfrontender fra virksomheder, der allerede havde købt tjenesten og deployet sig. Jeg måtte stoppe mig selv for ikke at gå ind til nogen i fronten og placere et bandeord på hovedsiden.
Jeg vil forklare med eksempler, hvordan jeg gjorde det, og hvordan man skal beskytte sig imod det.
Men skal jeg starte med at præsentere mig. Mit navn er Pavel Selivanov. Jeg er arkitekt hos Southbridge. Jeg har ekspertise inden for Kubernetes, DevOps og andre trendy teknologier. Sammen med ingeniørerne hos Southbridge opbygger vi alt dette, mens jeg rådgiver.
Udover vores primære aktiviteter har vi for nylig lanceret projekter, der kaldes Slürmer. Vi forsøger at bringe vores evne til at arbejde med Kubernetes ud til folket og lære andre mennesker at arbejde med K8s.
Hvad vil jeg tale om i dag. Emnet for mit oplæg er klart — sikkerhed i Kubernetes-klynger. Men jeg vil straks sige, at dette emne er meget omfattende — og derfor vil jeg straks præcisere, hvad jeg bestemt ikke vil tale om. Jeg vil ikke tale om de overused begreber, som allerede er blevet mast igennem på internettet. Alt det der RBAC og certifikater.
Jeg vil tale om, hvad jeg og mine kolleger bekymrer os om, når det kommer til sikkerheden i Kubernetes-klynger. Vi ser disse problemer både hos udbydere, der tilbyder Kubernetes-klynger, og hos kunder, der henvender sig til os. Selv kunder, der kommer til os fra andre konsulentadministrative virksomheder. Så skalaen af tragedien er faktisk meget stor.
Lad mig præsentere tre punkter, som jeg vil tale om i dag:
- Brugerrettigheder vs pod-rettigheder. Brugerrettigheder og pod-rettigheder er ikke det samme.
- Indsamling af information om klyngen. Jeg vil vise, hvilken information der kan samles fra en klynge, uden at have specielle rettigheder i denne klynge.
- DoS-angreb på klyngen. Hvis vi ikke kan indsamle information, kan vi stadig bringe klyngen ned. Jeg vil tale om DoS-angreb på de styrende elementer i klyngen.
En anden generel ting, jeg vil nævne — hvad jeg har testet dette på, og hvad jeg kan sige fungerer.
Vi tager udgangspunkt i installationen af en Kubernetes-klynge ved hjælp af Kubespray. Hvis nogen ikke ved, hvad det er, så er det faktisk en samling roller til Ansible. Vi bruger det konstant i vores arbejde. Det er godt, fordi det kan installeres hvor som helst — både på fysisk hardware og i skyen. En installationsmetode fungerer generelt overalt.
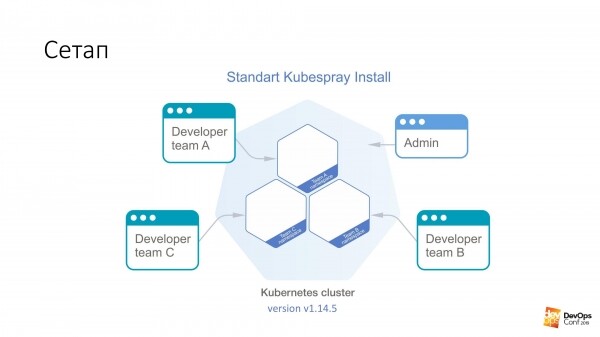
I denne klynge vil jeg have Kubernetes v1.14.5. Hele Kubernetes-klyngen, som vi vil overveje, er opdelt i namespaces, hvor hver namespace tilhører et separat team, og medlemmerne af dette team har adgang til deres eget namespace. De kan ikke gå ind i andre namespaces, kun deres eget. Men der findes en admin-konto, som har rettigheder til hele klyngen.
Jeg lovede, at det første, vi skulle gøre, var at få admin-rettigheder til klyngen. Vi har brug for en specielt forberedt pod, som skal bryde klyngen i Kubernetes. Alt, hvad vi skal gøre, er at anvende den i Kubernetes-klyngen.
kubectl apply -f pod.yamlDenne pod vil komme til en af masterne i Kubernetes-klyngen. Efter dette vil klyngen gladeligt returnere en fil, der hedder admin.conf. I denne fil gemmes alle admin-certifikater, og API'en for klyngen er desuden konfigureret. Sådan kan man nemt få admin-adgang, jeg vil sige til 98% af Kubernetes-klynger.
Jeg gentager, denne pod blev lavet af en udvikler i din klynge, som har adgang til at implementere sine forslag i en lille namespace, han er helt begrænset af RBAC. Han havde ingen rettigheder. Men alligevel kom certifikatet tilbage.
Og nu til den specielt forberedte pod. Vi kører den på en hvilken som helst image. For eksempel vil vi tage debian:jessie.
Vi har noget som dette:
tolerations:
-   effect: NoSchedule
    operator: Exists
nodeSelector:
    node-role.kubernetes.io/master: ""
Hvad er en toleration? Masterne i Kubernetes-klyngen er normalt markeret med noget, der kaldes taint. Essensen af denne 'taint' er, at pod'er ikke kan tildeles til master-noder. Men ingen forhindrer os i at angive i enhver pod, at den er tolerant over for 'taint'. Toleration-sektionen siger netop, at hvis der er NoSchedule på en node, er vores pod tolerant over for denne taint — og der er ingen problemer.
Derudover siger vi, at vores pod ikke bare er tolerant, men også ønsker at gå specifikt til masteren. Fordi de mest værdifulde ting, vi har brug for, findes på masterne — alle certifikaterne. Derfor angiver vi nodeSelector — og vi har en standardlabel på masterne, der tillader os at vælge de noder fra hele klyngen, som er mastere.
Med disse to sektioner vil pod'en helt sikkert komme til masteren. Og den vil få lov til at bo der.
Men det er ikke nok bare at komme til masteren. Det giver os ikke noget. Derfor har vi to ting mere:
hostNetwork: true
hostPID: true
Vi angiver, at vores pod, som vi kører, vil leve i kernens namespace, i netværks-namespace og i PID-namespace. Så snart pod'en kører på masteren, vil den kunne se alle de rigtige, levende interfaces på denne node, lytte til al trafik og se PID for alle processer.
Næste skridt er enkelt. Tag etcd og læs, hvad du ønsker.
Det mest interessante er denne mulighed i Kubernetes, som er til stede som standard.
volumeMounts:
- mountPath: /host
  name: host
volumes:
- hostPath:
    path: /
    type: Directory
  name: host
Og essensen er, at vi i pod'en, som vi kører, selv uden rettigheder til denne klynge, kan sige, at vi ønsker at oprette et volume af typen hostPath. Det vil sige, tage stien fra værten, hvori vi vil køre — og tage den som et volume. Og så giver vi det navnet: host. Hele denne hostPath monterer vi inde i pod'en. I dette eksempel i mappen /host.
Jeg gentager. Vi sagde til pod'en at komme til masteren, få hostNetwork og hostPID — og montere hele roden fra masteren ind i denne pod.
Du forstår, at vi har bash kørende i debian, og denne bash kører som root. Det vil sige, at vi lige har fået root-adgang til masteren uden at have nogen slags rettigheder i Kubernetes-klyngen.
Dernæst er hele opgaven at gå ind i pod'en i mappen /host /etc/kubernetes/pki, hvis jeg ikke tager fejl, og hente alle masterens certifikater fra klyngen og dermed blive admin på klyngen.
Ser man det sådan, er det nogle af de mest farlige rettigheder i pods — uanset hvad rettigheder brugeren har:
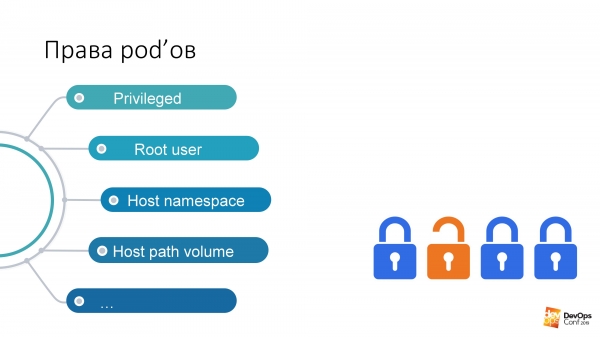
Hvis jeg har ret til at starte en pod i et bestemt namespace af klyngen, så har denne pod som standard de samme rettigheder. Jeg kan starte privilegerede pods, og det er i praksis alle rettigheder, næsten root på noden.
Mit favorit er Root-bruger. Og Kubernetes har denne mulighed, Run As Non-Root. Det er en slags beskyttelse mod hackere. Ved du, hvad et 'moldovisk virus' er? Hvis du er hacker og er kommet ind i min Kubernetes-klynge, så beder vi, de stakkels administratorer: 'Angiv venligst i dine pods, som du vil hacke min klynge med, run as non-root. Ellers risikerer du at køre en proces i din pod som root, og det vil gøre det meget nemt at hacke mig. Beskyt dig selv, tak.'
Host path volume — efter min mening den hurtigste måde at opnå det ønskede resultat fra Kubernetes-klyngen.
Men hvad skal man gøre med alt dette?
Tankerne, der bør komme til enhver normal administrator, der står over for Kubernetes: "Åh, jeg sagde det, Kubernetes fungerer ikke. Der er huller i det. Og hele Kubernetes er skrammel." I virkeligheden findes der noget, der hedder dokumentation, og hvis man kigger der, er der et afsnit .
Dette er et yaml-objekt — vi kan oprette det i Kubernetes-klassen — som kontrollerer sikkerhedsaspekter specifikt ved beskrivelsen af pods. Det vil sige, at det faktisk kontrollerer de rettigheder til at bruge forskellige hostNetwork, hostPID, bestemte typer volume, der findes i pods, når de startes. Ved hjælp af Pod Security Policy kan alt dette beskrives.
Det mest interessante ved Pod Security Policy er, at PSP-installationerne i Kubernetes-klassen ikke er beskrevet på nogen måde, de er simpelthen slukket som standard. Pod Security Policy aktiveres ved hjælp af en admission plugin.
Okay, lad os deployere Pod Security Policy til klassen og sige, at vi har nogle administrative pods i et namespace, som kun administratorer har adgang til. Lad os sige, at i alle andre pods har begrænsede rettigheder. For det er sandsynligvis ikke nødvendig for udviklerne at køre privilegerede pods i din klasse.
Og alt ser ud til at være i orden. Og vores Kubernetes-klasse kan ikke hacked på to minutter.
Der er et problem. Sandsynligvis, hvis du har en Kubernetes-klasse, så er der installeret overvågning i din klasse. Jeg tør endda forudsige, at hvis der er overvågning i din klasse, så hedder den Prometheus.
Det, jeg nu vil fortælle, vil være gyldigt både for Prometheus-operatøren og for Prometheus, der er sat op i sin reneste form. Spørgsmålet er, at hvis jeg ikke hurtigt kan få en administrator i klassen, betyder det, at jeg skal lede mere. Og jeg kan lede ved hjælp af din overvågning.
Sandsynligvis har alle læst de samme artikler på Habré, og overvågningen findes i namespace'et monitoring. Helm-chartet kaldes næsten det samme af alle. Jeg antager, at hvis du laver helm install stable/prometheus, vil du få cirka de samme navne. Og det er endda sandsynligt, at DNS-navnet i din klasse ikke skal gætte. For det er standard.
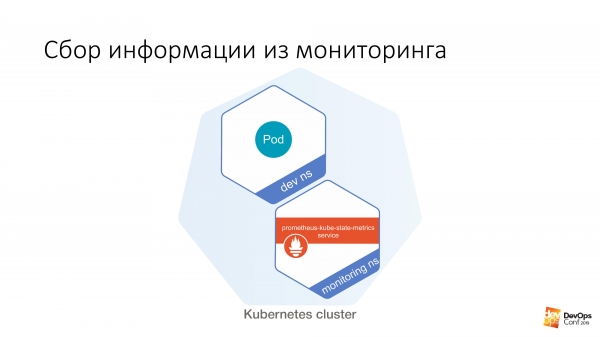
Videre har vi et slags dev ns, i hvilket man kan starte en slags pod. Og derfra er det meget let at gøre sådan her:
$ curl http://prometheus-kube-state-metrics.monitoring prometheus-kube-state-metrics er en af Prometheus' eksportører, der indsamler metrics fra Kubernetes API'en selv. Der er mange data om, hvad der kører i din klynge, hvordan det er, og hvilke problemer du måtte have med det.
Som et simpelt eksempel:
kube_pod_container_info{namespace="kube-system",pod="kube-apiserver-k8s-1",container="kube-apiserver",image=
"gcr.io/google-containers/kube-apiserver:v1.14.5"
,image_id="docker-pullable://gcr.io/google-containers/kube-apiserver@sha256:e29561119a52adad9edc72bfe0e7fcab308501313b09bf99df4a9638ee634989",container_id="docker://7cbe7b1fea33f811fdd8f7e0e079191110268f2853397d7daf08e72c22d3cf8b"} 1
Ved at lave en simpel curl-forespørgsel fra en ikke-privilegeret pod kan du få sådan en information. Hvis du ikke ved, hvilken version af Kubernetes du kører, så kan den nemt fortælle dig det.
Og det mest interessante er, at udover at du tilgår kube-state-metrics, kan du ligeså godt tilgå Prometheus direkte. Du kan indsamle metrics derfra. Du kan endda bygge metrics derfra. Teoretisk set kan du bygge en forespørgsel fra klyngen til Prometheus, som simpelthen slukker den. Og din overvågning vil overhovedet stoppe med at fungere.
Og her opstår spørgsmålet, overvåger nogen ekstern overvågning din overvågning. Lige nu har jeg fået mulighed for at agere i Kubernetes-klyngen uden konsekvenser for mig selv. Du vil ikke engang vide, at jeg handler der, da overvågningen allerede er væk.
Ligesom med PSP, opstår der en følelse af, at problemet er, at alle disse trendy teknologier — Kubernetes, Prometheus — de virker bare ikke og er fulde af huller. Men det gør de ikke.
Der er sådan en ting — .
Hvis du er en normal administrator, så ved du sandsynligvis, at Network Policy er endnu en yaml, der allerede findes i klyngen. Og nogle Network Policies er bestemt ikke nødvendige. Selvom du har læst om, hvad en Network Policy er, at det er en yaml-firewall i Kubernetes, som begrænser adgangen mellem namespaces og pods, så har du helt sikkert besluttet, at en firewall i yaml-format i Kubernetes er bare endnu en abstraktion… Nej, det er slet ikke nødvendigt.
Selv hvis dine sikkerhedsspecialister ikke har fået fortalt, at du nemt og enkelt kan bygge en meget granular firewall ved hjælp af din Kubernetes, hvis de ikke ved dette endnu, og ikke trykker på: «Lad os få det...». Så er Network Policy noget, du har brug for, for at lukke adgangen til visse services, som kan tilgås fra din klynge uden nogen form for autorisation.
Som i det eksempel, jeg nævnte, kan man tilgå kube state metrics fra enhver namespace i Kubernetes-klyngen uden at have nogen rettigheder til det. Network policies har lukket adgangen fra alle andre namespaces til overvågningsnamespace, og som sådan: ingen adgang, ingen problemer. I alle chartene, der findes, både den standard Prometheus og den Prometheus, der er i operatoren, er der blot en mulighed i Helm values for at aktivere network policies for dem. Du skal blot aktivere det, så vil det fungere.
Der er dog ét problem. Som en ordentlig bearded admin har du nok besluttet, at network policies ikke er nødvendige. Og efter at have læst forskellige artikler på ressourcer som Habr, har du besluttet, at flannel, især med host-gateway mode, er det bedste, du kan vælge.
Hvad skal man gøre?
Du kan prøve at redeploye den netværksløsning, du har i din Kubernetes-klynge, og forsøge at erstatte den med noget mere funktionelt. Det samme Calico, for eksempel. Men jeg vil straks sige, at opgaven at skifte netværksløsningen i en arbejds-Kubernetes-klynge er ganske ikke-triviel. Jeg har løst den to gange (begge gange teoretisk), men vi har endda på Slyerma vist, hvordan man gør det. For vores studerende har vi vist, hvordan man skifter netværksløsning i en Kubernetes-klynge. Du kan principielt prøve at gøre det, så der ikke er nedetid på produktionsklyngen. Men sandsynligvis vil du ikke have held.
Og problemet løses faktisk meget enkelt. I klyngen findes der certifikater, og du ved, at dine certifikater udløber om et år. Nå, og den normale løsning med certifikater i klyngen er – hvorfor skal vi bryde os om det, vi kan oprette en ny klynge ved siden af, lad den gamle være, indtil den udløber, og så redeployer vi alt. Sandt nok, når den udløber, vil vi have en dag, hvor alt ligger ned, men vi har i det mindste en ny klynge.
Når du opretter den nye klynge, så indsæt Calico i stedet for flannel.
Hvad skal man gøre, hvis du har certifikater udstedt i hundrede år, og du ikke planlægger at genudrulle klyngen? Der findes noget kaldet Kube-RBAC-Proxy. Det er en ret smart løsning, som gør det muligt at integrere sig selv som en sidecar-container til en hvilken som helst pod i Kubernetes-klyngen. Og den tilføjer faktisk godkendelse via RBAC fra Kubernetes til denne pod.
Der er et problem. Tidligere var denne Kube-RBAC-Proxy-løsning indbygget i Prometheus-operatoren. Men det findes ikke længere. Moderne versioner forudsætter, at du har netværkspolitikker, og at du lukker af med dem. Så du bliver nødt til at omskrive diagrammet en smule. Hvis du går ind i , vil der være eksempler på, hvordan dette kan bruges som sidecars, og diagrammerne skal kun omskrives minimalt.
Der er et andet lille problem. Ikke kun Prometheus giver sine metrikker til hvem som helst. Alle komponenterne i Kubernetes-klyngen kan også sende deres egne metrikker.
Men som jeg allerede har sagt, hvis du ikke kan få adgang til klyngen og indsamle information, kan du i det mindste skabe nogen skade.
Så jeg vil hurtigt vise to måder, hvordan man kan skade sundheden af Kubernetes-klyngen.
Du vil grine, når jeg fortæller det, det er to tilfælde fra virkeligheden.
Første metode. Udnyttelse af ressourcer.
Vi starter en anden speciel pod. Den vil have sådan en sektion.
resources:
    requests:
        cpu: 4
        memory: 4Gi
Som du ved, er requests den mængde CPU og hukommelse, der reserveres på værten for specifikke pods med requests. Hvis vi har en firekernet vært i Kubernetes-klyngen, og der ankommer en pod med requests på fire CPU'er, så kan der ikke ankomme flere pods med requests til denne vært.
Hvis jeg lancerer en sådan pod, og derefter udfører kommandoen:
$ kubectl scale special-pod --replicas=...Så vil ingen andre kunne deploye til Kubernetes-klyngen. Fordi alle noder vil løbe tør for requests. Og på den måde vil jeg stoppe din Kubernetes-klynge. Hvis jeg gør det om aftenen, kan jeg stoppe deployeringen i ret lang tid.
Hvis vi ser endnu en gang i Kubernetes-dokumentationen, vil vi se noget, der hedder Limit Range. Det fastsætter ressourcer for klyngeobjekter. Du kan skrive et Limit Range-objekt i yaml, anvende det i bestemte namespaces – og derefter kan du angive, at du har standard, maksimale og minimale ressourcer til pods i dette namespace.
Med en sådan ordning kan vi begrænse brugerne i specifikke produkt-namespace til at angive alt muligt snavs i deres pods. Men desværre, selvom du siger til brugeren, at de ikke må starte pods med requests større end én CPU, er der en fantastisk kommando kaldet scale, eller de kan gøre det gennem dashboardet.
Og herfra kommer den anden metode. Vi starter 11 111 111 111 111 pods. Det er elleve milliarder. Det er ikke, fordi jeg har fundet på det tal, men fordi jeg selv har set det.
En sand historie. Senere om aftenen var jeg allerede ved at forlade kontoret. Jeg ser en gruppe udviklere sidde sammen i hjørnet og gøre noget nervøst med deres bærbare computere. Jeg nærmer mig dem og spørger: «Hvad er der sket?»
Tidligere, omkring kl. 21, havde en af udviklerne tænkt sig at tage hjem. Og besluttede: «Jeg vil skalere min applikation til én.» Han trykkede på én, men internettet var lidt langsomt. Han trykkede igen på én, han trykkede på én, klikkede på Enter. Han trykkede på alt, hvad han kunne. Så blev internettet levende – og alt begyndte at skalere til dette tal.
Faktisk foregik denne historie ikke på Kubernetes, det var på det tidspunkt Nomad. Det sluttede med, at efter en times forsøg på at stoppe Nomad fra sin insisterende skalering, svarede Nomad, at den ikke ville stoppe med at skalere og ikke ville lave noget andet. «Jeg er træt, jeg går.» Og lukkede ned.
Jeg forsøgte naturligvis at gøre det samme på Kubernetes. Elleve milliarder pods glædede ikke Kubernetes, den sagde: «Jeg kan ikke. Overskrider interne grænser.» Men 1 000 000 000 pods kunne den håndtere.
Som svar på en milliard pods i sig selv, er han virkelig begyndt at skalere. Jo længere processen skred frem, desto mere tid brugte han på at oprette nye pods. Men processen gik stadig. Det eneste problem er, at hvis jeg kan køre pods uden begrænsninger i mit namespaces, kan jeg selv uden requests og limits starte et sådant antal pods med nogle opgaver, at noderne begynder at kollapsere på grund af hukommelse og CPU. Når jeg starter så mange pods, skal informationen fra dem gemmes i lagringen, det vil sige etcd. Og når der kommer for meget information derind, begynder lagringen at returnere for langsomt - og Kubernetes oplever flaskehalse.
Men der er endnu et problem... Som I ved, er Kubernetes kontrolmoduler ikke bare én central ting, men flere komponenter. Herunder er der controller manager, scheduler osv. Alle disse drenge vil begynde at udføre unødvendigt og meningsløst arbejde samtidig, som med tiden vil tage mere og mere tid. Controller manageren vil oprette nye pods. Scheduler vil forsøge at finde en ny node til dem. Nye noder i jeres klynge vil snart være opbrugt. Kubernetes-klyngen vil begynde at arbejde langsommere og langsommere.
Men jeg besluttede at tage det et skridt videre. Som I ved, i Kubernetes er der noget, der kaldes en service. Og som standard fungerer servicen sandsynligvis i jeres klynger ved hjælp af IP tables.
Hvis man starter en milliard pods, for eksempel, og derefter med et lille script får Kubernetes til at oprette nye services:
for i in {1..1111111}; do
    kubectl expose deployment test --port 80
        --overrides="{"apiVersion": "v1",
           "metadata": {"name": "nginx$i"}}";
done
På alle noder i klyngen vil der omtrent samtidigt blive genereret nye og nye iptables-regler. Hver service vil generere én milliard iptables-regler.
Jeg har testet det hele med et par tusinde, op til ti. Og problemet er, at allerede ved dette niveau er det ret problematisk at SSH'e ind på noden. Fordi pakkerne, der passerer gennem så mange kæder, begynder at få det lidt skidt.
Og det hele kan også løses ved hjælp af Kubernetes. Der findes et objekt kaldet Resource quota. Det fastsætter antallet af tilgængelige ressourcer og objekter for et namespace i klyngen. Vi kan oprette et yaml-objekt i hvert namespace i Kubernetes-klyngen. Ved hjælp af dette objekt kan vi angive, at der er afsat et bestemt antal requests og limits til dette namespace, og derefter kan vi sige, at der i dette namespace kan oprettes 10 services og 10 pods. Og udvikleren kan gøre hvad som helst i aftentimerne. Kubernetes vil sige til ham: "Du kan ikke skalere dine pods op til det antal, fordi det overskrider ressourcekvoten." Problemet er løst. .
Et problem opstår i den forbindelse. Du kan mærke, hvor svært det bliver at oprette et namespace i Kubernetes. For at oprette det skal vi tage højde for en masse ting.
Resource quota + Limit Range + RBAC
• Opretter namespace
• Opretter limitrange indeni
• Opretter resourcequota indeni
• Opretter serviceaccount til CI
• Opretter rolebinding til CI og brugere
• Valgfrit kan der startes de nødvendige tjenester i pods
Derfor vil jeg benytte lejligheden til at dele mine udviklinger. Der findes noget, der hedder operator SDK. Det er en måde at skrive operatorer til Kubernetes-klyngen. Du kan skrive operatorer ved hjælp af Ansible.
Først havde vi skrevet det med Ansible, men så så jeg, at der er en operator SDK og skrev Ansible-rollen om til en operator. Denne operator gør det muligt at oprette et objekt i Kubernetes-klyngen, som hedder en kommando. Inden for kommandoen giver det mulighed for at beskrive et yaml-miljø til denne kommando. Og inden for miljøet for kommandoen giver det mulighed for at beskrive, at vi tildeler så mange ressourcer.
Lille .
Og til sidst. Hvad skal vi gøre med alt dette?
For det første. Pod Security Policy — det er godt. Og selvom ingen af Kubernetes-installatørerne bruger dem til dato, bør de alligevel anvendes i jeres klynger.
Network Policy — det er ikke bare en unødvendig funktion. Det er noget, der virkelig er nødvendigt i klyngen.
LimitRange/ResourceQuota — det er på tide at bruge. Vi begyndte for længe siden at anvende dette, og jeg var længe overbevist om, at alle anvendte det. Det viste sig at være sjældent.
Udover det, jeg nævnte i mit foredrag, er der udocumenterede funktioner, der muliggør angreb på klyngen. For nylig kom der en .
Nogle ting er så triste og frustrerende. For eksempel, under visse omstændigheder kan kubelets i Kubernetes-klyngen returnere indholdet af warlocks-mappen til uautoriserede brugere.
Der ligger instruktioner om, hvordan man genskaber alt, hvad jeg har talt om. Der ligger filer med produktionsudgaver, som viser, hvordan ResourceQuota og Pod Security Policy ser ud. Og alt dette kan man røre ved.
Tak til alle.
Kilde: habr.com
