

Jeg deler mine personlige erfaringer om, hvad der har været nyttigt, hvornår og hvor. En overordnet og punktformet oversigt, så det er klart, hvad man kan udforske videre — men dette er udelukkende baseret på mine subjektive oplevelser; det kan være, at din oplevelse er helt anderledes.
Hvorfor er det vigtigt at kende og kunne håndtere forespørgselssprog? I Data Science er der grundlæggende flere vigtige faser i arbejdet, og den første og mest afgørende (uden den vil intet fungere!) — er indsamlingen eller udvindingen af data. Oftest ligger data et eller andet sted, og de skal 'hentes' derfra.
Forespørgselssprog er netop det, der gør det muligt at udvinde disse data! I dag vil jeg tale om de forespørgselssprog, som jeg har haft brug for og vise, hvor og hvordan — og hvorfor det er nødvendigt at lære dem.
Der vil være tre hovedtyper af forespørgsler til data, som vi vil gennemgå i denne artikel:
- ‘Standard’ forespørgselssprog — det, som folk normalt tænker på, når de taler om forespørgselssprog, som for eksempel relationsalgebra eller SQL.
- Scripttype forespørgselssprog: for eksempel Python-værktøjer som pandas, numpy eller shell scripting.
- Forespørgselssprog til vidensgrafen og grafdatabaser.
Alt, hvad der er skrevet her, er blot mine personlige erfaringer om, hvad der har været nyttigt, med beskrivelser af situationer og 'hvorfor de var nødvendige' — enhver kan overveje, hvorvidt sådanne situationer kan opstå for dem og forsøge at forberede sig på dem, ved at sætte sig ind i disse sprog, inden de skal anvendes (i en hast) på et projekt eller overhovedet komme ind i et projekt, hvor de er nødvendige.
‘Standard’ forespørgselssprog
Standard forespørgselssprog netop i den forstand, at vi normalt tænker på dem, når vi taler om forespørgsler.
Relationsalgebra
Hvorfor er relationsalgebra vigtig i dag? For at få en god forståelse for, hvorfor forespørgselssprog er bygget op på en bestemt måde, og at bruge dem bevidst, skal man forstå kernen bag.
Hvad er relationsalgebra?
En formel definition er sådan: relationsalgebra er et lukket system af operationer på relationer i det relationelle datamodel. Hvis vi siger det lidt mere menneskeligt, er det et system af operationer på tabeller, sådan at resultatet også altid er en tabel.
Se alle relationelle operationer i artiklen fra Habr — her beskriver vi, hvorfor det er vigtigt at vide, og hvor det bruges.
Hvorfor?
Man begynder at forstå, hvad forespørgselsprogene består af, og hvilke operationer der ligger bag de specifikke forespørgselsprog — det giver ofte en dybere forståelse af, hvad og hvordan tingene fungerer i forespørgselsprog.
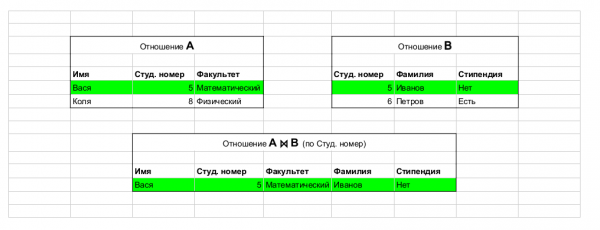
Udtaget fra artikler. Et eksempel på en operation: join, som forbinder tabeller.
Materialer til studiet:
. Generelt er der mange materialer om relationel algebra og teori — Coursera, Udacity. Der er også et væld af materialer online, inklusive gode . Mit personlige råd: man skal forstå relationel algebra meget godt — det er grundlaget.
SQL
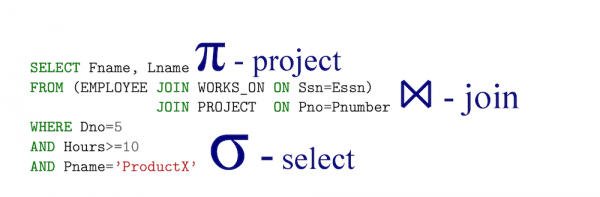
Udtaget fra af artiklen.
SQL er i sin essens en implementering af relationel algebra — med den vigtige bemærkning, at SQL er deklarativt! Det vil sige, at når du skriver en forespørgsel i relationel algebra, siger du faktisk, hvordan det skal beregnes — men med SQL angiver du, hvad du ønsker at hente, og derefter genererer databasesystemet (effektive) udtryk i relationel algebra (deres ækvivalens kender vi fra ).
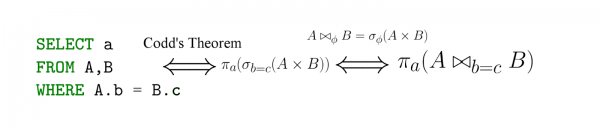
Udtaget fra af artiklen.
Hvorfor?
Relationelle databasesystemer: Oracle, Postgres, SQL Server osv. — er stadig stort set overalt, og chancen for, at du skal interagere med dem, er utrolig stor, hvilket betyder, at du enten skal læse SQL (hvilket er meget sandsynligt) eller skrive i det (også ikke usandsynligt).
Hvad skal man læse og studere
På de samme links ovenfor (om relationel algebra) findes der en utrolig mængde materiale, for eksempel .
Forresten, hvad er NoSQL?
"Det skal endnu en gang understreges, at termen 'NoSQL' har en fuldstændig spontan oprindelse og ikke har nogen anerkendt definition eller videnskabelig institution bag sig." Den relevante på Habr.
I bund og grund indså folk, at den fulde relationelle model ikke var nødvendig for at løse mange opgaver, især dem, hvor ydeevne er principielt og dominerer visse enkle forespørgsler med aggregater — det er kritisk at beregne metrics hurtigt og skrive dem i databasen, og de fleste funktioner i relationel algebra viste sig ikke kun at være unødvendige, men også skadelige — hvorfor normalisere noget, hvis det vil skade det, der er vigtigst for os (for en bestemt opgave) — ydeevnen?
Der er også ofte behov for fleksible skemaer i stedet for faste matematiske skemaer fra den klassiske relationelle model - og det gør det utrolig nemmere at udvikle applikationer, når det er kritisk at implementere systemet og komme i gang hurtigt med at bearbejde resultaterne - eller skemaet og typerne af lagrede data er ikke så vigtige.
For eksempel skaber vi et ekspertssystem og ønsker at opbevare information om et bestemt domæne sammen med noget metadata - vi kender måske ikke alle felter og kan simpelthen gemme JSON for hver post - det giver os et meget fleksibelt miljø til at udvide datamodellen og hurtigt iterere - derfor vil NoSQL i dette tilfælde være endda at foretrække og mere læsbart. Et eksempel på en post (fra et af mine projekter, hvor NoSQL var præcis der, hvor det var nødvendigt).
{"en_wikipedia_url":"https://en.wikipedia.org/wiki/Johnny_Cash",
"ru_wikipedia_url":"https://ru.wikipedia.org/wiki/?curid=301643",
"ru_wiki_pagecount":149616,
"entity":[42775,"Джонни Кэш","ru"],
"en_wiki_pagecount":2338861}
Du kan læse mere om NoSQL.
Hvad skal man studere?
Her skal man hellere bare grundigt analysere sin opgave, hvilke egenskaber den har, og hvilke NoSQL-systemer der ville passe til denne beskrivelse - og så begynde at studere det pågældende system.
Scripting-sprog til forespørgsler
Først virker det som om, hvad har Python overhovedet med det at gøre - det er et programmeringssprog, og handler slet ikke om forespørgsler.
- Pandas er ligesom en schweizerkniv inden for Data Science, et stort antal datatransformationer, aggregeringer osv. finder sted i det.
- Numpy - vektorberegninger, matriser og lineær algebra er der.
- Scipy - meget matematik er i dette pakke, især statistik.
- Jupyter lab - meget exploratory data analysis passer godt ind i notebooks - det er nyttigt at kunne.
- Requests - arbejde med nettet.
- Pyspark - meget populært blandt dataingeniører, du vil sandsynligvis skulle interagere med dette eller Spark, simpelthen på grund af deres popularitet.
- *Selenium - meget nyttigt til indsamling af data fra websteder og ressourcer, nogle gange er der simpelthen ingen anden måde at få data på.
Mit hovedråd: Lær Python!
Pandas
Lad os tage følgende kode som eksempel:
import pandas as pd
df = pd.read_csv(“data/dataset.csv”)
# Beregn og omdøb aggregeringer
all_together = (df[df[‘trip_type’] == “return”]
    .groupby(['start_station_name','end_station_name'])
                  	    .agg({'trip_duration_seconds': [np.size, np.mean, np.min, np.max]})
                           .rename(columns={'size': 'num_trips',
           'mean': 'avg_duration_seconds',
           'amin': 'min_duration_seconds',
           ‘amax': 'max_duration_seconds'}))
I bundet ser vi, at koden passer ind i et klassisk SQL-mønster.
SELECT start_station_name, end_station_name, count(trip_duration_seconds) as size, …..
FROM dataset
WHERE trip_type = 'return'
GROUP BY start_station_name, end_station_name
Men den vigtige del er, at denne kode er en del af et script og et pipeline; faktisk integrerer vi forespørgsler i en Python-pipeline. I denne situation kommer forespørgssproget fra biblioteker som Pandas eller pySpark.
Generelt ser vi i pySpark en lignende type datatransformation gennem forespørgelsessproget som:
df.filter(df.trip_type = 'return')
  .groupby('day')
  .agg({duration: 'mean'})
  .sort()
Hvor og hvad man kan læse
Om selve Python generelt med at finde materialer til studier. Der er et væld af tutorials online om , og kurser om (og også om selve ). Generelt er materialerne lette at finde via Google, og hvis jeg skulle vælge én pakke at fokusere på, ville det selvfølgelig være pandas. Der er også .
Shell som forespørgelsessprog
Der er mange projekter relateret til databehandling og analyse, som jeg har arbejdet med — de er i bund og grund shell-scripts, der kalder Python-kode, Java og selve shell-kommandoerne. Derfor kan man generelt se på pipelines i bash/zsh/etc. som en slags højere niveau forespørgsel (man kan selvfølgelig også putte loops ind, men det er usædvanligt for DS-kode i shell-sprog). Lad os bringe et simpelt eksempel — jeg skulle lave mapping af QID fra Wikidata og de fulde links til den russiske og engelske wiki, til dette skrev jeg en simpel forespørgsel i bash og skrev et simpelt script i Python til output, som jeg samlede sådan her:
pv 'data/latest-all.json.gz' |
unpigz -c  |
jq --stream $JQ_QUERY |
python3 scripts/post_process.py 'output.csv'
hvor
JQ_QUERY = 'select((.[0][1] == "sitelinks" and (.[0][2]=="enwiki" or .[0][2] =="ruwiki") and .[0][3] =="title") or .[0][1] == "id")' Det var i bund og grund hele pipelinen, der skabte den ønskede mapping; som vi ser, kørte alt i streamingtilstand:
- pv filepath — giver en progress bar baseret på filens størrelse og sender indholdet videre
- unpigz -c læste en del af arkivet og sendte det til jq
- jq med nøglen — stream gav straks resultatet og sendte det videre til postprocessoren (ligesom i det første eksempel) i Python
- inde i postprocessoren — dette er en simpel tilstandsmaskine, der formaterede output
I alt er en kompleks pipeline, der fungerer i streaming-tilstand med store data (0,5 TB), uden betydelige ressourcer og lavet af en simpel pipeline og et par værktøjer.
Endnu et vigtigt tip: Vær god til at arbejde effektivt i terminalen og skrive på bash/zsh/etc.
Hvor er det nyttigt? Næsten overalt — der er VIRKELIG mange materialer til at studere på nettet. Især, her er min tidligere artikel.
R scripting
Igen kan læseren udbryde — men det er jo et helt programmeringssprog! Og det vil selvfølgelig have ret. Men jeg har typisk stødt på R i en sådan sammenhæng, at det faktisk ligner et forespørgselssprog.
R er et miljø for statistiske beregninger og et sprog til statistiske beregninger og visualisering (ifølge ).
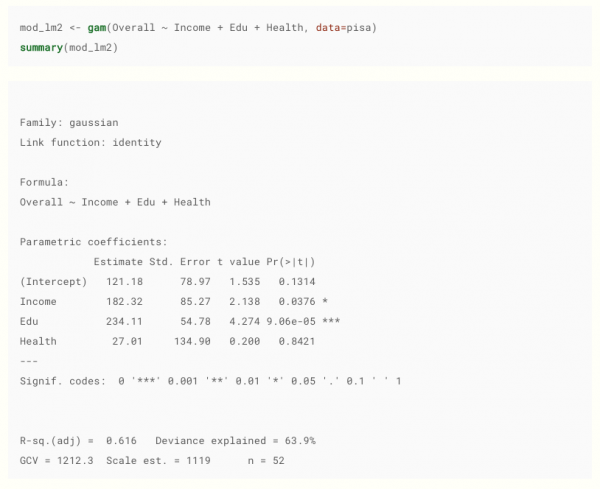
Hentet . Forresten, jeg anbefaler, det er et godt materiale.
Hvorfor skal en data scientist kende R? I hvert fald fordi der er en stor gruppe mennesker uden for IT, der arbejder med datanalyse i R. Jeg har set det i følgende områder:
- Den farmaceutiske sektor.
- Biologer.
- Den finansielle sektor.
- Mennesker med en ren matematisk uddannelse, der beskæftiger sig med statistik.
- Specialiserede statistiske modeller og maskinlæringsmodeller (som ofte kun kan findes i forfatterversioner som R-pakker).
Hvorfor er det faktisk et forespørgselssprog? I den form, det ofte præsenteres — det er faktisk en forespørgsel til at skabe en model, inklusive indlæsning af data og fastsættelse af parametre for forespørgslen (modellen), samt datavisualisering i pakkene som ggplot2 — det er også en form for at skrive forespørgsler.
Eksempel på forespørgsler til visualisering
ggplot(data = beav,
       aes(x = id, y = temp,
           group = activ, color = activ)) +
  geom_line() +
  geom_point() +
  scale_color_manual(values = c("red", "blue"))
Generelt er mange ideer fra R blevet overført til Python-pakker som pandas, numpy eller scipy, som dataframes og vektorisering af data — derfor vil mange ting i R virke kendte og bekvemme for dig.
Der er mange kilder til at studere, for eksempel, .
Viden graf (Knowledge graph)
Her har jeg en lidt usædvanlig erfaring, fordi jeg ret ofte arbejder med viden graf og forespørgselssprog til grafer. Så vi vil kort gennemgå grundlæggende emner, da denne del er lidt mere eksotisk.
I klassiske relationelle databaser har vi en fast skema — her er skemaet fleksibelt, hver prædikat er faktisk en "kolonne" og endda mere.
Forestil dig, at du skulle modellere et menneske og ønskede at beskrive nøgleelementer; lad os tage den specifikke person Douglas Adams som eksempel.
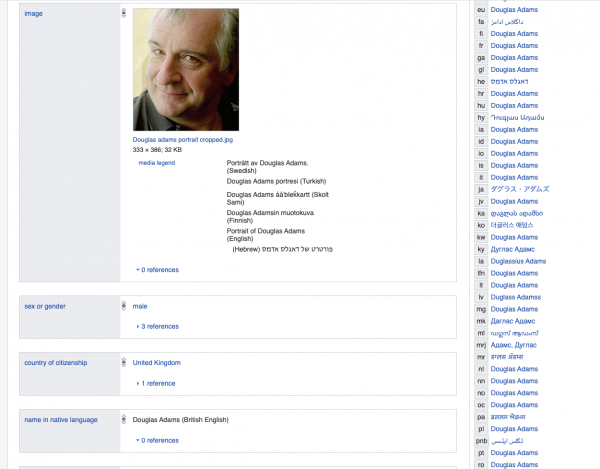
Hvis vi skulle bruge en relationsdatabase, ville vi være nødt til at oprette en kæmpe tabel eller tabeller med et enormt antal kolonner, hvoraf størstedelen ville være NULL eller udfyldt med en eller anden standard False værdi. For eksempel har de fleste af os næppe en post i det nationale koreanske biblioteks register. Selvfølgelig kunne vi adskille dem i separate tabeller, men det ville i sidste ende være en forsøg på at modellere et fleksibelt logisk skema med prædikater ved hjælp af en fast relation.
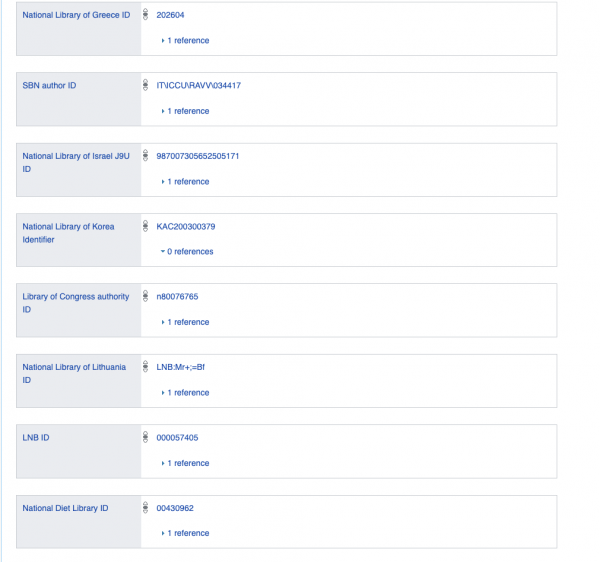
Så forestil dig, at alle data opbevares i form af en graf eller i form af binære og unariske logiske udsagn.
Hvor kan du overhovedet støde på dette? Først og fremmest når du arbejder med , ja, og med enhver grafdatabase eller forbindte data.
Herunder følger de grundlæggende forespørgselsprog, som jeg har været nødt til at anvende og arbejde med.
SPARQL
Wiki:
SPARQL ( fra SPARQL Protocol and RDF Query Language) — , der præsenteres efter modellen , samt til at overføre disse forespørgsler og svarene på dem. SPARQL er en anbefaling fra og en af teknologierne .
Det er reelt et forespørgselssprog til logiske unariske og binære prædikater. Du angiver blot betinget, hvad der er fastsat i det logiske udsagn, og hvad der ikke er (meget forsimplet).
Selve RDF-databasen (Resource Description Framework), hvorpå SPARQL-forespørgsler udføres, er en triplet objekt, prædikat, subjekt — og forespørgslen vælger de relevante tripletter efter angivne begrænsninger i stil med: find en sådan X, at p_55(X, q_33) er sand — hvor p_55 naturligvis er et forhold med id 55, og q_33 er et objekt med id 33 (og det er hele historien, igen uden at tage højde for mange detaljer).
Eksempel på datavisualisering:
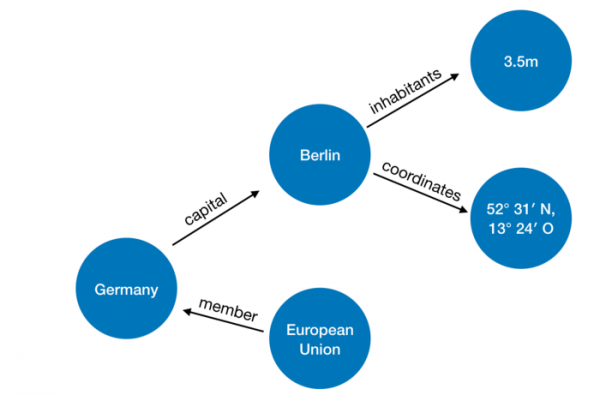
Billeder og eksempel med lande er her .
Eksempel på en grundlæggende forespørgsel
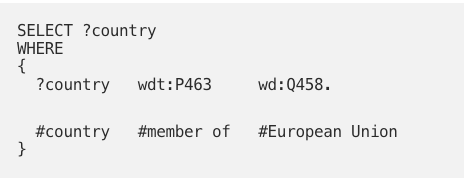
Faktisk ønsker vi at finde værdien af variablen ?country, sådan at for prædikatet
member_of, er det korrekt, at member_of(?country,q458), og q458 er ID'et for den europæiske union.
Eksempel på en reel SPARQL-forespørgsel inden for Python-motoren:
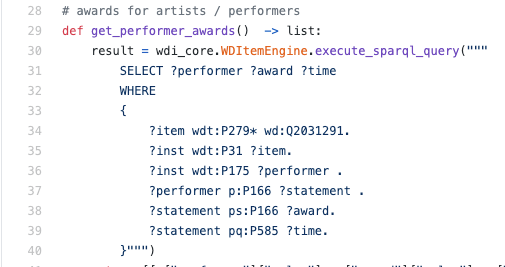
Som regel har jeg måtte læse SPARQL i stedet for at skrive det — i en sådan situation vil det sandsynligvis være en nyttig færdighed at forstå sproget i det mindste på et grundlæggende niveau for at forstå, hvordan dataene faktisk udtrækkes.
Der er mange materialer online til at lære: for eksempel her og . Jeg søger normalt efter specifikke konstruktioner og eksempler, og indtil videre er det nok.
Logiske forespørgselssprog
Du kan læse mere om emnet i min artikel . Her vil vi dog kun kort gennemgå, hvorfor logiske sprog er godt egnede til at skrive forespørgsler. Grundlæggende er RDF bare en samling af logiske udsagn af formen p(X) og h(X,Y), mens en logisk forespørgsel har følgende form:
output(X) :- country(X), member_of(X,“EU”).
Her taler vi om at oprette en ny prædikat output/1 ( /1 betyder unær), under forudsætning af, at det for X er sandt, at country(X) — det vil sige, X er et land og også member_of(X,“EU”).
Det vil sige, at vi i dette tilfælde har både data og regler præsenteret helt ens, hvilket gør det meget nemt og godt at modellere opgaver.
Hvor det er blevet brugt i branchen: et helt stort projekt med et firma, der skriver forespørgsler på et sådant sprog, samt i det nuværende projekt i systemets kerne — det virker som en ret eksotisk ting, men det dukker nogle gange op.
Et eksempel på kodefragment på et logisk sprog, der behandler wikidata:
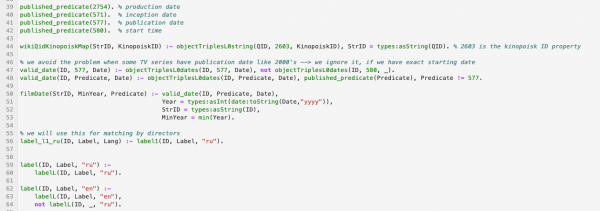
Materialer: jeg vil her angive et par links til det moderne logiske programmeringssprog Answer Set Programming — jeg anbefaler at studere netop dette:
Kilde: habr.com
