

Kære læsere, god dag. I dag vil vi tale lidt om Apache Spark og dets udviklingsmuligheder.
I den moderne verden af Big Data er Apache Spark de facto standarden ved udvikling af opgaver til batchbehandling af data. Derudover bruges det også til at oprette streaming-applikationer, der arbejder i micro batch-konceptet og behandler samt leverer data i små portioner (Spark Structured Streaming). Traditionelt har det været en del af den samlede Hadoop-stak, hvor YARN fungerer som ressourcestyringssystem (eller, i nogle tilfælde, Apache Mesos). I 2020 er brugen af det traditionelle system for de fleste virksomheder under stort pres på grund af manglen på ordentlige Hadoop-distributioner — udviklingen af HDP og CDH er stoppet, CDH er utilstrækkelig og har en høj pris, mens de øvrige leverandører af Hadoop enten har ophørt med at eksistere eller har en usikker fremtid. Derfor vækker det større interesse blandt samfundet og store virksomheder at køre Apache Spark ved hjælp af Kubernetes — da det er blevet standarden inden for containerorkestrering og ressourcestyring i private og offentlige skyer, løser det problemet med den kluntede ressourcereservering af Spark-opgaver på YARN og tilbyder en stabil og udviklende platform med mange kommercielle og åbne distributioner til virksomheder af alle størrelser og typer. Desuden har mange allerede fået et par installationer og opbygget ekspertise i brugen, hvilket gør overgangen lettere.
Siden version 2.3.0 har Apache Spark fået officiel støtte til at køre opgaver i Kubernetes-kluster, og i dag vil vi tale om den nuværende modenhed af denne tilgang, forskellige anvendelsesmuligheder og faldgruberne, som man vil møde ved implementering.
Først og fremmest vil vi se på udviklingsprocessen for opgaver og applikationer baseret på Apache Spark og fremhæve typiske tilfælde, hvor det er nødvendigt at køre en opgave på et Kubernetes-kluster. I forberedelsen af dette indlæg anvendes OpenShift som distribution, og kommandoer, der er relevante for dens kommandolinjeværktøj (oc), vil blive præsenteret. For andre Kubernetes-distributioner kan de tilsvarende kommandoer fra standard Kubernetes kommandolinjeværktøj (kubectl) eller deres analoger (f.eks. for oc adm policy) anvendes.
Den første anvendelsesmulighed — spark-submit
I udviklingsprocessen for opgaver og applikationer kræver udvikleren at køre opgaver til fejlfinding af datatransformationer. Teoretisk kan stubber anvendes til disse formål, men udvikling med deltagelse af reelle (selv om de er test) instanser af slutsystemer har vist sig at være hurtigere og mere kvalitetsbevidst i denne type opgaver. I de tilfælde, hvor vi udfører fejlfinding på reelle instanser af slutsystemer, er der to mulige arbejds-scenarier:
- udvikleren kører en Spark-opgave lokalt i standalone-tilstand;

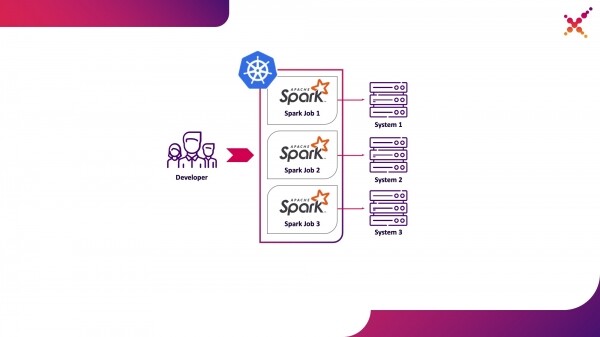
- udvikleren kører en Spark-opgave på et Kubernetes-kluster i testmiljøet.
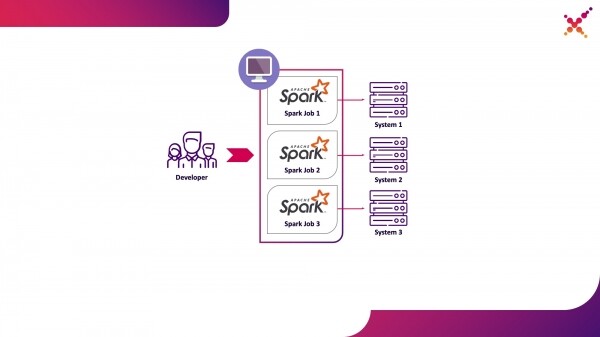
Den første mulighed er legitim, men indebærer en række ulemper:
- hver udvikler skal sikre adgang fra arbejdspladsen til alle de nødvendige instanser af slutsystemer;
- den arbejdsstation, der kræves for, at den udviklede opgave kan køre, skal have tilstrækkelige ressourcer.
Den anden mulighed har ikke disse ulemper, da brugen af Kubernetes-klusteret muliggør tildeling af det nødvendige ressourcer til kørsel af opgaver og sikrer de nødvendige adgange til instanserne af slutsystemer, fleksibelt tilpassende adgangen gennem Kubernetes' rollemodel for alle medlemmer af udviklingsteamet. Lad os fremhæve det som den første anvendelsesmulighed — kørsel af Spark-opgaver fra udviklerens lokale maskine på et Kubernetes-kluster i testmiljøet.
Lad os tale mere om processen med at konfigurere Spark til lokal kørsel. For at begynde at bruge Spark skal det installeres:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Vi samler de nødvendige pakker til at arbejde med Kubernetes:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
Den komplette opsætning tager lang tid, men for at oprette Docker-billeder og køre dem på et Kubernetes-cluster er der kun brug for jar-filer fra biblioteket «assembly/», så vi kan kun bygge dette delprojekt:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
For at køre Spark-opgaver i Kubernetes er det nødvendigt at oprette et Docker-billede, som vil blive brugt som basis. Der er to tilgange til dette:
- Det oprettede Docker-billede indeholder den eksekverbare kode for Spark-opgaven;
- Det oprettede billede indeholder kun Spark og nødvendige afhængigheder, den eksekverbare kode placeres eksternt (f.eks. i HDFS).
Lad os først oprette et Docker-billede, der indeholder et testeksempel på en Spark-opgave. Til at oprette Docker-billeder har Spark et relevant værktøj kaldet «docker-image-tool». Lad os se hjælp til det:
./bin/docker-image-tool.sh --help
Med dette værktøj kan man oprette Docker-billeder og uploade dem til eksterne registre, men det har nogle væsentlige ulemper som standard:
- det opretter obligatorisk straks 3 Docker-billeder — til Spark, PySpark og R;
- det tillader ikke at angive billede-navnet.
Derfor vil vi bruge en modificeret version af dette værktøj, som beskrevet nedenfor:
vi bin/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
Med dette værktøj samler vi et basis-billede af Spark, som indeholder en testopgave til beregning af π (her {docker-registry-url} er URL'en til dit Docker-register, {repo} er navnet på repositoryet i registret, der tæller med projektet i OpenShift, {image-name} er navnet på billedet (hvis der bruges en tre-niveau-opdeling af billederne, f.eks. som i det integrerede register Red Hat OpenShift), {tag} er tag'en for denne version af billedet):
./bin/docker-image-tool-upd.sh -f resource-managers/kubernetes/docker/src/main/dockerfiles/spark/Dockerfile -r {docker-registry-url}/{repo} -i {image-name} -t {tag} build
Vi logger ind i OKD-clusteret ved hjælp af konsolværktøjet (her {OKD-API-URL} er API-URL'en til OKD-clusteret):
oc login {OKD-API-URL}
Lad os få tokenen for den nuværende bruger til godkendelse i Docker Registry:
oc whoami -t
Vi logger ind i det interne Docker Registry i OKD-clusteret (brug tokenen, der blev opnået med den foregående kommando, som adgangskode):
docker login {docker-registry-url}
Vi uploader det oprettede Docker-billede til OKD Docker Registry:
./bin/docker-image-tool-upd.sh -r {docker-registry-url}/{repo} -i {image-name} -t {tag} push
Lad os sikre, at det samlede billede er tilgængeligt i OKD. For at gøre dette åbner vi i browseren URL'en med listen over billeder fra det relevante projekt (her er {project} navnet på projektet inde i OpenShift-klyngen, {OKD-WEBUI-URL} er URL'en til Web-konsollen for OpenShift) — https://{OKD-WEBUI-URL}/console/project/{project}/browse/images/{image-name}.
For at starte opgaver skal der oprettes en servicekonto med privilegier til at starte pods under root (vi vil senere diskutere dette emne):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Vi udfører kommandoen spark-submit for at publicere en Spark-opgave i OKD-klyngen, ved at angive den oprettede servicekonto og Docker-billedet:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Her:
—name — navnet på opgaven, som vil deltage i dannelsen af navnet på Kubernetes-pods;
—class — klassen af den eksekverbare fil, der kaldes ved opstart af opgaven;
—conf — konfigurationsparametre for Spark;
spark.executor.instances — antallet af kørende Spark-executorer;
spark.kubernetes.authenticate.driver.serviceAccountName — navnet på Kubernetes-servicekontoen, der bruges ved opstart af pods (til at bestemme sikkerhedskonteksten og mulighederne ved interaktion med Kubernetes API);
spark.kubernetes.namespace — Kubernetes-navneområdet, hvor driver- og executor-pods vil blive kørt;
spark.submit.deployMode — måden, Spark startes på (den standard spark-submit bruger er «cluster», for Spark Operator og nyere versioner af Spark «client»);
spark.kubernetes.container.image — Docker-billedet, der bruges til at starte pods;
spark.master — URL'en for Kubernetes API (den angives eksternt, så adgangen sker fra den lokale maskine);
local:// — stien til den eksekverbare Spark-fil inden i Docker-billedet.
Vi går til det relevante OKD-projekt og undersøger de oprettede pods — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
For at forenkle udviklingsprocessen kan en anden løsning anvendes, hvor der oprettes et fælles grundlæggende Spark-billede, der bruges af alle opgaver til at køre, og snapshots af de eksekverbare filer publiceres til eksternt lager (f.eks. Hadoop) og angives ved kald af spark-submit som et link. I dette tilfælde kan der køres forskellige versioner af Spark-opgaver uden at skulle genopbygge Docker-billeder, ved at bruge f.eks. WebHDFS til at publicere billeder. Vi sender en forespørgsel om at oprette en fil (her er {host} værten for WebHDFS-tjenesten, {port} er porten for WebHDFS-tjenesten, {path-to-file-on-hdfs} er den ønskede sti til filen på HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE"
Svaret vil være af følgende art (her er {location} URL'en, som skal bruges til at uploade filen):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Vi uploader Spark eksekverbar fil til HDFS (her er {path-to-local-file} stien til den eksekverbare Spark-fil på den nuværende vært):
curl -i -X PUT -T {path-to-local-file} "{location}"
Efter dette kan vi udføre spark-submit ved at bruge den Spark-fil, der er blevet uploadet til HDFS (her er {class-name} navnet på den klasse, der skal køres for at udføre opgaven):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Det skal bemærkes, at adgang til HDFS og sikring af opgavens udførelse kan kræve ændringer i Dockerfile og entrypoint.sh-scriptet — tilføje en direktiv i Dockerfile for at kopiere nødvendige biblioteker til /opt/spark/jars-mappen og inkludere HDFS konfigurationsfilen i SPARK_CLASSPATH i entrypoint.sh.
Den anden anvendelsesmulighed — Apache Livy
Når opgaven er udviklet, og den resulterende output skal testes, opstår spørgsmålet om dens kørsel inden for CI/CD-processen og overvågning af udførelsesstatus. Selvfølgelig kan den køres via lokalt kald til spark-submit, men dette komplicerer CI/CD-infrastrukturen, da det kræver installation og konfiguration af Spark på CI-servernes agenter/løbere og indstilling af adgang til Kubernetes API. I dette tilfælde blev Apache Livy valgt som REST API til kørsel af Spark-opgaver, placeret inden i Kubernetes-klyngen. Med det kan du køre Spark-opgaver på Kubernetes-klyngen ved hjælp af almindelige cURL-anmodninger, hvilket er nemt at implementere på basis af enhver CI-løsning, og dens placering inden i Kubernetes-klyngen løser autentificeringsproblemet ved interaktion med Kubernetes API.
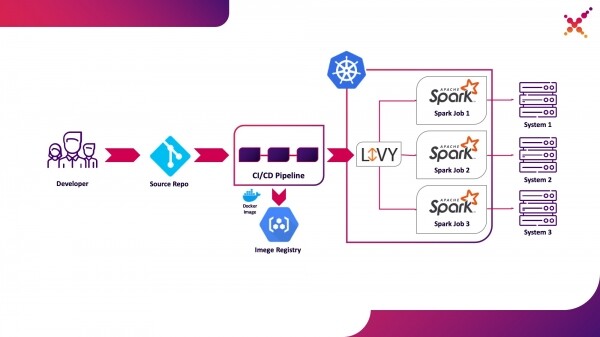
Lad os fremhæve dette som den anden anvendelsesmulighed — at køre Spark-opgaver inden for CI/CD-processen på Kubernetes-klyngen i et testmiljø.
Lidt om Apache Livy — det fungerer som HTTP-server, der tilbyder et webinterface og RESTful API, som gør det muligt at eksternt køre spark-submit ved at videregive de nødvendige parametre. Traditionelt blev det leveret som en del af HDP-distributionen, men kan også implementeres i OKD eller enhver anden Kubernetes-installation ved hjælp af den relevante manifest og sæt af Docker-billeder, for eksempel dette — . For vores tilfælde blev en tilsvarende Docker-billede bygget, der inkluderer Spark version 2.4.5 fra følgende Dockerfile:
FRA java:8-alpine

ENV SPARK_HOME=/opt/spark
ENV LIVY_HOME=/opt/livy
ENV HADOOP_CONF_DIR=/etc/hadoop/conf
ENV SPARK_USER=spark

WORKDIR /opt

RUN apk add --update openssl wget bash &&
    wget -P /opt https://downloads.apache.org/spark/spark-2.4.5/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s /opt/spark-2.4.5-bin-hadoop2.7 /opt/spark

RUN wget http://mirror.its.dal.ca/apache/incubator/livy/0.7.0-incubating/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s /opt/apache-livy-0.7.0-incubating-bin /opt/livy &&
    mkdir /var/log/livy &&
    ln -s /var/log/livy /opt/livy/logs &&
    cp /opt/livy/conf/log4j.properties.template /opt/livy/conf/log4j.properties

ADD livy.conf /opt/livy/conf
ADD spark-defaults.conf /opt/spark/conf/spark-defaults.conf
ADD entrypoint.sh /entrypoint.sh

ENV PATH="/opt/livy/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["/entrypoint.sh"]
CMD ["livy-server"]
Det oprettede billede kan bygges og uploades til dit eksisterende Docker-register, f.eks. det interne OKD-register. Udrulningen bruger følgende manifest ({registry-url} — URL til Docker-billedregisteret, {image-name} — navn på Docker-billedet, {tag} — tag for Docker-billedet, {livy-url} — ønsket URL, hvor Livy-serveren skal være tilgængelig; manifestet "Route" bruges, hvis Kubernetes-distributionen er Red Hat OpenShift, ellers bruges det relevante Ingress- eller NodePort-Servicemanifest):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
Efter anvendelse og vellykket opstart af pod'en er Livy's grafiske grænseflade tilgængelig via linket: http://{livy-url}/ui. Med Livy kan vi publicere vores Spark-opgave ved hjælp af et REST-anrop, for eksempel fra Postman. Et eksempel på en samling med forespørgsler er givet nedenfor (i arrayet "args" kan konfigurationsargumenter med de variabler, der er nødvendige for at køre den udførte opgave, sendes):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Indsend job med jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"local://opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar\", nt\"className\": \"org.apache.spark.examples.SparkPi\",nt\"numExecutors\":1,nt\"name\": \"spark-test-1\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Indsend job uden jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"hdfs://{host}:{port}/{path-to-file-on-hdfs}\", nt\"className\": \"{class-name}\",nt\"numExecutors\":1,nt\"name\": \"spark-test-2\",nt\"proxyUser\": \"0\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt},nt\"args\": [ntt\"HADOOP_CONF_DIR=/opt/spark/hadoop-conf\",ntt\"MASTER=k8s://https://kubernetes.default.svc:8443\"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Udfør den første anmodning fra samlingen, gå til OKD-grænsefladen og kontroller, at opgaven er blevet startet korrekt — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. I Livy-grænsefladen (http://{livy-url}/ui) vil der opstå en session, hvor du ved hjælp af Livy API'et eller det grafiske interface kan overvåge opgaveforløbet og studere sessionsloggene.
Vi vil nu vise, hvordan Livy fungerer. For at gøre dette vil vi undersøge logfilerne fra Livy-containere inde i pod'en med Livy-serveren — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Af dem kan vi se, at ved kald af REST API'et i Livy-containeren med navnet «livy» udføres spark-submit, som ligner den, vi brugte ovenfor (her er {livy-pod-name} navnet på den oprettede pod med Livy-serveren). Samlingen indeholder også et andet kald, der muliggør eksekvering af opgaver med en fjernplacering af Spark-eksekveringsfilen ved hjælp af Livy-serveren.
Den tredje anvendelse - Spark Operator
Nu da opgaven er testet, opstår spørgsmålet om dens regelmæssige kørsel. Den native metode til regelmæssig kørsel af opgaver i en Kubernetes-klynge er entiteten CronJob, og den kan anvendes, men i øjeblikket er det blevet meget populært at bruge operatorer til applikationsstyring i Kubernetes, og der findes en meget moden operator til Spark, som især anvendes i Enterprise-løsninger (f.eks. Lightbend FastData Platform). Vi anbefaler at bruge den — den nuværende stabile version af Spark (2.4.5) har begrænsede muligheder for konfiguration af kørsel af Spark-opgaver i Kubernetes, mens den kommende hovedversion (3.0.0) har lovet fuld støtte til Kubernetes, men udgivelsesdatoen forbliver ukendt. Spark Operator kompenserer for denne mangel ved at tilføje væsentlige konfigurationsparametre (f.eks. montering af ConfigMap med konfigurationen til adgang til Hadoop i Spark-pods) og muligheden for regelmæssig kørsel af opgaven efter en tidsplan.
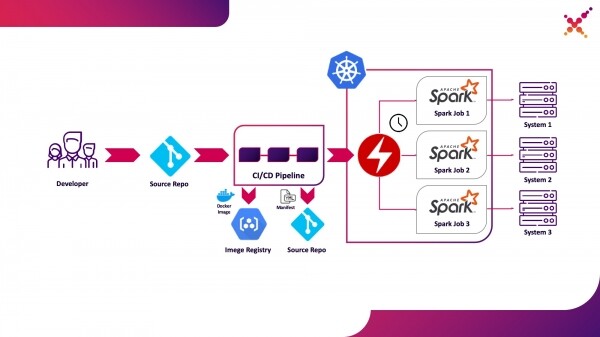
Vi fremhæver det som den tredje anvendelse - regelmæssig kørsel af Spark-opgaver i Kubernetes-klyngen i produktionsmiljøet.
Spark Operator har åbent kildekode og udvikles som en del af Google Cloud Platform - . Dens installation kan ske på 3 måder:
- Som en del af installationen af Lightbend FastData Platform/Cloudflow;
- Ved hjælp af Helm:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Ved at anvende manifester fra det officielle repository (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). Det er vigtigt at bemærke, at Cloudflow inkluderer en operator med API-version v1beta1. Hvis denne installationsmetode anvendes, skal beskrivelserne af Spark-applikationens manifester være baseret på eksempler fra tags i Git med den relevante API-version, f.eks. "v1beta1-0.9.0-2.4.0". Du kan finde versionen af operatoren i beskrivelsen af CRD, der er en del af operatoren i ordlisten "versions":
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Hvis operatoren er installeret korrekt, vil der i det relevante projekt være en aktiv pod med Spark-operatoren (f.eks. cloudflow-fdp-sparkoperator i Cloudflow-området for Cloudflow-installationen), og der vil være en tilsvarende Kubernetes-resurstype med navnet "sparkapplications". For at undersøge de eksisterende Spark-applikationer kan følgende kommando anvendes:
oc get sparkapplications -n {project}
For at køre opgaver ved hjælp af Spark Operator kræves der 3 ting:
- oprette et Docker-billede, der indeholder alle nødvendige biblioteker samt konfigurations- og eksekverbare filer. I den ønskede kontekst er dette billedet, der oprettes under CI/CD-trinnene og er testet på et testklynge;
- publicere Docker-billedet til et register, som er tilgængeligt fra Kubernetes-klyngen;
- oprette et manifest med typen "SparkApplication" og beskrivelsen af den opgave, der skal køre. Eksempler på manifester er tilgængelige i det officielle repository (f.eks. ). Det er vigtigt at bemærke vigtige punkter vedrørende manifestet:
- i "apiVersion"-ordlisten skal API-versionen, der svarer til operatørens version, angives;
- i "metadata.namespace"-ordlisten skal det navnerum, hvori applikationen skal køre, angives;
- i "spec.image"-ordlisten skal adressen til det oprettede Docker-billede i det tilgængelige register angives;
- i "spec.mainClass"-ordlisten skal den Spark-klasse, der skal køres under processtarten, angives;
- i "spec.mainApplicationFile"-ordlisten skal stien til den eksekverbare jar-fil angives;
- i "spec.sparkVersion"-ordlisten skal den anvendte version af Spark angives;
- i "spec.driver.serviceAccount"-ordlisten skal den servicekonto, der vil blive brugt til at køre applikationen i det relevante Kubernetes-område, angives;
- i "spec.executor"-ordlisten skal mængden af ressourcer, der afsættes til applikationen, angives.
- I ordbogen «spec.volumeMounts» skal der angives en lokal mappe, hvor de lokale filer til Spark-opgaven skal oprettes.
Eksempel på udformning af manifest (her er {spark-service-account} servicekontoen inden for Kubernetes-klyngen til at køre Spark-opgaver):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
I dette manifest er den servicekonto angivet, som kræver, at de nødvendige rollebindinger oprettes før publiceringen af manifestet for at give de nødvendige rettigheder til at interagere med Spark-applikationen i Kubernetes API (hvis nødvendigt). I vores tilfælde har applikationen brug for rettigheder til at oprette Pods. Vi opretter den nødvendige rollebinding:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Det er også værd at bemærke, at specifikationen for dette manifest kan indeholde parameteren «hadoopConfigMap», som giver mulighed for at angive et ConfigMap med Hadoop-konfiguration uden nødvendigvis at placere den tilsvarende fil i Docker-billedet på forhånd. Den er også velegnet til regelmæssig kørsel af opgaver - ved hjælp af parameteren «schedule» kan et køreplan for denne opgave angives.
Efter dette gemmer vi vores manifest i filen spark-pi.yaml og anvender det til vores Kubernetes-klynge:
oc apply -f spark-pi.yaml
Der oprettes et objekt af typen «sparkapplications»:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Der oprettes en pod med applikationen, hvis status vises i den oprettede «sparkapplications». Den kan ses med følgende kommando:
oc get sparkapplications spark-pi -o yaml -n {project}
Når opgaven er afsluttet, vil POD’en skifte til status «Completed», hvilket også opdateres i «sparkapplications». Applikationens logs kan ses i browseren eller med følgende kommando (her {sparkapplications-pod-name} er navnet på pod’en med den kørende opgave):
oc logs {sparkapplications-pod-name} -n {project}
Også kan opgavehåndteringen af Spark udføres ved hjælp af det specialiserede værktøj sparkctl. For at installere det kloner vi lagret med kildekoden og installerer Go, hvorefter vi bygger dette værktøj:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Lad os gennemgå listen over kørende Spark-opgaver:
sparkctl list -n {project}
Lad os oprette en beskrivelse for Spark-opgaven:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Lad os køre den beskrevne opgave ved hjælp af sparkctl:
sparkctl create spark-app.yaml -n {project}
Lad os gennemgå listen over kørende Spark-opgaver:
sparkctl list -n {project}
Lad os gennemgå listen over begivenheder for den kørende Spark-opgave:
sparkctl event spark-pi -n {project} -f
Lad os gennemgå status for den kørende Spark-opgave:
sparkctl status spark-pi -n {project}
Til sidst vil jeg gerne gennemgå de opdagede ulemper ved at bruge den nuværende stabile version af Spark (2.4.5) i Kubernetes:
- Den første og måske største ulempe er manglen på data-lokalitet. På trods af alle ulemperne ved YARN var der også fordele ved at bruge det, for eksempel princippet om at levere kode til data (i stedet for data til kode). Dette betød, at Spark-opgaver blev udført på noderne, hvor dataene, der var involveret i beregningerne, var placeret, hvilket tydeligt reducerede tiden til dataoverførsel via netværket. Når vi bruger Kubernetes, står vi over for behovet for at overføre data, der er involveret i opgaven, over netværket. Hvis disse data er store nok, kan udførelsestiden for opgaven stige betydeligt, og der kan være behov for et betydeligt større diskplads, der tildeles Spark-opgavens instanser til midlertidig lagring. Denne ulempe kan mindskes ved at bruge specialiserede softwareværktøjer, der sikrer data-lokalitet i Kubernetes (for eksempel Alluxio), men det betyder faktisk, at der er behov for at opbevare en fuld kopi af dataene på Kubernetes-klyngens noder.
- Den anden væsentlige ulempe er sikkerheden. Som standard er funktioner relateret til sikringen af sikkerhed ved kørsel af Spark-opgaver deaktiveret; brugen af Kerberos i den officielle dokumentation er ikke dækket (selvom de relevante parametre dukkede op i version 3.0.0, hvilket kræver yderligere overvejelse), og i dokumentationen om sikkerhed ved brug af Spark (https://spark.apache.org/docs/2.4.5/security.html) nævnes kun YARN, Mesos og Standalone Cluster som nøglelagre. Desuden kan brugeren, under hvilken Spark-opgaverne køres, ikke angives direkte — vi angiver kun den servicekonto, under hvilken pod'en vil køre, og brugeren vælges på baggrund af de konfigurerede sikkerhedspolitikker. Som følge heraf benyttes enten root-brugeren, hvilket ikke er sikkert i produktionsmiljøer, eller en bruger med et vilkårligt UID, hvilket er besværligt, når det kommer til fordeling af adgangsrettigheder til data (dette kan løses ved at oprette PodSecurityPolicies og binde dem til de relevante servicekonti). I øjeblikket bliver det løst enten ved at placere alle nødvendige filer direkte i Docker-billedet eller ved at modificere Spark-startscriptet til at bruge mekanismen til lagring og hentning af hemmeligheder, som er vedtaget i din organisation.
- Kørsel af Spark-opgaver ved hjælp af Kubernetes er officielt stadig i eksperimentel tilstand, og der kan i fremtiden ske betydelige ændringer i de anvendte artefakter (konfigurationsfiler, basis Docker-billeder og startskrift). Og faktisk — under forberedelsen af materialet blev versionerne 2.3.0 og 2.4.5 testet, og adfærden varierede betydeligt.
Vi ser frem til opdateringerne — for nylig blev en ny version af Spark (3.0.0) frigivet, som bragte mærkbare ændringer i Spark's funktion på Kubernetes, men som stadig har den eksperimentelle status for understøttelsen af denne ressourcechef. Måske vil de næste opdateringer virkelig tillade os fuldt ud at anbefale at opgive YARN og køre Spark-opgaver på Kubernetes uden at frygte for sikkerheden af dit system og uden behov for selvstændig udvikling af funktionelle komponenter.
Fin.
Kilde: habr.com
