

Enhver operation med store datamængder kræver stor beregningskraft. Almindelig overførsel af data fra en database til Hadoop kan tage flere uger eller koste som en flyvinge. Ønsker du ikke at vente og bruge penge? Balancer belastningen på forskellige platforme. En måde at gøre det på er pushdown-optimering.
Jeg bad den førende træner i Rusland for udvikling og administration af Informatica-produkter, Alexey Ananyev, fortælle om pushdown-optimeringsfunktionen i Informatica Big Data Management (BDM). Har du engang lært at arbejde med Informatica-produkter? Sandsynligvis var det Alexey, der fortalte dig om grundlæggende PowerCenter og forklarede, hvordan man bygger mappinger.
Alexey Ananyev, leder af læringsafdelingen hos DIS Group
Hvad er pushdown?
Mange af jer er allerede bekendt med Informatica Big Data Management (BDM). Produktet kan integrere store data fra forskellige kilder, overføre dem mellem forskellige systemer, sikre nem adgang til dem, muliggøre profilering af dem og meget mere.
I dygtige hænder kan BDM udføre mirakler: opgaver vil blive udført hurtigt og med minimale beregningsressourcer.
Vil du også det? Lær at bruge pushdown-funktionen i BDM til at fordele beregningsbelastningen mellem forskellige platforme. Pushdown-teknologi giver mulighed for at omdanne mappingen til et script og vælge det miljø, hvor dette script skal køre. Muligheden for at vælge gør det muligt at kombinere styrkerne fra forskellige platforme og opnå deres maksimale ydeevne.
For at konfigurere udførelsesmiljøet for scriptet skal du vælge typen af pushdown. Scriptet kan køres fuldt ud på Hadoop eller delvist fordeles mellem kilden og modtageren. Der er 4 mulige typer pushdown. Mappingen kan ikke omdannes til et script (native). Mappingen kan udføres maksimalt på kilden (source) eller helt på kilden (full). Derudover kan mappingen omdannes til et Hadoop-script (none).
Pushdown-optimering
De nævnte 4 typer kan kombineres på forskellige måder – optimere pushdown til systemets specifikke behov. For eksempel er det ofte mere hensigtsmæssigt at udtrække data fra databasen ved at anvende dens egne muligheder, mens datatransformationen kan udføres af Hadoop for ikke at overbelaste selve databasen.
Lad os overveje et tilfælde, hvor både kilden og modtageren er i databasen, og udførelsesplatformen for transformationerne kan vælges: afhængigt af indstillingerne vil det være Informatica, databaseserveren eller Hadoop. Et sådant eksempel vil bedst illustrere den tekniske side af arbejdet med denne mekanisme. Selvfølgelig opstår en sådan situation ikke i virkelighedens verden, men den passer bedst til at demonstrere funktionaliteten.
Lad os tage en mapping for at læse to tabeller i en enkelt Oracle-database. Og lad resultaterne af læsningen blive indskrevet i en tabel i den samme database. Mappingskemaet vil se sådan ud:
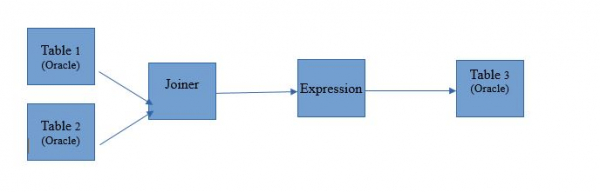
Som en mapping i Informatica BDM 10.2.1 ser det sådan her ud:
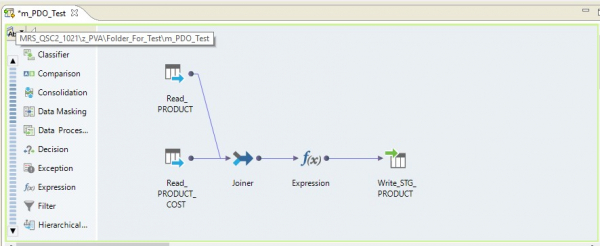
Pushdown-type – native
Hvis vi vælger pushdown native type, vil mappingen blive udført på serveren Informatica. Data vil blive læst fra Oracle-serveren, overført til Informatica-serveren, transformeret dér og sendt til Hadoop. Med andre ord får vi en almindelig ETL-proces.
Pushdown-type – source
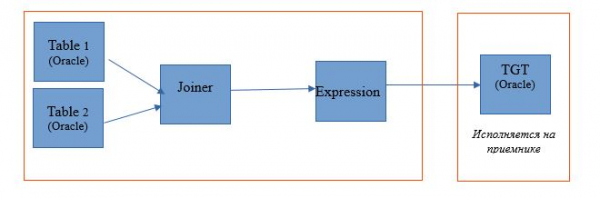
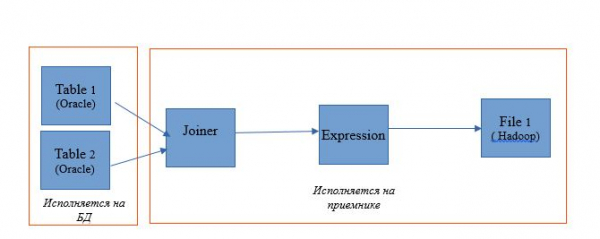
Ved valg af type source får vi mulighed for at fordele vores proces mellem serveren databaser (DB) og Hadoop. Når processen udføres med denne indstilling, vil der blive sendt forespørgsler til databasen for at hente data fra tabellerne. Det øvrige vil blive udført som trin på Hadoop.
Udførelsesskemaet vil se sådan ud:
Nedenfor er et eksempel på opsætningen af udførelsesmiljøet.
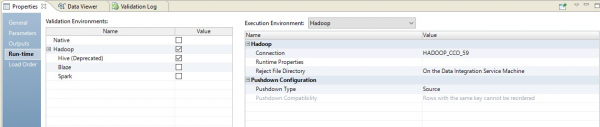
I dette tilfælde vil mappingen blive udført i to trin. I dens indstillinger vil vi se, at den er blevet til et script, der vil blive sendt til kilden. Samtidig vil sammenlægning af tabeller og transformation af data blive udført som en omskreven forespørgsel til kilden.
På billedet nedenfor ser vi en optimeret mapping i BDM, og på kilden – en omskreven forespørgsel.
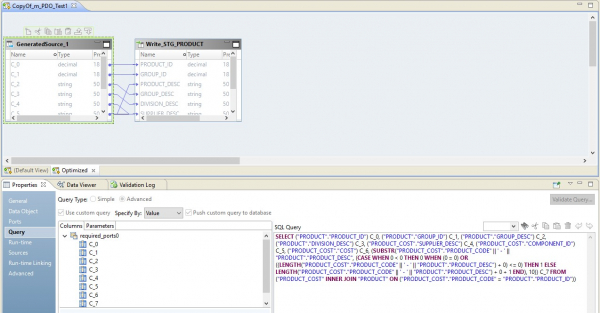
Hadoop's rolle i denne konfiguration vil være at styre dataflowet – dirigere det. Resultatet af forespørgslen vil blive sendt til Hadoop. Når læsningen er afsluttet, vil filen fra Hadoop blive skrevet til modtageren.
Pushdown-type – full
Når typen full vælges, bliver mappingen helt til en forespørgsel til databasen. Og resultatet af forespørgslen vil blive sendt til Hadoop. Skemaet for en sådan proces er præsenteret nedenfor.
Et eksempel på opsætningen er præsenteret nedenfor.
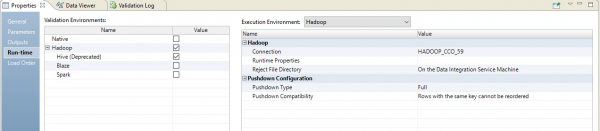
Som resultat vil vi få en optimeret mapping, der ligner den tidligere. Forskellen er kun, at al logik overføres til modtageren i form af overstyring af hans indsættelse. Eksemplet på den optimerede mapping er præsenteret nedenfor.
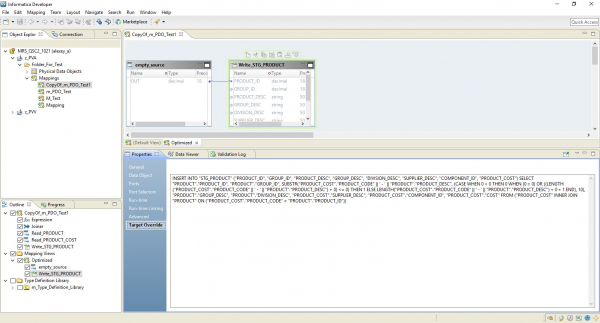
Her spiller Hadoop, ligesom før, rollen som dirigent. Men her læses kilden fuldstændigt, og derefter udføres databehandlingslogikken på modtagerens niveau.
Pushdown-typen – null
Og den sidste mulighed – pushdown-typen, hvori vores mapping vil blive til et script på Hadoop.
Den optimerede mapping vil nu se således ud:
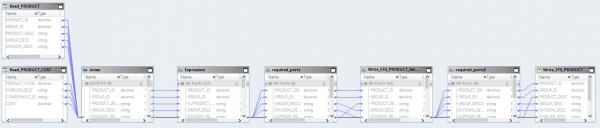
Her vil dataene fra kildefilerne først blive læst på Hadoop. Derefter vil de to filer blive slået sammen ved hjælp af Hadoop selv. Efter dette vil dataene blive transformeret og eksporteret til databasen.
Ved at forstå principperne for pushdown-optimering kan man meget effektivt organisere mange processer i arbejdet med store data. For nylig har en stor virksomhed på blot få uger eksporteret store data fra lageret til Hadoop, som de tidligere havde samlet i flere år.
Kilde: habr.com
