

Hello, Habr!
Efter nytårsferien har vi genstartet det katastroferesistente cloud-system baseret på to lokationer. I dag vil vi forklare, hvordan det fungerer, og vise, hvad der sker med kundernes virtuelle maskiner ved nedbrud af enkelte elementer i klyngen og fuldstændig nedbrud af en hel lokation (spoiler - de har det godt).
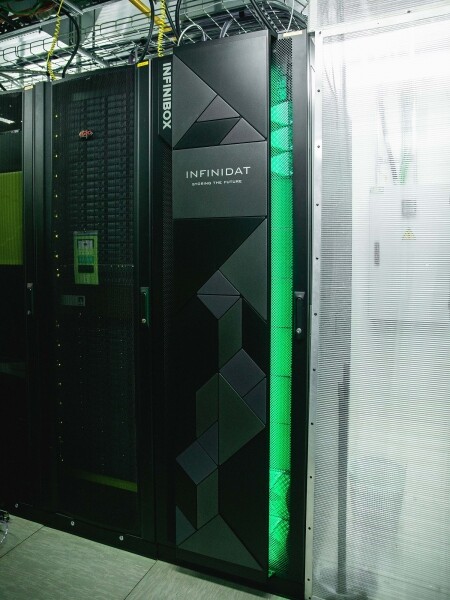
SDS for det katastroferesistente cloud-system på OST-lokationen.
Hvad er indeni
Under motorhjelmen er der Cisco UCS-servere med VMware ESXi hypervisor, to INFINIDAT InfiniBox F2240 SDS, Cisco Nexus-netværksudstyr samt Brocade SAN-switsch. Klyngen er fordelt over to lokationer - OST og NORD, det vil sige, at hver datacenter har et identisk sæt udstyr. Det er netop dette, der gør det katastrofe-resistent.
Inden for en lokation er de vigtigste elementer også duplikerede (værter, SAN-swits, netværk).
De to lokationer er forbundet med dedikerede fiberoptiske linjer, som også er reserverede.
Et par ord om SDS. Den første version af det katastroferesistente cloud-system byggede vi på NetApp. Her valgte vi INFINIDAT, og her er hvorfor:
- Active-Active replikationsmulighed. Det gør det muligt for en virtuel maskine at forblive funktionel, selv ved fuldstændigt nedbrud af en af SDS. Jeg vil fortælle mere om replikation senere.
- Tre disksystemkontrollere for at øge systemets fejltolerance. Normalt er der kun to.
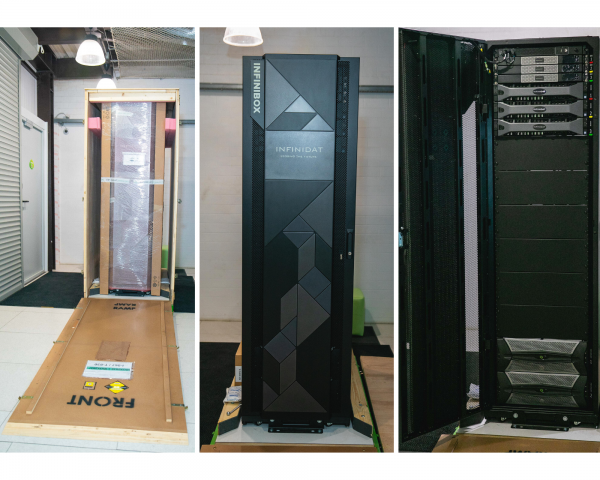
- Færdig løsning. Vi modtog et allerede samlet rack, som kun skal tilsluttes netværket og konfigureres.
- Opmærksom teknisk support. INFINIDAT's teknikere analyserer konstant logs og begivenheder fra SDS, opdaterer firmwareversioner og hjælper med konfiguration.
Her er lidt billeder fra unpacking:
Hvordan det fungerer
Cloudet er allerede katastrofe-resistent internt. Det beskytter kunden mod enkeltstående hardware- og softwarefejl. Det katastrofe-resistente cloud kan derimod hjælpe med at beskytte mod massen af fejl inden for én lokation: for eksempel nedbrud af SDS (eller klyngen, hvilket sker ofte 🙂), massefejl i lagringsnetværket, og meget mere. Og det vigtigste: et sådant cloud redder, når en hel lokation bliver utilgængelig på grund af brand, blackout, hackerangreb, eller endda invasion af rumvæsener.
I alle disse tilfælde fortsætter kundernes virtuelle maskiner med at køre, og her er hvorfor.
Clusterarkitekturen er sådan, at enhver ESXi-vært med klientvirtualmaskiner kan tilgå en hvilken som helst af de to SAN-lager. Hvis SAN-lageret på OST-lokaliteten svigter, fortsætter de virtuelle maskiner med at fungere: værterne, som de kører på, vil anmode om data fra SAN-lageret på NORD.
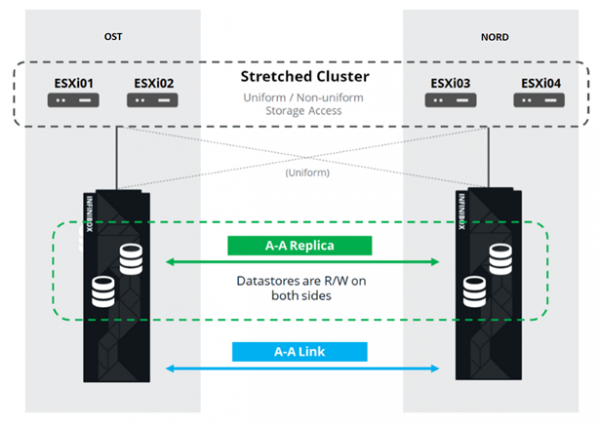
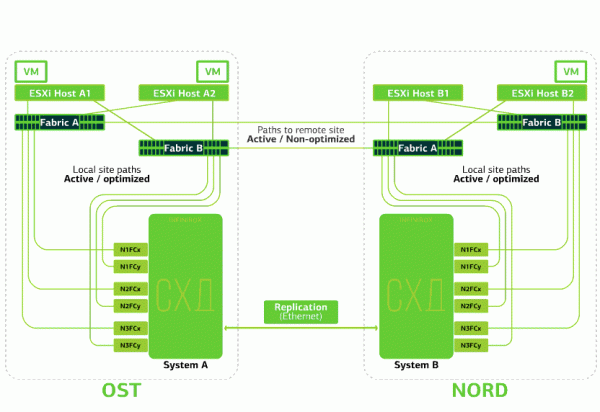
Her er, hvordan forbindelsesskemaet i klyngen ser ud.
Dette er muligt, fordi der er opsat Inter-Switch Link mellem SAN-fabrikkerne på de to lokaliteter: SAN-switch Fabric A OST er forbundet til SAN-switch Fabric A NORD, på samme måde som for SAN-switchene Fabric B.
Og for at alle disse komplekse SAN-fabrikker giver mening, er der opsat aktiv-aktiv replikation mellem de to SAN-lager: oplysninger skrives praktisk talt samtidigt til det lokale og det fjerne SAN-lager, RPO=0. Det betyder, at der på det ene SAN-lager opbevares originaldata, og på det andet – deres kopi. Data replikeres på niveauet for SAN-lag, og oven på dem opbevares VM-data (dens diske, konfigurationsfil, swap-fil osv.).
ESXi-værten ser det primære volumen og dets kopi som en enkelt lagringsenhed (Storage Device). Fra ESXi-værten til hver lagringsenhed er der 24 forbindelser:
12 forbindelser forbinder den til det lokale SAN-lager (optimale forbindelser), mens de resterende 12 forbinder den til det fjerne (ikke-optimale forbindelser). I normal drift tilgår ESXi data på det lokale SAN-lager ved hjælp af de "optimale" forbindelser. Når dette SAN-lager svigter, mister ESXi de optimale forbindelser og skifter til de "ikke-optimale". Sådan ser det ud på diagrammet.
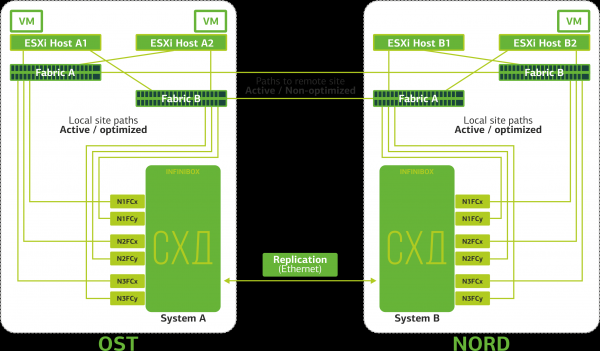
Diagram over katastrofesikre klynger.
Alle kundens netværk er tilsluttet begge lokaliteter gennem en fælles netværksfabrik. På hver lokalitet er der en Provider Edge (PE), hvor kundernes netværk termineres. PE'er er samlet i en fælles klynge. Hvis en PE svigter på en lokalitet, omdirigeres al trafik til den anden lokalitet. Takket være dette forbliver virtuelle maskiner fra den lokalitet, der er uden PE, tilgængelige via netværket for kunden.
Lad os nu se, hvad der sker med kundens virtuelle maskiner ved forskellige svigt. Vi starter med de mest enkle scenarier og slutter med det mest alvorlige – svigt af hele lokaliteten. I eksemplerne vil den primære lokalitet være OST, og den sekundære, med replikater af data, vil være NORD.
Hvad sker der med kundens virtuelle maskine, hvis...
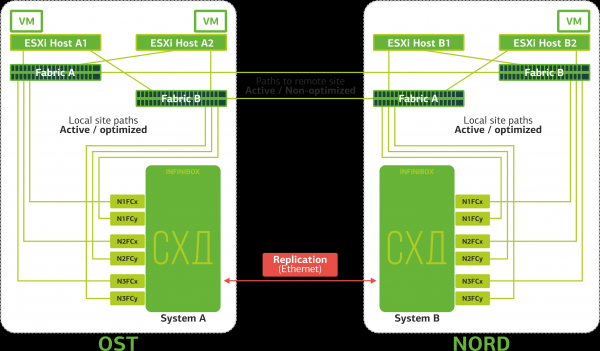
Replikationslinket svigter. Replikationen mellem SAN-lagerne på de to lokaliteter stopper.
ESXi vil kun fungere med lokale disk enheder (via optimale ruter).
Virtuelle maskiner fortsætter med at køre.
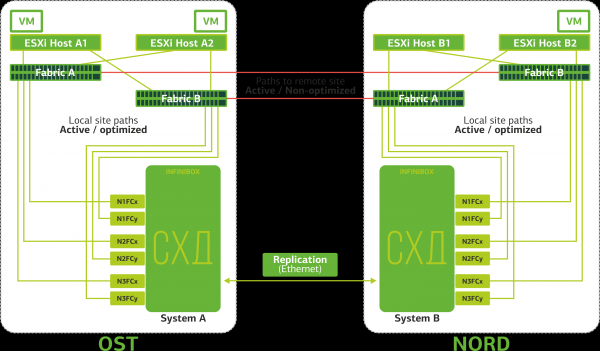
ISL (Inter-Switch Link) bliver afbrudt. Det er en usandsynlig situation. Medmindre en gal gravemaskine graver over flere optiske ruter, der løber uafhængigt og er tilsluttet via forskellige indgange. Men alligevel. I så fald vil ESXi-værter miste halvdelen af ruterne og kun kunne tilgå deres lokale storage. Replikaer bliver samlet, men værterne vil ikke kunne tilgå dem.
De virtuelle maskiner fungerer normalt.
SAN-switchen svigter på en af lokationerne. ESXi-værter mister en del af ruterne til storage. I dette tilfælde vil værterne på den lokation, hvor switchen svigtede, kun kunne operere gennem én af deres HBA.
De virtuelle maskiner fortsætter med at køre normalt.
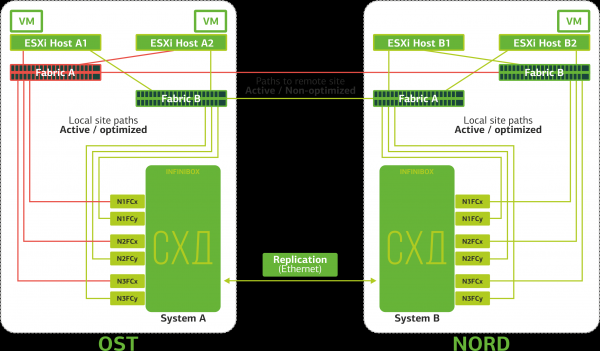
Alle SAN-switcher svigter på en af lokationerne. Lad os antage, at dette sker på OST-lokationen. I så fald vil ESXi-værterne på denne lokation miste alle ruter til deres disk enheder. Standardmekanismen VMware vSphere HA træder i kraft: den vil genstarte alle virtuelle maskiner på OST-lokationen i NORD max 140 sekunder.
De virtuelle maskiner, der kører på værterne på NORD, fungerer normalt.
ESXi-værten svigter på en lokation. Her træder vSphere HA-mekanismen til igen: de virtuelle maskiner fra den fejlbehæftede vært bliver genstartet på andre værter – på samme eller en fjern lokation. Genstartstiden for den virtuelle maskine er op til 1 minut.
Hvis alle ESXi-værter på OST-lokationen fejler, er der ikke andre muligheder: VM genstartes på en anden lokation. Genstartstiden er den samme.
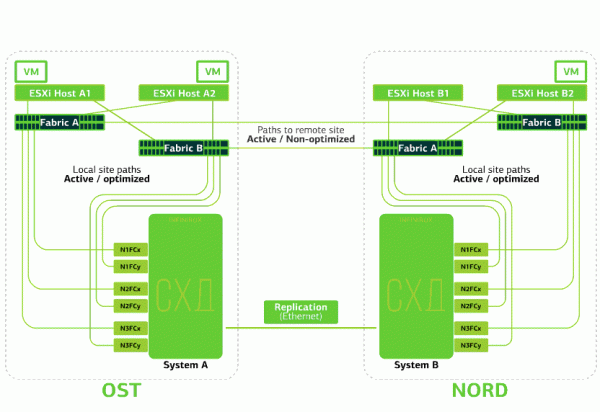
Storage svigter på en lokation. Lad os antage, at storage svigter på OST-lokationen. Så vil ESXi-værterne på OST-lokationen skifte til at arbejde med repliker af storage i NORD. Når den fejlbehæftede storage er genoprettet, vil der finde en tvingende replikation sted, og ESXi-værterne i OST vil igen begynde at tilgå den lokale storage.
De virtuelle maskiner fungerer hele tiden normalt.
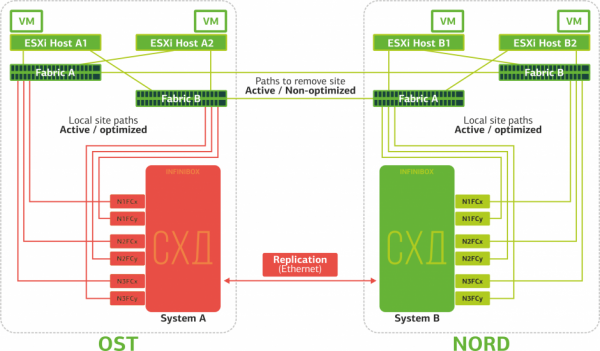
En af lokationerne svigter. I så fald vil alle virtuelle maskiner blive genstartet på en reserve-lokation via vSphere HA mekanismen. Genstartstiden for VM er 140 sekunder. I denne proces vil alle netværksindstillinger for den virtuelle maskine blive bevaret, og den vil forblive tilgængelig for kunden via netværket.
For the restart of machines at the backup site to go smoothly, each site is filled only halfway. The second half serves as a reserve in case all virtual machines need to be moved from the second, affected site.
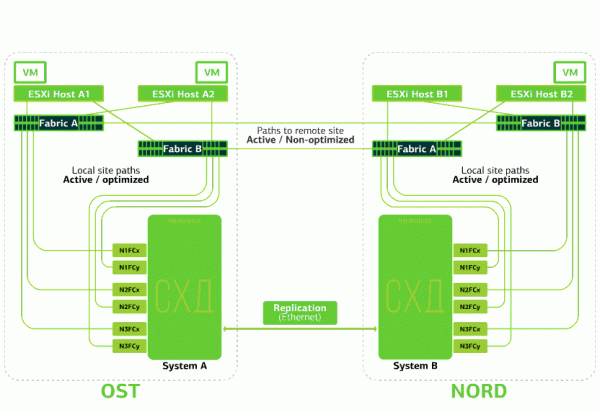
This is what a disaster-resistant cloud based on two data centers protects against.
This is not a cheap pleasure, as, in addition to the main resources, a reserve is needed at the second site. Therefore, business-critical services are hosted in such a cloud, where a prolonged downtime incurs significant financial and reputational losses or where there are requirements for disaster resistance from regulators or internal company regulations.
Kilder:
Kilde: habr.com
