

Data Science for Beginners
1. Sentiment Analysis (Sentimentanalyse via tekst)
Se det fulde Data Science projekt med kildekoden — .
Sentiment Analysis — er analysen af ord for at bestemme følelser og meninger, der kan være positive eller negative. Dette er en klassificeringstype, hvor klasserne kan være binære (positive og negative) eller multiple (glade, vrede, triste, ubehagelige …). Vi vil implementere dette Data Science projekt i R-sproget og bruge et datasæt fra pakken «janeaustenR». Vi vil anvende generelle ordlister som AFINN, Bing og Loughran, foretage interne join, og til sidst vil vi skabe et ordskyl for at illustrere resultatet.
Sprog: R
Datasæt/Pakke: janeaustenR
Artiklen er oversat med støtte fra EDISON Software, som , samt .
2. Fake News Detection (Opdagelse af falske nyheder)
Tag dine færdigheder til det næste niveau ved at arbejde på et Data Science projekt for begyndere — .
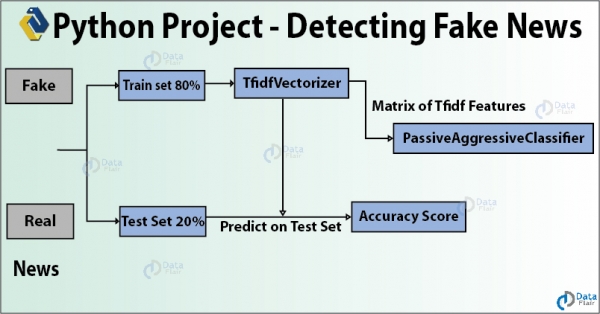
Falske nyheder er falske oplysninger, der spredes gennem sociale medier og andre netværksmedier med politiske mål. I denne Data Science projektidé vil vi bruge Python til at opbygge en model, der kan nøjagtigt bestemme, om en nyhed er ægte eller falsk. Vi vil oprette TfidfVectorizer og bruge PassiveAggressiveClassifier til at klassificere nyhederne som „ægte“ eller „falske“. Vi vil bruge et datasæt i størrelsen 7796 × 4 og udføre alt i Jupyter Lab.
Sprog: Python
Datasæt/Pakke: news.csv
3. Detecting Parkinson’s Disease (Opdagelse af Parkinsons sygdom)
Kom videre ved at arbejde på idéen til et Data Science projekt — .
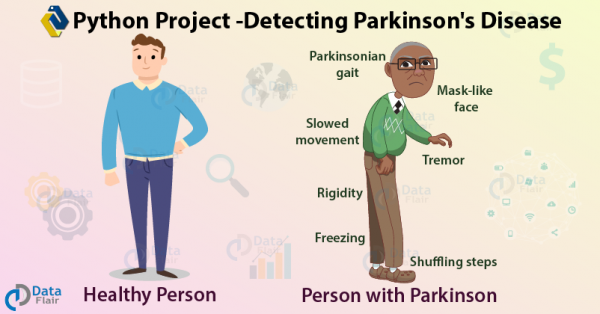
Vi er begyndt at bruge Data Science til at forbedre sundhedspleje og tjenester — hvis vi kan forudsige sygdommen tidligt, vil der være mange fordele. Således vil vi i denne Data Science projektidé lære at identificere Parkinsons sygdom med Python. Dette er en neurodegenerativ, progressiv sygdom i centralnervesystemet, der påvirker bevægelse og forårsager rysten og stivhed. Det påvirker dopaminproducerende neuroner i hjernen, og hvert år påvirker det mere end 1 million mennesker i Indien.
Sprog: Python
Datasæt/Pakke: UCI ML Parkinsons dataset
Data Science projekter af mellem sværhedsgrad
4. Speech Emotion Recognition (Genkendelse af følelser fra tale)
Se for en omfattende implementering af Data Science-projektet — .
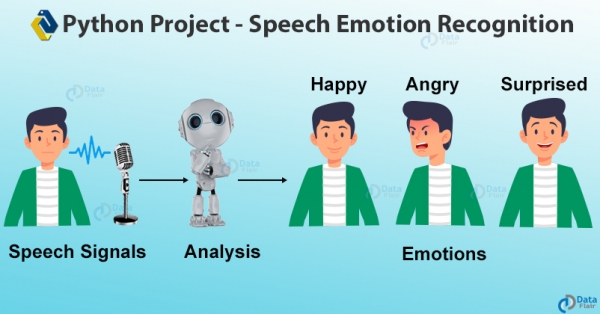
Lad os nu lære at bruge forskellige biblioteker. Dette Data Science-projekt anvender librosa til talegenkendelse. SER (Speech Emotion Recognition) er processen med at bestemme menneskelige følelser og affektive tilstande ud fra tale. Da vi bruger tone og tonehøjde til at udtrykke følelser med stemmen, er SER relevant. Men eftersom følelser er subjektive, er annotering af lyd en kompleks opgave. Vi vil bruge funktionerne mfcc, chroma og mel og anvende RAVDESS-datasættet til at genkende følelser. Vi vil oprette en MLPC-klassifikator til denne model.
Sprog: Python
Datasæt/Pakke: RAVDESS datasæt
5. Køn og Aldersdetektion (Gender and Age Detection)
Imponer arbejdsgivere med det nyeste Data Science-projekt — .
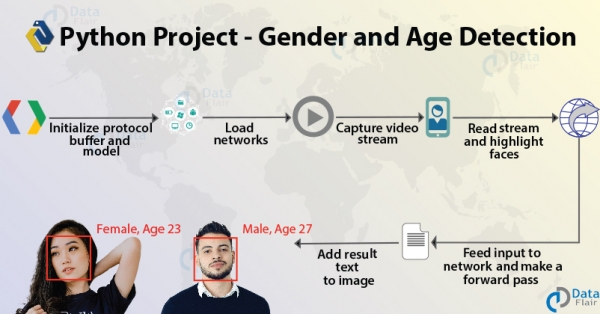
Dette er et interessant Data Science-projekt med Python. Ved at bruge kun et enkelt billede vil du lære at forudsige en persons køn og alder. I dette projekt vil vi introducere dig til Computer Vision og dets principper. Vi vil bygge en og anvende modeller trænet af Tal Hassner og Gil Levi til Adience datasættet. Undervejs vil vi bruge nogle .pb, .pbtxt, .prototxt og .caffemodel filer.
Sprog: Python
Datasæt/Pakke: Adience
6. Uber Data Analyse (Uber Data Analysis)
Se den komplette implementering af Data Science-projektet med kildekoden — .
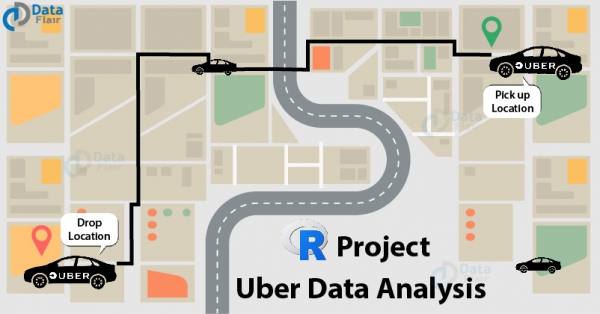
Dette er et datavisualiseringsprojekt med ggplot2, hvor vi vil bruge R og dets biblioteker til at analysere forskellige parametre. Vi vil bruge datasættet Uber Pickups i New York og skabe visualiseringer for forskellige tidspunkter på året. Dette fortæller os, hvordan tid påvirker kundernes ture.
Sprog: R
Datasæt/Pakke: Uber Pickups i New York City datasæt
7. Førertrætheddetektion (Driver Drowsiness Detection)
Forbedr dine færdigheder ved at arbejde på et top Data Science-projekt — .
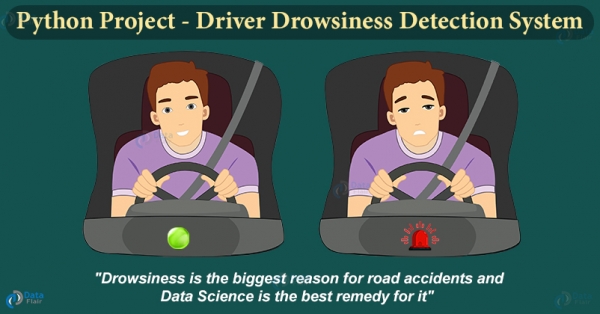
Træt kørsel er ekstremt farligt, og hvert år opstår der omkring tusinde ulykker, fordi chauffører falder i søvn under kørslen. I dette Python-projekt vil vi oprette et system, der kan opdage søvnige chauffører og advare dem med en alarm.
Dette projekt er gennemført ved hjælp af Keras og OpenCV. Vi vil bruge OpenCV til at opdage ansigt og øjne, og med Keras vil vi klassificere tilstanden af øjet (Åbent eller Lukket) ved hjælp af metoder fra dybe neurale netværk.
8. Chatbot
Opret en chatbot med Python og tag et skridt fremad i din karriere — .
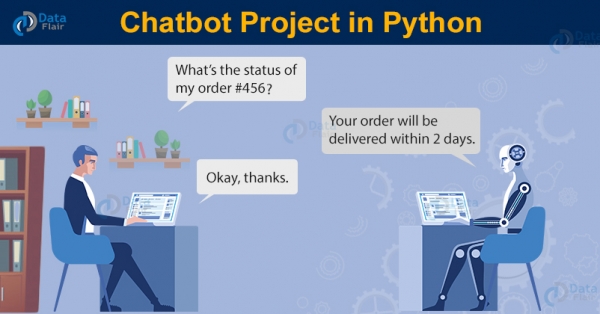
Chatbots er en uundgåelig del af erhvervslivet. Mange virksomheder skal tilbyde tjenester til deres kunder, og for at imødekomme dem kræves der meget arbejdskraft, tid og kræfter. Chatbots kan automatisere en stor del af interaktionen med kunderne ved at besvare nogle af de ofte stillede spørgsmål, som kunderne stiller. Der er hovedsageligt to typer chatbots: Domænespecifikke og Åben domæne. Domænespecifik chatbot bruges ofte til at løse et bestemt problem. Derfor skal du tilpasse den for at fungere effektivt inden for dit felt. Åben domæne chatbots kan stille enhver spørgsmål, derfor kræver deres træning en enorm mængde data.
Datasæt: Intents json-fil
Sprog: Python
Avancerede Data Science projekter
9. Image Caption Generator (Billedbeskrivelsesgenerator)
Tjek den fulde implementering af projektet med kildekode — .
At beskrive, hvad der er på et billede, er en let opgave for mennesker, men for computere er et billede bare et sæt tal, der repræsenterer farveværdien af hver pixel. Det er en udfordrende opgave for computere. At forstå, hvad der er i billedet, og derefter skabe en beskrivelse på naturligt sprog (for eksempel på engelsk) er en anden udfordrende opgave. Dette projekt bruger dyb læringsmetoder, hvor vi implementerer et Convolutional Neural Network (CNN) med et Recurrent Neural Network (LSTM) for at skabe en billedbeskrivelsesgenerator.
Datasæt: Flickr 8K
Sprog: Python
Framework: Keras
10. Credit Card Fraud Detection (Identifikation af kreditkortsvindel)
Gør dit bedste, mens du arbejder på idéen til et Data Science projekt — .
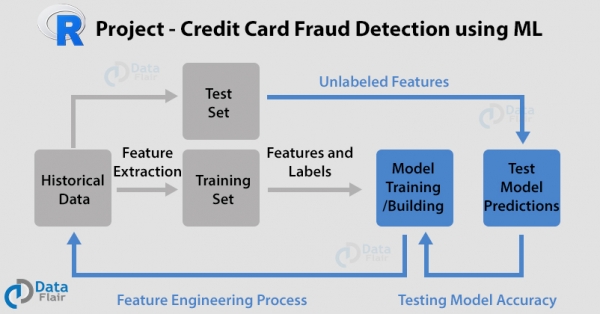
Indtil nu har du begyndt at forstå metoder og koncepter. Lad os gå videre til nogle avancerede projekter inden for datavidenskab. I dette projekt vil vi bruge sprog R med algoritmer som , logistisk regression, kunstige neurale netværk og gradient boosting classifier. Vi vil bruge et datasæt med korttransaktioner til at klassificere kreditkorttransaktioner som svigagtige eller ægte. Vi vil vælge forskellige modeller til dem og bygge præstationskurver.
Sprog: R
Datasæt/Pakke: Datasæt for korttransaktioner
11. Filmanbefalingssystem
Udforsk implementeringen af et førsteklasses Data Science-projekt med kildekode —
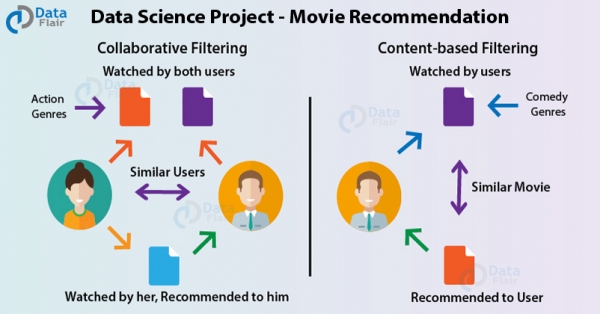
I dette Data Science-projekt vil vi bruge R til at anbefale film ved hjælp af maskinlæring. Anbefalingssystemet sender forslag til brugere gennem en filtreringsproces baseret på præferencer fra andre brugere og seerhistorik. Hvis A og B kan lide Home Alone, og B elsker Mean Girls, kan A få tilsendt en anbefaling om, at de også kunne lide det. Dette gør det muligt for kunder at interagere med platformen.
Sprog: R
Datasæt/Pakke: MovieLens datasæt
12. Kundesegmentering
Imponer arbejdsgivere med et Data Science-projekt (inklusive kildekode) — .
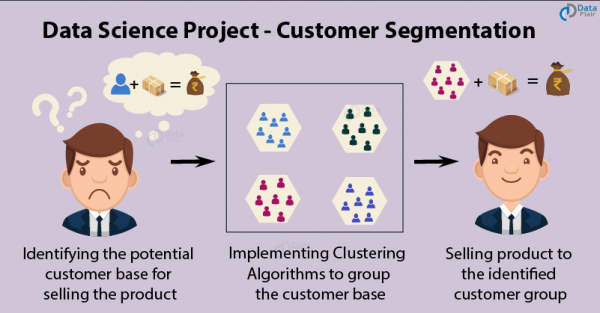
Kundesegmentering er en populær anvendelse Ved at bruge klustering kan virksomheder identificere kundesegmenter til at arbejde med potentielle brugere. De opdeler kunder i grupper baseret på fælles karakteristika såsom køn, alder, interesser og forbrugsvaner, så de effektivt kan sælge deres produkter til hver gruppe. Vi vil bruge , samt visualisere fordelingen efter køn og alder. Derefter vil vi analysere deres årlige indkomst og udgiftsniveau.
Sprog: R
Datasæt/Pakke: Mall_Customers datasæt
13. Klassifikation af brystkræft
Se den fulde implementering af Data Science-projektet i Python — .
Når vi ser på den medicinske bidrag fra datalogi, lad os lære at identificere brystkræft ved hjælp af Python. Vi vil bruge datasættet IDC_regular til at identificere invasiv duktal karcinom, den mest almindelige form for brystkræft. Den udvikler sig i mælkekanalerne og trænger ind i det fibrøse eller fedtholdige væv uden for kanalen. I dette datainnsamlingsprojekt vil vi anvende og Keras-biblioteket til klassificering.
Sprog: Python
Datasæt/Pakke: IDC_regular
14. Trafikskiltgenkendelse (Traffic Sign Recognition)
At opnå nøjagtighed i teknologien til selvkørende biler gennem et Data Science-projekt om med open source.
Trafikskilte og færdselsregler er meget vigtige for hver chauffør for at undgå ulykker. For at følge reglerne skal man først forstå, hvordan et trafikskilt ser ud. En person skal lære alle trafikskilte, før de får lov til at føre noget køretøj. Men nu vokser antallet af selvkørende køretøjer, og i den nærmeste fremtid vil mennesker ikke længere selv styre bilen. I projektet "Trafikskiltgenkendelse" vil du lære, hvordan et program kan identificere typen af trafikskilte ved at tage et billede som input. Datasættet til trafikskiltgenkendelse i Tyskland (GTSRB) bruges til at opbygge et dybt neuralt netværk til at genkende klassen, som trafikskiltet tilhører. Vi skaber også en simpel grafisk brugergrænseflade til interaktion med applikationen.
Sprog: Python
Datasæt: GTSRB (German Traffic Sign Recognition Benchmark)
Læs mere
Kilde: habr.com
