

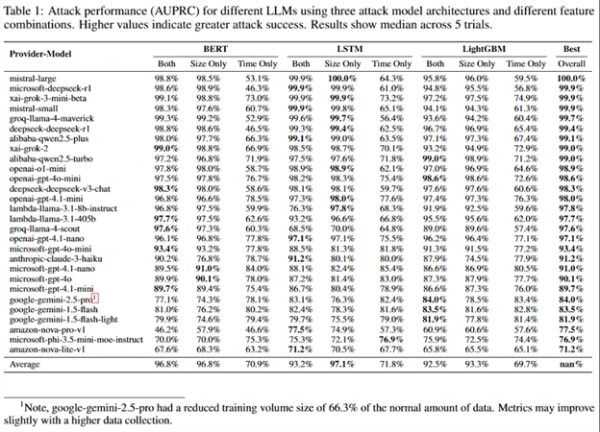
Sikkerhedsforskere fra Microsoft har udviklet en angrebsteknik ved hjælp af sidekanaler kaldet Whisper Leak, som gør det muligt at klassificere emner i forespørgsler til services baseret på store sprogmodeller ved passiv analyse af den krypterede trafik, der sendes via TLS-forbindelser. Information om størrelsen af netværkspakker og forsinkelserne mellem deres transmissioner var tilstrækkelig til at bestemme emnerne i forespørgsler til AI-chatbotter med en nøjagtighed på over 98 %. I praksis kan den foreslåede metode anvendes til at identificere bestemte emner i brugerens transit trafik, eksempelvis forsøg på at opnå information om ulovlige aktiviteter, uden at indholdet dekrypteres.
Værktøjer til at udtrække data fra trafikdump, træne modellen og teste metodens funktion er offentliggjort på GitHub. Muligheden for at udføre angrebet er blevet demonstreret for 28 populære store sprogmodeller fra de største producenter. For eksempel var nøjagtigheden af at identificere forespørgsler om "hvidvaskning af penge" for mange AI-services 100 %, når der i den analyserede trafik var 1 relevant forespørgsel og 10.000 forespørgsler, der ikke var relateret til det ønskede emne.
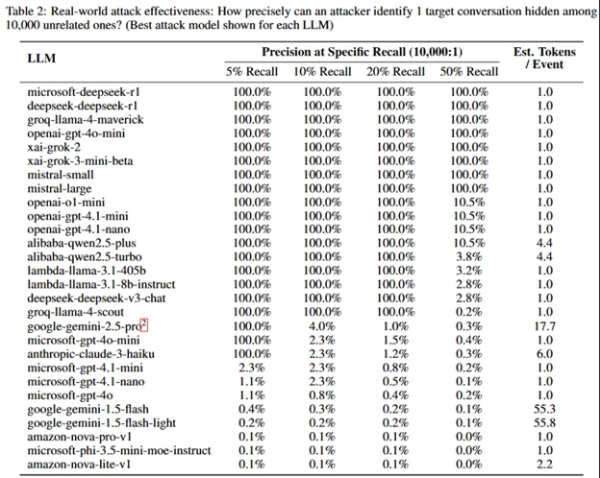
Årsagen til informationslækagen er, at modellerne genererer svar på forespørgsler trin for trin, ét token ad gangen, og ved hvert trin bruger det forrige token som kontekst til at bestemme det næste mest sandsynlige ord eller frase. Derfor sendes der et særskilt netværkspakke for hvert token, og forsinkelsen mellem pakkerne svarer til forsinkelsen mellem modelens bestemmelse af det næste token.
I TLS, hvis der ikke anvendes datakomprimering, er størrelsen af chifferteksten lig med størrelsen af den ukrypterede tekst plus en konstant. Ved at skabe en model, der korrelerer de ønskede sæt af tokens med størrelsen af pakkerne og forsinkelserne mellem deres transmissioner, kan man ret præcist bestemme tilstedeværelsen af ønskede emner i trafikken. I løbet af undersøgelsen er der udviklet tre varianter af sådanne maskinlæringsmodeller baseret på neurale netværksarkitekturer som LightGBM, Bi-LSTM og BERT. For hver model er der udført eksperimenter for at bestemme det ønskede emne ved kun at analysere størrelsen af pakkerne, kun forsinkelserne mellem pakkerne og begge kriterier.
For at reducere effektiviteten af passiv analyse af forespørgsels-tematikker har udviklerne af AI-tjenester foreslået at vedhæfte tilfældigt efterfyld, buffered transmittere token eller udføre substitution af falske pakker.
Kilde: opennet.ru
