

I øjeblikket er REST API blevet standarden for udvikling af webapplikationer, hvilket gør det muligt at opdele udviklingen i uafhængige dele. Til UI bruges der i øjeblikket forskellige populære rammer som Angular, React, Vue og andre. Backend-udviklere kan vælge imellem mange forskellige sprog og rammer. I dag vil jeg gerne tale om en ramme som . Vi i bruger aktivt den til interne projekter. Ved at bruge nest og pakken , vil vi skabe en simpel CRUD-applikation.
Hvorfor NestJS
For nylig er der kommet mange backend-rammer i JavaScript-samfundet. Og selvom de giver funktionaliteter, der ligner dem i Nest, er der ét område, hvor det bestemt vinder — det er arkitekturen. De følgende funktioner i NestJS muliggør oprettelse af industrikvalitetsapplikationer og skalering af udviklingen til store teams:
- brug af TypeScript som det primære udviklingssprog. Selvom NestJS også understøtter JavaScript, kan nogle funktioner muligvis ikke fungere, især når det kommer til tredjepartspakker;
- tilstedeværelsen af en DI-container, hvilket muliggør oprettelse af løst koblede komponenter;
- rammens funktionalitet er opdelt i uafhængige, udskiftelige komponenter. For eksempel kan der under motorhjelmen anvendes en , og , og til at arbejde med databaser giver nest ud af boksen bindinger til , , ;
- NestJS er platformuafhængig og understøtter REST, GraphQL, Websockets, gRPC osv.
Selve rammen er inspireret af frontend-rammen Angular og har mange konceptuelle ligheder med den.
Installation af NestJS og opsætning af projektet
Nest indeholder pakken /cli, который позволяет быстро развернуть базовый каркас приложения. Установим глобально данный пакет:
npm install --global @nest/cliEfter installationen genererer vi grundstrukturen for vores applikation med navnet nest-res. Dette gøres ved hjælp af kommandoen nest new nest-rest.
nest new nest-rest
dmitrii@dmitrii-HP-ZBook-17-G3:~\/projects $ nest new nest-rest
  Vi vil oprette din app på få sekunder..

CREATE \/nest-rest\/.prettierrc (51 bytes)
CREATE \/nest-rest\/README.md (3370 bytes)
CREATE \/nest-rest\/nest-cli.json (84 bytes)
CREATE \/nest-rest\/nodemon-debug.json (163 bytes)
CREATE \/nest-rest\/nodemon.json (67 bytes)
CREATE \/nest-rest\/package.json (1805 bytes)
CREATE \/nest-rest\/tsconfig.build.json (97 bytes)
CREATE \/nest-rest\/tsconfig.json (325 bytes)
CREATE \/nest-rest\/tslint.json (426 bytes)
CREATE \/nest-rest\/src\/app.controller.spec.ts (617 bytes)
CREATE \/nest-rest\/src\/app.controller.ts (274 bytes)
CREATE \/nest-rest\/src\/app.module.ts (249 bytes)
CREATE \/nest-rest\/src\/app.service.ts (142 bytes)
CREATE \/nest-rest\/src\/main.ts (208 bytes)
CREATE \/nest-rest\/test\/app.e2e-spec.ts (561 bytes)
CREATE \/nest-rest\/test\/jest-e2e.json (183 bytes)

? Hvilken pakkehåndteringsprogram vil du ️ bruge? yarn
 Installationen er i gang...

  Projektet nest-rest er oprettet med succes
  Kom i gang med følgende kommandoer:

$ cd nest-rest
$ yarn run start

                          Tak for installationen af Nest
                 Overvej venligst at donere til vores åbne kollektive
                        for at hjælpe os med at vedligeholde denne pakke.

                 Doner: https:\/\/opencollective.com\/nest
Vi vælger yarn som pakkehåndteringsprogram.
Du kan i øjeblikket starte serveren med kommandoen npm start og besøge adressen for at se startsiden. Men det er ikke derfor, vi er her, så lad os komme videre.
Lad os konfigurere databasen
Som databasen til denne artikel har jeg valgt PostgreSQL. Der findes mange meninger om dette, men efter min mening er det den mest modne database, der har alle nødvendige funktioner. Som allerede nævnt giver Nest integration med forskellige pakker til databasearbejde. Da jeg valgte PostgreSQL, vil det være logisk at vælge TypeORM som ORM. Lad os installere de nødvendige pakker til databaseintegration:
yarn add typeorm @nestjs\/typeorm pg
Lad os gennemgå, hvad hver pakke bruges til:
- typeorm — pakken, som indeholder selve ORM'en;
- @nestjs\/typeorm — TypeORM-pakken til NestJS. Tilføjer moduler til import i projektmoduler samt et sæt hjælpe-dekoratorer;
- pg — driveren til at arbejde med PostgreSQL.
Okay, pakkerne er installeret, nu skal databasen startes. Jeg vil bruge docker-compose.yml med følgende indhold til at opsætte databasen:
docker-compose.yml
version: '3.1'

services:
  db:
    image: postgres:11.2
    restart: always
    environment:
      POSTGRES_PASSWORD: example
    volumes:
      - ..\/db:\/var\/lib\/postgresql\/data
      - .\/postgresql.conf:\/etc\/postgresql\/postgresql.conf
    ports:
      - 5432:5432
  adminer:
    image: adminer
    restart: always
    ports:
      - 8080:8080
Som det fremgår, konfigurerer denne fil opstart af 2 containere:
- db — dette er containeren med selve databasen. I vores tilfælde bruges postgresql version 11.2;
- adminer — en databasehåndterer. Tilbyder et web-interface til at se og administrere databasen.
For working with TCP connections, I added a configuration with the following content.
postgresql.conf
# -----------------------------
# PostgreSQL configuration file
# -----------------------------
#
# This file consists of lines of the form:
#
# name = value
#
# (The "=" is optional.) Whitespace may be used. Comments are introduced with
# "#" anywhere on a line. The complete list of parameter names and allowed
# values can be found in the PostgreSQL documentation.
#
# The commented-out settings shown in this file represent the default values.
# Re-commenting a setting is NOT sufficient to revert it to the default value;
# you need to reload the server.
#
# This file is read on server startup and when the server receives a SIGHUP
# signal. If you edit the file on a running system, you have to SIGHUP the
# server for the changes to take effect, run "pg_ctl reload", or execute
# "SELECT pg_reload_conf()". Some parameters, which are marked below,
# require a server shutdown and restart to take effect.
#
# Any parameter can also be given as a command-line option to the server, e.g.,
# "postgres -c log_connections=on". Some parameters can be changed at run time
# with the "SET" SQL command.
#
# Memory units: kB = kilobytes Time units: ms = milliseconds
# MB = megabytes s = seconds
# GB = gigabytes min = minutes
# TB = terabytes h = hours
# d = days
#------------------------------------------------------------------------------
# FILE LOCATIONS
#------------------------------------------------------------------------------
# The default values of these variables are driven from the -D command-line
# option or PGDATA environment variable, represented here as ConfigDir.
#data_directory = 'ConfigDir' # use data in another directory
# (change requires restart)
#hba_file = 'ConfigDir/pg_hba.conf' # host-based authentication file
# (change requires restart)
#ident_file = 'ConfigDir/pg_ident.conf' # ident configuration file
# (change requires restart)
# If external_pid_file is not explicitly set, no extra PID file is written.
#external_pid_file = '' # write an extra PID file
# (change requires restart)
#------------------------------------------------------------------------------
# CONNECTIONS AND AUTHENTICATION
#------------------------------------------------------------------------------
# - Connection Settings -
listen_addresses = '*'
#listen_addresses = 'localhost' # what IP address(es) to listen on;
# comma-separated list of addresses;
# defaults to 'localhost'; use '*' for all
# (change requires restart)
#port = 5432 # (change requires restart)
#max_connections = 100 # (change requires restart)
#superuser_reserved_connections = 3 # (change requires restart)
#unix_socket_directories = '/tmp' # comma-separated list of directories
# (change requires restart)
#unix_socket_group = '' # (change requires restart)
#unix_socket_permissions = 0777 # begin with 0 to use octal notation
# (change requires restart)
#bonjour = off # advertise server via Bonjour
# (change requires restart)
#bonjour_name = '' # defaults to the computer name
# (change requires restart)
# - TCP Keepalives -
# see "man 7 tcp" for details
#tcp_keepalives_idle = 0 # TCP_KEEPIDLE, in seconds;
# 0 selects the system default
#tcp_keepalives_interval = 0 # TCP_KEEPINTVL, in seconds;
# 0 selects the system default
#tcp_keepalives_count = 0 # TCP_KEEPCNT;
# 0 selects the system default
# - Authentication -
#authentication_timeout = 1min # 1s-600s
#password_encryption = md5 # md5 or scram-sha-256
#db_user_namespace = off
# GSSAPI using Kerberos
#krb_server_keyfile = ''
#krb_caseins_users = off
# - SSL -
#ssl = off
#ssl_ca_file = ''
#ssl_cert_file = 'server.crt'
#ssl_crl_file = ''
#ssl_key_file = 'server.key'
#ssl_ciphers = 'HIGH:MEDIUM:+3DES:!aNULL' # allowed SSL ciphers
#ssl_prefer_server_ciphers = on
#ssl_ecdh_curve = 'prime256v1'
#ssl_min_protocol_version = 'TLSv1'
#ssl_max_protocol_version = ''
#ssl_dh_params_file = ''
#ssl_passphrase_command = ''
#ssl_passphrase_command_supports_reload = off
#------------------------------------------------------------------------------
# RESOURCE USAGE (except WAL)
#------------------------------------------------------------------------------
# - Memory -
#shared_buffers = 32MB # min 128kB
# (change requires restart)
#huge_pages = try # on, off, or try
# (change requires restart)
#temp_buffers = 8MB # min 800kB
#max_prepared_transactions = 0 # zero disables the feature
# (change requires restart)
# Caution: it is not advisable to set max_prepared_transactions nonzero unless
# you actively intend to use prepared transactions.
#work_mem = 4MB # min 64kB
#maintenance_work_mem = 64MB # min 1MB
#autovacuum_work_mem = -1 # min 1MB, or -1 to use maintenance_work_mem
#max_stack_depth = 2MB # min 100kB
#shared_memory_type = mmap # the default is the first option
# supported by the operating system:
# mmap
# sysv
# windows
# (change requires restart)
#dynamic_shared_memory_type = posix # the default is the first option
# supported by the operating system:
# posix
# sysv
# windows
# mmap
# (change requires restart)
# - Disk -
#temp_file_limit = -1 # limits per-process temp file space
# in kB, or -1 for no limit
# - Kernel Resources -
#max_files_per_process = 1000 # min 25
# (change requires restart)
# - Cost-Based Vacuum Delay -
#vacuum_cost_delay = 0 # 0-100 milliseconds (0 disables)
#vacuum_cost_page_hit = 1 # 0-10000 credits
#vacuum_cost_page_miss = 10 # 0-10000 credits
#vacuum_cost_page_dirty = 20 # 0-10000 credits
#vacuum_cost_limit = 200 # 1-10000 credits
# - Background Writer -
#bgwriter_delay = 200ms # 10-10000ms between rounds
#bgwriter_lru_maxpages = 100 # max buffers written/round, 0 disables
#bgwriter_lru_multiplier = 2.0 # 0-10.0 multiplier on buffers scanned/round
#bgwriter_flush_after = 0 # measured in pages, 0 disables
# - Asynchronous Behavior -
#effective_io_concurrency = 1 # 1-1000; 0 disables prefetching
#max_worker_processes = 8 # (change requires restart)
#max_parallel_maintenance_workers = 2 # taken from max_parallel_workers
#max_parallel_workers_per_gather = 2 # taken from max_parallel_workers
#parallel_leader_participation = on
#max_parallel_workers = 8 # maximum number of max_worker_processes that
# can be used in parallel operations
#old_snapshot_threshold = -1 # 1min-60d; -1 disables; 0 is immediate
# (change requires restart)
#backend_flush_after = 0 # measured in pages, 0 disables
#------------------------------------------------------------------------------
# WRITE-AHEAD LOG
#------------------------------------------------------------------------------
# - Settings -
#wal_level = replica # minimal, replica, or logical
# (change requires restart)
#fsync = on # flush data to disk for crash safety
# (turning this off can cause
# unrecoverable data corruption)
#synchronous_commit = on # synchronization level;
# off, local, remote_write, remote_apply, or on
#wal_sync_method = fsync # the default is the first option
# supported by the operating system:
# open_datasync
# fdatasync (default on Linux)
# fsync
# fsync_writethrough
# open_sync
#full_page_writes = on # recover from partial page writes
#wal_compression = off # enable compression of full-page writes
#wal_log_hints = off # also do full page writes of non-critical updates
# (change requires restart)
#wal_buffers = -1 # min 32kB, -1 sets based on shared_buffers
# (change requires restart)
#wal_writer_delay = 200ms # 1-10000 milliseconds
#wal_writer_flush_after = 1MB # measured in pages, 0 disables
#commit_delay = 0 # range 0-100000, in microseconds
#commit_siblings = 5 # range 1-1000
# - Checkpoints -
#checkpoint_timeout = 5min # range 30s-1d
#max_wal_size = 1GB
#min_wal_size = 80MB
#checkpoint_completion_target = 0.5 # checkpoint target duration, 0.0 - 1.0
#checkpoint_flush_after = 0 # measured in pages, 0 disables
#checkpoint_warning = 30s # 0 disables
# - Archiving -
#archive_mode = off # enables archiving; off, on, or always
# (change requires restart)
#archive_command = '' # command to use to archive a logfile segment
# placeholders: %p = path of file to archive
# %f = file name only
# e.g. 'test ! -f /mnt/server/archivedir/%f && cp %p /mnt/server/archivedir/%f'
#archive_timeout = 0 # force a logfile segment switch after this
# number of seconds; 0 disables
# - Archive Recovery -
# These are only used in recovery mode.
#restore_command = '' # command to use to restore an archived logfile segment
# placeholders: %p = path of file to restore
# %f = file name only
# e.g. 'cp /mnt/server/archivedir/%f %p'
# (change requires restart)
#archive_cleanup_command = '' # command to execute at every restartpoint
#recovery_end_command = '' # command to execute at completion of recovery
# - Recovery Target -
# Set these only when performing a targeted recovery.
#recovery_target = '' # 'immediate' to end recovery as soon as a
# consistent state is reached
# (change requires restart)
#recovery_target_name = '' # the named restore point to which recovery will proceed
# (change requires restart)
#recovery_target_time = '' # the time stamp up to which recovery will proceed
# (change requires restart)
#recovery_target_xid = '' # the transaction ID up to which recovery will proceed
# (change requires restart)
#recovery_target_lsn = '' # the WAL LSN up to which recovery will proceed
# (change requires restart)
#recovery_target_inclusive = on # Specifies whether to stop:
# just after the specified recovery target (on)
# just before the recovery target (off)
# (change requires restart)
#recovery_target_timeline = 'latest' # 'current', 'latest', or timeline ID
# (change requires restart)
#recovery_target_action = 'pause' # 'pause', 'promote', 'shutdown'
# (change requires restart)
#------------------------------------------------------------------------------
# REPLICATION
#------------------------------------------------------------------------------
# - Sending Servers -
# Set these on the master and on any standby that will send replication data.
#max_wal_senders = 10 # max number of walsender processes
# (change requires restart)
#wal_keep_segments = 0 # in logfile segments; 0 disables
#wal_sender_timeout = 60s # in milliseconds; 0 disables
#max_replication_slots = 10 # max number of replication slots
# (change requires restart)
#track_commit_timestamp = off # collect timestamp of transaction commit
# (change requires restart)
# - Master Server -
# These settings are ignored on a standby server.
#synchronous_standby_names = '' # standby servers that provide sync rep
# method to choose sync standbys, number of sync standbys,
# and comma-separated list of application_name
# from standby(s); '*' = all
#vacuum_defer_cleanup_age = 0 # number of xacts by which cleanup is delayed
# - Standby Servers -
# These settings are ignored on a master server.
#primary_conninfo = '' # connection string to sending server
# (change requires restart)
#primary_slot_name = '' # replication slot on sending server
# (change requires restart)
#promote_trigger_file = '' # file name whose presence ends recovery
#hot_standby = on # "off" disallows queries during recovery
# (change requires restart)
#max_standby_archive_delay = 30s # max delay before canceling queries
# when reading WAL from archive;
# -1 allows indefinite delay
#max_standby_streaming_delay = 30s # max delay before canceling queries
# when reading streaming WAL;
# -1 allows indefinite delay
#wal_receiver_status_interval = 10s # send replies at least this often
# 0 disables
#hot_standby_feedback = off # send info from standby to prevent
# query conflicts
#wal_receiver_timeout = 60s # time that receiver waits for
# communication from master
# in milliseconds; 0 disables
#wal_retrieve_retry_interval = 5s # time to wait before retrying to
# retrieve WAL after a failed attempt
#recovery_min_apply_delay = 0 # minimum delay for applying changes during recovery
# - Subscribers -
# These settings are ignored on a publisher.
#max_logical_replication_workers = 4 # taken from max_worker_processes
# (change requires restart)
#max_sync_workers_per_subscription = 2 # taken from max_logical_replication_workers
#------------------------------------------------------------------------------
# QUERY TUNING
#------------------------------------------------------------------------------
# - Planner Method Configuration -
#enable_bitmapscan = on
#enable_hashagg = on
#enable_hashjoin = on
#enable_indexscan = on
#enable_indexonlyscan = on
#enable_material = on
#enable_mergejoin = on
#enable_nestloop = on
#enable_parallel_append = on
#enable_seqscan = on
#enable_sort = on
#enable_tidscan = on
#enable_partitionwise_join = off
#enable_partitionwise_aggregate = off
#enable_parallel_hash = on
#enable_partition_pruning = on
# - Planner Cost Constants -
#seq_page_cost = 1.0 # measured on an arbitrary scale
#random_page_cost = 4.0 # same scale as above
#cpu_tuple_cost = 0.01 # same scale as above
#cpu_index_tuple_cost = 0.005 # same scale as above
#cpu_operator_cost = 0.0025 # same scale as above
#parallel_tuple_cost = 0.1 # same scale as above
#parallel_setup_cost = 1000.0 # same scale as above
#jit_above_cost = 100000 # perform JIT compilation if available
# and query more expensive than this;
# -1 disables
#jit_inline_above_cost = 500000 # inline small functions if query is
# more expensive than this; -1 disables
#jit_optimize_above_cost = 500000 # use expensive JIT optimizations if
# query is more expensive than this;
# -1 disables
#min_parallel_table_scan_size = 8MB
#min_parallel_index_scan_size = 512kB
#effective_cache_size = 4GB
# - Genetic Query Optimizer -
#geqo = on
#geqo_threshold = 12
#geqo_effort = 5 # range 1-10
#geqo_pool_size = 0 # selects default based on effort
#geqo_generations = 0 # selects default based on effort
#geqo_selection_bias = 2.0 # range 1.5-2.0
#geqo_seed = 0.0 # range 0.0-1.0
# - Other Planner Options -
#default_statistics_target = 100 # range 1-10000
#constraint_exclusion = partition # on, off, or partition
#cursor_tuple_fraction = 0.1 # range 0.0-1.0
#from_collapse_limit = 8
#join_collapse_limit = 8 # 1 disables collapsing of explicit
# JOIN clauses
#force_parallel_mode = off
#jit = on # allow JIT compilation
#plan_cache_mode = auto # auto, force_generic_plan or
# force_custom_plan
#------------------------------------------------------------------------------
# REPORTING AND LOGGING
#------------------------------------------------------------------------------
# - Where to Log -
#log_destination = 'stderr' # Valid values are combinations of
# stderr, csvlog, syslog, and eventlog,
# depending on platform. csvlog
# requires logging_collector to be on.
# This is used when logging to stderr:
#logging_collector = off # Enable capturing of stderr and csvlog
# into log files. Required to be on for
# csvlogs.
# (change requires restart)
# These are only used if logging_collector is on:
#log_directory = 'log' # directory where log files are written,
# can be absolute or relative to PGDATA
#log_filename = 'postgresql-%Y-%m-%d_%H%M%S.log' # log file name pattern,
# can include strftime() escapes
#log_file_mode = 0600 # creation mode for log files,
# begin with 0 to use octal notation
#log_truncate_on_rotation = off # If on, an existing log file with the
# same name as the new log file will be
# truncated rather than appended to.
# But such truncation only occurs on
# time-driven rotation, not on restarts
# or size-driven rotation. Default is
# off, meaning append to existing files
# in all cases.
#log_rotation_age = 1d # Automatic rotation of logfiles will
# happen after that time. 0 disables.
#log_rotation_size = 10MB # Automatic rotation of logfiles will
# happen after that much log output.
# 0 disables.
# These are relevant when logging to syslog:
#syslog_facility = 'LOCAL0'
#syslog_ident = 'postgres'
#syslog_sequence_numbers = on
#syslog_split_messages = on
# This is only relevant when logging to eventlog (win32):
# (change requires restart)
#event_source = 'PostgreSQL'
# - When to Log -
#log_min_messages = warning # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# info
# notice
# warning
# error
# log
# fatal
# panic
#log_min_error_statement = error # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# info
# notice
# warning
# error
# log
# fatal
# panic (effectively off)
#log_min_duration_statement = -1 # logs statements and their durations
# according to log_statement_sample_rate. -1 is disabled,
# 0 logs all statement, > 0 logs only statements running at
# least this number of milliseconds.
#log_statement_sample_rate = 1 # Fraction of logged statements over
# log_min_duration_statement. 1.0 logs all statements,
# 0 never logs.
# - What to Log -
#debug_print_parse = off
#debug_print_rewritten = off
#debug_print_plan = off
#debug_pretty_print = on
#log_checkpoints = off
#log_connections = off
#log_disconnections = off
#log_duration = off
#log_error_verbosity = default # terse, default, or verbose messages
#log_hostname = off
#log_line_prefix = '%m [%p] ' # special values:
# %a = application name
# %u = user name
# %d = database name
# %r = remote host and port
# %h = remote host
# %p = process ID
# %t = timestamp without milliseconds
# %m = timestamp with milliseconds
# %n = timestamp with milliseconds (as a Unix epoch)
# %i = command tag
# %e = SQL state
# %c = session ID
# %l = session line number
# %s = session start timestamp
# %v = virtual transaction ID
# %x = transaction ID (0 if none)
# %q = stop here in non-session
# processes
# %% = '%'
# e.g. '<%u%%%d> '
#log_lock_waits = off # log lock waits >= deadlock_timeout
#log_statement = 'none' # none, ddl, mod, all
#log_replication_commands = off
#log_temp_files = -1 # log temporary files equal or larger
# than the specified size in kilobytes;
# -1 disables, 0 logs all temp files
#log_timezone = 'GMT'
#------------------------------------------------------------------------------
# PROCESS TITLE
#------------------------------------------------------------------------------
#cluster_name = '' # added to process titles if nonempty
# (change requires restart)
#update_process_title = on
#------------------------------------------------------------------------------
# STATISTICS
#------------------------------------------------------------------------------
# - Query and Index Statistics Collector -
#track_activities = on
#track_counts = on
#track_io_timing = off
#track_functions = none # none, pl, all
#track_activity_query_size = 1024 # (change requires restart)
#stats_temp_directory = 'pg_stat_tmp'
# - Monitoring -
#log_parser_stats = off
#log_planner_stats = off
#log_executor_stats = off
#log_statement_stats = off
#------------------------------------------------------------------------------
# AUTOVACUUM
#------------------------------------------------------------------------------
#autovacuum = on # Enable autovacuum subprocess? 'on'
# requires track_counts to also be on.
#log_autovacuum_min_duration = -1 # -1 disables, 0 logs all actions and
# their durations, > 0 logs only
# actions running at least this number
# of milliseconds.
#autovacuum_max_workers = 3 # max number of autovacuum subprocesses
# (change requires restart)
#autovacuum_naptime = 1min # time between autovacuum runs
#autovacuum_vacuum_threshold = 50 # min number of row updates before
# vacuum
#autovacuum_analyze_threshold = 50 # min number of row updates before
# analyze
#autovacuum_vacuum_scale_factor = 0.2 # fraction of table size before vacuum
#autovacuum_analyze_scale_factor = 0.1 # fraction of table size before analyze
#autovacuum_freeze_max_age = 200000000 # maximum XID age before forced vacuum
# (change requires restart)
#autovacuum_multixact_freeze_max_age = 400000000 # maximum multixact age
# before forced vacuum
# (change requires restart)
#autovacuum_vacuum_cost_delay = 2ms # default vacuum cost delay for
# autovacuum, in milliseconds;
# -1 means use vacuum_cost_delay
#autovacuum_vacuum_cost_limit = -1 # default vacuum cost limit for
# autovacuum, -1 means use
# vacuum_cost_limit
#------------------------------------------------------------------------------
# CLIENT CONNECTION DEFAULTS
#------------------------------------------------------------------------------
# - Statement Behavior -
#client_min_messages = notice # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# log
# notice
# warning
# error
#search_path = '"$user", public' # schema names
#row_security = on
#default_tablespace = '' # a tablespace name, '' uses the default
#temp_tablespaces = '' # a list of tablespace names, '' uses
# only default tablespace
#check_function_bodies = on
#default_transaction_isolation = 'read committed'
#default_transaction_read_only = off
#default_transaction_deferrable = off
#session_replication_role = 'origin'
#statement_timeout = 0 # in milliseconds, 0 is disabled
#lock_timeout = 0 # in milliseconds, 0 is disabled
#idle_in_transaction_session_timeout = 0 # in milliseconds, 0 is disabled
#vacuum_freeze_min_age = 50000000
#vacuum_freeze_table_age = 150000000
#vacuum_multixact_freeze_min_age = 5000000
#vacuum_multixact_freeze_table_age = 150000000
#vacuum_cleanup_index_scale_factor = 0.1 # fraction of total number of tuples
# before index cleanup, 0 always performs
# index cleanup
#bytea_output = 'hex' # hex, escape
#xmlbinary = 'base64'
#xmloption = 'content'
#gin_fuzzy_search_limit = 0
#gin_pending_list_limit = 4MB
# - Locale and Formatting -
#datestyle = 'iso, mdy'
#intervalstyle = 'postgres'
#timezone = 'GMT'
#timezone_abbreviations = 'Default' # Select the set of available time zone
# abbreviations. Currently, there are
# Default
# Australia (historical usage)
# India
# You can create your own file in
# share/timezonesets/.
#extra_float_digits = 1 # min -15, max 3; any value >0 actually
# selects precise output mode
#client_encoding = sql_ascii # actually, defaults to database
# encoding
# These settings are initialized by initdb, but they can be changed.
#lc_messages = 'C' # locale for system error message
# strings
#lc_monetary = 'C' # locale for monetary formatting
#lc_numeric = 'C' # locale for number formatting
#lc_time = 'C' # locale for time formatting
# default configuration for text search
#default_text_search_config = 'pg_catalog.simple'
# - Shared Library Preloading -
#shared_preload_libraries = '' # (change requires restart)
#local_preload_libraries = ''
#session_preload_libraries = ''
#jit_provider = 'llvmjit' # JIT library to use
# - Other Defaults -
#dynamic_library_path = '$libdir'
#------------------------------------------------------------------------------
# LOCK MANAGEMENT
#------------------------------------------------------------------------------
#deadlock_timeout = 1s
#max_locks_per_transaction = 64 # min 10
# (change requires restart)
#max_pred_locks_per_transaction = 64 # min 10
# (change requires restart)
#max_pred_locks_per_relation = -2 # negative values mean
# (max_pred_locks_per_transaction
# / -max_pred_locks_per_relation) - 1
#max_pred_locks_per_page = 2 # min 0
#------------------------------------------------------------------------------
# VERSION AND PLATFORM COMPATIBILITY
#------------------------------------------------------------------------------
# - Previous PostgreSQL Versions -
#array_nulls = on
#backslash_quote = safe_encoding # on, off, or safe_encoding
#escape_string_warning = on
#lo_compat_privileges = off
#operator_precedence_warning = off
#quote_all_identifiers = off
#standard_conforming_strings = on
#synchronize_seqscans = on
# - Other Platforms and Clients -
#transform_null_equals = off
#------------------------------------------------------------------------------
# ERROR HANDLING
#------------------------------------------------------------------------------
#exit_on_error = off # terminate session on any error?
#restart_after_crash = on # reinitialize after backend crash?
#data_sync_retry = off # retry or panic on failure to fsync
# data?
# (change requires restart)
#------------------------------------------------------------------------------
# CONFIG FILE INCLUDES
#------------------------------------------------------------------------------
# These options allow settings to be loaded from files other than the
# default postgresql.conf.
#include_dir = 'conf.d' # include files ending in '.conf' from
# directory 'conf.d'
#include_if_exists = 'exists.conf' # include file only if it exists
#include = 'special.conf' # include file
#------------------------------------------------------------------------------
# CUSTOMIZED OPTIONS
#------------------------------------------------------------------------------
# Add settings for extensions hereThat's it, you can start the containers with the command docker-compose up -d. Or in a separate console with the command docker-compose up.
So, we have installed the packages, started the database, and now we need to connect them. For this, you need to add a file named ormconfig.js to the root of the project with the following content:
ormconfig.js
const process = require('process');

const username = process.env.POSTGRES_USER || "postgres";
const password = process.env.POSTGRES_PASSWORD || "example";

module.exports = {
  "type": "postgres",
  "host": "localhost",
  "port": 5432,
  username,
  password,
  "database": "postgres",
  "synchronize": true,
  "dropSchema": false,
  "logging": true,
  "entities": [__dirname + "\/src\/**\/*.entity.ts", __dirname + "\/dist\/**\/*.entity.js"],
  "migrations": ["migrations\/**\/*.ts"],
  "subscribers": ["subscriber\/**\/*.ts", "dist\/subscriber\/**\/*.js"],
  "cli": {
    "entitiesDir": "src",
    "migrationsDir": "migrations",
    "subscribersDir": "subscriber"
  }
}
This configuration will be used for the TypeORM CLI.
Let's delve into this configuration in detail. In lines 3 and 4, we retrieve the username and password from the environment variables. This is convenient when you have multiple environments (dev, stage, prod, etc.). By default, the username is postgres and the password is example. The rest of the config is trivial, so we will only focus on the most interesting parameters:
- synchronize — indicates whether the database schema should be automatically created when the application starts. Be careful with this option and do not use it in production, as you may lose data. This option is handy during development and debugging of the application. Alternatively, you can use the command
schema:syncfrom the TypeORM CLI. - dropSchema — drops the schema every time a connection is established. Just like the previous one, this option should only be used during the development and debugging of the application.
- entities — the paths to search for model descriptions. Note that pattern matching is supported.
- cli.entitiesDir — the directory where models created from the TypeORM CLI should be stored by default.
For us to use all features of TypeORM in our Nest application, we need to import the TypeOrmModule i AppModule. That is, your AppModule se således ud:
app.module.ts
import { Module } from '@nestjs/common';
import { AppController } from './app.controller';
import { AppService } from './app.service';
import { TypeOrmModule } from '@nestjs/typeorm';
import * as process from "process";

const username = process.env.POSTGRES_USER || 'postgres';
const password = process.env.POSTGRES_PASSWORD || 'example';

@Module({
  imports: [
    TypeOrmModule.forRoot({
      type: 'postgres',
      host: 'localhost',
      port: 5432,
      username,
      password,
      database: 'postgres',
      entities: [__dirname + '/**/*.entity{.ts,.js}'],
      synchronize: true,
    }),
  ],
  controllers: [AppController],
  providers: [AppService],
})
export class AppModule {}
Som du måske har bemærket, i metoden forRoot sendes den samme konfiguration til databasen, som i filen ormconfig.ts
Der er kun et sidste touch — vi skal tilføje nogle opgaver til TypeORM i package.json. Problemet er, at CLI'en er skrevet i JavaScript og kører i en Node.js-miljø. Men alle vores modeller og migrationer vil være skrevet i TypeScript. Så vi skal transpile vores migrationer og modeller før vi bruger CLI. Derfor har vi brug for pakken ts-node:
yarn add -D ts-node
Derefter tilføjer vi de nødvendige kommandoer i package.json:
"typeorm": "ts-node -r tsconfig-paths/register ./node_modules/typeorm/cli.js",
"migration:generate": "yarn run typeorm migration:generate -n",
"migration:create": "yarn run typeorm migration:create -n",
"migration:run": "yarn run typeorm migration:run"
Den første kommando, typeorm, tilføjer en wrapper i form af ts-node til at køre TypeORM CLI. De andre kommandoer er praktiske genveje, som du som udvikler vil bruge næsten dagligt:
migration:generate — oprettelse af migration baseret på ændringer i dine modeller.
migration:create — oprettelse af en tom migration.
migration:run — udførelse af migrationer.
Nu er vi helt færdige, vi har tilføjet de nødvendige pakker, konfigureret applikationen til at arbejde med databasen både fra CLI og fra applikationen, samt startet databasen. Det er tid til at tilføje logik til vores applikation.
Installation af pakker til oprettelse af CRUD
Ved kun at bruge Nest kan du oprette et API, der tillader oprettelse, læsning, opdatering og sletning af en entitet. Denne løsning vil være så fleksibel som muligt, men i nogle tilfælde kan det være overflødigt. For eksempel, hvis du hurtigt skal oprette en prototype, kan det ofte være nødvendigt at ofre fleksibilitet for udviklingshastighed. Mange rammer tilbyder funktionalitet til at generere CRUD baseret på beskrivelsen af datamodel for en given entitet. Og Nest er ingen undtagelse! Denne funktionalitet leveres af pakken . Dens muligheder er meget interessante:
- nem installation og opsætning;
- uafhængighed af databasen;
- en kraftfuld forespørgsels-sprog med mulighed for filtrering, paginering, sortering, indlæsning af relationer og indlejrede enheder, caching osv.;
- et paket til at danne forespørgsler på front-end;
- nem overskrivning af controller-metoder;
- en lille konfiguration;
- support for swagger dokumentation.
Funktionaliteten er opdelt i flere pakker:
- — en grundpakke, der giver dekoreringsmetoden () til at generere ruter, konfigurere og validere;
- — et paket, der leverer en builder/parser til forespørgsler til brug på frontend-siden;
- — et paket til integration med TypeORM, der tilbyder den basale service TypeOrmCrudService med CRUD-metoder til at arbejde med enheder i databasen.
I denne vejledning vil vi bruge pakkerne jsx/crud og jsx/crud-typeorm. For at komme i gang, lad os installere dem
yarn add @nestjsx/crud class-transformer class-validatorPakker og er i denne applikation nødvendige for deklarativ beskrivelse af transformationsregler for modelinstanser og validering af indkommende forespørgsler. Disse pakker kommer fra samme forfatter, så grænsefladerne er ens.
Direkte implementering af CRUD
Som eksempelmodel vil vi tage en liste over brugere. Brugerne vil have følgende felter: id, brugernavn, displayName, email. id — et auto-increment felt, email og brugernavn — unikke felter. Det er enkelt! Nu er det tid til at realisere vores idé som en Nest-applikation.
Først skal vi oprette et modul brugere, der skal håndtere brugerne. Vi bruger CLI'en fra NestJS, og i roden af vores projektmappe udfører vi kommandoen nest g module users.
nest g module users
dmitrii@dmitrii-HP-ZBook-17-G3:~/projects/nest-rest git:(master*)$ nest g module users
CREATE /src/users/users.module.ts (82 bytes)
UPDATE /src/app.module.ts (312 bytes)
I dette modul tilføjer vi en mappe til enheder, hvor vi vil gemme modellerne for dette modul. Især tilføjer vi her filen user.entity.ts med beskrivelsen af brugerens model:
user.entity.ts
import { Column, Entity, PrimaryGeneratedColumn } from 'typeorm';

@Entity()
export class User {
  @PrimaryGeneratedColumn()
  id: string;

  @Column({unique: true})
  email: string;

  @Column({unique: true})
  username: string;

  @Column({nullable: true})
  displayName: string;
}
For at vores applikation kan "se" denne model, skal vi importere den i modulet UsersModule users.module.ts TypeOrmModule med følgende indhold:
import { Module } from '@nestjs/common'; import { UsersController } from './controllers/users/users.controller'; import { UsersService } from './services/users/users.service'; import { TypeOrmModule } from '@nestjs/typeorm'; import { User } from './entities/user.entity';@Module({ controllers: [UsersController], providers: [UsersService], imports: [ TypeOrmModule.forFeature([User]) ] }) export class UsersModule {}
Det vil sige, her importerer viТ.е здесь мы импортируем TypeOrmModule, hvor vi angiver listen over modeller, der tilhører denne modul. forFeature med hensyn til dette modul.
Det eneste, der er tilbage, er at oprette den relevante enhed i databasen. Migration-mekanismen hjælper os med det. For at oprette en migration baseret på ændringerne i modellerne, skal du køre kommandoen npm run migration:generate -- CreateUserTable:
Spoileroverskrift
$ npm run migration:generate -- CreateUserTable
Migration /home/dmitrii/projects/nest-rest/migrations/1563346135367-CreateUserTable.ts er blevet genereret med succes.
Færdig på 1.96s.
Vi skulle ikke skrive migrationen manuelt, alt skete på magisk vis. Er det ikke vidunderligt! Men det er ikke alt. Lad os tage et kig på den genererede migrations fil:
1563346135367-CreateUserTable.ts
import {MigrationInterface, QueryRunner} from "typeorm";

export class CreateUserTable1563346816726 implements MigrationInterface {

    public async up(queryRunner: QueryRunner): Promise {
        await queryRunner.query(`CREATE TABLE "user" ("id" SERIAL NOT NULL, "email" character varying NOT NULL, "username" character varying NOT NULL, "displayName" character varying, CONSTRAINT "UQ_e12875dfb3b1d92d7d7c5377e22" UNIQUE ("email"), CONSTRAINT "UQ_78a916df40e02a9deb1c4b75edb" UNIQUE ("username"), CONSTRAINT "PK_cace4a159ff9f2512dd42373760" PRIMARY KEY ("id"))`);
    }

    public async down(queryRunner: QueryRunner): Promise {
        await queryRunner.query(`DROP TABLE "user"`);
    }

}
Som man kan se, er der ikke kun blevet automatisk genereret en metode til at køre migrationen, men også en metode til at rulle den tilbage. Fantastisk!
Det er kun tilbage at anvende denne migration. Det gøres med følgende kommando:
npm run migration:run.Færdig, nu er ændringerne i skemaet overført til databasen.
Dernæst vil vi oprette en service, der er ansvarlig for arbejdet med brugerne og arve fra TypeOrmCrudService. I parameteren til den overordnede konstruktor skal vi angive repository for den ønskede enhed, i vores tilfælde Bruger repository.
users.service.ts
import { Injectable } from '@nestjs/common';
import { TypeOrmCrudService } from '@nestjsx/crud-typeorm';
import { User } from '../../entities/user.entity';
import { InjectRepository } from '@nestjs/typeorm';
import { Repository } from 'typeorm';

@Injectable()
export class UsersService extends TypeOrmCrudService{
  constructor(@InjectRepository(User) usersRepository: Repository){
    super(usersRepository);
  }
}
Denne service vil vi have brug for i controlleren brugere. For at oprette en controller, skriv i konsollen nest g controller users/controllers/users
nest g controller users/controllers/users
dmitrii@dmitrii-HP-ZBook-17-G3:~/projects/nest-rest git:(master*)$ nest g controller users/controllers/users
CREATE /src/users/controllers/users/users.controller.spec.ts (486 bytes)
CREATE /src/users/controllers/users/users.controller.ts (99 bytes)
UPDATE /src/users/users.module.ts (188 bytes)
Lad os åbne denne controller og redigere den for at tilføje lidt magi jsx/crud. Til klassen UsersController tilføjer vi en dekorerende tilstand som følger:
@Crud({
  model: {
    type: User
  }
}) — er en dekorator, der tilføjer de nødvendige metoder til controlleren for at arbejde med modellen. Modellen specificeres i feltet model.type for dekoratorens konfiguration.
Det andet skridt er at implementere grænsefladen CrudController. "I samlet form" ser koden for controlleren således ud:
import { Controller } from '@nestjs/common';
import { Crud, CrudController } from '@nestjsx/crud';
import { User } from '../..//entities/user.entity';
import { UsersService } from '../..//services/users/users.service';

@Crud({
  model: {
    type: User
  }
})
@Controller('users')
export class UsersController implements CrudController{
  constructor(public service: UsersService){}
}
Og det er alt! Nu understøtter controlleren hele sæt af operationer med modellen! Tvivler du? Lad os prøve vores applikation i aktion!
Oprettelse af forespørgselsscenario i TestMace
Til at teste vores service vil vi bruge en IDE til at arbejde med API . Hvorfor TestMace? Sammenlignet med lignende produkter har det følgende fordele:
- kraftig håndtering af variabler. Der findes i øjeblikket flere typer variabler, hver med sin specifikke rolle: indbyggede variabler, dynamiske variabler, miljøvariabler. Hver variabel tilhører en eller anden node med støtte til arveregler;
- nem oprettelse af scripts uden programmering. Dette vil blive dækket nedenfor;
- menneskeleseligt format, der gør det muligt at gemme projektet i versionskontrolsystemer;
- autoudfyldning, syntaksfremhævning, fremhævning af variabelværdier;
- understøttelse af API-beskrivelse med mulighed for import fra Swagger.
Lad os starte vores server med kommandoen npm start og prøve at tilgå brugerlistene. Ifølge vores controllerkonfiguration kan brugerlisten fås ved url localhost:3000/users. Lad os lave en forespørgsel til denne url.
Efter opstart af TestMace kan du se et sådant interface:
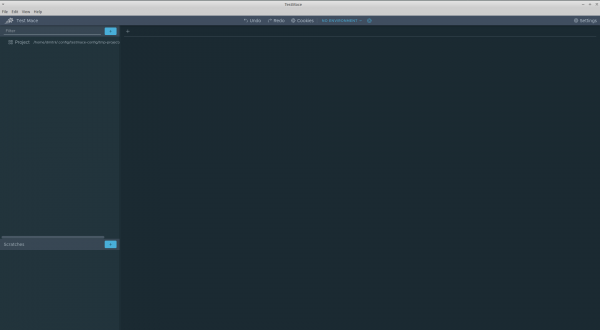
Til venstre oppe er der et projekttræ med rodnoden . Lad os forsøge at oprette den første forespørgsel om at hente brugerlisten. For at gøre dette skal vi oprette en node. Dette gøres i kontekstmenuen for Project-noden Add node -> RequestStep.
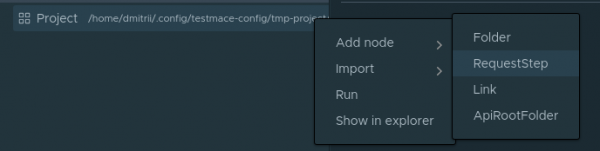
I URL-feltet indsætter du localhost:3000/users og udfører forespørgslen. Vi får 200 kode med en tom matrix i svaret. Det giver mening, da vi endnu ikke har tilføjet nogen.
Lad os oprette et scenario, der vil inkludere følgende trin:
- oprettelse af en bruger;
- forespørgsel efter id på den lige oprettede bruger;
- sletning efter id af brugeren, der blev oprettet i trin 1.
Lad os komme i gang. For nemheds skyld opretter vi en node af typen . Det er reelt bare en mappe, hvor vi gemmer hele scriptet. For at oprette en mappe-node skal vi vælge Tilføj node -> Mappe. Lad os kalde noden check-create. Inden i noden check-create opretter vi vores første anmodning om at oprette en bruger. Lad os kalde den nyoprettede node create-user. Så i øjeblikket vil hierarkiet af noder se sådan ud:
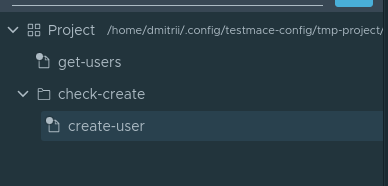
Lad os gå til fanen for den åbne create-user node. Vi indtaster følgende parametre til anmodningen:
- Anmodningstype — POST
- URL — localhost:3000/users
- Body — JSON med værdien
{"email": "user@user.com", "displayName": "New user", "username": "user"}
Vi udfører denne anmodning. Vores applikation siger, at registreringen er oprettet.
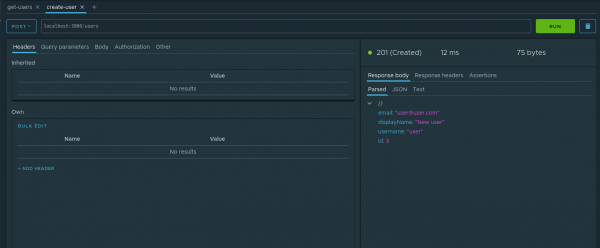
Lad os tjekke denne kendsgerning. For at kunne arbejde med id'et for den oprettede bruger i de følgende trin, er det nødvendigt at gemme denne parameter. Mecanismen er perfekt til dette. Lad os på vores eksempel se, hvordan vi arbejder med dem. I fanen parsed af svaret i nodens kontekstmenu skal du vælge elementet Assign to variable. I dialogboksen skal du angive følgende parametre:
- Node — hvilken af forfædrene der skal oprettes en dynamisk variabel i. Vi vælger check-create
- Variable name — navnet på denne variabel. Lad os kalde den
userId.
Sådan ser processen for oprettelse af en dynamisk variabel ud:
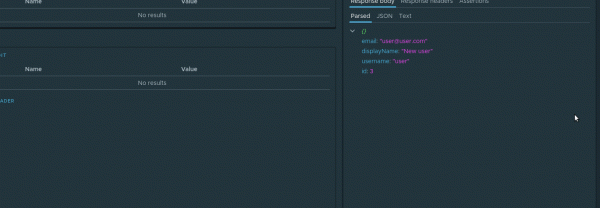
Nu vil værdien af den dynamiske variabel blive opdateret hver gang, denne anmodning udføres. Og da dynamiske variable understøtter mekanismen for hierarkisk arv, vil variablen userId være tilgængelig i efterfølgere check-create af noden på enhver niveau af indlejring.
I den næste anmodning får vi brug for denne variabel. Mere specifikt vil vi anmode om den nyoprettede bruger. Som efterkommer af noden check-create vil vi oprette anmodningen check-if exists with the parameter url lig med localhost:3000/users/${$dynamicVar.userId}. Konstruktionsformen ${variable_name} er at hente værdien af variablen. Da vi har en dynamisk variabel, skal vi for at hente den henvise til objektet $dynamicVar, dvs. den fulde henvisning til den dynamiske variabel userId vil se således ud ${$dynamicVar.userId}. Vi udfører anmodningen og bekræfter, at dataene forespørges korrekt.
Der sidste detalje er at lave en forespørgsel om sletning. Vi har brug for den ikke kun for at teste sletningsfunktionen, men også for at rydde op i databasen, da felterne email og username er unikke. Så lad os i noden check-create oprette en delete-user-forespørgsel med følgende parametre
- Forespørgselstype — DELETE
- URL —
localhost:3000/users/${$dynamicVar.userId}
Vi starter. Venter. Nyder resultatet)
Og nu kan vi til enhver tid køre dette scenarie fuldt ud. For at starte scenariet skal vi vælge i kontekstmenuen check-create punktet Kør.
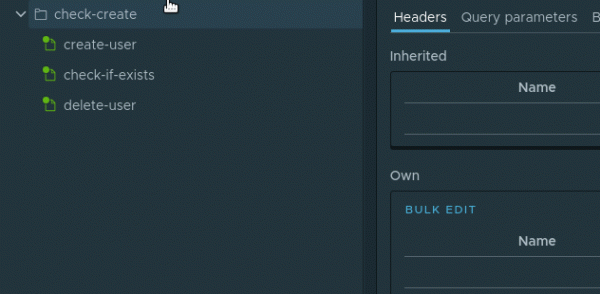
Noderne i scenariet vil udføre rækkefølge for rækkefølge
Dette scenarie kan du gemme i dit projekt ved at udføre File -> Save project.
Konklusion
I denne artikels format kunne alle funktionerne for de anvendte værktøjer simpelthen ikke være plads til. Hvad angår den primære synder — pakken jsx/crud — de følgende emner er forblevet ubelyst:
- tilpasset validering og transformation af modeller;
- et kraftfuldt forespørgselssprog og nem anvendelse på frontend;
- omdefinition og tilføjelse af nye metoder i crud-controllere;
- understøttelse af swagger;
- styring af caching.
Men selv det, der er beskrevet i artiklen, er tilstrækkeligt til at forstå, at selv et enterprise-rammeværk som NestJS har værktøjer til hurtig prototyping af applikationer i baghånden. Og en så fantastisk IDE som gør det muligt at holde det angivne tempo.
Kildekoden til denne artikel, sammen med projektet , er tilgængelig i lageret . For at åbne projektet er det nok at udføre i applikationen File -> Open project.
Kilde: habr.com
