

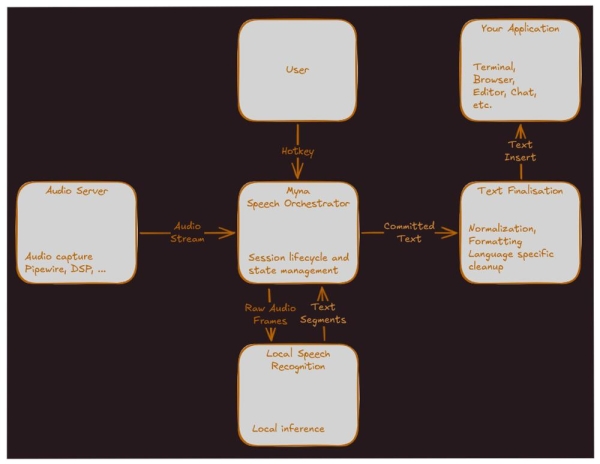
Canonical har præsenteret et projekt Myna — et nyt system til tale-til-tekst konvertering til Ubuntu Desktop. Projektet fokuserer på indbygget diktering: brugeren trykker på en genvejstast, taler, og den erkendte tekst vises i den aktive applikation. I annoncen understreges det, at Myna skal føles som en naturlig del af Ubuntu-skrivebordet og samtidig tage hensyn til brugerens privatliv. Listen over understøttede input-sprog er ikke offentliggjort på tidspunktet for nyhedens udgivelse.
Det første mål for projektet er Ubuntu 26.10. På dette stadie forsøger Canonical ikke at skabe en fuld stemmeassistent eller et system til skrivbordskontrol via stemme. Udviklerne har bevidst begrænset området for den første version til grundlæggende, pålidelig diktering: trykke på en genvejstast, sige teksten og få resultatet i det aktuelle inputfelt. Den primære testmiljø er Ubuntu Desktop på Wayland med GNOME, men arkitekturen planlægges at være fleksibel nok til fremtidig understøttelse af andre skrivebordsmiljøer.
Myna er designet til lokal talegenkendelse. Efter installation af de nødvendige modeller kræves der ikke internetforbindelse for dikteringen at fungere, mikrofonen skal kun bruges efter aktivéring fra brugeren, lyden behandles i hukommelsen og kasseres derefter, og optagelser sendes ikke til eksterne tjenester. I projektets specifikation er det også angivet, at løsningen skal undgå at gemme lyd som standard og ikke må skifte til en cloud-tjeneste uset.
Koden og dokumentationen for Myna er offentliggjort i Canonical's arkiv på GitHub. Projektet beskrives som en let svejse-app til tale-til-tekst for Ubuntu Desktop og distribueres under GPL-3.0 licensen. Projektet er dog i en tidlig fase: der er ikke publicerede versioner i arkivet endnu, og den arkitektoniske specifikation har status som Proposed.
Nøglefunktioner og karakteristika ved Myna
Push-to-talk diktering. Brugeren holder en konfigurerbar genvejstast nede, taler, og systemet indsætter den erkendte tekst i det valgte inputfelt. Dikteringen slutter, når tasten slippes.
Lokal talegenkendelse. Genkendelsen udføres på brugerens maskine gennem en lokal inference-stack. Dette reducerer afhængigheden af cloud og gør det muligt at arbejde offline efter installationen af modellerne.
Privat behandling af lyd. Mikrofonen aktiveres kun under brugerens dikteringssession. Lyd skal som standard ikke optages på disken, der anvendes en begrænset hukommelsespuffer, som tømmes efter sessionens afslutning.
Visuel aktivitetsindikator. Under optagelse og transskription skal brugeren se en forståelig tilstandsindikator. I specifikationen nævnes tilstande som Optager, Transskriberer, Afslutter og Fejl.
Indsættelse af kun stabil tekst. I den første implementering må mellemhypoteser for genkendelse ikke indsættes direkte i applikationen. Kun den bekræftede endelige tekst sendes til det målrettede felt.
Postbehandling af tekst. Den rå transkription kan gennemgå normalisering, tegnsætning, kapitalisering, formatering og omdannelsen af mundtlige former til skriftlige, f.eks. “twenty two” → “22”.
Valg af dikteringssprog. Systemet skal understøtte et tilpasset dikteringssprog, der som standard baserer sig på brugergrænsefladens sprog, hvis der er tilgængelig en passende model.
Modelkvalitetsprofiler. Specifikationen omfatter forskellige profiler for modeller: en let variant med lavere ressourcforbrug, en afbalanceret standardprofil og en mere kvalitetsorienteret, men tungere variant.
Sikker arbejde med indtastningsfokus. Målet for tekstindsættelse vælges i starten af sessionen. Hvis vinduets fokus ændres under diktering, må systemet ikke stille og roligt sende tekst til en anden applikation.
Låsning i beskyttede felter. Diktering skal låses i password-felter, autentificeringsvinduer og andre beskyttede steder, hvis applikationen eller toolkit giver mulighed for dette.
Integration med Wayland/GNOME. Den første version er rettet mod Wayland og GNOME. For den indledende tekstindsættelse overvejes IBus, og på sigt planlægges en mere nativen Wayland-vej via input-method/text-input protokoller.
Brugerindstillinger. I det planlagte indstillingsinterface skal der være mulighed for at aktivere/deaktivere STT, vælge genvejstast, dikteringssprog, mikrofon, modelprofil, postbehandlingsmuligheder og aktivitetsindikator.
I den første iteration forbliver vækkelse af nøgleord, konstant baggrundsovervågning, cloud-baseret genkendelse, stemmeassistent, stemmekommandoer, skrivebordsstyring, taleoversættelse, taleridentifikation, automatisk sproggenkendelse og dikteringshistorik uden for projektet. Med andre ord starter Canonical ikke med "AI-assistenten", men med en mere jordnær funktion: lokal stemmeindtastning i almindelige Ubuntu-applikationer.
Kilde: linux.org.ru
