

Du står over for en ny opgave med objektdetektering. Prioriteten er hastighed med acceptabel præcision. Du tager YOLOv3-arkitekturen og finjusterer den. Præcisionen (mAp75) skal være over 0,95. Men hastigheden for kørsel er stadig lav. Damn.
I dag springer vi kvantisering over. Og under overskriften kigger vi på Model Pruning — beskæring af overflødige dele af netværket for at fremskynde inferensen uden at miste præcision. Illustrativt — hvor, hvor meget og hvordan man kan skære. Vi vil se på, hvordan man gør dette manuelt, og hvor man kan automatisere det. Til slut — et repository på keras.
Introduktion
På mit tidligere arbejde, i Perms Macroscop, fik jeg en vane — altid at holde øje med udførelsestiden for algoritmer. Og jeg tjekker altid tiden for netværk gennem en rimelighedstest. Normalt klarer state-of-the-art ikke denne test i produktion, hvilket førte mig til Pruning.
Pruning er et gammelt emne, der blev præsenteret i i 2017. Hovedideen er at reducere størrelsen på det trænede netværk uden at miste præcision ved at fjerne forskellige noder. Det lyder godt, men jeg hører sjældent om dets anvendelse. Måske mangler der implementationer, eller der er ikke artikler på russisk, eller måske mener alle, at pruning er en hemmelighed og holder det skjult.
Men lad os dykke ind i det
Et kig ind i biologi
Jeg elsker, når der i Deep Learning tages ideer fra biologien. Som med evolutionen kan man stole på dem (vidste du, at ReLU ligner meget på ?)
Processen med Model Pruning er også tæt knyttet til biologi. Netværkets reaktion her kan sammenlignes med hjernens plastisitet. Der er nogle interessante eksempler i bogen :
- Hjernen hos en kvinde, der siden fødslen kun havde den ene hjernehalvdel, omprogrammerede sig selv til at udføre funktioner fra den manglende hjernehalvdel.
- En fyr skød en del af sin hjerne, som var ansvarlig for synet. Over tid overtog andre dele af hjernen disse funktioner. (vi prøver ikke at gentage)
Således kan du også skære svage convolutioner fra din model. I værste fald vil de resterende convolutioner hjælpe med at erstatte de skårne.
Elsker du Transfer Learning eller træner du fra bunden?
Mulighed nummer ét. Du bruger Transfer Learning på Yolov3, Retina, Mask-RCNN eller U-Net. Men oftest har vi ikke brug for at genkende 80 objektklasser, som i COCO. I min erfaring er det ofte 1-2 klasser. Man kan antage, at arkitekturen til 80 klasser her er overflødig. Det giver mening at overveje at reducere arkitekturen. Desuden vil jeg gerne gøre det uden at miste de forudtrænede vægte.
Variant nummer to. Måske har du mange data og beregningsressourcer, eller måske har du blot brug for en supertilpasset arkitektur. Uanset hvad, så træner du netværket fra bunden. Den sædvanlige rækkefølge er at se på datastrukturen, vælge en OVERFLØDIG arkitektur og trykke dropout for at undgå overfitting. Jeg har set dropouts på 0.6, Karl.
I begge tilfælde kan netværket reduceres. Det motiverede os. Nu skal vi undersøge, hvad pruning indebærer.
Generel algoritme
Vi besluttede, at vi kan fjerne convolutioner. Det ser ganske simpelt ud:
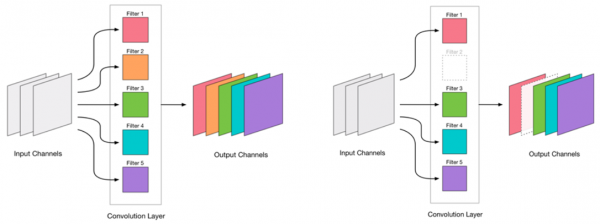
At fjerne en hvilken som helst convolution er en stressfaktor for netværket, som normalt fører til en vis stigning i fejlen. På den ene side er denne fejlstigning et tegn på, hvor korrekt vi fjerner convolutionerne (for eksempel siger en stor stigning, at vi gør noget forkert). Men en lille stigning er helt acceptabel og kan ofte afhjælpes med efterfølgende let finjustering med en lille LR. Vi tilføjer et fintunings trin:
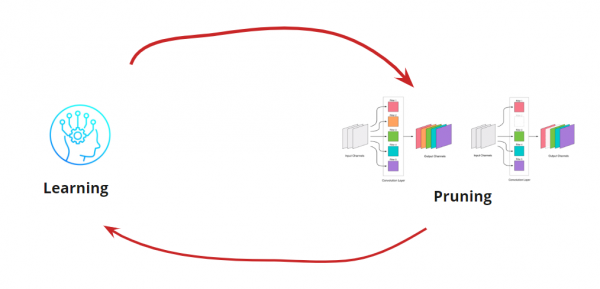
Nu skal vi forstå, hvornår vi vil stoppe vores LearningPruning cyklus. Her kan der være eksotiske muligheder, hvor vi ønsker at reducere netværket til en bestemt størrelse og hastighed (for eksempel til mobile enheder). Men den mest almindelige mulighed er at fortsætte cyklussen, indtil fejlen overstiger det acceptable niveau. Vi tilføjer en betingelse:
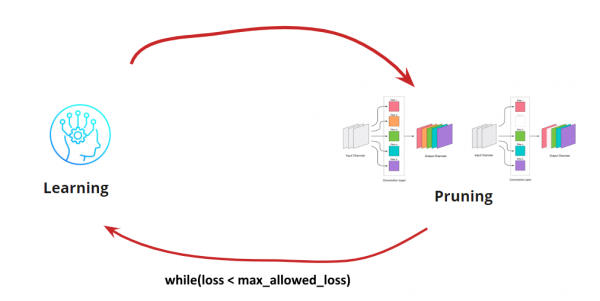
Så algoritmen bliver klar. Det er tilbage at finde ud af, hvordan man bestemmer, hvilke convolutioner der skal fjernes.
Søgning efter fjernbare convolutioner
Vi skal fjerne nogle convolutioner. At rush fremad og "skyde" hvilken som helst er en dårlig idé, selvom det vil fungere. Men da vi har en hjerne, kan vi tænke og forsøge at identificere "svage" convolutioner til fjernelse. Der er flere muligheder:
- . Ideen er, at convolutioner med små vægtværdier bidrager lidt til den endelige beslutning.
- Mindste L1-måling under hensyntagen til gennemsnit og standardafvigelse. Supplerer vurderingen af fordelingens karakter.
- . Mere præcis bestemmelse af uvæsentlige konvolutter, men meget tids- og ressourcekrævende.
- ReadinessGate
Hver af mulighederne har ret til at eksistere og sine implementeringsspecifikationer. Her ser vi på muligheden med den mindste L1-metric
Manuel proces for YOLOv3
I den oprindelige arkitektur er der residualblokke. Men uanset hvor imponerende de er for dybe netværk, kan de være problematic for os. Problemet er, at vi ikke kan fjerne konvolutter med forskellige indekser i disse lag:
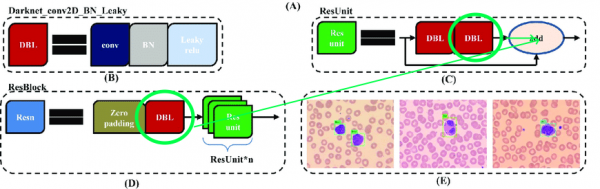
Derfor vil vi fremhæve de lag, hvorfra vi frit kan fjerne konvolutter:

Lad os nu bygge arbejdscyklussen:
- Eksporterer aktiveringer
- Vurderer, hvor meget der skal skæres
- Skærer
- Træner i 10 epoker med LR=1e-4
- Testning
At eksportere konvolutter er nyttigt for at vurdere, hvilken del vi kan fjerne på en bestemt trin. Eksempler på eksport:
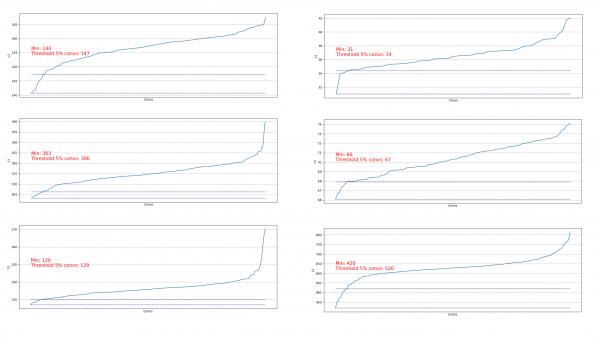
Vi ser, at næsten overalt har 5% af konvolutterne en meget lav L1-norm, og vi kan fjerne dem. På hvert trin blev denne eksport gentaget, og der blev foretaget en vurdering af, hvilke lag og hvor mange der kunne skæres.
Hele processen var opdelt i 4 trin (her og alle steder tal for RTX 2060 Super):
| Trin | mAp75 | Antal parametre, mio | Netværksstørrelse, mb | Fra den oprindelige, % | Køretid, ms | Betingelse for beskæring |
|---|---|---|---|---|---|---|
| 0 | 0.9656 | 60 | 241 | 100 | 180 | — |
| 1 | 0.9622 | 55 | 218 | 91 | 175 | 5% af alle |
| 2 | 0.9625 | 50 | 197 | 83 | 168 | 5% af alle |
| 3 | 0.9633 | 39 | 155 | 64 | 155 | 15% for lag med 400+ konvolutter |
| 4 | 0.9555 | 31 | 124 | 51 | 146 | 10% for lag med 100+ konvolutter |
Ved trin 2 opstod der en positiv effekt — batch-størrelse 4 blev muligt i hukommelsen, hvilket betydeligt fremskyndede genuddannelsesprocessen.
Ved trin 4 blev processen stoppet, da selv langvarig genuddannelse ikke hævede mAp75 til de gamle værdier.
Som et resultat lykkedes det at fremskynde inferensen med 15%, reducere størrelsen med 35% og ikke miste i nøjagtighed.
Automatisering til enklere arkitekturer
For enklere netværksarkitekturer (uden betingede add, concatenate og residualblokke) kan man helt sikkert fokusere på at bearbejde alle konvolutionslag og automatisere beskæringsprocessen.
Denne mulighed har jeg implementeret .
Det er enkelt: kun tab-funktionen, optimereren og batch-generatorerne er nødvendig:
import pruning
from keras.optimizers import Adam
from keras.utils import Sequence

train_batch_generator = BatchGenerator...
score_batch_generator = BatchGenerator...

opt = Adam(lr=1e-4)
pruner = pruning.Pruner("config.json", "categorical_crossentropy", opt)

pruner.prune(train_batch, valid_batch)
Hvis nødvendigt kan konfigurationsparametrene ændres:
{
    "input_model_path": "model.h5",
    "output_model_path": "model_pruned.h5",
    "finetuning_epochs": 10, # antallet af epoker til træning mellem pruning trin
    "stop_loss": 0.1, # tab for at stoppe processen
    "pruning_percent_step": 0.05, # del af konvolutioner der slettes ved hver pruning trin
    "pruning_standart_deviation_part": 0.2 # skift for at begrænse pruning delen
}
Derudover er der implementeret en begrænsning baseret på standardafvigelsen. Målet er at begrænse den del, der fjernes, og ekskludere konvolutioner med allerede "tilstrækkelige" L1-mål:
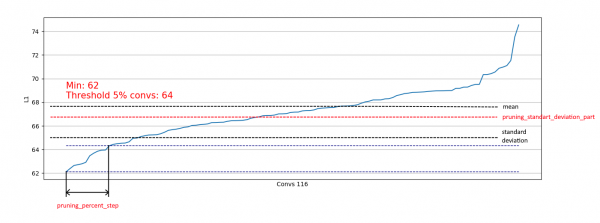
Hermed tillader vi kun svage konvolutioner at blive fjernet fra fordelinger, der ligner den højre, uden at påvirke fjernelsen fra fordelinger, der ligner den venstre:
Når fordelingen nærmer sig normalfordelingen, kan koefficienten pruning_standart_deviation_part vælges fra:
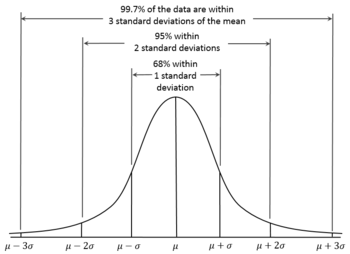
Jeg anbefaler et toleranceniveau på 2 sigmas. Alternativt kan man vælge ikke at tage højde for denne egenskab og lade værdien være < 1.0.
Udgangen resulterer i et diagram over netværkets størrelse, tab og køretid over hele testen, normaliseret til 1.0. For eksempel, her blev netværkets størrelse næsten halveret uden tab af kvalitet (en lille konvolutionel netværk med 100k vægte):
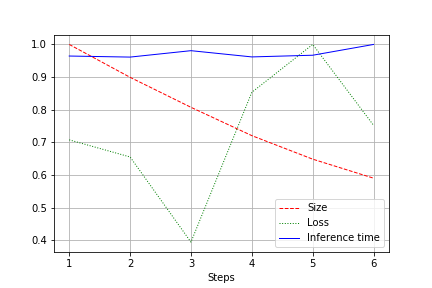
Køretiden er udsat for normale udsving og har stort set ikke ændret sig. Der er en forklaring på dette:
- Antallet af konvolutioner ændres fra mere bekvemme (32, 64, 128) til mindre bekvemme for grafikkort — 27, 51 osv. Her kan jeg tage fejl, men sandsynligvis påvirker det.
- Arkitekturen er ikke bred, men sekventiel. Ved at mindske bredden rører vi ikke dybden. Dette reducerer belastningen, men ændrer ikke hastigheden.
Derfor resulterede forbedringen i en reduktion af CUDA-belastningen under kørslen med 20-30%, men ikke i en reduktion af køretiden.
Resumé
Lad os reflektere. Vi har overvejet 2 varianter af pruning — til YOLOv3 (hvor man må arbejde med hænderne) og til netværk med simplere arkitekturer. Det er tydeligt, at det i begge tilfælde er muligt at reducere netværkets størrelse og opnå hurtigere køretider uden at miste præcision. Resultaterne:
- Reduceret størrelse
- Hurtigere køretid
- Reduceret CUDA-belastning
- Som følge heraf, forbedret miljøvenlighed (Vi optimerer fremtidig brug af beregningsressourcer. Et sted glæder én sig )
Bilag
- Efter pruning-trinnet kan man også finjustere og kvantisere (for eksempel med TensorRT)
- Tensorflow tilbyder muligheder for . Det fungerer.
- jeg ønsker at udvikle mig og vil glæde mig over hjælp
Kilde: habr.com
