

Google har annonceret udgivelsen af den store sprogmodel Gemma, der er bygget ved hjælp af de teknologier, der anvendes til at opbygge chatbotmodellen Gemini, som forsøger at konkurrere med ChatGPT. Modellen fås i fire varianter, der spænder over 2 og 7 milliarder parametre, i basissamt optimerede versioner til dialogsystemer. Varianterne med 2 milliarder parametre er egnede til brug i forbruger-apps og kræver blot CPU til behandling. Varianterne med 7 milliarder parametre kræver mere kraftfuldt udstyr med GPU eller TPU.
Blandt anvendelsesområderne for Gemma-modellen nævnes oprettelse af dialogsystemer og virtuelle assistenter, tekstgenerering, dannelse af svar på spørgsmål stillet på naturligt sprog, sammenfatning og generalisering af indhold, forklaring af begreber og termer, fejlfinding i teksten samt hjælp til sprogindlæring. Der understøttes oprettelse af forskellige typer tekstdata, herunder digte, kode på programmeringssprog, omskrivning af værker med andre ord og dannelse af breve efter skabelon. Modellen har en relativt lille størrelse, som gør det muligt at bruge den på sit eget udstyr med begrænsede ressourcer, for eksempel på almindelige bærbare computere og pc'er.
Licensen til modellen tillader gratis brug og distribution ikke kun i forsknings- og personlige projekter, men også i kommercielle produkter. Der er også tilladt at oprette og offentliggøre modificerede versioner af modellen. Brugsvilkårene forbyder anvendelsen af modellen til skadelige handlinger og foreskriver, at den nyeste version af Gemma skal anvendes i sine produkter, hvis det er muligt.
Støtte til arbejde med Gemma-modellerne er allerede tilføjet til værktøjsættet Transformers og Responsible Generative AI Toolkit. Keras-rammen og backends til TensorFlow, JAX og PyTorch kan anvendes til optimering af modellen. Der er også mulighed for at bruge Gemma med rammerne MaxText, NVIDIA NeMo og TensorRT-LLM.
Den kontekst, som modellen Gemma tager hensyn til, er 8.000 tokens (antallet af tokens, som modellen kan behandle og huske under tekstgenerering). Til sammenligning er størrelsen på konteksten for modellerne Gemini og GPT-4 32.000 tokens, mens modellen GPT-4 Turbo understøtter 128.000 tokens. Modellen understøtter kun engelsk. Med hensyn til ydeevne er modellen Gemma-7B lidt bagud sammenlignet med modellen LLama 2 70B Chat og lidt foran modellerne DeciLM-7B, PHI-2 (2.7B) og Mistral-7B-v0.1. Sammenlignet med Google er modellen Gemma-7B lidt foran LLama 2 7B/13B og Mistral-7B.
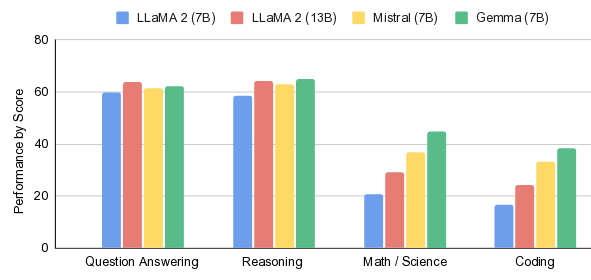
Kilde: opennet.ru
