

Kvantcomputere og kvanteberegning er et nyt , som er blevet tilføjet til vores informationsrum sammen med , og andre højteknologiske termer. Alligevel har jeg ikke været i stand til at finde materiale på internettet, der kunne samle brikkerne i mit hoved med titlen “hvordan fungerer kvantcomputere”. Ja, der er mange fremragende værker, herunder på Habr (se. ), hvis kommentarer, som det ofte er tilfældet, er endnu mere informative og nyttige, men billedet i mit hoved, så at sige, faldt ikke på plads.
For nylig kom kolleger til mig og spurgte “Forstår du, hvordan en kvantcomputer fungerer? Kan du fortælle os det?” Og her indså jeg, at problemet med at samle et klart billede ikke kun findes hos mig.
Som et resultat blev der gjort et forsøg på at kompilere information om kvantcomputere i et sammenhængende logisk skema, hvor der på et grundlæggende niveau, uden dybdegående dykning i matematik og strukturen af kvanteverdenen, forklares, hvad en kvantcomputer er, hvilke principper den fungerer på, samt hvilke problemer forskere står over for ved dens skabelse og brug.
Indholdsfortegnelse
Fraskrivelse
Forfatteren er ikke specialist i kvanteberegning, og den målrettede læserskare for artiklen er IT-folk, ikke kvantespecialister, der også ønsker at samle et klart billede med titlen “Hvordan fungerer kvantcomputere”. Af denne grund er mange begreber i artiklen bevidst forenklet for bedre at forstå kvante-teknologier på et “grundlæggende” niveau, men uden .
I artiklen bruges der på nogle steder materialer fra andre kilder, Overalt, hvor det var muligt, er der indsat direkte links og henvisninger til den originale tekst, tabel eller figur. Hvis der er noget (eller nogen), jeg har glemt, så skriv til mig — jeg vil rette det.
Introduktion
I dette kapitel vil vi kort se på, hvordan den kvantiske æra startede, hvad der var den drivende kraft bag idéen om kvantecomputer, hvilke lande og virksomheder der i øjeblikket er de førende aktører på dette område, samt kort diskutere de vigtigste retninger inden for udviklingen af kvanteberegninger.
Hvordan det hele begyndte
Udgangspunktet for den kvantiske æra anses for at være året 1900, hvor M. Planck først fremsatte om at energi ikke udsendes og absorberes kontinuerligt, men i separate kvanta (portioner). Ideen blev grebet og videreudviklet af mange fremtrædende videnskabsmænd i den tid — Bohr, Einstein, Heisenberg, Schrödinger, hvilket til sidst førte til skabelsen og udviklingen af det, vi i dag kender som . Der er mange gode materialer på nettet om opståen af kvantefysik som videnskab; i denne artikel vil vi ikke gå ind i detaljer om dette, men det var nødvendigt at angive datoen, hvor vi gik ind i den nye kvantæra.
Kvantafysik har bragt mange opfindelser og teknologier ind i vores dagligdag, som det er svært at forestille sig vores omgivelser uden i dag. For eksempel laseren, som nu bruges overalt, fra husholdningsapparater (laser nivelleringsværktøjer osv.) til højteknologiske systemer (lasere til synskorrektion, hej ). Det ville være logisk at antage, at før eller senere ville nogen komme med idéen om, hvorfor man ikke bruger kvantesystemer til beregninger. Og i 1980 skete det.
Wikipedia angiver, at den første, der fremsatte idéen om kvanteberegninger, var vores forsker Yuri Manin i 1980. Men det var først i 1981, at der blev talt alvorligt om det, da den velkendte R. Feynman i , bemærkede, at det er umuligt effektivt at modellere evolutionen af et kvantesystem på en klassisk computer. Han foreslog en elementær model , der ville være i stand til at udføre en sådan modellering.
Der er , i hvilken overvejes mere akademisk og detaljeret, men vi vil hurtigt kigge på:
Vigtige milepæle i udviklingen af kvantecomputere:
- [1994]. P. Shor. Udviklet
- [1998]. Skabt
- [2001]. IBM præsenterede udførelsen til faktorisering af tallet 15
- [2007-2016]. skaber og udvikler en computer med 128-2000 kubitter
- [2012]. Ved universitetet i Californien implementerede
- [2016]. Google på en 9-kubits computer
- [2017]. (tre atomer)
- [2019]. . en 20-kubits computer i skyen
- [2019]. . en 53-kubits computer. ?
Som du kan se, gik der 17 år (fra 1981 til 1998) fra idéen til dens første realisering i en computer med 2 kubitter, og 21 år (fra 1998 til 2019) indtil antallet af kubitter blev øget til 53. Det tog 11 år (fra 2001 til 2012) at forbedre resultatet af Shors algoritme (som vi vil dykke dybere ned i senere) fra tallet 15 til 21. Derudover var det kun for tre år siden, at vi nåede til det punkt, hvor vi kunne realisere det, Feynman talte om, og lære at simulere de enkleste fysiske systemer.
Udviklingen af kvanteberegninger skrider langsomt frem. Forskere og ingeniører står over for meget komplekse udfordringer, kvantetilstande er meget kortvarige og skrøbelige, og for at bevare dem i tilstrækkelig lang tid til at udføre beregninger, må der bygges sarcophagus'er til millioner af dollars, der opretholder en temperatur lige over det absolutte nulpunkt, og som er maksimalt beskyttet mod eksterne påvirkninger. Vi vil i det følgende tale mere detaljeret om disse opgaver og problemer.
Førende aktører
Slides til dette afsnit er taget fra artiklen , fra forskningsmedarbejderen Alexey Fyodorov. Jeg tillader mig direkte citater:
Alle teknologisk succesfulde lande beskæftiger sig i øjeblikket aktivt med udviklingen af kvante teknologier. Der investeres enorme beløb i disse undersøgelser, og der oprettes særlige programmer til støtte for kvante teknologier.
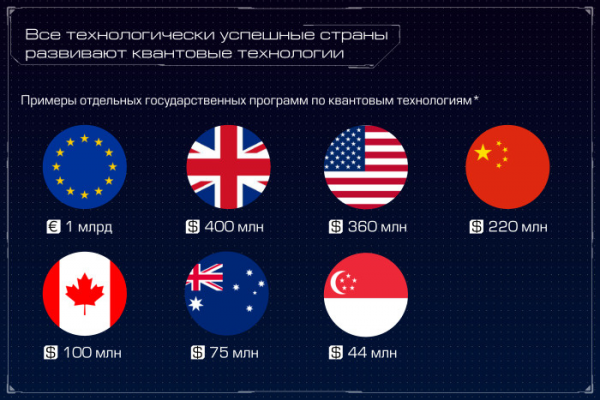
I kvantekapløbet deltager ikke kun stater, men også private selskaber. Samlet set har Google, IBM, Intel og Microsoft investeret omkring 0,5 milliarder dollars i udviklingen af kvantecomputere for nylig, og de har oprettet store laboratorier og forskningscentre.
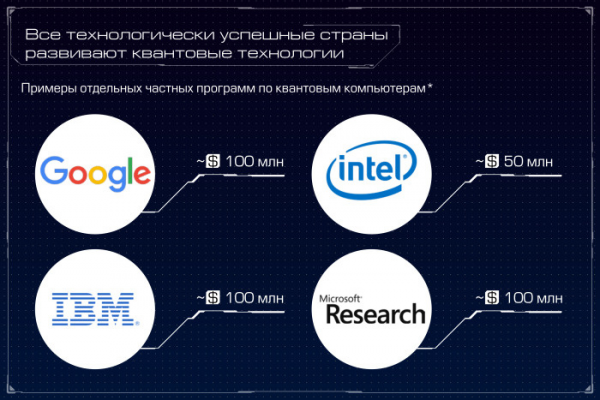
På Habré og på nettet er der mange artikler, for eksempel, , og , hvor den nuværende tilstand af udviklingen af kvante-teknologier i forskellige lande bliver beskrevet mere detaljeret. Det vigtigste for os nu er, at alle førende teknologisk udviklede lande og aktører investerer enorme ressourcer i forskning inden for dette område, hvilket giver håb om at komme ud af den nuværende teknologiske blindgyde.
Udviklingsretninger
I øjeblikket (jeg kan tage fejl, ret mig) er hovedindsatsen (og mere eller mindre betydningsfulde resultater) for alle førende aktører koncentreret om to retninger:
- Specialiserede kvantecomputere, der er rettet mod at løse en specifik opgave, for eksempel optimering. Et eksempel på et produkt er D-Wave kvantecomputere.
- Universelle kvantecomputere — der kan implementere vilkårlige kvantealgoritmer (Shor, Grover mv.). Implementeringer fra IBM, Google.
Andre udviklingsveje, som kvantefysik giver os, såsom:
- som grundlag for
- og meget mere
er bestemt også på listen over forskningsretninger, men der ser ud til at være endnu ikke nogen mere betydningsfulde resultater i øjeblikket.
Desuden kan man læse , og så kan man google “”, for eksempel, , og .
Grundlæggende. Kvanteobjekt og kvantesystemer
Det vigtigste, man skal forstå fra dette afsnit, er, at
En kvantecomputer (i modsætning til en almindelig) bruger kvanteobjekter, og for at udføre beregninger skal kvanteobjekterne forbindes i en kvantesystem..
Hvad er et kvanteobjekt?
Et kvanteobjekt — et objekt fra mikroworlden (den kvanteverden), der udviser kvantestruktur:
- Har en bestemt tilstand med to grænse niveauer
- Er i superposition af sin tilstand indtil måling
- Fletter sig med andre objekter for at skabe kvante-systemer.
- Udfører teoremet om kloningens forbud (man kan ikke kopiere en objekts tilstand)
Lad os gå mere i dybden med hver egenskab:
Har en bestemt tilstand med to grænse-niveauer (endelig tilstand)
Et klassisk eksempel fra den virkelige verden - en mønt. Den har en tilstand 'side', som har to grænse-niveauer - 'krone' og 'plat'.
Er i superposition af sin tilstand indtil måling
Vi kastede mønten, den flyver og roterer. Mens den roterer, er det umuligt at sige, hvilken af sine grænse-niveauer dens tilstand 'side' er i. Men så snart vi fanger den og ser på resultatet - som superpositionen af tilstande straks kollapser til ét af de to grænse-niveauer - 'krone' og 'plat'. At fange mønten er i dette tilfælde målingen.
Fletter sig med andre objekter for at skabe kvante-systemer.
Med mønten er det svært, men lad os prøve. Forestil dig, at vi har kastet tre mønter, så de roterer og griber fat i hinanden, en slags jonglering med mønter. I hvert øjeblik er ikke kun hver af dem i superposition af tilstande, men disse tilstande påvirker også hinanden (mønterne støder jo ind i hinanden).
Udfører teoremet om kloningens forbud (man kan ikke kopiere en objekts tilstand)
Mens mønterne flyver og roterer, kan vi på ingen måde skabe en separate kopi af det roterende tilstand af nogen af mønterne. Systemet lever for sig selv og er meget beskyttende over for at offentliggøre enhver information.
Et par flere ord om selve begrebet “superposition”, praktisk talt i alle artikler forklares superposition som “er i alle tilstande på samme tid”, hvilket selvfølgelig er korrekt, men til tider er det unødvendigt forvirrende. Superposition af tilstande kan også forestilles som at kvanteobjektet på hvert givent tidspunkt har bestemte sandsynligheder for at kollapsere til hver af sine grænse-niveauer, og i summen er disse sandsynligheder, naturligvis, lig med 1. Når vi ser nærmere på kubitten, vil vi uddybe dette mere.
For mønterne kan man visuelt forestille sig det - afhængig af startfarten, vinklen på kastet, tilstanden af det omgivende miljø, hvor mønten flyver, er sandsynligheden for at få 'krone' eller 'plat' forskellig på hvert tidspunkt. Og som nævnt tidligere kan tilstanden af en sådan flyvende mønt forestilles som 'at være i alle sine grænse-tilstande samtidig, men med forskellig sandsynlighed for deres realisering'.
Enhver objekt, der opfylder ovenstående egenskaber, og som vi kan skabe og administrere, kan bruges som en informationsbærer i en kvantecomputer.
Lidt længere fremme vil vi tale om den nuværende tilstand af den fysiske realisering af qubits som kvanteobjekter, og hvad forskere i øjeblikket bruger i denne forbindelse.
Så det tredje karakteristika siger, at kvanteobjekter kan sammenfiltres for at skabe kvantesystemer. Hvad er et kvantesystem?
Kvantesystem — et system af sammenfiltrede kvanteobjekter, der har følgende egenskaber:
- Kvantesystemet er i en superposition af alle mulige tilstande af de objekter, som det består af
- Man kan ikke kende systemets tilstand før målingen.
- I øjeblikket af måling realiserer systemet en af de mulige varianter af sine grænsetilstande.
(og, for at springe lidt frem)
Konsekvens for kvanteprogrammer:
- Et kvanteprogram har en bestemt tilstand af systemet som input, en superposition indeni, en superposition som output.
- Som output af programmet efter måling har vi en probabilistisk realisering af en af de mulige sluttilstande af systemet (plus mulige fejl).
- Enhver kvanteprogram har en arkitektur af en røgkanal (input -> output. Der er ingen cykler, man kan ikke se systemets tilstand midt i processen.)
Sammenligning af kvantcomputere og almindelige computere
Lad os nu sammenligne en almindelig computer med en kvantecomputer.
| Almindelig computer | En kvantecomputer | |
Logik | 0 / 1 | `a|0> + b|1>, a^2+b^2=1` |
Fysik | Halvledertransistor | Et kvanteobjekt |
Informationsbærer | Spændingsniveauer | Polarisering, spin,… |
Operationer | NOT, AND, OR, XOR på bits | Porter: CNOT, Hadamard,… |
Forbindelse | Halvlederchip | Sammenfiltring imellem hinanden |
Algoritmer | Standard (se Knuth) | Speciale (Shor, Grover) |
Princip | Digital, deterministisk | Analog, probabilistisk |
Logisk niveau
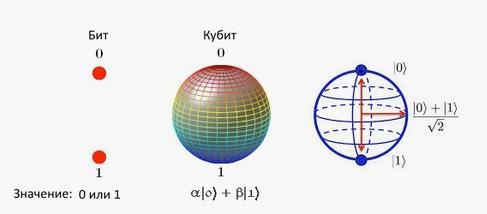
I en almindelig computer er dette en bit. Meget bekendt for os. deterministisk bit.Den kan antage værdierne 0 eller 1. Den klarede perfekt sin rolle logisk enhed for den almindelige computer, men er helt uhensigtsmæssig til at beskrive tilstanden af et kvanteobjekt, som, som vi allerede har nævnt, i naturen befinder sig i ensuperposition af sine grænsetilstande..
Til dette blev der opfundet . I sine grænsetilstande realiserer den tilstande, der ligner 0 og 1. , og i superposition udgør det en sandsynlighedsfordeling over sine grænsetilstande |0> og |1>:
a|0> + b|1>, sådan at a^2+b^2=1a og b repræsenterer , hvor kvadraterne af deres modulus — faktisk sandsynligheder for at få netop disse værdier af grænsetilstande |0> og |1>, hvis man sammenbringer kubitten med måling lige nu.
Fysisk niveau
På det nuværende teknologiske udviklingsniveau er den fysiske realisering af bit for en almindelig computer en halvledertransistor, for kvantecomputeren, som vi allerede har nævnt, enhver kvantemaskine. I det næste afsnit vil vi tale om, hvad der i øjeblikket anvendes som fysiske bærere af kubitter.
Informationsbærer
For en almindelig computer er det elektrisk strøm — spændingsniveauer, tilstedeværelse eller fravær af strøm osv., for kvantecomputeren — det samme tilstand i kvantemaskinen (polariseringsretning, spin osv.), som kan være i superpositions-tilstand.
Operationer
For at realisere logiske kredsløb på en almindelig computer anvendes velkendte , mens der til operationer over kubitter måtte opfindes et helt andet system af operationer, kaldet . Porter er en- og to-kubiske, afhængigt af hvor mange kubitter transformationen foretages på.
Eksempler på kvanteporte:
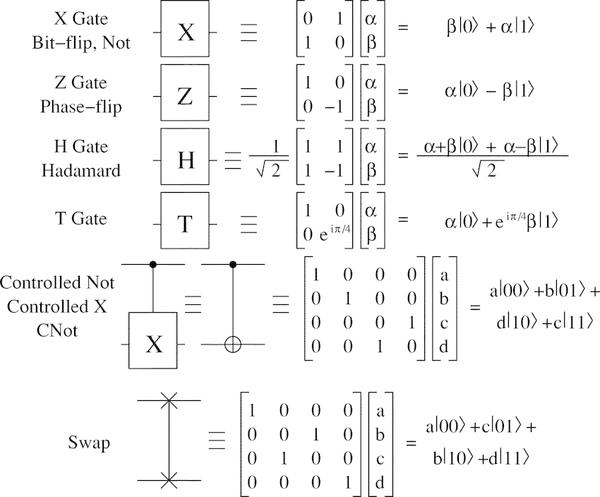
Der findes et begreb af et universelt sæt porte, som er tilstrækkelige til at udføre enhver kvanteberegning. For eksempel er et universelt sæt det, der inkluderer Hadamard-porten, faseforskydningsporten, CNOT-porten og π⁄8-porten. Med dem kan man udføre enhver kvanteberegning på et vilkårligt sæt af kubitter.
I denne artikel vil vi ikke gå i dybden med kvanteport-systemet, men man kan læse mere detaljeret om dem og de logiske operationer over kubitter f.eks. . Det vigtigste at huske er:
- Operationer over kvantemaskiner kræver skabelse af nye logiske operatorer (kvanteporte)
- Kvanteporte er en- og to-kubiske
- Der findes universelle sæt porte, med hvilke man kan udføre enhver kvanteberegning
Forbindelse
En transistor er os helt ubrugelig til at udføre beregninger; vi skal forbinde mange transistorer sammen, dvs. skabe en halvlederchip med millioner af transistorer, som vi kan bygge logiske kredsløb på. og i sidste ende få en moderne processor i sin klassiske form.
En kubit er os også helt ubrugelig (kun i akademisk sammenhæng),
for at udføre beregninger har vi brug for et system af kubitter (kvanteobjekter)
som, som vi allerede har nævnt, skabes ved at sammenflette kubitter på en måde, så ændringer i deres tilstande sker koordineret.
Algoritmer
Standardalgoritmerne, som menneskeheden har opbygget indtil nu, er helt uegnede til implementering på en kvantecomputer. Faktisk er der ikke engang behov for det. Kvantecomputere, der er baseret på logik af porte over kubitter, kræver skabelsen af helt andre algoritmer, kvantealgoritmer. Blandt de mest kendte kvantealgoritmer kan man fremhæve tre:
- (faktorisering)
- (hurtig søgning i en uordnet database)
- (svaret på spørgsmålet, om en funktion er konstant eller balanceret)
Princip
Og den vigtigste forskel er arbejdsprincippet. Hos en standardcomputer er det et digitalt, strengt deterministisk princip, baseret på, at hvis vi har angivet en bestemt initial tilstand af systemet og kørt den gennem en given algoritme, så vil resultatet af beregningerne være det samme, uanset hvor mange gange vi kører denne beregning. Faktisk er sådan en opførsel præcist det, vi forventer af en computer.
En kvantecomputer arbejder på et analogt, probabilistisk princip.Resultatet af arbejdet med en given algoritme på en given initial tilstand repræsenterer et stikprøve fra en sandsynlighedsfordeling af mulige realiseringer af algoritmen plus mulige fejl.
Denne probabilistiske natur af kvanteberegninger skyldes selve den probabilistiske essens af kvanteverdenen. “Gud spiller ikke terning med universet”, sagde den gamle Einstein, men alle eksperimenter og observationer bekræfter indtil videre (i den nuværende videnskabelige paradigme) det modsatte.
Fysiske realiseringer af kubitter
Som som tidligere nævnt, kan en qbit repræsenteres som et kvanteobjekt, det vil sige et fysisk objekt, der realiserer de tidligere beskrevne kvantestruktur. Med andre ord, enhver fysisk enhed, der kan eksistere i to tilstande, og hvor disse to tilstande er i en superpositionsposition, kan bruges til at opbygge en kvantecomputer.
"Hvis vi kan placere et atom i to forskellige niveauer og styre dem, så har vi en qbit. Hvis vi kan gøre det med en ion, så er det en qbit. Det samme gælder for strøm. Hvis vi sender det med uret og imod uret på samme tid, så har vi en qbit."
Der er pull-requesten på GitHub , hvor den nuværende mangfoldighed af fysiske realiseringer af qbits behandles mere detaljeret, vil vi blot nævne de mest kendte og udbredte:
- og mange andre eksotiske ideer (aniomer osv.)
Af al denne mangfoldighed er den mest udviklede metode til fremstilling af qbits baseret på . , , og andre førende aktører bruger netop denne metode til at opbygge deres systemer.
Og læs også mulige af qbits fra .
Grundlæggende. Principper for kvantcomputerens drift
Materialerne til dette afsnit (opgave og billeder) er taget fra artiklen .
Lad os forestille os, at vi har følgende opgave:
Der er en gruppe på tre personer: (A)ndrey, (B)olya og (S)ergey. Der er to taxier (0 og 1).
Det er også kendt, at:
- (A)ndrey, (B)olya - venner
- (A)ndrey, (S)ergey - fjender
- (B)olya og (S)ergey - fjender
Opgaven: Placer folk i taxier, så Max(venner) og Min(fjender)
Vurdering: L = (antal venner) - (antal fjender) for hver mulighed for placering
VIGTIGT: Antag, at der ikke er nogen heuristik, og der ikke er nogen optimal løsning. I dette tilfælde løses problemet kun ved fuld gennemgang af mulige kombinationer.
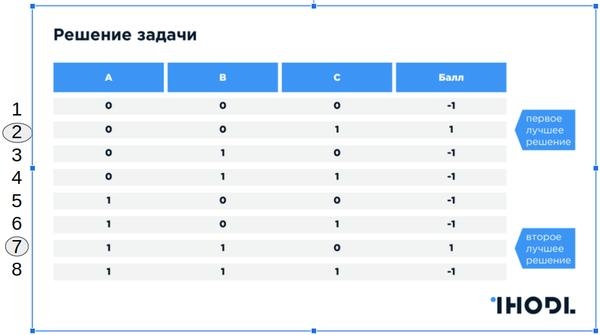
Løsning på en almindelig computer
Hvordan man løser denne opgave på en almindelig (super)computer (eller klynge) - det er klart, at man skal gennemgå alle mulige muligheder i en cykel.Hvis vi har et multiprocessorsystem, kan løsningerne paralleliseres på flere processorer og derefter samle resultaterne.
Vi har 2 mulige måder at placere (taxi 0 og taxi 1) og 3 personer. Løsningsrummet 2^3 = 8. Man kan gennemgå 8 muligheder selv med en lommeregner, det er ikke et problem. Og nu gør vi opgaven sværere — vi har 20 personer og to busser, løsningsrummet 2^20 = 1 048 576. Det er heller ikke så kompliceret. Lad os øge antallet af mennesker med 2,5 gange — vi tager 50 mennesker og to tog, løsningsrummet er nu 2^50 = 1,12 x 10^15. En almindelig (super)computer vil allerede have alvorlige problemer. Lad os fordoble antallet af mennesker, 100 personer vil give os 1,2 x 10^30 mulige varianter.
Alt i alt er det ikke muligt at beregne denne opgave på rimelig tid.
Vi tilslutter en supercomputer
Den kraftigste computer på nuværende tidspunkt — nummer 1 af , det er , med en ydeevne på 122 Lad os antage, at vi kun har brug for 100 operationer for at beregne en variant, så for at løse opgaven for 100 personer, vil vi have brug for:
(1,2 x 10^30 100) / 122×10^15 / (606024365) = 3 x 10^37 år.
Som vi kan se, når dimensionen af de oprindelige data øges, vokser løsningsrummet ifølge en potenseret lov, generelt set for N bits har vi 2^N mulige løsningsvarianter, hvilket ved relativt små N (100) giver os et uoverskueligt (i det nuværende teknologiske niveau) løsningsrum.
Er der alternativer? Som du sikkert har gætte, ja, der er.
Men før vi går videre til hvordan og hvorfor kvantecomputere kan løse sådanne opgaver effektivt, lad os kort huske, hvad sandsynlighedsfordelinger. Frygt ikke, artiklen er en oversigt, der vil ikke være hård matematik, vi klarer os med et klassisk eksempel med en pose og kugler.
Lidt kombinatorik, sandsynlighedsteori og en underlig eksperimentator
Lad os tage en pose og lægge i den 1000 hvide og 1000 sorte kugler.Vi vil gennemføre et eksperiment — trække en kugle, registrere farven, returnere kuglen til posen og blande kuglerne i posen.
Vi har gennemført eksperimentet 10 gange, trukket 10 sorte kugler.Er det muligt? Helt bestemt. Giver denne prøve os nogen rimelig forståelse af den sande fordeling i posen? Åbenlyst ikke. Hvad skal der gøres — korrekt, på gentage eksperimentet en million gange og beregne frekvenserne af de sorte og hvide kugler. For eksempel får vi 49,95% sorte og 50,05% hvide.I dette tilfælde er strukturen af fordelingen, som vi sampler fra (trækker én kugle), mere eller mindre forståelig.
Det vigtigste at forstå er, at selve eksperimentet har en probabilistisk natur., med én prøve (bold) kan vi ikke kende den sande struktur af distributionen, vi skal gentage eksperimentet mange gange og gennemsnitlige resultater.
Lad os tilføje til vores pose 10 røde og 10 grønne bolde (fejl). Vi gentager eksperimentet 10 gange. Itræk vi 5 røde og 5 grønne. Er det muligt? Ja. Kan vi sige noget om den sande fordeling — Nej. Hvad skal der gøres — nå, I forstår.
For at få en forståelse af strukturen i den sandsynlighedsfordeling, skal vi tage mange prøveudtagninger fra denne fordeling og gennemsnitlige resultaterne.
Vi forbinder teori med praksis
Nu i stedet for sorte og hvide bolde, lad os tage billardbolde og lægge i posen 1000 bolde med nummer 2, 1000 med nummer 7 og 10 bolde med andre numre. Forestil dig en eksperimentator, der er trænet i grundlæggende handlinger (tage en bold, notere nummeret, lægge bolden tilbage i posen, røde bolde i posen) og gør det på 150 mikrosekunder. En sådan eksperimentator på speed (ingen reklame for stoffer!!!). Så på 150 sekunder kan han udføre vores eksperiment 1 million gange og give os resultaterne af gennemsnittet.
Vi satte eksperimentatoren, gav ham posen, vende os væk, ventede 150 sekunder — fik:
nummer 2 — 49,5%, nummer 7 — 49,5%, de øvrige numre i alt — 1%.
Ja, det er korrekt, vores pose — det er en kvantecomputer med en algoritme, der løser vores opgave, og boldene — mulige løsningsalternativer. Da der er to korrekte løsninger, så vil kvantecomputeren give os vilkårligt et af disse mulige løsninger, og 0,5% (10/2000) fejl, som vi vil tale om senere.
For at få resultatet af kvantecomputerens arbejde, skal vi gentage kvantealgoritmen mange gange på det samme datasæt og gennemsnitlige resultatet.
Skalérbarhed af kvantecomputeren
Nu forestil dig, at for en opgave, hvor 100 personer deltager (løsningsrum 2^100 vi husker dette), er der også kun to korrekte løsninger. Så hvis vi tager 100 qubits og skriver en algoritme, der beregner vores mål funktion (L, se ovenfor) over disse qubits, vil vi få en pose, der har 1000 bolde med nummeret på den første rigtige løsning, 1000 med nummeret på den anden rigtige løsning, og 10 bolde med andre numre. Og vores eksperimentator vil give os en vurdering af den sandsynlighedsfordeling af korrekte svar på samme 150 sekunder..
Tiden for udførelsen af den kvantemekaniske algoritme (med visse antagelser) kan betragtes som konstant O(1) i forhold til dimensionen af løsningsrummet (2^N).
Og netop denne egenskab ved den kvantecomputer — konstansen af udførelsestiden i forhold til den eksponentielt voksende kompleksitet i løsningsrummet, er nøglepunktet.
Qubit og parallelle verdener
Hvordan sker det? Hvad gør det muligt for den kvantecomputer at udføre beregninger så hurtigt? Alt handler om den kvantemæssige natur af qubit.
Se, vi har nævnt, at qubit som kvanteobjekt realiserer et af sine to tilstande, når det observeres, men i ‘den levende natur’ er det i superpositions tilstande, hvilket vil sige, at det er i begge sine grænsetilstande samtidig (med en vis sandsynlighed).
Lad os tage (A)ndrej og forestille os hans tilstand (i hvilket transportmiddel - 0 eller 1) som en qubit. Så får vi (i det kvante rum) to parallelle verdener, i den ene (A) sidder i taxa 0, i den anden verden - i taxa 1. Samtidig i to taxa, men med en vis sandsynlighed for at finde ham i hver af dem ved observation.
Lad os tage (V)olodya og lad os også forestille os hans tilstand som en qubit. Det opstår to andre parallelle verdener. Men indtil videre interagerer disse verdenspar (A) og (V) ikke. Hvad skal der til for at skabe et sammenkoblet system? Correct, vi skal sammenkoble disse qubits (forvirre). Vi tager og forvirrer (A) med (V) — så får vi et kvantesystem af to qubits (A, V), som indeholder fire indbyrdes afhængige parallelle verdener. Tilføj (S)erghei og vi får et system bestående af tre qubits (ABC), som realiserer otte indbyrdes afhængige parallelle verdener.
Essensen af kvanteberegning (realiseringen af en kæde af kvanteporte over et system af sammenkoblede qubits) er, at beregningen sker i alle parallelle verdener samtidig.
Og det er ikke vigtigt, hvor mange vi har, 2^3 eller 2^100, den kvantemekaniske algoritme vil udføres på en endelig tid over alle disse parallelle verdener og give os et resultat, der repræsenterer et sample fra sandsynlighedsfordelingen af algoritmens svar.
For bedre forståelse kan man forestille sig, at en kvantecomputer på kvanteniveau kører 2^N parallelle processer til løsning, hvor hver enkelt arbejder med én mulig løsning, hvorefter den samler resultaterne — og giver os svaret i form af superposition af løsningen (sandsynlighedsfordelingen af svarene), fra hvilken vi hver gang (ved hvert eksperiment) sampler én.
Husk tiden, som vores eksperimentator har brug for (150 μs) til at udføre eksperimentet; det vil være nyttigt lidt senere, når vi taler om de grundlæggende problemer med kvantecomputere og dekohærens tiden.
Kvantalgoritmer
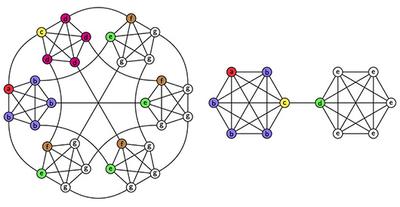
Som nævnt før er almindelige algoritmer, der er baseret på binær logik, ikke anvendelige til kvantecomputeren, der bruger kvantelogik (kvanteporte). For den måtte man finde på nye, der fuldt ud udnytter det potentiale, der ligger i kvantumnaturens beregninger.
De mest kendte algoritmer i dag er:
I modsætning til klassiske er kvantecomputere ikke universelle.
Der er stadig kun fundet et lille antal kvantealgoritmer.
Tak for henvisningen til , et sted, hvor, ifølge forfatteren (), de bedste repræsentanter for den kvante-algoritmiske verden er samlet og fortsat samles.
I denne artikel vil vi ikke gå i dybden med kvantealgoritmer; der er mange fremragende materialer online i enhver sværhedsgrad, men vi skal kort gennemgå de tre mest kendte.
Shor's algoritme.
Den mest kendte kvantealgoritme er (opfundet i 1994 af den engelske matematiker ), som er målrettet mod at løse problemet med faktorering af tal (faktoriseringsproblemet, diskret logaritme).
Netop denne algoritme nævnes som eksempel, når man skriver om, at dine banksystemer og koder snart vil blive brudt. I betragtning af at længden af de nøgler, der anvendes i dag, er mindst 2048 bit, er tiden for huen endnu ikke kommet.
I dag er mere end beskedne. De bedste resultater for faktorering ved hjælp af Shor-algoritmen — tal og , hvilket er meget mindre end 2048 bit. For de øvrige resultater i tabellen blev en anden beregning anvendt, men selv det bedste resultat for denne algoritme (291311) er langt fra reel anvendelse.
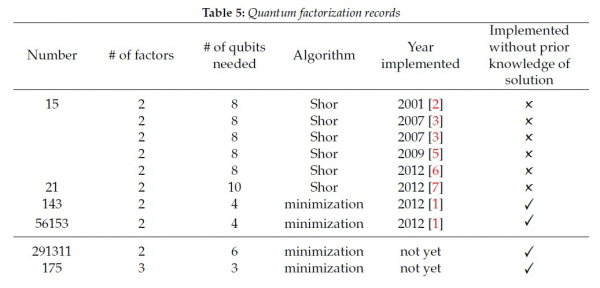
Du kan læse mere om Shor's algoritme for eksempel. Om den praktiske implementering — .
En af af kompleksiteten og den nødvendige kraft til at faktorisere et tal på 2048 bit, er en computer med . Vi kan sove trygt.
Grover's algoritme
— til at løse problemer ved brute force, altså finde løsningen på ligningen F(X) = 1, hvor F er fra n af variabler. Den blev foreslået af den amerikanske matematiker i .
Grover's algoritme kan bruges til at finde og af en talrække. Desuden kan det anvendes til at løse problemer gennem udtømmende søgning blandt en mængde mulige løsninger. Dette kan medføre en betydelig hastighedsforøgelse sammenlignet med klassiske algoritmer, selvom det ikke giver en "" i almindelighed..
Du kan læse mere i, eller Der er også en god forklaring af algoritmen ved hjælp af eksemplet med kasser og en bold, men desværre åbner denne hjemmeside ikke for mig fra Rusland af grunde, som ikke er under min kontrol. Hvis du har denne hjemmeside Grover's algoritme. Forestil dig, at du har N nummererede lukkede kasser. De er alle tomme undtagen én, hvor bolden befinder sig. Din opgave: at finde ud af nummeret på den kasse, hvor bolden ligger (dette ukendte nummer betegnes ofte med bogstavet w).
Hvordan løser man dette problem? Den dummeste metode er at åbne kasserne en ad gangen, og før eller siden vil du støde på kassen med bolden. Men hvor mange kasser skal man i gennemsnit åbne, før man finder kassen med bolden? I gennemsnit skal man åbne cirka halvdelen af kasserne N/2. Det vigtigste her er, at hvis vi øger antallet af kasser 100 gange, så vil det gennemsnitlige antal kasser, der skal åbnes, også stige med 100 gange, før man finder kassen med bolden.
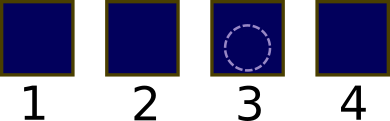
), foreslået
Lad os nu præcisere én ting mere. Lad os sige, at vi ikke selv åbner kasserne med hænderne og kontrollerer, at der er en bold i hver, men at der er en form for mellemmand, lad os kalde ham Oraklet. Vi siger til Oraklet: "tjek kasse nummer 732", og Oraklet tjekker ærligt og svarer: "der er ingen bold i kasse nummer 732." I stedet for at tale om, hvor mange kasser vi i gennemsnit skal åbne, taler vi nu om, "hvor mange gange i gennemsnit vi skal henvende os til Oraklet for at finde nummeret på kassen med bolden"
Det viser sig, at hvis vi oversætter denne opgave med kasser, bold og Orakel til kvante-sprog, så opnår vi et fantastisk resultat: for at finde nummeret på kassen med bolden blandt N kasser, skal vi kun forstyrre Oraklet cirka SQRT(N) gange!
Så kompleksiteten ved at søge med Grover's algoritme reduceres til kvadratroden.
Deutsch-Josza algoritmen
Deutsch-Joshi-algoritmen (også nævnt som Deutsch-Jozas-algoritme) – [kvantealgoritme](), foreslået og i , og blev et af de første eksempler på algoritmer, der var designet til udførelse på . _
Problemet med Deutsch-Joshi handler om at bestemme, om en funktion af flere binære variable F(x1, x2, … xn) er konstant (den antager enten værdien 0 eller 1 for enhver argumentation) eller balanceret (den antager værdien 0 for halvdelen af definitionsområdet og 1 for den anden halvdel). Det antages a priori, at funktionen enten er en konstant eller balanceret.
Man kan også læse . En enklere forklaring:
Deutsch-algoritmen (Deutsch-Joshi) er baseret på søgning, men muliggør, at denne kan udføres hurtigere end sædvanligt. Forestil dig, at der ligger en mønt på bordet, og det er nødvendigt at finde ud af, om den er falsk eller ej. For at gøre dette skal man se på mønten to gange og bestemme: "plat" og "krone" – ægte, to "plader", to "kroner" – falsk. Med Deutsch's kvantealgoritme kan denne bestemmelse dog gøres med et enkelt blik – en måling.
Problemer ved kvantcomputere
Ved design og drift af kvantecomputere står forskere og ingeniører over for en lang række problemer, der i dag løses med varierende succes. Ifølge () kan følgende problemer identificeres:
- Følsomhed over for miljøet og interaktion med miljøet
- Opsamling af fejl under beregninger
- Udfordringer med den indledende initialisering af kubitternes tilstande
- Udfordringer med at skabe multikubit systemer
Jeg anbefaler stærkt at læse artiklen "", især kommentarerne til den.
Lad os organisere alle hovedproblemerne i tre større grupper og se nærmere på hver enkelt af dem:
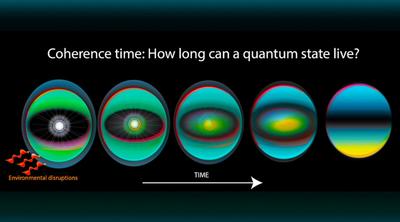
Dekohærens
.
Kvantetilstand er en meget skrøbelig ting, kubitter i sammenfiltret tilstand er ekstremt ustabile, enhver ekstern påvirkning kan ødelægge (og ødelægger) denne forbindelse. Ændringer i temperaturen med den mindste del af en grad, tryk, en tilfældig photon der flyver forbi — alt dette destabiliserer vores system.
For at løse dette problem bygger man lavtemperatur-sarkofager, hvor temperaturen (-273,14 grader celsius) er lige over det absolutte nulpunkt, med maksimal isolering af det indre kammer med processoren fra alle (mulige) påvirkninger fra det ydre miljø.
Den maksimale levetid for et kvantesystem af flere sammenfiltret kubitter, i hvilken det bevarer sine kvanteegenskaber og kan bruges til at udføre beregninger, kaldes dekoherenstid.
På nuværende tidspunkt er dekoherenstiden i de bedste kvante-løsninger omkring tusinder og hundreder af mikrosekunder.
Der er en fremragende , som man kan se af alle skabte kvantesystemer. I denne artikel er kun to top-processorer — fra IBM og fra . Som vi ser, overstiger dekoherenstiden (T2) ikke 200 µs.
Jeg fandt ikke præcise data om Sycamore, men i selve nævnes to tal — 1 million beregninger på 200 sekunder, et andet sted — på 130 sekunder uden tab af kontrolsignaler og andet. I hvert fald giver det os dekoherenstid på omkring 150 µs. Husk vores forsker med posen? Ну так вот он.
| Computer Name | N Qubits | Maks parret | T2 (µs) |
| IBM Q System One | 20 | 6 | 70 |
| Google Sycamore | 53 | 4 | ~150-200 |
Hvilke risici medfører dekoherens?
Hovedproblemet er, at efter 150 µs vil vores beregningssystem af N sammenfiltret kubitter begynde at afgive på output i stedet for en sandsynlighedsfordeling med korrekte løsninger — sandsynligt hvidt støj.
Det vil sige, at vi skal:
- Initialisere kubitsystemet
- Udføre beregningen (kæde af portoperationer)
- Beregn resultatet
Og gør alt dette på 150 µs. Hvis du ikke når det, bliver resultatet til en græskar.
Men det er ikke alt…
Fejl
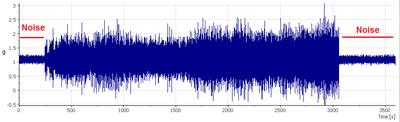
Som vi allerede har nævnt, har kvanteprocesser og kvanteberegninger en probabilistisk natur, vi kan ikke være 100% sikre på noget, kun med en vis sandsynlighed. Situationen forværres yderligere af det, at kvanteberegninger er udsat for fejl. De vigtigste typer af fejl i kvanteberegninger er:
- Dekohærensfejl, som skyldes systemets kompleksitet og interaktion med det ydre miljø
- Gateberegningsfejl (som skyldes den kvante natur af beregningerne)
- Fejl ved aflæsning af den endelige tilstand (resultatet)
Fejl relateret til dekohærens, opstår straks, så snart vi sammenfiltret vores qubits og begyndte at udføre beregninger. Jo flere qubits vi sammenfiltret, desto mere kompleks bliver systemet, og desto lettere bliver det at ødelægge det. Lavtemperatur-sarkofager, beskyttede kamre, alle disse teknologiske finurligheder er netop designet til at reducere antallet af fejl og forlænge dekohærensens tid.
Gateberegningsfejl — enhver operation (gate) på qubits kan med en vis sandsynlighed afsluttes med en fejl, og for at implementere algoritmen skal vi udføre hundrede gates, så forestil dig, hvad vi ender med, når vi afslutter vores algoritme. Den klassiske reaktion på spørgsmålet — “Hvad er sandsynligheden for at møde en dinosaur i elevatoren?” — er 50x50, enten møder du en eller også gør du ikke.
Problemet forværres yderligere af, at standardmetoder til fejlkorrektion (dublere beregninger og gennemsnit) i kvanteverdenen ikke virker på grund af kloningens forbudssætning. For i kvanteberegninger måtte man finde på . Groft sagt tager vi N almindelige qubits og laver dem til 1 logisk qubit med en lavere fejlrate.
Men her opstår et andet problem — det samlede antal qubits. Se, lad os sige, at vi har en processor med 100 qubits, hvoraf 80 qubits er optaget til fejlkorrektion, så har vi kun 20 til beregninger.
Fejl ved aflæsning af det endelige resultat — som vi husker, præsenteres resultatet af kvanteberegninger for os i form af en sandsynlighedsfordeling af svar. Men aflæsning af den endelige tilstand kan også afsluttes med en fejl.
På samme måde er der sammenligningstabeller for processorer baseret på fejlniveauer. Til sammenligning tager vi de samme processorer som i det forrige eksempel — IBM og :
| Computer | 1-Qubit Gate Fidelity | 2-Qubit Gate Fidelity | Readout Fidelity |
| IBM Q System One | 99.96% | 98.31% | — |
| Google Sycamore | 99.84% | 99.38% | 96.2% |
Her — et mål for ligheden mellem to kvantetilstande. Fejlens størrelse kan groft ses som 1-Fidelity. Som vi kan se, er fejl på 2-qubit portene og aflæsningsfejl den største hindring for at udføre komplekse og lange algoritmer på eksisterende kvantecomputere.
Man kan også læse år fra til løsning af fejlkorrektionsopgaven.
Processorarkitektur
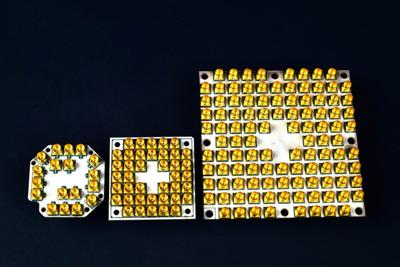
I teorien bygger vi og opererer med kredsløb af dusinvis af sammenfiltrede qubits, i virkeligheden er det mere kompliceret. Alle eksisterende kvantechips (processorer) er bygget på en måde, der sikrer smertefri sammenfiltring af én qubit kun med sine naboer, som ikke må være flere end seks.
Hvis vi skal sammenfiltre den 1. qubit, lad os sige, med den 12., så må vi bygge en kæde af ekstra kvanteoperationer, involvere flere qubits osv., hvilket øger det samlede fejlniveau. Og glem ikke dekoherenstid, det kan være, at når du er færdig med at forbinde qubits i det ønskede kredsløb, er tiden gået, og hele strukturen bliver til en charmerende generator af hvid støj.
Glem heller ikke, at arkitekturen hos alle kvanteprocessorer er forskellig, og programmet, der er skrevet i emulatoren i tilstanden “forbindelse alle med alle”, skal “genkompileres” til arkitekturen af den specifikke chip. Der findes endda til at udføre denne operation.
Maksimal forbindelse og maksimalt antal qubits for de bedste chips:
| Computer Name | N Qubits | Maks parret | T2 (µs) |
| IBM Q System One | 20 | 6 | 70 |
| Google Sycamore | 53 | 4 | ~150-200 |
Og til sammenligning, en tabel med data fra den foregående generation af processorer. Sammenlign antallet af qubits, dekoherenstid og fejlprocenten med, hvad vi har nu i den nye generation. Der er trods alt fremgang, om end langsomt.
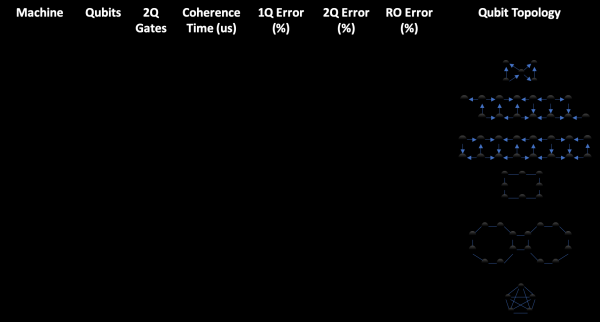
Så:
- I øjeblikket er der ingen fuldt tilsluttede arkitekturdiagrammer med > 6 qubits
- For at forbinde qubit 0 med f.eks. den 15. på en reel processor kan det tage flere dusin ekstra operationer
- Flere operationer -> flere fejl -> stærkere indflydelse af dekoherens
Resumé
Dekoherens er det barske virkelighed for moderne kvanteberegninger. Inden for 150 µs skal vi have plads til det hele:
- Initialisering af kvbiternes grundlæggende tilstand
- Beregning af opgaven ved hjælp af kvanteporte
- Udfør fejlkorrigering for at opnå betydningsfulde resultater
- Opnå det resulterende resultat
Indtil videre er resultaterne skuffende, selvom det hævdes at have nået 0,5 s kohærensholdetid på en kvantecomputer baseret på :
Vi måler en kvbit kohærens tid på over 0,5 s, og med magnetisk afskærmning forventer vi, at dette forbedres til at være længere end 1000 s
Der kan også læses om denne teknologi eller for eksempel .
Situationen kompliceres yderligere ved, at brugen af komplekse beregninger kræver kvanteskemaer til fejlkorrigering, hvilket også tager tid og tilgængelige kvitter.
Og endelig tillader moderne arkitekturer ikke, at kvantetilstandsschemer realiseres med minimale omkostninger bedre end 1 til 4 eller 1 til 6.
Løsninger på problemerne
Til at løse ovennævnte problemer anvendes i øjeblikket følgende tilgange og metoder:
- Brug af kryokamre med lave temperaturer (10 mK (–273,14°C))
- Brug af processorblokke, der er maksimalt beskyttet mod eksterne påvirkninger
- Brug af kvantefejlkorrigeringssystemer (Logisk kvbit)
- Brug af optimeringsværktøjer ved programmering af skemaer til specifik processor
Der gennemføres også forskning, der sigter på at øge dekohærensens tid, finde nye (og forbedre kendte) fysiske realiseringer af kvanteobjekter, optimere korrigeringsskemaer osv. Der er fremskridt (se ovenfor på specifikationerne for tidligere og nuværende topchips), men det går stadig langsomt, meget langsomt.
D-Wave
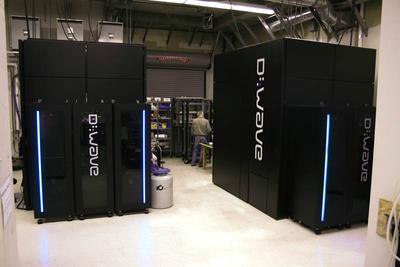
2000-kvbit computeren D-Wave 2000Q. Kilde:
Baggrund for Googles udtalelse om at have opnået kvanteoverlegenhed ved brug af en processor med 53 kvbits, og fra D-Wave, hvor antallet af kvbits tælles i tusinder, kan være forvirrende. Jamen virkelig, hvis 53 kvbits kunne opnå kvanteoverlegenhed, hvad er så kapaciteten hos en computer med 2048 kvbits? Men ikke alt er så godt ...
Kort sagt (taget fra wiki):
Computere arbejder ud fra princippet om (), kan kun løse en meget begrænset underklasse af optimeringsopgaver og er ikke velegnede til implementering af traditionelle kvantealgoritmer og kvanteporte.
Man kan læse mere om det f.eks. , (forsigtigt, det virker muligvis ikke fra Rusland), eller hos i i hans . Forresten vil jeg varmt anbefale at læse hans blog, der er mange gode materialer der.
Fra begyndelsen af annonceringerne har det videnskabelige samfund haft spørgsmål til D-Wave computere. For eksempel i 2014 stillede IBM spørgsmål ved, om D-Wave Det gik så langt, at Google sammen med NASA i 2015 købte en af sådanne kvantecomputere, og efter undersøgelserne , ja, computeren arbejder og beregner opgaver hurtigere end en almindelig. Du kan også læse om Googles udtalelse og f.eks. .
Det vigtigste er, at D-Wave computerne, med deres hundrede eller tusinde kubitter, ikke kan bruges til beregning og kørsel af kvantealgoritmer. Man kan ikke køre Shor's algoritme på dem, for eksempel. Alt, hvad de kan, er at bruge bestemte kvantemekaniske metoder til at løse specifikke optimeringsopgaver. Man kan opfatte D-Wave som en slags kvante ASIC til en konkret opgave.
Lidt om emulering af kvantcomputere
Kvanteberegninger kan emuleres på en almindelig computer. For faktisk, :
- Tilstanden af en kubit kan som et komplekst tal, optager fra 2^32 til 2^64 bits (8-16 bytes) afhængigt af processorens arkitektur.
- Tilstanden af N sammenkoblede kubitter kan repræsenteres som 2^N komplekse tal, altså 2^(3+N) for 32-bit arkitektur og 2^(4+N) for 64-bit.
- En kvanteoperation over N kubitter kan repræsenteres som en 2^N x 2^N matrix.
Så:
- For at gemme emulerede tilstande af 10 kubitter kræves der 8 KB.
- For at gemme tilstande af 20 kubitter kræves der 8 MB.
- For at gemme tilstande af 30 kubitter kræves der 8 GB.
- For at gemme tilstande af 40 kubitter kræves der 8 Terabyte.
- For at gemme tilstande af 50 kubitter kræves der 8 Petabyte osv.
Til sammenligning, () har kun 2.8 Petabyte hukommelse.
— 49 kubitter, der blev opnået sidste år på den største kinesiske supercomputer ()
Grænsen for simulation af kvantecomputere på klassiske systemer er begrænset af mængden af RAM, der kræves for at gemme tilstandene af kubitter.
Jeg vil også anbefale at læse . Her er:
For operationer — for præcist at emulere skemaet på 49 kubitter krævedes der omkring 39 "takts" (uafhængige lag af ventiler) 2^63 komplekse multiplicationer — 4 Petaflops supercomputer i 4 timer
Emulering af en kvantecomputer med 50+ kubitter på klassiske systemer anses for umulig inden for rimelig tid. Blandt andet af denne grund brugte Google en processor med 53 kubitter til sit eksperiment med kvantesuperioritet.
Kvantcomputational overlegenhed.
Wikipedia giver os følgende definition på kvanteberegningsmæssig overlegenhed:
Kvantitativ overlegenhed — evnen til enheder til at løse problemer, som klassiske computere praktisk talt ikke kan løse.
Faktisk betyder opnåelsen af kvanteoverlegenhed, at for eksempel faktorisering af store tal ved hjælp af Shors algoritme kan løses på en rimelig tid, eller at man kan emulere komplekse kemiske molekyler på kvanteniveau, osv. Det vil sige, en ny epoke er begyndt.
Men i formuleringen af definitionen er der et vist smuthul, “som klassiske computere praktisk talt ikke kan løse”. Faktisk betyder det, at hvis man opretter en kvantecomputer med 50+ kubitter og kører et bestemt kvanteskema på den, så vil resultatet af dette skema, som vi har set ovenfor, ikke kunne emuleres på en almindelig computer. Det vil sige, en klassisk computer vil ikke være i stand til at genskabe resultatet af et sådant skema..
Er et sådant resultat virkelig kvanteoverlegenhed eller ej, er spørgsmålet mere filosofisk. Men det er vigtigt at forstå, hvad Google har gjort, og hvad der ligger til grund for dets skal man.
Googles erklæring om opnåelse af kvanteoverlegenhed
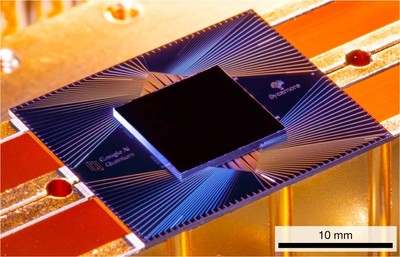
54-kubits Sycamore-processor
Så i oktober 2019 offentliggjorde udviklerne fra Google en artikel i det videnskabelige tidsskrift Nature, “”. Forfatterne annoncerede først i historien opnåelsen af kvanteoverlegenhed ved hjælp af den 54-kubits processor “Sycamore”.
I netværket nævnes det ofte i artikler om Sycamore, hvordan den er en 54-kubits processor eller en 53-kubits. Sandheden er, at ifølge , er processoren fysisk lavet af 54 kubitter, men en af dem er defekt og taget ud af drift. Så i virkeligheden har vi en 53-kubits processor.
På nettet kom det straks materialer om dette emne, hvis gradient varierede fra op til .
Senere meddelte medarbejdere fra IBM's afdeling for kvantecomputing, at . Virksomheden hævder, at en almindelig computer vil kunne klare denne opgave i værste fald på 2,5 dage, og at det resulterende svar vil være mere nøjagtigt end en kvantecomputer. Denne konklusion blev draget på baggrund af en teoretisk analyse af flere optimeringsmetoder.
Og selvfølgelig i din kunne ikke undgå at bemærke denne erklæring. Hans sammen med alle referencer og som sædvanlig er værd at bruge tid på. På Habr af denne FAQ, og sørg for at læse kommentarerne, der er links til tidligere dokumenter, som lækkede til nettet før den officielle meddelelse.
Hvad gjorde Google i virkeligheden? For en detaljeret forståelse læs Aaronson, men kort sagt:
Jeg kan selvfølgelig fortælle dig, men det føles lidt dumt. Beregningen er sådan: eksperimentatoren genererer et tilfældigt kvantekrets S (dvs. en tilfældig sekvens af 1-qubit og 2-qubit – mellem nærmeste naboer – porte, med en dybde på for eksempel 20, der fungerer på et 2D-netværk af n=50-60 qubits). Derefter sender eksperimentatoren S til kvantecomputeren og beder den anvende S på en indledende tilstand af 0, måle resultatet i basen {0,1}, returnere en n-bit observeret sekvens (streng) og gentage dette flere tusinde eller millioner gange. Endelig, ved at bruge sin viden om S, udfører eksperimentatoren en statistisk test for at kontrollere, om resultatet stemmer overens med den forventede output fra kvantecomputeren.
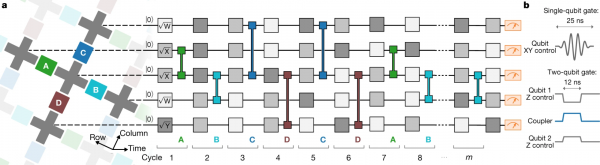
Kort sagt:
- Der oprettes et tilfældigt skema af længde 20 fra 53 qubits ved hjælp af porte
- Skemaet startes med den indledende tilstand [0…0] til udførelse
- Udgangen af skemaet er en tilfældig bitstreng (sample)
- Resultatfordelingen er ikke tilfældig (interferens)
- Fordelingen af de opnåede samples sammenlignes med den forventede
- Der drages en konklusion om kvanteoverlegenhed
Det vil sige, at Google har udført en syntetisk opgave på en 53-qubit processor, og deres erklæring om at have opnået kvantemæssig overlegenhed er baseret på det faktum, at sådanne processorer ikke kan emuleres på standard systemer inden for rimelig tid.
For at forstå — i dette afsnit mindskes på ingen måde Googles præstation, ingeniørerne har virkelig gjort et godt stykke arbejde, og spørgsmålet om, hvorvidt dette kan betragtes som reel kvantemæssig overlegenhed eller ej, er som tidligere nævnt mere filosofisk end ingeniørmæssigt. Men det skal forstås, at selvom vi har opnået sådan regnekraftig overlegenhed, er vi ikke et skridt tættere på at kunne køre Shor's algoritme på 2048-bit tal.
CV
Kvantcomputere og kvanteberegninger er et meget lovende, meget ungt og stadig relativt lidt anvendeligt område inden for informationsteknologi.
Udviklingen af kvanteberegning vil (en dag) gøre det muligt at løse opgaver:
- Modellering af komplekse fysiske systemer på kvanteniveau
- Som ikke kan løses på almindelige computere på grund af beregningskompleksitet
De vigtigste problemer ved oprettelse og drift af kvantcomputere:
- Dekohærens
- Fejl (dekoherens og gatefejl)
- Processorarkitektur (fuldt forbundne qubit-skemaer)
Status på nuværende tidspunkt:
- Faktisk — meget tidligt .
- DER ER IKKE REALISTISK kommerciel drift endnu (og det er uklart, hvornår det vil ske)
Hvad der kan hjælpe:
- En eller anden fysisk opdagelse, der reducerer omkostningerne ved forbindelse og drift af processorer
- Opdagelse af noget, der væsentligt øger dekohærens tiden og/eller reducerer antallet af fejl
Efter min mening (kun personligt synspunkt), i den nuværende videnskabelige vidensparadigme vil vi ikke opnå betydelige fremskridt i udviklingen af kvante teknologier, der kræves et kvalitetsbrud inden for et område af grundlæggende eller anvendt videnskab, som vil give et skub til nye ideer og metoder.
Men indtil da — opbygger vi erfaring med kvanteprogrammering, samler og skaber kvantealgoritmer, tester ideer og meget mere. Vi venter på et gennembrud.
Konklusion
I denne artikel har vi gennemgået de vigtigste milepæle i udviklingen af kvantecomputere og kvanteberegninger, vi har forklaret deres funktionsprincip, diskuteret de vigtigste problemer, ingeniører står overfor ved udviklingen og driften af kvanteprocessorer, samt set på, hvad der egentlig består i D-Wave's mange-kubits computere og Googles nylige erklæring om at have opnået kvanteoverlegenhed.
Spørgsmål om programmering af kvantecomputere (sprog, tilgange, metoder osv.) og spørgsmål relateret til den specifikke fysiske implementering af processorer, hvordan man styrer kubitter, binding, aflæsning osv. er forblevet udenfor. Måske vil dette være emnet for næste artikel eller artikler.
Tak for opmærksomheden, jeg håber, denne artikel vil være nyttig for nogen.
(C)
Taknemmelighed
for korrektur og bemærkninger til den oprindelige tekst samt for artiklen
for de informationsrige kommentarer til , ja og ikke kun til den, som i høj grad hjalp mig med at forstå dette puslespil.
Til alle forfattere af artikler og publikationer, hvis materialer er blevet brugt i skrivningen af denne artikel.
Liste over ressourcer
Artikler om den nuværende situation fra [The National Academies Press]
Artikler fra Habr (i tilfældig rækkefølge)
Usorterede (men ikke mindre interessante) artikler fra internettets verden
Kurser og forelæsninger
Kilde: habr.com
