

Jeg stødte på et interessant materiale om kunstig intelligens i spil. Det forklarer de grundlæggende begreber om AI med simple eksempler, og det indeholder mange nyttige værktøjer og metoder til nem udvikling og design. Der er også information om, hvordan, hvor og hvornår man skal bruge dem.
De fleste eksempler er skrevet i pseudokode, så dybe programmeringskundskaber vil ikke være nødvendige. Under brudteksten er der 35 sider med billeder og GIF'er, så vær forberedt.
UPD. Jeg beklager, men jeg har allerede lavet min egen oversættelse af denne artikel på Habr. . Du kan læse hans version , men af en eller anden grund er artiklen gået mig forbi (jeg brugte en søgning, men noget gik galt). Og eftersom jeg skriver i en blog, der er dedikeret til game development, besluttede jeg at efterlade min egen version af oversættelsen til abonnenterne (nogle punkter er præsenteret anderledes af mig, og nogle er bevidst udeladt efter udviklernes råd).
Hvad er AI?
Spil AI fokuserer på, hvilke handlinger en enhed skal udføre, baseret på de forhold, den befinder sig i. Dette kaldes normalt styring af "intelligente agenter", hvor en agent kan være en spilfigur, et køretøj, en bot eller nogle gange noget mere abstrakt: en hel gruppe enheder eller endda en civilisation. I hvert tilfælde er det noget, der skal se sit miljø, træffe beslutninger baseret på dette og handle i overensstemmelse hermed. Dette kaldes Sense/Think/Act-cyklussen:
- Sense: agenten finder eller modtager information om ting i sit miljø, der kan påvirke dens adfærd (trusler i nærheden, genstande til at samle, interessante steder at udforske).
- Think: agenten beslutter, hvordan den skal reagere (overvejer, om det er sikkert nok at samle ting eller om den først skal kæmpe/gemme sig).
- Act: agenten udfører handlinger for at gennemføre den tidligere beslutning (begynder at bevæge sig mod modstanderen eller genstanden).
- ...situationen er nu ændret på grund af karakterernes handlinger, så cyklussen gentages med nye data.
AI fokuserer normalt på Sense-delen af cyklussen. For eksempel tager selvkørende biler billeder af vejen, kombinerer dem med radardata og lidar-data og fortolker dem. Dette udføres typisk af maskinlæring, som behandler de indkommende data og giver dem mening ved at udtrække semantisk information som "der er en anden bil 20 yards foran dig". Dette kaldes classification problems.
Spil har ikke brug for et komplekst system til at udtrække information, da størstedelen af dataene allerede er en integreret del af dem. Der er ingen grund til at køre billedgenkendelsesalgoritmer for at afgøre, om der er en fjende foran — spillet ved det allerede og videregiver oplysningerne direkte i beslutningsprocessen. Derfor er Sense-delen af cyklussen ofte meget simpler end Think og Act.
Begrænsninger for spil-AI
AI har en række begrænsninger, som skal overholdes:
- AI skal ikke trænes forud, som det er tilfældet med maskinlæringsalgoritmer. Det giver ikke mening at skrive et neuralt netværk under udviklingen for at observere titusindvis af spillere og lære den bedste måde at spille imod dem. Hvorfor? Fordi spillet ikke er udgivet, og der ikke er nogen spillere.
- Spillet skal underholde og udfordre, så agenterne må ikke finde den bedste tilgang mod mennesker.
- Agenterne skal se realistiske ud, så spillerne føler, at de spiller imod rigtige mennesker. Programmets AlphaGo overgik mennesker, men de valgte trin var langt fra den traditionelle forståelse af spillet. Hvis et spil imiterer en menneskelig modstander, bør den følelse ikke være der. Algoritmen skal ændres, så den træffer plausible beslutninger og ikke perfekte.
- AI skal fungere i realtid. Det betyder, at algoritmen ikke kan monopolere processorens brug i længere tid til at træffe beslutninger. Selv 10 millisekunder til dette er for længe, da de fleste spil har brug for 16 til 33 millisekunder for at udføre hele behandlingen og gå videre til det næste grafiske frame.
- Det er ideelt, hvis i det mindste en del af systemet styres af data, så "non-coders" kan foretage ændringer, og så justeringer kan ske hurtigere.
Lad os se på AI-tilgange, der dækker hele cyklussen Sense/Think/Act.
Træffe grundlæggende beslutninger
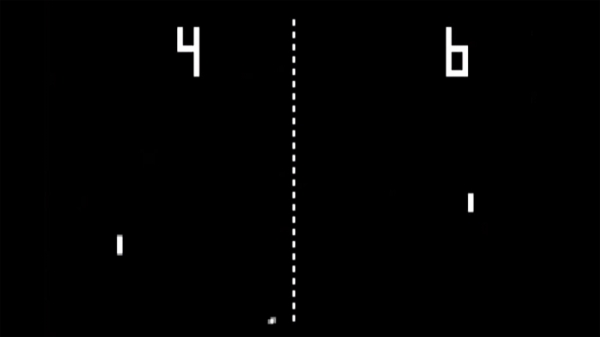
Lad os starte med det enkleste spil - Pong. Målet er at flytte platformen (paddle), så bolden hopper af den i stedet for at flyve forbi. Det er ligesom tennis, hvor du taber, hvis du ikke slår bolden. Her har AI en relativt let opgave - at beslutte, hvilken retning platformen skal bevæges i.
Betingede operatorer
For AI i Pong er den mest åbenlyse løsning at forsøge at placere platformen under bolden hele tiden.
En simpel algoritme til dette, skrevet i pseudokode:
hver ramme/opdatering mens spillet kører:
hvis bolden er til venstre for paddle:
flyt paddle til venstre
ellers hvis bolden er til højre for paddle:
flyt paddle til højre
Hvis platformen bevæger sig med boldens hastighed, så er dette den ideelle algoritme for AI i Pong. Der er ikke behov for at komplicere det, hvis dataene og de mulige handlinger for agenten ikke er så mange.
Denne tilgang er så enkel, at hele cyklen Sense/Think/Act knap er mærkbar. Men den eksisterer:
- Delen Sense findes i de to if-operatorer. Spillet ved, hvor bolden er, og hvor platformen er, så AI henvender sig til det for denne information.
- Delen Think inkluderer også to if-operatorer. De udtrykker to løsninger, som i dette tilfælde er gensidigt udelukkende. Som et resultat vælges en af tre handlinger - flyt platformen til venstre, flyt platformen til højre, eller gør ingenting, hvis den allerede er korrekt placeret.
- Delen Act findes i operationerne Flyt Paddle Til Venstre og Flyt Paddle Til Højre. Afhængigt af spillets design kan de flytte platformen øjeblikkeligt eller med en bestemt hastighed.
Sådanne tilgange kaldes reaktive - der findes et simpelt sæt regler (i dette tilfælde if-operatorer i koden), der reagerer på den aktuelle tilstand af verden og handler.
Beslutningstræ
Eksemplet med spillet Pong er faktisk lig med den formelle AI-koncept kaldet beslutningstræ. Algoritmen gennemgår det for at nå 'bladet' - beslutningen om, hvilken handling der skal tages.
Lad os lave et flowchart til beslutningstræet for vores platforms algoritme:
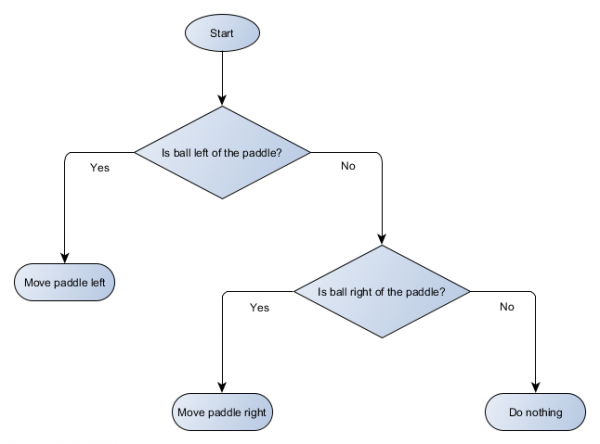
Hver del af træet kaldes en node - AI bruger grafteori til at beskrive sådanne strukturer. Der er to typer noder:
- Beslutningsnoder: valg mellem to alternativer baseret på kontrol af en betingelse, hvor hvert alternativ præsenteres som en separat node.
- Terminalnoder: en handling, der skal udføres, som repræsenterer den endelige beslutning.
Algoritmen begynder med den første node ('roden' af træet). Den træffer enten en beslutning om, hvilken datternode der skal gå til, eller udfører den handling, der er gemt i noden, og afsluttes.
Hvad er fordelene, hvis beslutningstræet udfører det samme arbejde som if-operatorer i det forgående afsnit? Her er der et generelt system, hvor hver beslutning kun har én betingelse og to mulige resultater. Dette gør det muligt for udvikleren at skabe AI baseret på data, der repræsenterer beslutninger i træet, og undgå hardcoding. Lad os forestille os det i form af en tabel:
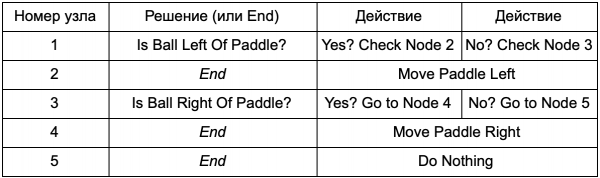
På kodens side får du et system til at læse rækker. Opret en node for hver af dem, tilslut beslutningstagning logikken baseret på den anden kolonne og datterknuderne baseret på den tredje og fjerde kolonne. Du skal stadig programmere betingelser og handlinger, men nu vil spilstrukturen være mere kompleks. I den tilføjer du flere beslutninger og handlinger, og derefter justerer du hele AI'en blot ved at redigere en tekstfil med definitionen af træet. Derefter overleveres filen til spildesigneren, som vil kunne ændre adfærden uden at recompilere spillet og ændre koden.
Beslutningstræer er meget nyttige, når de automatisk genereres baseret på et stort antal eksempler (f.eks. ved hjælp af ID3-algoritmen). Dette gør dem til et effektivt og højtydende værktøj til klassificering af situationer baseret på indsamlede data. Men vi går ud over et simpelt system til at vælge handlinger for agenter.
Scenarier
Vi har gennemgået systemet for beslutningstræet, som brugte foruddefinerede betingelser og handlinger. Mennesket, der designer AI, kan organisere træet, som de ønsker, men de skal stadig stole på koderen, der programmerede det hele. Hvad hvis vi kunne give designeren værktøjerne til at skabe deres egne betingelser eller handlinger?
For at programmøren ikke skal skrive kode for betingelserne Is Ball Left Of Paddle og Is Ball Right Of Paddle, kan han lave et system, hvor designeren vil indtaste betingelser for at kontrollere disse værdier. Så ville dataene i beslutningstræet se sådan ud:
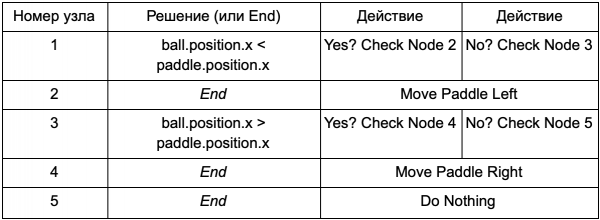
I bundet er det dybest set det samme som i den første tabel, men løsningerne har deres egen kode, der ligner den betingede del af en if-sætning. I koden ville dette blive læst i den anden kolonne for beslutningstagningsnoder, men i stedet for at lede efter en specifik betingelse for at udføre (Is Ball Left Of Paddle) vurderer det det betingede udtryk og returnerer true eller false. Dette gøres med scripting-sproget Lua eller Angelscript. Ved hjælp af disse kan udvikleren tage objekter i sit spil (bold og paddle) og oprette variable, der vil være tilgængelige i scriptet (ball.position). Desuden er scriptsproget enklere end C++. Det kræver ikke en fuld kompilering, hvilket gør det ideelt til hurtige justeringer af spilogikken og giver "ikke-programmører" mulighed for at oprette de ønskede funktioner selv.
I det givne eksempel bruges scripting-sproget kun til at vurdere det betingede udtryk, men det kan også bruges til handlinger. For eksempel kan dataene Move Paddle Right blive til en scripting-operator (ball.position.x += 10). På den måde bestemmes handlingen også i scriptet, uden at det er nødvendigt at kode Move Paddle Right.
Man kan gå endnu længere og skrive hele beslutningstræet i et scriptsprog. Dette vil være kode i form af hardcoded betingede operatorer, men de vil befinde sig i eksterne scriptfiler, dvs. de kan ændres uden at genkompilere hele programmet. Ofte kan man ændre scriptfilen midt i spillet for hurtigt at teste forskellige AI-reaktioner.
Reagering på begivenheder
Eksemplerne ovenfor passer perfekt til Pong. De kører konstant en cyklus af Sense/Think/Act og handler baseret på den seneste tilstand af verden. Men i mere komplekse spil skal man reagere på enkeltbegivenheder i stedet for at evaluere alt på én gang. Pong er i så fald ikke et ideelt eksempel. Lad os vælge et andet.
Forestil dig en shooter, hvor fjenderne er stille, indtil de opdager spilleren, hvorefter de handler afhængigt af deres „specialisering”: nogle vil „rush”, mens andre vil angribe på afstand. Dette er stadig et grundlæggende reaktionssystem — „hvis spilleren ses, så gør noget” — men det kan logisk opdeles i begivenheden Player Seen (spilleren set) og reaktionen (vælg en respons og udfør den).
Dette bringer os tilbage til cyklussen Sense/Think/Act. Vi kan kode Sense-delen, som vil tjekke i hver ramme — om AI'en kan se spilleren. Hvis ikke, sker der ikke noget, men hvis den kan se spilleren, oprettes der en begivenhed kaldet Player Seen. Koden vil have en sektion, der siger: "når begivenheden Player Seen indtræffer, så gør ", hvor er det svar, du har brug for for at kommunikere med delene Think og Act. På den måde konfigurerer du reaktionerne på begivenheden Player Seen: for en 'rushende' karakter — ChargeAndAttack, og for en snigskytte — HideAndSnipe. Disse forbindelser kan oprettes i en datafil til hurtig redigering uden behov for at kompilere på ny. Og her kan man også bruge scriptsprog.
At træffe komplekse beslutninger
Selvom enkle reaktionssystemer er meget effektive, er der mange situationer, hvor de ikke er tilstrækkelige. Nogle gange skal man træffe forskellige beslutninger baseret på, hvad agenten gør lige nu, men det er svært at repræsentere dette som en betingelse. Nogle gange er der for mange betingelser til effektivt at repræsentere dem i et beslutningstræ eller script. Nogle gange skal man på forhånd vurdere, hvordan situationen vil ændre sig, før man træffer en beslutning om næste skridt. For at løse disse problemer kræves mere komplekse tilgangsformer.
Endelig tilstandsmaskine
Endelig tilstandsmaskine eller FSM (finite state machine) — det er en metode til at angive, at vores agent i øjeblikket er i en af flere mulige tilstande, og at den kan skifte fra en tilstand til en anden. Antallet af sådanne tilstande er begrænset — deraf navnet. Det bedste virkelige eksempel er et trafiklys. I forskellige steder er der forskellige lyssekvenser, men princippet er det samme — hver tilstand repræsenterer noget (stop, gå osv.). Trafiklyset er kun i én tilstand ad gangen og skifter fra én tilstand til en anden baseret på enkle regler.
Med NPC'er i spil er historien ens. Lad os tage en vagt med følgende tilstande:
- Patruljerende (Patrolling).
- Angrebende (Attacking).
- Flygter (Fleeing).
Og med følgende betingelser for at ændre dens tilstand:
- Hvis vagten ser en fjende, angriber den.
- Hvis vagten angriber, men ikke længere ser fjenden, vender den tilbage til patruljering.
- Hvis vagten angriber, men er alvorligt såret, flygter den.
Du kan også skrive if-sætninger med en vagtstate-variabel og forskellige kontroller: er der en fjende i nærheden, hvad er NPC'ens sundhedsniveau osv. Lad os tilføje et par flere tilstande:
- Inaktivitet (Idling) — mellem patruljeringer.
- Søgning (Searching) — når en observeret fjende er forsvundet.
- Be om hjælp (Finding Help) — når fjenden er bemærket, men for stærk til at kæmpe imod alene.
Valget for hver af dem er begrænset — for eksempel vil vagten ikke søge efter den skjulte fjende, hvis hans helbred er lavt.
I sidste ende kan en massiv liste over "hvis" <x и y, но не z>, så <p>", blive alt for uoverskuelig, så vi bør formaliserer en metode, der gør det muligt for os at huske tilstandene og overgange mellem tilstande. For at gøre dette, lad os tage højde for alle tilstande, og under hver tilstand notere en liste over alle overgange til andre tilstande, sammen med de nødvendige betingelser for dem.
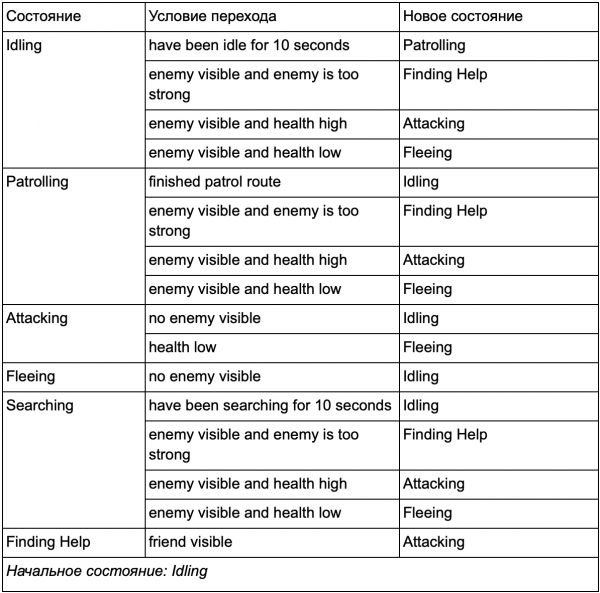
Dette er en overgangstabel for tilstande — en kompleks måde at repræsentere FSM på. Lad os tegne et diagram og få et klart overblik over, hvordan NPC'ens adfærd ændrer sig.
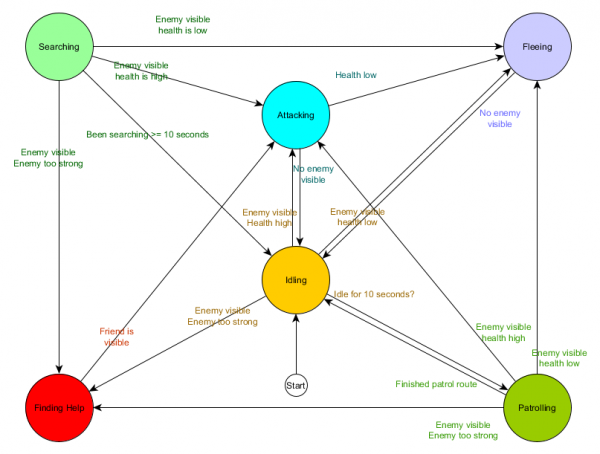
Diagrammet afspejler essensen af beslutningstagning for denne agent baseret på den aktuelle situation. Hver pil viser en overgang mellem tilstande, hvis betingelsen ved siden af er sand.
Ved hver opdatering tjekker vi agentens nuværende tilstand, gennemgår overgange, og hvis betingelserne for en overgang opfyldes, tager den en ny tilstand. For eksempel, hver frame tjekkes det, om 10-sekunders timeren er udløbet, og hvis ja, går vagten fra Idling til Patrolling. På samme måde tjekker tilstanden Attacking agentens helbred — hvis det er lavt, skifter den til tilstanden Fleeing.
Dette er behandling af overgange mellem tilstande, men hvad med adfærden knyttet til selve tilstandene? Når det kommer til implementationen af den faktiske adfærd for en specifik tilstand, eksisterer der typisk to typer 'hooks', hvor vi tildeler handlinger til FSM:
- Handlinger, som vi periodisk udfører for den nuværende tilstand.
- Handlinger, som vi foretager, når vi skifter fra en tilstand til en anden.
Eksempler på den første type. Tilstanden Patrolling vil hver frame bevæge agenten langs patruljeruten. Tilstanden Attacking vil hver frame forsøge at starte et angreb eller skifte til en tilstand, når det er muligt.
For the second type, let's consider the transition 'if the enemy is visible and the enemy is too strong, then switch to the Finding Help state. The agent must choose where to go for help and retain this information so that the Finding Help state knows where to turn. Once help is found, the agent transitions back to the Attacking state. At this point, he will want to inform an ally about the threat, so an action NotifyFriendOfThreat may occur.
Once again, we can look at this system through the lens of the Sense/Think/Act cycle. Sense is embodied in the data used by the transition logic. Think consists of the transitions available in each state. Act is executed through actions performed periodically within the state or during transitions between states.
Sometimes continuous polling of transition conditions can be costly. For example, if each agent performs complex calculations every frame to determine if they see enemies and whether they can transition from Patrolling to Attacking state — it will consume a lot of processor time.
Important changes in the state of the world can be viewed as events that will be processed as they arise. Instead of the FSM checking the transition condition 'can my agent see the player?' every frame, a separate system can be set up to perform checks less frequently (for example, 5 times a second). The result can then yield a Player Seen when the check passes.
This is passed to the FSM, which now needs to transition to the condition Player Seen event received and react accordingly. The final behavior remains the same except for an almost imperceptible delay before the response. However, performance has improved as a result of separating part of the Sense into a separate part of the program.
Hierarkisk finite state machine
However, working with large FSMs is not always convenient. If we want to expand the attack state by separating it into MeleeAttacking (close combat) and RangedAttacking (ranged combat), we will have to change the transitions from all other states that lead to the Attacking state (both current and future).
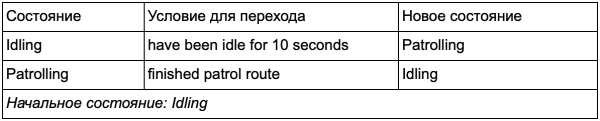
Du har sikkert bemærket, at der i vores eksempel er mange duplikerede overgange. De fleste overgange i tilstanden Idling er identiske med overgange i tilstanden Patrolling. Det ville være godt ikke at gentage os selv, især hvis vi tilføjer flere lignende tilstande. Det giver mening at gruppere Idling og Patrolling under et fælles mærkat "ikke-kamp", hvor der kun er et fælles sæt overgange til kamptilstande. Hvis vi betragter dette mærkat som en tilstand, vil Idling og Patrolling blive undertilstande. Et eksempel på brug af en separat overgangstabel for den nye ikke-kamp undertilstand:
Primære tilstande:
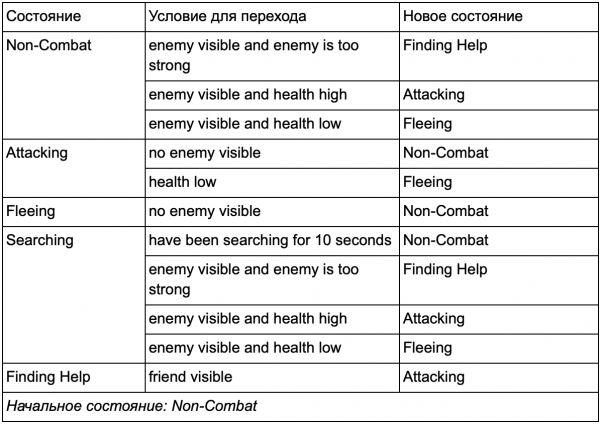
Tilstand uden kamp:
Og i form af et diagram:
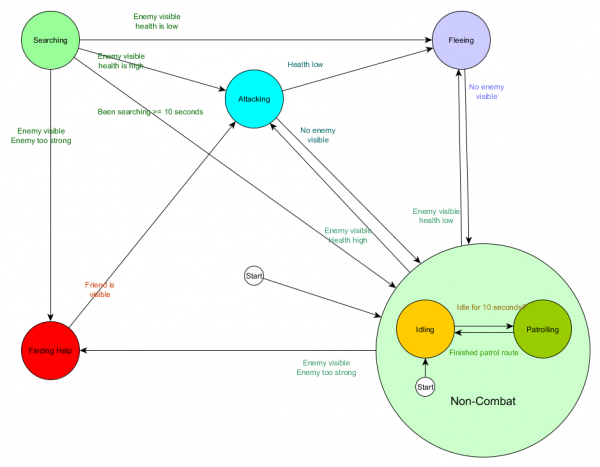
Det er det samme system, men med en ny ikke-kamp tilstand, der inkluderer Idling og Patrolling. Hver tilstand indeholder en FSM med undertilstande (og disse undertilstande kan i sig selv indeholde deres egne FSM'er — og så videre så mange som du har brug for), vi får Hierarchical Finite State Machine eller HFSM (hierarkisk endelig automat). Ved at gruppere den ikke-kamp tilstand, skar vi en masse overflødige overgange væk. Det samme kan gøres for enhver ny tilstand med fælles overgange. For eksempel, hvis vi i fremtiden udvider tilstanden Attacking til tilstandene MeleeAttacking og MissileAttacking, vil de være undertilstande, der skifter imellem hinanden baseret på afstanden til fjenden og tilgængeligheden af ammunition. I sidste ende kan komplekse adfærdsmønstre og adfærdssubmodeller præsenteres med et minimum af duplikerede overgange.
Adfærdstræ
Med HFSM skabes komplekse kombinationer af adfærd på en enkel måde. Der er imidlertid en lille udfordring; beslutningstagning i form af overgangsregler er tæt knyttet til den nuværende tilstand. Og i mange spil er det netop det, der er nødvendigt. Omhyggelig brug af tilstandshierarkiet kan reducere antallet af gentagelser ved overgange. Men nogle gange har man brug for regler, der fungerer uafhængigt af, hvilken tilstand du er i, eller som kan anvendes i næsten alle tilstande. For eksempel, hvis agentens sundhed falder til 25%, ønsker du, at han skal flygte uanset om han har været i kamp, været inaktiv eller talt — du bliver nødt til at tilføje denne betingelse i hver tilstand. Og hvis din designer senere ønsker at ændre tærsklen for lav sundhed fra 25% til 10%, skal der igen arbejdes med dette.
Ideelt set kræver denne situation et system, hvor beslutninger om "hvilken tilstand man skal være i" ligger uden for tilstandene selv, så ændringer kun skal foretages ét sted uden at røre ved overgangsbetingelserne. Her kommer adfærds-træer ind i billedet.
Der er flere måder at implementere dem på, men essensen er stort set den samme og ligner et beslutningstræ: algoritmen starter med en "rod"-node, og i træet findes noder, der repræsenterer enten beslutninger eller handlinger. Der er dog nogle væsentlige forskelle:
- Nu returnerer noderne en af tre værdier: Succeeded (hvis arbejdet er udført), Failed (hvis det ikke kan startes) eller Running (hvis det stadig kører og der ikke er et endeligt resultat).
- Der er ikke længere beslutningsnoder til at vælge mellem to alternativer. I stedet er der Decorator-noder, som har en enkelt datterenode. Hvis de lykkes, udfører de deres eneste datterenode.
- Noder, der udfører handlinger, returnerer værdien Running for at repræsentere igangværende handlinger.
Dette lille udvalg af noder kan kombineres for at skabe et stort antal komplekse adfærdsmodeller. Lad os forestille os HFSM-vagten fra det forrige eksempel som et adfærds-træ:
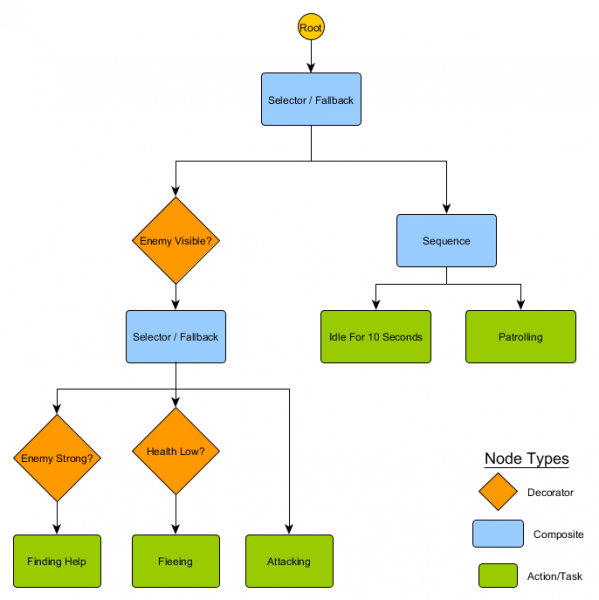
Med denne struktur skal der ikke være nogen åbenlyse overgange fra tilstandene Idling/Patrolling til tilstanden Attacking eller andre. Hvis fjenden er synlig, og karakterens helbred er lavt, vil udførelsen stoppe ved noden Fleeing, uanset hvilken node den tidligere har køRT — Patrolling, Idling, Attacking eller en anden.
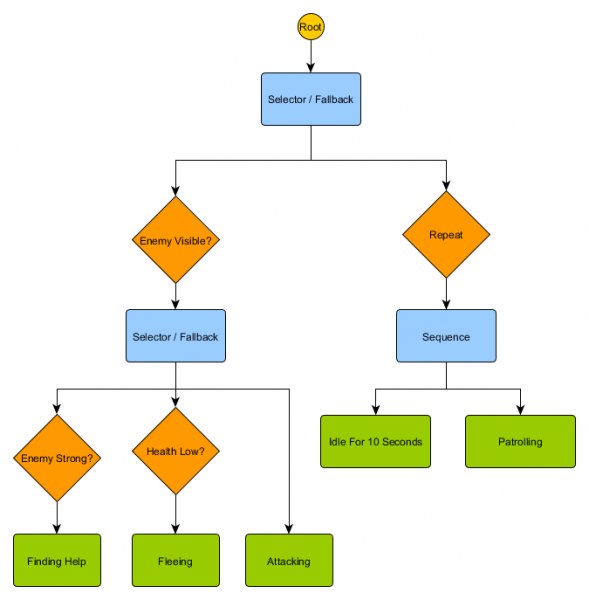
Adfærdstræer er komplekse — der er mange måder at konstruere dem på, og det kan være problematisk at finde den rigtige kombination af dekoratorer og sammensatte noder. Der er også spørgsmål om, hvor ofte man skal kontrollere træet — vil vi gerne gennemgå det hver del, eller kun når en af betingelserne ændres? Hvordan gemmer man tilstanden, der relaterer sig til noderne — hvordan kan man vide, hvornår vi har været i tilstanden Idling i 10 sekunder, eller hvordan kan man vide, hvilke noder der blev udført sidst for at behandle sekvenserne korrekt?
Netop derfor findes der mange implementationer. For eksempel har nogle systemer dekorator-noder erstattet med indbyggede dekoratorer. De evaluerer træet igen, når dekatorbetingelserne ændres, hjælper med at tilslutte noder og giver periodiske opdateringer.
Utility-baseret system
Nogle spil har mange forskellige mekanikker. Det er ønskeligt, at de får alle fordelene ved enkle og generelle overgangspunktregler, men det er ikke nødvendigt i form af et fuldt adfærdsdiagram. I stedet for at have et klart sæt valg eller et træ af mulige handlinger er det lettere at lære alle handlinger at kende og vælge den mest passende i det givne øjeblik.
Et system baseret på nytte (utility-based system) hjælper netop med dette. Det er et system, hvor agenten har mange handlinger at vælge imellem, og selv vælger hvilken der skal udføres, baseret på den relative nytte af hver handling. Hvor nytte er et vilkårligt mål for, hvor vigtigt eller ønskeligt det er for agenten at udføre denne handling.
Den beregnede nytte af en handling baseret på den nuværende tilstand og miljø kan agenten kontrollere og vælge det mest passende alternative tilstand når som helst. Det ligner en FSM, bortset fra at overgange defineres af vurderingen af hver potentiel tilstand, inklusive den nuværende. Bemærk, at vi vælger den mest nyttige handling til at overgå (eller bliver, hvis vi allerede har udført den). For at skabe større variation kan det være et vægtet, men tilfældigt valg fra en lille liste.
Systemet tildeler et vilkårligt interval af nytteværdier - for eksempel fra 0 (helt uønsket) til 100 (fuldt ønsket). Hver handling har en række parametre, der påvirker beregningen af denne værdi. Tilbage til vores eksempel med vagten:
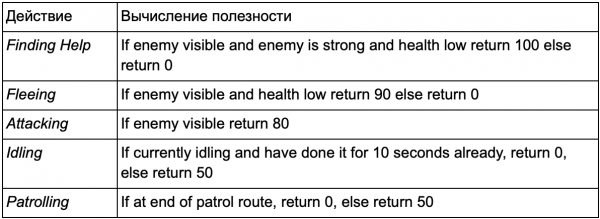
Overgange mellem handlinger er flertydige - enhver tilstand kan følge efter enhver anden. Prioriteterne for handlinger findes i de returnerede nytteværdier. Hvis fjenden er synlig, og denne fjende er stærk, mens karakterens helbred er lavt, vil både Fleeing og FindingHelp returnere høje, ikke-nul værdier. Her vil FindingHelp dog altid være højere. På samme måde returnerer ikke-kamphandlinger aldrig mere end 50, så de vil altid være lavere end kamphandlinger. Dette skal tages i betragtning ved oprettelsen af handlinger og beregningen af deres nytte.
I vores eksempel returnerer handlingerne enten en fast konstant værdi eller en af to faste værdier. Et mere realistisk system forudsætter, at der returneres en vurdering fra et kontinuerligt interval af værdier. For eksempel returnerer handlingen Fleeing højere nytteværdier, hvis agentens helbred er lavt, mens handlingen Attacking returnerer lavere, hvis fjenden er for stærk. På grund af dette har handlingen Fleeing forrang over Attacking i enhver situation, hvor agenten føler, at der ikke er tilstrækkeligt helbred til at overvinde modstanderen. Dette giver mulighed for at ændre prioriteterne for handlinger baseret på et vilkårligt antal kriterier, hvilket gør denne tilgang mere fleksibel og variabel end adfærdstræer eller FSM.
Hver handling har mange betingelser for at beregne programmet. De kan skrives i scriptsprog eller som en række matematiske formler. I The Sims, som modellerer en karakters dagligdag, tilføjes der et ekstra niveau af beregninger — agenten modtager en række 'motivationer', der påvirker nyttevurderingerne. Hvis karakteren er sulten, vil den over tid blive endnu mere sulten, og nytteværdien af handlingen EatFood vil stige, indtil karakteren udfører den, hvilket reducerer sulten og bringer værdien af EatFood tilbage til nul.
Idéen om at vælge handlinger baseret på et vurderingssystem er ret simpel, så et nyttebaseret system kan bruges som del af AI-beslutningsprocesser, snarere end som en fuldstændig erstatning. Beslutningstræet kan anmode om en nyttevurdering af to undernoder og vælge den højere. På samme måde kan adfærdstræet have en sammensat nytte-knude til at vurdere nytteværdien af handlinger for at beslutte, hvilken underenhed der skal udføres.
Bevægelse og navigation
I de tidligere eksempler havde vi en platform, som vi bevægede til venstre eller højre, og en vagt, der patruljerede eller angreb. Men hvordan håndterer vi faktisk agentens bevægelse over en bestemt tid? Hvordan fastsætter vi hastigheden, hvordan undgår vi forhindringer, og hvordan planlægger vi ruten, hvis det er sværere at nå destinationen end blot at bevæge sig lige frem? Lad os tage et kig på det.
Administration
I starten antager vi, at hver agent har en hastighedsværdi, som inkluderer, hvor hurtigt den bevæger sig, og i hvilken retning. Den kan måles i meter pr. sekund, kilometer i timen, pixels pr. sekund osv. Når vi husker cyklussen Sense/Tænke/Handle, kan vi forestille os, at en del af Tænke vælger hastighed, mens en del af Handle anvender denne hastighed på agenten. Normalt er der i spil et fysiksystem, der udfører denne opgave for dig ved at studere hastighedsværdien af hver objekt og justere den. Derfor kan AI efterlades med én opgave — at beslutte, hvilken hastighed agenten skal have. Hvis det er kendt, hvor agenten skal være, skal den flyttes i den rigtige retning med den angivne hastighed. Et meget trivielt ligning:
desired_travel = destination_position – agent_position
Forestil dig en 2D-verden. Agenten er i punktet (-2,-2), destinationspunktet ligger et sted mod nordøst i punktet (30, 20), og den nødvendige vej for agenten at nå dertil er (32, 22). Antag, at disse positioner måles i meter — hvis vi tager hastigheden for agenten som 5 meter pr. sekund, vil vi skalere vores bevægelsesvektor og få en hastighed på cirka (4.12, 2.83). Med disse parametre ville agenten nå destinationen om næsten 8 sekunder.
Værdierne kan genberegnes når som helst. Hvis agenten er halvvejs til målet, vil bevægelsen være halvdelen af længden, men da agentens maksimale hastighed er 5 m/s (som vi har besluttet ovenfor), vil hastigheden være den samme. Dette fungerer også for bevægende mål, hvilket giver agenten mulighed for at foretage små justeringer, mens de bevæger sig.
Men vi ønsker mere variabilitet — for eksempel langsomt at øge hastigheden for at simulere en karakter, der bevæger sig fra stillestående til løb. Det samme kan gøres i slutningen før stop. Disse funktioner kaldes steering behaviours, hver med specifikke navne: Seek (søge), Flee (flygte), Arrival (ankomst) osv. Ideen er, at accelerationskræfter kan anvendes på agentens hastighed, baseret på sammenligning af agentens position og nuværende hastighed med destinationspunktet, for at bruge forskellige måder at bevæge sig mod målet.
Hver adfærd har et lidt andet formål. Seek og Arrival er måder at flytte agenten til en destination. Obstacle Avoidance (undgåelse af forhindringer) og Separation (adskillelse) justerer agentens bevægelse for at undgå forhindringer på vejen mod målet. Alignment (justering) og Cohesion (sammenhold) holder agenterne sammen, når de bevæger sig. Ethvert antal forskellige steering behaviours kan summere til en enkelt banevektor, der tager højde for alle faktorer. En agent, der bruger adfærd som Arrival, Separation og Obstacle Avoidance for at holde sig væk fra vægge og andre agenter. Denne tilgang fungerer godt i åbne områder uden for mange detaljer.
Under sværere forhold fungerer summen af forskellige adfærd dårligere — for eksempel kan en agent sidde fast i en væg på grund af konflikten mellem Arrival og Obstacle Avoidance. Derfor er det nødvendigt at overveje muligheder, der er mere komplekse end blot at summere alle værdier. En metode er: i stedet for at summere resultaterne fra hver adfærd, kan man overveje bevægelse i forskellige retninger og vælge den bedste mulighed.
Men i et komplekst miljø med blindgader og valg om, hvilken retning man skal gå, har vi brug for noget endnu mere avanceret.
Søgevej
Steering behaviours er ideelle til simpel bevægelse på åbne områder (fodboldbane eller arena), hvor det at komme fra A til B er en direkte vej med små afvigelser forbi forhindringer. For komplekse ruter har vi brug for pathfinding (vejfinding), som er en metode til at udforske verden og træffe beslutninger om ruten gennem den.
Den mest enkle måde er at lægge et net over hvert kvadrat ved siden af agenten og vurdere, hvilke der er tilladt at bevæge sig ind i. Hvis et af dem er bestemmelsesstedet, skal du følge vejen fra hvert kvadrat tilbage til det forrige, indtil du når starten. Det er ruten. Ellers gentag processen med de nærmeste andre kvadrater, indtil du finder bestemmelsesstedet eller løber tør for kvadrater (hvilket betyder, at der ikke er nogen mulig rute). Dette er formelt kendt som Breadth-First Search eller BFS (bredde-først søgning). På hvert trin ser den i alle retninger (deraf breadth, 'bredde'). Søgeområdet ligner en bølgefront, der bevæger sig, indtil den når det ønskede sted - søgeområdet udvider sig ved hvert skridt, indtil det når slutpunktet, hvorefter vejen tilbage til starten kan spores.
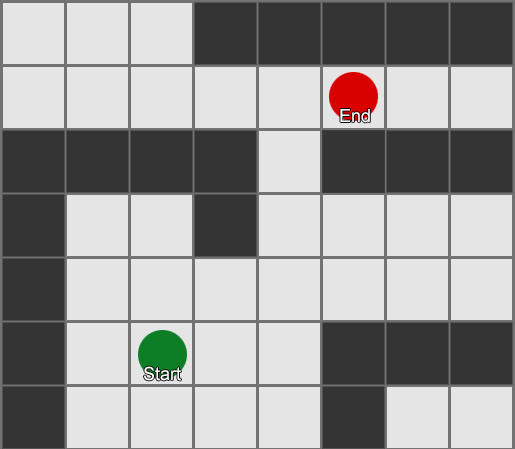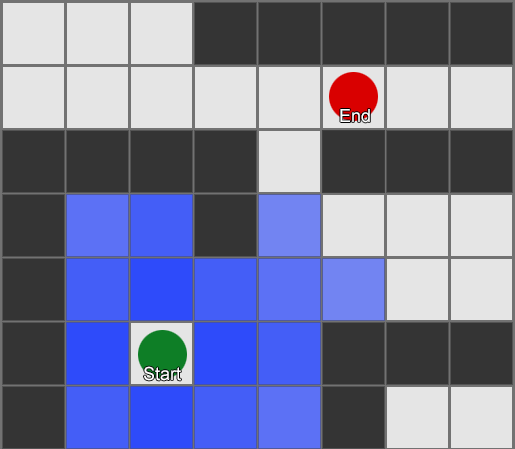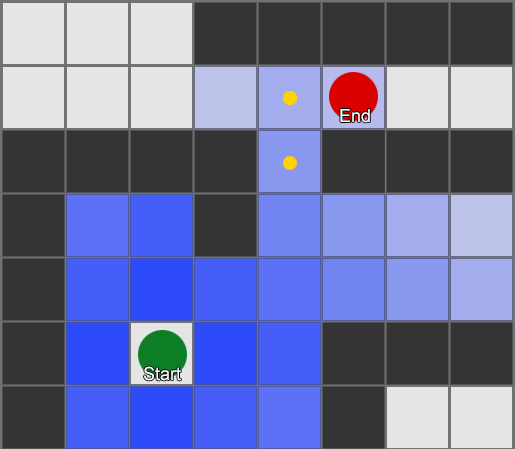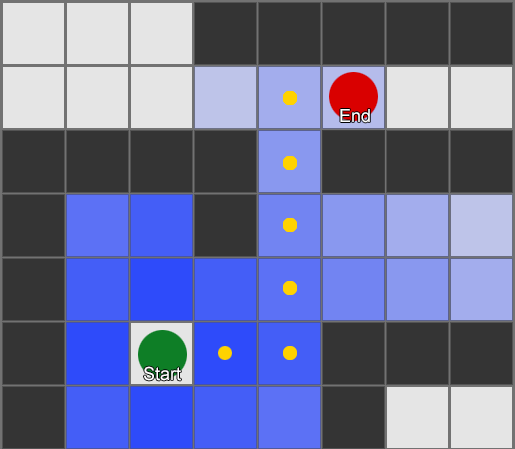
Som resultat får du en liste over kvadrater, der udgør den ønskede rute. Det er vejen (deraf pathfinding) - en liste over steder, som agenten vil besøge, mens den bevæger sig mod bestemmelsen.
I betragtning af at vi kender positionen af hvert kvadrat i verden, kan vi bruge steering behaviours til at bevæge os langs ruten - fra node 1 til node 2, derefter fra node 2 til node 3 og så videre. Den enkleste tilgang er at styre mod midten af det næste kvadrat, men det er endnu bedre at stoppe ved midten af kanten mellem det aktuelle kvadrat og det næste. Dette gør det muligt for agenten at skære hjørnerne på skarpe sving.
BFS-algoritmen har også ulemper - den undersøger lige så mange kvadrater i den 'forkerte' retning som i den 'rette'. Her introduceres en mere kompleks algoritme kaldet A* (A stjerne). Den fungerer på samme måde, men i stedet for blindt at undersøge nabokvadrater (derefter nabokvadraternes naboer, så naboernes naboer osv.), samler den noder i en liste og sorterer dem, så den næste undersøgte node altid er den, der vil føre til den korteste rute. Noderne sorteres baseret på en heuristik, der tager højde for to ting - 'omkostningerne' ved den hypotetiske rute til det ønskede kvadrat (herunder eventuelle omkostninger ved bevægelse) og en vurdering af, hvor langt dette kvadrat er fra bestemmelsesstedet (ved at lede søgningen i den rigtige retning).
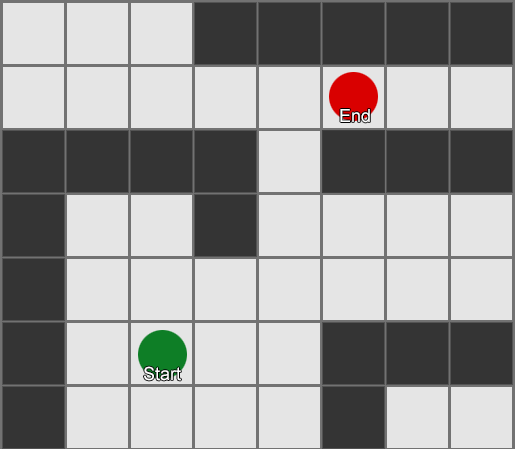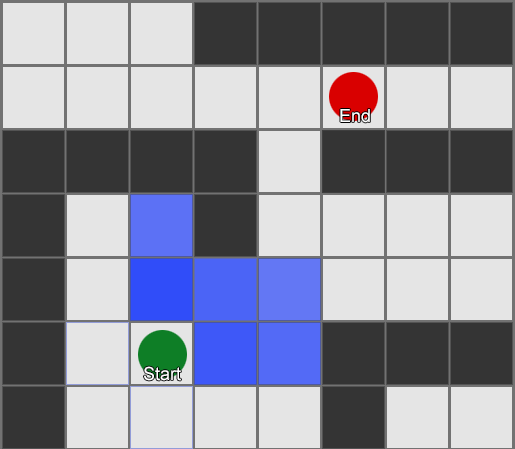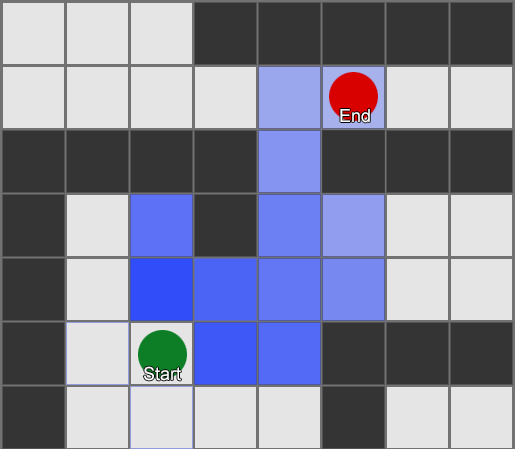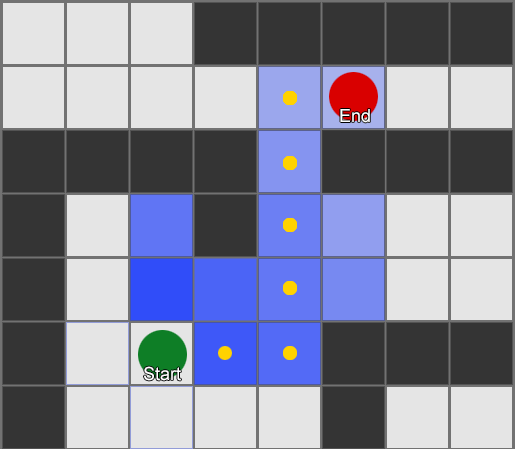
I dette eksempel ses det, at agenten undersøger én sektion ad gangen og hver gang vælger den mest lovende nabosektion. Den resulterende sti er den samme som ved BFS, men færre sektioner er blevet overvejet undervejs - og det har stor betydning for spillets ydeevne.
Bevægelse uden net
Men de fleste spil er ikke opdelt i net, og det er ofte umuligt at gøre det uden at skade realismen. Kompromiser er nødvendige. Hvad skal størrelsen på sektionerne være? Hvis de er for store, kan de ikke korrekt repræsentere små gange eller sving; hvis de er for små, vil der være alt for mange sektioner at søge i, hvilket til sidst tager en masse tid.
Det første, man skal forstå, er, at nettet giver os et graf over forbundet noder. A* og BFS algoritmer arbejder reelt med grafer og bekymrer sig slet ikke om vores net. Vi kunne placere noder hvor som helst i spillets verden: hvis der er forbindelse mellem to tilsluttede noder samt mellem start- og slutpunktet og mindst én af noderne, så vil algoritmen fungere lige så godt som før. Dette kaldes ofte et waypoint-system, da hver node repræsenterer en betydningsfuld position i verden, der kan være del af et uendeligt antal hypotetiske stier.
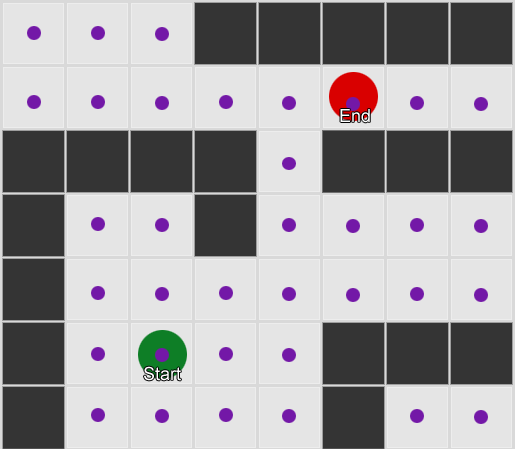
Eksempel 1: En node i hver sektion. Søgningen begynder fra noden, som agenten befinder sig i, og slutter i noden for den ønskede sektion.
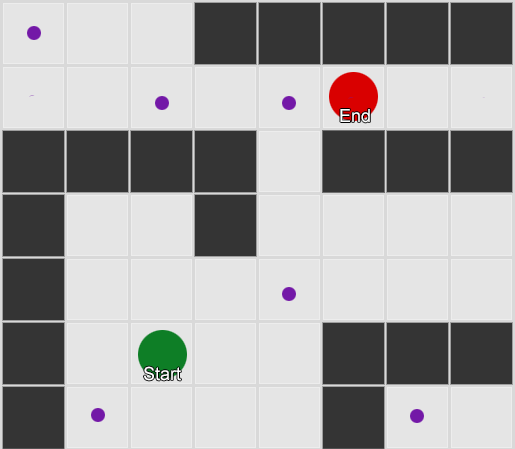
Eksempel 2: Et mindre udvalg af noder (waypoints). Søgningen begynder i sektionen med agenten, går gennem det nødvendige antal noder, og fortsætter derefter til destinationen.
Dette er et ret fleksibelt og kraftfuldt system. Men der skal tages visse forholdsregler, når det kommer til, hvor og hvordan man placerer waypoints, ellers kan agenterne simpelthen ikke se den nærmeste punkt og ikke være i stand til at starte deres rute. Det ville være lettere, hvis vi kunne placere waypoints automatisk baseret på verdens geometri.
Her kommer navigation mesh eller navmesh (navigationsnet) ind. Det er typisk et 2D-net af trekanter, der er lagt over verdens geometri - hvor agenten har tilladelse til at bevæge sig. Hver trekant i nettet bliver en node i grafen og kan have op til tre nabotrekants, som bliver tilstødende noder i grafen.
Dette billede er et eksempel fra Unity-engine — den har analyseret geometrien i verden og skabt en navmesh (vist lys blå på skærmen). Hver polygon i navmesh er et område, hvor en agent kan stå eller bevæge sig fra en polygon til en anden. I dette eksempel er polygonerne mindre end de etager, de er placeret på — dette er gjort for at tage højde for størrelsen af agenten, som vil overskride sin nominelle position.
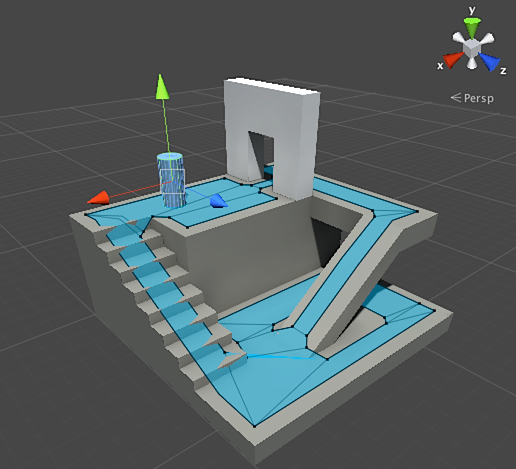
Vi kan finde en rute gennem dette netværk ved igen at bruge A*-algoritmen. Dette vil give os en næsten perfekt rute i verden, der tager højde for al geometrien og samtidig ikke kræver unødvendige noder eller oprettelse af waypoint.
Pathfinding er et alt for omfattende emne til blot at blive dækket i et afsnit i en artikel. Ønsker du at dykke dybere ned i det, kan du finde hjælp på .
Planlægning
Vi har med pathfinding set, at det nogle gange ikke er nok blot at vælge en retning og bevæge sig — vi skal vælge en rute og tage nogle drejninger for at nå vores ønskede destination. Vi kan opsummere denne idé: at nå et mål er ikke blot næste skridt, men en hel sekvens, hvor det til tider kræver, at vi ser fremad et par skridt for at finde ud af, hvad det første skridt skal være. Dette kaldes planlægning. Pathfinding kan betragtes som et af flere supplementer til planlægning. Set fra vores Sense/Think/Act cyklus er dette, hvor en del af Think planlægger flere dele af Act for fremtiden.
Lad os se på et eksempel fra brætspillet Magic: The Gathering. Vi spiller først med følgende kort på hånden:
- Swamp — giver 1 sort mana (landkort).
- Forest — giver 1 grøn mana (landkort).
- Fugitive Wizard — kræver 1 blå mana for at kunne blive kaldt.
- Elvish Mystic — kræver 1 grøn mana for at kunne blive kaldt.
De resterende tre kort ignorerer vi for at gøre det enklere. Ifølge reglerne er det tilladt for spilleren at spille 1 landkort per tur; han kan "tappe" dette kort for at få mana, og derefter bruge trylleformularer (inklusive at kalde skabninger) i henhold til mængden af mana. I denne situation ved den menneskelige spiller, at han skal spille Forest, "tappe" 1 grøn mana, og derefter kalde Elvish Mystic. Men hvordan kan den spillede AI gætte dette?
Simpel planlægning
Den trivielle tilgang er at prøve hver handling i rækkefølge, indtil der ikke er flere passende. Når AI kigger på kortene, ser det, at det kan spille Swamp. Og det spiller det. Er der andre handlinger tilbage i denne tur? Det kan ikke spille hverken Elvish Mystic eller Fugitive Wizard, da der kræves henholdsvis grøn og blå mana for at spille dem, og Swamp giver kun sort mana. Og det kan ikke spille Forest, fordi det allerede har spillet Swamp. Dermed har den spillegående AI handlet efter reglerne, men gjort det dårligt. Det kan forbedres.
Planlægning kan finde en liste over handlinger, der fører spillet til den ønskede tilstand. Ligesom hver firkant på stien havde naboer (i pathfinding), har hver handling i planen også naboer eller efterfølgere. Vi kan søge efter disse handlinger og efterfølgende handlinger, indtil vi når den ønskede tilstand.
I vores eksempel er det ønskede resultat "at påkalde en skabning, hvis det er muligt". I starten af turen ser vi kun to mulige handlinger, som er tilladt af spillets regler:
1. Spille Swamp (resultat: Swamp i spillet)
2. Spille Forest (resultat: Forest i spillet)
Hver accepteret handling kan føre til yderligere handlinger og lukke andre, igen afhængigt af spillets regler. Forestil dig, at vi spiller Swamp - det fjerner Swamp som næste skridt (vi har allerede spillet det), og det fjerner også Forest (da reglerne tillader at spille et landkort pr. tur). Herefter tilføjer AI som næste skridt - at få 1 sort mana, fordi der ikke er andre muligheder. Hvis det fortsætter og vælger at Tap the Swamp, får det 1 enhed sort mana og kan ikke gøre noget med det.
1. Spille Swamp (resultat: Swamp i spillet)
1.1 "Tap" Swamp (resultat: Swamp "tapet", +1 enhed sort mana)
Ingen tilgængelige handlinger – SLUT
2. Spille Forest (resultat: Forest i spillet)
Listen over handlinger blev kort, vi er gået i stå. Vi gentager processen for næste handling. Vi spiller Forest, åbnende handlingen "få 1 grøn mana", som i sin tur vil åbne den tredje handling - påkaldelse af Elvish Mystic.
1. Spille Swamp (resultat: Swamp i spillet)
1.1 "Tap" Swamp (resultat: Swamp "tapet", +1 enhed sort mana)
Ingen tilgængelige handlinger – SLUT
2. Spille Forest (resultat: Forest i spillet)
2.1 "Tap" Forest (resultat: Forest "tapet", +1 enhed grøn mana)
2.1.1 Påkalde Elvish Mystic (resultat: Elvish Mystic i spillet, -1 enhed grøn mana)
Ingen tilgængelige handlinger – SLUT
Endelig har vi undersøgt alle mulige handlinger og fundet en plan for at påkalde en skabning.
Dette er et meget forenklet eksempel. Det er bedst at vælge den bedst mulige plan i stedet for hvilken som helst, der opfylder nogle kriterier. Generelt kan man vurdere potentielle planer baseret på det endelige resultat eller den samlede gevinst ved deres udførelse. Man kan få 1 point for at spille et land-kort og 3 point for at påkalde en skabning. At spille Swamp ville give en plan, der giver 1 point. At spille Forest → Tap the Forest → påkalde Elvish Mystic vil straks give 4 point.
Sådan fungerer planlægning i Magic: The Gathering, men denne logik kan anvendes i andre situationer også. For eksempel at flytte en bonde for at frigøre plads til at flytte en løber i skak. Eller at tage skjul bag en væg for sikkert at skyde i XCOM på den måde. I det store hele forstår du essensen.
Forbedret planlægning
Nogle gange er der for mange potentielle handlinger til at overveje hver eneste mulighed. Lad os vende tilbage til eksemplet med Magic: The Gathering: antag, at der er flere land- og skabninger på hånden — antallet af mulige bevægelseskombinationer kan tælles i flere titalls. Der er flere løsninger på problemet.
Den første metode er backwards chaining (baglæns kædning). I stedet for at gennemgå alle kombinationer, er det bedre at starte med det ønskede resultat og prøve at finde en direkte rute. I stedet for at bevæge os fra roden af træet til et bestemt blad, bevæger vi os i modsatte retning — fra bladet til roden. Denne metode er enklere og hurtigere.
Hvis modstanderen har 1 liv, kan man finde planen 'påfør 1 eller flere skadede'. For at opnå dette skal en række betingelser opfyldes:
1. Skaden kan forårsages af en trylleformel — den skal være på hånden.
2. For at spille trylleformlen kræves mana.
3. For at få mana skal man spille et land-kort.
4. For at spille et land-kort skal man have det på hånden.
En anden metode er best-first search (bedste først søgning). I stedet for at gennemgå alle ruter, vælger vi den mest passende. Ofte giver denne metode en optimal plan uden unødvendige omkostninger ved søgning. A* er en form for bedste først søgning — ved at udforske de mest lovende ruter fra starten kan den allerede finde den bedste vej uden at skulle tjekke de øvrige muligheder.
En interessant og altid mere populær variant af best-first search er Monte Carlo Tree Search. I stedet for at gætte, hvilke planer der er bedre end andre ved valget af hver efterfølgende handling, vælger algoritmen tilfældige efterfølgere på hvert trin, indtil den når en afslutning (når planen fører til sejr eller nederlag). Den endelige resultat bruges derefter til at hæve eller sænke vurderingen af "vægten" af de tidligere muligheder. Ved at gentage denne proces flere gange, giver algoritmen en god vurdering af, hvilket næste skridt der er bedst, selvom situationen ændrer sig (hvis modstanderen tager skridt til at forhindre spilleren).
Når man taler om planlægning i spil, kan man ikke undgå Goal-Oriented Action Planning eller GOAP (målrettet handlingsplanlægning). Dette er en vidt brugt og diskuteret metode, men bortset fra et par særprægede detaljer, er det i bund og grund en metode til backwards chaining, som vi tidligere har omtalt. Hvis opgaven var "at eliminere spilleren", og spilleren er dækket af noget, kan planen være: kast en granat → få fat i den → kast.
Der er normalt flere mål, hver med sin egen prioritet. Hvis målet med højeste prioritet ikke kan opfyldes (ingen kombination af handlinger skaber planen "eliminere spilleren", fordi spilleren ikke kan ses), vil AI'en gå tilbage til målene med lavere prioriteter.
Læring og tilpasning
Vi har allerede sagt, at spils AI normalt ikke bruger maskinlæring, fordi det ikke er egnet til at styre agenter i realtid. Men det betyder ikke, at man ikke kan låne noget fra dette område. Vi ønsker en modstander i en shooter, som man kan lære noget af. For eksempel at lære om de bedste positioner på kortet. Eller en modstander i et fighting-spil, der ville blokere ofte brugte spillers kombinationsangreb, hvilket motiverer til at bruge andre. Så maskinlæring kan i sådanne situationer være ret nyttigt.
Statistik og sandsynligheder
Før vi går videre til de komplekse eksempler, lad os vurdere, hvor langt vi kan gå ved at tage nogle enkle målinger og bruge dem til at træffe beslutninger. For eksempel, hvordan kan vi vurdere, om en spiller kan starte et angreb i de første par minutter af spillet, og hvilken forsvarsstrategi vi skal forberede mod dette? Vi kan undersøge spillerens tidligere erfaring for at forstå, hvordan fremtidig reaktion kan se ud. Lad os starte med, at vi ikke har disse data, men vi kan indsamle dem — hver gang AI spiller mod en menneskelig modstander, kan den registrere tidsrammen for det første angreb. Efter flere sessioner vil vi få et gennemsnitligt tidspunkt for, hvornår spilleren vil angribe i fremtiden.
Der er dog et problem med gennemsnitsværdierne: hvis en spiller har 'rush'et' 20 gange og spillet langsomt 20 gange, vil de nødvendige værdier ligge et sted i midten, hvilket ikke giver os noget nyttigt. En af løsningerne er at begrænse inputdataene — vi kan tage de seneste 20 tilfælde i betragtning.
En lignende tilgang anvendes ved vurderingen af sandsynligheden for bestemte handlinger, idet man antager, at spillerens tidligere præferencer vil være de samme i fremtiden. Hvis spilleren angriber os med en ildkugle fem gange, med lyn to gange, og med nærkamp én gang, er det tydeligt, at han foretrækker ildkuglen. Lad os ekstrapolere og se sandsynligheden for brugen af forskellige våben: ildkugle=62,5%, lyn=25% og nærkamp=12,5%. Vores spille-AI skal forberede sig på at forsvare sig mod ild.
En anden interessant metode er at bruge Naive Bayes Classifier (naiv bayesisk klassifikator) til at analysere store mængder inputdata og klassificere situationen, så AI reagerer korrekt. Bayesianske klassifikatorer er mest kendte for deres anvendelse i spamfiltre for e-mail. Her analyserer de ord, sammenligner dem med, hvor disse ord tidligere har optrådt (i spam eller ej), og drager konklusioner om indkommende e-mails. Vi kan gøre det samme, selv med færre inputdata. Baseret på al den nyttige information, som AI ser (f.eks. hvilke fjendtlige enheder der er blevet oprettet, eller hvilke besværgelser de bruger, eller hvilke teknologier de har forsket i), samt det endelige resultat (krig eller fred, 'rush'e eller forsvare os osv.) — vil vi vælge den ønskede adfærd for AI.
Alle disse metoder til læring er tilstrækkelige, men det er ønskeligt at bruge dem baseret på data fra testningen. AI'en vil lære at tilpasse sig de forskellige strategier, som dine playtestere har brugt. En AI, der tilpasser sig spilleren efter lanceringen, kan blive forudsigelig eller omvendt for svær at overvinde.
Tilpasning baseret på værdier
I betragtning af indholdet i vores spilverden og reglerne kan vi ændre sættet af værdier, der påvirker beslutningstagningen, i stedet for blot at bruge inputdata. Vi gør det sådan her:
- Lad AI'en indsamle data om verdens tilstand og nøglebegivenheder under spillet (som angivet ovenfor).
- Vi ændrer nogle vigtige værdier baseret på disse data.
- Vi implementerer vores beslutninger, som er baseret på behandlingen eller evalueringen af disse værdier.
For eksempel har agenten flere værelser at vælge imellem på et førstepersons skydespil. Hvert værelse har sin egen værdi, der bestemmer, hvor ønskeligt det er at besøge. AI'en vælger tilfældigt, hvilket værelse den vil gå ind i, baseret på værdien. Derefter husker agenten, i hvilket værelse han blev dræbt, og sænker dens værdi (sandynligheden for, at han vil vende tilbage dertil). Det samme gælder for den omvendte situation - hvis agenten dræber mange modstandere, øges værdien af værelset.
Markov-model
Hvad hvis vi bruger de indsamlede data til at lave forudsigelser? Hvis vi husker hvert værelse, hvor vi ser spilleren i løbet af en bestemt tidsperiode, vil vi kunne forudsige, hvilket værelse spilleren kan gå til. Ved at spore og registrere spillerens bevægelser mellem værelserne (værdier), kan vi lave forudsigelser.
Lad os tage tre værelser: rødt, grønt og blåt. Og også de observationer, vi har registreret under vores visning af spilsessionen:
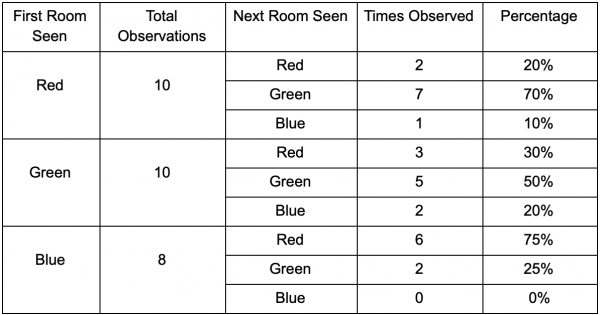
Antallet af observationer for hvert værelse er næsten ligeligt - hvor vi skal placere et godt sted til bagholdet, ved vi stadig ikke. Indsamling af statistik kompliceres også af respawn af spillere, som dukker op jævnt over hele kortet. Men dataene om det næste værelse, de går ind i efter at være blevet respawnet på kortet, er allerede nyttige.
Det er tydeligt, at det grønne rum tilfredsstiller spillerne - de fleste fra det røde rum går ind i det, og 50% af dem bliver der. Det blå rum derimod er ikke populært, næsten ingen går ind i det, og hvis de gør, så bliver de ikke længe.
Men dataene fortæller os noget mere vigtigt - når spilleren er i det blå rum, så vil det næste rum, hvor vi højst sandsynligt ser ham, være det røde og ikke det grønne. Selvom det grønne rum er mere populært end det røde, ændrer situationen sig, hvis spilleren er i det blå. Den næste tilstand (dvs. det rum, som spilleren vil gå ind i) afhænger af den forrige tilstand (dvs. rummet, som spilleren befinder sig i nu). Gennem undersøgelse af afhængigheder vil vi kunne lave mere præcise forudsigelser end hvis vi blot tæller observationerne uafhængigt af hinanden.
At forudsige den fremtidige tilstand baseret på data fra den forrige tilstand kaldes en Markov-model, og sådanne eksempler (med rummene) kaldes Markov-kæder. Da modellerne repræsenterer sandsynligheden for ændringer mellem de følgende tilstande, vises de visuelt i form af en FSM med sandsynligheder omkring hver overgang. Tidligere har vi brugt FSM til at repræsentere den adfærdsmæssige tilstand, som agenten befandt sig i, men dette koncept kan anvendes på enhver tilstand, uanset om den er relateret til agenten eller ej. I dette tilfælde repræsenterer tilstandene det rum, som agenten optager:
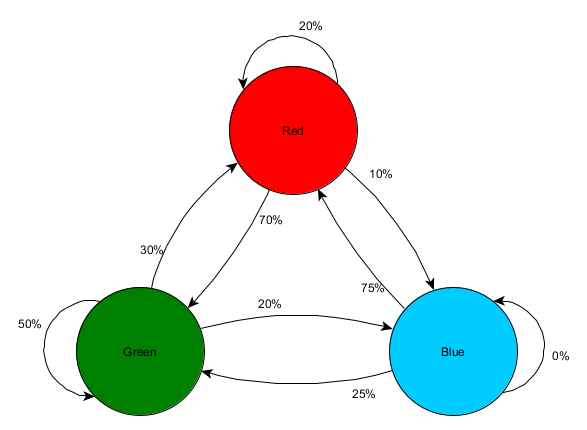
Dette er en enkel måde at repræsentere den relative sandsynlighed for ændringer i tilstande, som giver AI en mulighed for at forudsige den næste tilstand. Der kan forudses flere skridt fremad.
Hvis spilleren er i det grønne rum, er der 50% chance for, at han forbliver der ved den næste observation. Men hvad er sandsynligheden for, at han stadig vil være der bagefter? Der er ikke kun en chance for, at spilleren er forblevet i det grønne rum efter to observationer, men også en chance for, at han har forladt og derefter kommet tilbage. Her er en ny tabel, der tager højde for de nye data:
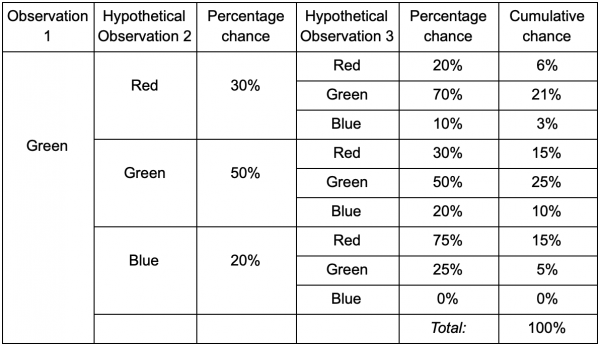
Heraf fremgår det, at chancen for at se spilleren i det grønne rum efter to observationer vil være 51% - 21%, at han kommer fra det røde rum, 5% af dem, der indikerer, at spilleren besøger det blå rum imellem, og 25%, at spilleren slet ikke forlader det grønne rum.
En tabel er et visuelt værktøj - proceduren kræver blot, at man multiplicerer sandsynlighederne ved hvert skridt. Det betyder, at du kan kigge langt ind i fremtiden med ét forbehold: Vi antager, at chancen for at komme ind i et rum helt afhænger af det nuværende rum. Dette kaldes Markov-ejendommen - fremtidige tilstande afhænger kun af den nuværende. Men dette er ikke 100% sikkert. Spillerne kan ændre beslutninger baseret på andre faktorer: helbredsniveau eller mængden af ammunition. Da vi ikke fastsætter disse værdier, vil vores forudsigelser være mindre præcise.
N-Grams
Hvad med eksemplet med fight-spillet og forudsigelse af spillerens combo-bevægelser? Det samme gælder! Men i stedet for én tilstand eller begivenhed vil vi undersøge hele sekvenserne, der udgør en combo-hit.
En måde at gøre dette på er at gemme hver input (f.eks. Kick, Punch eller Block) i en buffer og registrere hele bufferen som en begivenhed. Så når spilleren gentagne gange trykker på Kick, Kick, Punch for at udføre SuperDeathFist-angrebet, gemmer AI-systemet alle inputs i bufferen og husker de seneste tre, der bruges ved hvert skridt.
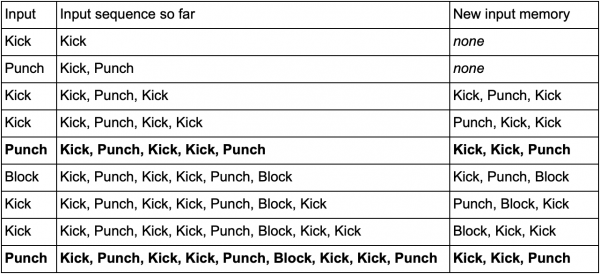
(Fremhævede linjer, når spilleren aktiverer SuperDeathFist-angrebet.)
AI vil se alle mulighederne, når spilleren vælger Kick efterfulgt af Kick, og derefter bemærke, at det næste input altid er Punch. Dette vil give agenten mulighed for at forudsige SuperDeathFist-comboen og blokere den, hvis det er muligt.
Disse sekvenser af begivenheder kaldes N-grammer, hvor N er antallet af gemte elementer. I det forrige eksempel var det en 3-gram (trigram), hvilket betyder, at de to første posters bruges til at forudsige den tredje. Tilsvarende i en 5-gram forudsiger de første fire posters den femte, og så videre.
Udvikleren skal nøje overveje størrelsen af N-grammerne. Et mindre antal N kræver mindre hukommelse, men gemmer også en kortere historie. For eksempel vil en 2-gram (bigram) gemme Kick, Kick eller Kick, Punch, men kan ikke gemme Kick, Kick, Punch, så AI vil ikke reagere på SuperDeathFist-comboen.
På den anden side kræver større tal mere hukommelse, og AI vil have sværere ved at lære, da der vil være mange flere mulige varianter. Hvis du har tre mulige inputs Kick, Punch eller Block, og vi bruger en 10-gram, vil der approximativt være omkring 60.000 forskellige varianter.
Modellen af bigrammer er en simpel Markov-kæde — hvert par "tidligere tilstand/nuværende tilstand" er en bigram, og du kan forudsige den anden tilstand baseret på den første. 3-grammer og større N-grammer kan også betragtes som Markov-kæder, hvor alle elementer (undtagen det sidste i N-grammet) tilsammen danner den første tilstand, og det sidste element er den anden. Et eksempel med kampe viser chancen for at gå fra tilstanden Kick og Kick til tilstanden Kick og Punch. Ved at betragte flere poster i indgangshistorikken som én enhed, omdanner vi i bund og grund indgangssekvensen til en del af en hel tilstand. Dette giver os Markov-egenskaber, der gør det muligt at bruge Markov-kæder til at forudsige næste input og gætte, hvilken kombinationsbevægelse der vil komme næste.
Konklusion
Vi har talt om de mest almindelige værktøjer og tilgange inden for udvikling af kunstig intelligens. Vi har også gennemgået situationer, hvor de skal anvendes, og hvor de er særligt nyttige.
Dette burde være tilstrækkeligt til at forstå de grundlæggende aspekter af spil-AI. Men selvfølgelig er dette langt fra alle metoder. Blandt de mindre populære, men ikke mindre effektive er:
- optimeringsalgoritmer, herunder bjergbestigning, gradientnedstigning og genetiske algoritmer
- konkurrencesøgning/planlægningsalgoritmer (minimax og alpha-beta pruning)
- klassifikationsmetoder (perceptroner, neurale netværk og støttevektormaskiner)
- systemer til behandling af agenter, opfattelse og hukommelse
- arkitektoniske tilgange til AI (hybridsystemer, undergrupper af arkitekturer og andre måder at lægge AI-systemer oven på hinanden)
- animationsværktøjer (planlægning og koordinering af bevægelse)
- ydelsesfaktorer (detaljeniveau, anytime-algoritmer og timeslicing)
Internetsider om emnet:
1. På GameDev.net findes der , samt .
2. indeholder mange præsentationer og artikler om en bred vifte af emner relateret til udviklingen af spil-AI.
3. inkluderer emner fra GDC AI summit, hvor mange er tilgængelige gratis.
4. Nyttige materialer kan også findes på .
5. Tommy Thompson, AI- forsker og spiludvikler, laver videoer på YouTube-kanalen med forklaringer og studier af AI i kommercielle spil.
Bøger om emnet:
1. Serien af bøgerne Game AI Pro er samlinger af korte artikler, der forklarer, hvordan man implementerer specifikke funktioner eller hvordan man løser specifikke problemer.
2. Serien AI Game Programming Wisdom er forgængeren til serien Game AI Pro. Den indeholder ældre metoder, men næsten alle er stadig relevante i dag.
3. — er en af de grundlæggende tekster for alle, der ønsker at forstå det generelle område inden for kunstig intelligens. Denne bog handler ikke om spiludvikling — den lærer de grundlæggende principper for AI.
Kilde: habr.com
