

Udgivelsen af version 0.9.0 af biblioteket til C++ (C++20 standarden) libunicode. Projektet udvikles af et team af udviklere af terminalemulatoren Contour og grænseflade Endo (under aktiv udvikling) og distribueres under Apache 2.0-licensen.
- overholdelse af standarder Unicode 17.0:
- API til at få Unicode egenskaber;
- SIMD-optimering af nogle funktioner (ved brug af std::simd eller std::experimental::simd hvis de er tilgængelige);
- optimeret konvertering mellem UTF-8 <-> UTF-16/UTF-32;
- ækvivalent til funktionen wcwidth (int unicode::width(char32_t));
- segmentering af tekst baseret på grafemer, tegn, emoji og skriftsystemer;
- ændring af store og små bogstaver og sammenligning af strenge;
- højniveau API til segmentering af tekst, velegnet til implementering af tekstformatering.
- testdækning for de fleste af bibliotekets funktioner (tegnbredde og segmentering).
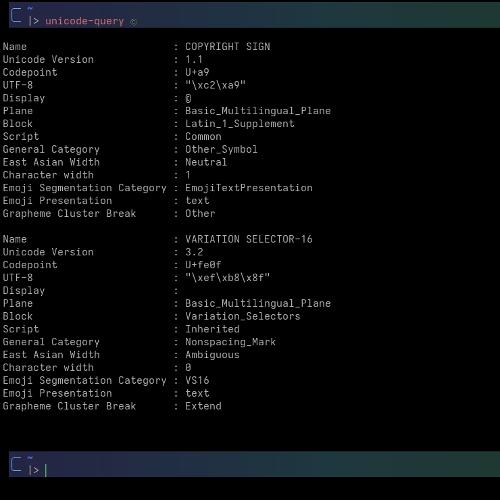
Leveringspakken inkluderer også kommandolinjeværktøjet unicode-query til at få detaljerede oplysninger om strenge.
Ændringer:
- API til grapheme_cluster_width tilføjet;
- forbedringer i arbejdet med Unicode-versioner ("Age");
- fuld support UAX #15 Unicode normaliseringsformer med understøttelse af streamingbehandling:
normalizer norm(Normalization_Form::NFC); \/\/ Feed dekomponeret e + kombinerende acute, så en ny starter for at udløse emission auto resultat = norm.feed(U’e’); CHECK(result.empty()); \/\/ stadig buffering resultat = norm.feed(U’u0301′); CHECK(result.empty()); \/\/ stadig buffering (kombinerende tegn) resultat = norm.feed(U’x’); \/\/ starter udløser emission af det forrige segment REQUIRE_FALSE(result.empty()); CHECK(result == U"u00E9"); \/\/ e + acute komposition til e-acute resultat = norm.flush(); CHECK(result == U"x"); \/\/ endeligt segment
- funktionen script_extensions returnerer nu std::optional<std::span<Script const>>;
- reglen GB9c for segmentering af grafemgrupper for tegnkombinationer i indiske sprog er implementeret;
- i grapheme_segmenter er reglerne for GB11 og GB4/GB5 rettet; forældet API er fjernet;
- SIMD-optimeret konvertering af UTF-8 til UTF-16/UTF-32 er implementeret;
- bredden af forbindelsestegnene Hangul V/T er nu lig med nul;
- segmentering efter ordgrænser er implementeret;
- rettelser i C API;
- refaktorisering af byggesystemet og den hjælpende C++ tabelgenerator;
- komplekse tests for konvertering mellem UTF-16/UTF-32 er tilføjet;
- CI har fået tilføjet en statisk bygning af værktøjet unicode-query.
Kilde: linux.org.ru
