

Det er sjovt, hvordan historien om udgivelserne af åbne modeller til at omdanne tekstprompter til billeder, udviklet og trænet af Stability AI, minder om en række op- og nedture som de successive versioner af Microsofts styresystemer. Efter den legendarisk succesfulde XP, mindes vi, kom den problematiske Vista; derefter den pragtfulde 'syvser' — og efter den den uheldige Windows 8. Stable Diffusion havde en oprindeligt usleben, men gradvist forfine version 1.5, der blev efterfulgt af den åbenlyst mislykkede SD 2.0 — mislykket, fordi den inkluderede den atypiske model for denne slags, decoder OpenCLIP, af . Under et sådant udvælgelsesforløb blev ikke kun upassende (NSFW) visuelle referencer udelukket, men også malerier og illustrationer af populære kunstnere såsom den berygtede Greg Rutkowski. Netop dette fik entusiasterne til at eksplodere: Hvis for SD 1.5 selv i sin grundversion, uden anvendelse af særligt finjusterede checkpoints, enkle prompts med stilarter — 'epic medieval fantasy landscape, in the style of Greg Rutkowski' — fungerede glimrende, og resultatet var imponerende, så stoppede SD 2.0 med at 'genkende' navnene på de mest kendte illustratorer, hvis ophavsret på de skabte værker stadig er gældende, og som ikke havde villet frigive disse værker til træning af AI. Det blev nødvendigt at bruge flere ord til at beskrive det ønskede, og med for lange prompts havde modellen svært ved at håndtere det.
Sæt sig — rejse sig, sæt sig — rejse sig
I forbindelse med den ændrede encoder (konverteringsværktøj, der omdanner tekstprompter til digitale tokens, som modellen derefter arbejder med) frarøvede muligheden for at anvende navngivne stilarter entusiaster motivationen til at videreudvikle "toeren" selv. For det er rigtigt: her skulle man samtidig finde ud af, hvordan man tilpassede den allerede udviklede teknik til at lave prompter til den nye encoder, og genuddanne modellen til at genkende de billeder, som skaberne ikke havde introduceret den for under den indledende træning — og der var dog ikke nogen kvalitativ forskel mellem billederne genereret af "toeren" og "halvanden". Ja, der var et kvalitetsløft fra den standard størrelse på 512×512 pixels, som SD 1.5 havde, til 768×768, men inden da havde fællesskabet allerede massivt anvendt upscalere, outpaintere og andre værktøjer til at øge størrelsen på det endelige billede, så SD 2.0 for det meste gik ubemærket hen. SDXL (udviklet af OpenAI og anvendt blandt andet i DALL-E-projektet) — koden er også åben, men databasen den er trænet på, , er proprietær. Derudover er den standard lærredsstørrelse vokset hos "Oversize" til 1024×1024, plus der er kommet en række yderligere forbedringer, — så entusiaster greb gladeligt chancen for at videreudvikle den. Og på nuværende tidspunkt kan man med sikkerhed sige, at det især er SDXL (samt de i nyere tid mindre hardwarekrævende afledninger som og ) der kan betragtes som den mest populære open source AI-billedgenerator. Dog argumenterer de ivrige tilhængere af SD 1.5 imod dette med henvisning til, at så vigtige værktøjer som ControlNet stadig ikke er blevet overført ordentligt til SDXL. .
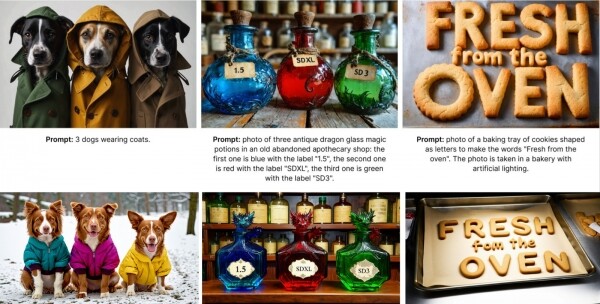
Stable Diffusion 3 Medium Stable Diffusion 3 Large , også kendt som SD3 8B. SDXL 1.0 har, lad os huske, — , men SD3M, ifølge udviklerne, er . Det blev nævnt, at den ved lavere videohukommelsesbehov end "Oversize" selv ved enkle prompts burde levere billeder "med et nyt niveau af fotorealisme". Blandt fordelene ved "treeren" blev også nævnt "enestående kvalitet af typografien af teksten på de genererede billeder", "dyb forståelse af prompts takket være kombinationen af tre kodere" og "parathed til effektiv finjustering selv på begrænsede datasæt".
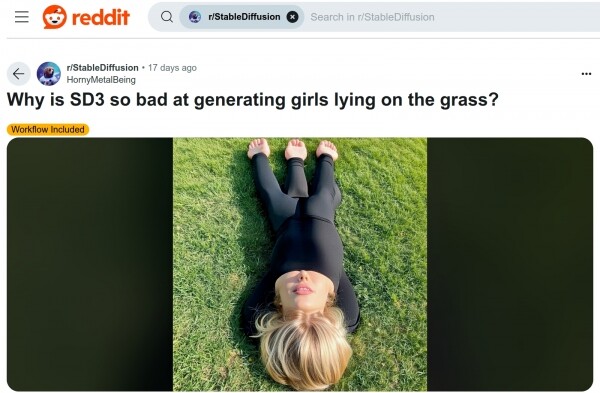
Det var sandsynligvis forventet, at entusiastfellesskabet, efter at have fået en ny eftertragtet leg, ville tage fat på at forbedre den med samme ivrighed som med "halvanden" og "Oversize" engang. Men fra starten gik alt ikke som planlagt: SD3M formåede i de første timer efter offentliggørelsen af model-filerne på Hugging Face og Civitai sin publikums, og det to gange. Første gang — en uforklarlig idiosynkrasi overfor prompts, der inkluderede en tilsyneladende uskyldig sætning "liggende på/i græsset" (lying on/in the grass); den anden — de ufatteligt uklare formuleringer i brugeraftalen, som selv professionelle jurister havde svært ved at forstå ved første øjekast. Selvom det fra en almindelig AI-kunstentusiasts synspunkt virker ubetydeligt, vil det lovlige aspekt have direkte indflydelse på den videre udvikling af modellen — helt til det punkt, hvor der måske slet ikke vil følge nogen udvikling.
Tidligere creationer af Stable Diffusion med åben kilde (mere præcist med åbne værdier for neurnetvægte, tilgængelige til gratis download og derefter lokal udførelse), såsom SDXL, blev ledsaget af en typisk for generative modeller med egenskaber som "evig, global, ikke-eksklusiv, gratis, ubetinget, uigenkaldelig ophavsret med henblik på reproduktion, tilberedning, offentlig fremføring, offentlig visning, underlicensering og distribution af yderligere materialer, både af selve modellen og af heraf afledte materialer". "Trekant" forudser dog to typer licensering: — med ret meget afslappende formuleringer som "Stability AI giver dig en ikke-eksklusiv, global, overdragelig, ikke-underlicensierbar, tilbagekaldelig, gratis og begrænset licens til intellektuel ejendom" — og .
Græsset fører ikke til gode ting
Efter en forholdsvis kort tid nåede fællesskabet til enighed om, at . Og i praksis erklærede de boykot mod udviklerfirmaet, da de ikke ønskede at spilde tid og kræfter på at træne en tydeligvis halvkøddet og halvgennemsigtig model — med forståelsen af, at Stability AI til enhver tid kan, efter et lille indfald fra deres mediechefer, tilbagekalde den licens, der tidligere var givet til en specifik entusiast, der træner sådan en model. Licensaftalen er formuleret på en måde, så det virker som om, at dem, der studerer den, får indtrykket af, at efter tilbagekaldelsen af retten til kommerciel brug af SD3M, vil den tidligere modtager være forpligtet til at slette alle de afledte værker, han har skabt fra den licenserede intellektuelle ejendom, inklusive både de trænede modeller (LoRA, tekstinversioner, hele checkpoints) og deres afledte (citat: "Ved ophør af denne aftale skal du slette og ophøre med at bruge alle softwareprodukter eller afledte værker") — det vil sige, frugterne af arbejdet fra andre mennesker, der har brugt disse afledte modeller som udgangspunkt for deres eget arbejde; og det er udført uden nogen betaling, udført på ren entusiasme.
Kort tid efter at bølgen af forargelse nåede stratosfæriske højder, begyndte der at komme rapporter fra professionelle jurister, Og hvad angår anmeldelsen om forbud mod yderligere brug, så bør den i praksis kun vedrøre visse hjælpemidler med lukket kode, som Stability AI vil videregive til kommercielle brugere (lad os sige, til at fremskynde og optimere den samme finjustering af SD3M), — men virksomheden har endnu ikke givet endelige afklaringer om dette. Og det faktum, at der har været så kvælende tavshed i allerede tre uger (på tidspunktet for denne artikels skrivning) siden 'trekløveret' blev offentligt tilgængeligt, skader udviklerens omdømme langt mere end græs – det genererede skaberens værk piger.
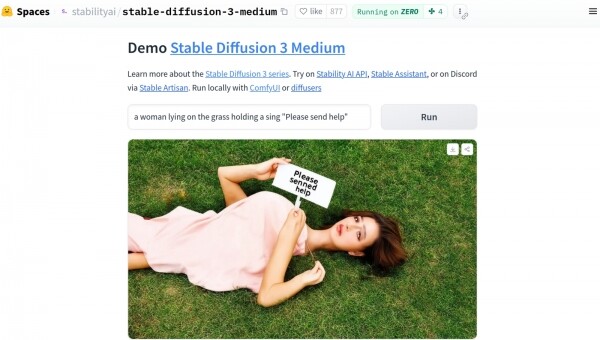
Hvad angår det berygtede græs, der bogstaveligt talt i løbet af få timer blev til et meme , og derefter næsten overalt på de mere eller mindre relevante platforme på nettet, så viste det sig, at tilstedeværelsen af en sætning som 'en pige, der ligger på græsset' i prompten fører til, at 'trekløveret' ikke blot genererer hallucinationer, men mareridtsagtige skabninger fra en syg – i medicinsk forstand – fantasi fra kunstnere og filmskabere, der specialiserer sig i body horror (vi beder dig, hvis fornuft og liv er kært for dig, — hold dig langt fra dette, og prøv ikke engang at skrive denne sætning ind i billedsøgningsvinduet med sikkerhedsfilteret deaktiveret). Samtidig formår 'trekløveret' at producere billeder af stående – og noget mindre siddende – personer med en sikker karakter på 4 med plus, mens portrætter nogle gange er fuldstændig perfekte; i det mindste ikke værre end den grundlæggende model SDXL 1.0, — problemet ligger netop i en slags indre tabu mod den vandrette position af menneskekroppen.
Dømmer efter kommentaren fra Emad Mostaque, grundlæggeren og tidligere (indtil marts 2024) leder af Stability AI, der forlod virksomheden for at , var den grove mishandling af SD3M lige før åbningen af dens vægt til begrænset, ikke-kommerciel brug (API'en til den større model SD3 8B til online generation, lad os huske, , men dens vægt forbliver skjult) et resultat af den nuværende ledelses stræben efter sikkerhed — , formuleret allerede i marts i år som . I henhold til denne politik med brug af den generative model SD3M er det ikke tilladt for brugere "at begå, fremme, tilskynde til, lette, opmuntre, planlægge, instigere eller bidrage til yderligere vold, terrorisme eller skabe indhold, der fremkalder had og diskriminerer eller truer en beskyttet gruppe mennesker (uanset om det er baseret på køn, etnicitet, seksuel identitet eller orientering, religion eller andet)", – så der bliver ingen billeder af pandaer, der kæmper med vilde drager! Udelukkende katte i sjove hatte, hunde i søde jakker, flasker med mystisk indhold og friskbagt småkager!
Teknisk set kan det være, at afskrænkningen af modellen bestod i, at billeder med liggende mennesker og andre billeder, der på en eller anden måde kunne antyde upassende fortolkninger, simpelthen blev udelukket fra træningsdatasættet – og derfor "forstår" "treeren" simpelt hen ikke betydningen af ordet "ligge". Alternativt kunne den opdaterede SD3-arkitektur have gjort det muligt at identificere vægte på perceptronerne, der aktiveres under genereringen af "usikre" billeder, – og disse vægte blev selektivt nulstillet lige før udgivelsen, hvilket resulterede i "tvungen hallucination". Måske, : koderen oversætter korrekt tekst til tokens, men i det "sikrede" latente rum peger disse tokens ikke længere på noget specifikt, – og derfor placeres de resulterende pixels på billedet stort set tilfældigt.
I betragtning af tilgængeligheden af API'et til den fuldt funktionelle, men lukkede model SD3 8B i flere måneder, og de varme forsikringer fra mediecheferne hos Stability AI om, at den "kompakte" 2B , blev offentliggørelsen af SD3M-væggene den 12. juni mødt med stor entusiasme af AI-kunstnere: . I øjeblikket er det stadig muligt at få fat i den, omend via en lidt mere omstændelig rute end normalt for SDXL og SD 1.5 checkpoints. Den sædvanlige metode er at henvende sig til Civitai-sitet, hvor de fleste modeller kan downloades uden registrering, men fra den 17. juni og indtil dette vilkår blev sendt til tryk, er siden dedikeret til "treeren" . Årsagen er én: den kommercielle licens for SD3M er skrevet i så uklart sprog, at selv juristerne fra Civitai har taget sig tid til at undersøge den nærmere. For hvis en entusiast træner LoRA til "treeren" på sin PC og uploader den til Civitai, og Stability AI pludselig mener, at resultatet er upassende, og inddrager licensen fra den involverede, hvordan skal hosting-sitet så forholde sig? De placerer jo ikke bare checkpoints, hjælpeprogrammer og modeller, men giver også besøgende mulighed for både skybaseret billedgenerering og træning af de samme LoRA, tekstinversioner osv. Kort sagt, indtil retssagen er afsluttet, kan man kun få filerne for selve modellen og de tre tilhørende tekst-til-token konvertere fra .
Lad os komme i gang
Der er dog et lille problem: for at få adgang til downloadlinkene skal man logge ind på siden og derefter bekræfte accept af den nævnte drakoniske licensaftale – men denne procedure er gratis og helt tilgængelig fra Rusland. Der tilbydes i alt fire varianter af modellerne (models) og fire konvertere til tekstprompts til tokens (encoders), plus tre standard hjælpeprogrammer til udførelse i ComfyUI-miljøet, :
modeller:
- sd3_medium.safetensors
- sd3_medium_incl_clips.safetensors
- sd3_medium_incl_clips_t5xxlfp8.safetensors
- sd3_medium_incl_clips_t5xxlfp16.safetensors
kodere:
- clip_g.safetensors
- clip_l.safetensors
- t5xxl_fp8_e4m3fn.safetensors
- t5xxl_fp16.safetensors
hjælpemidler:
- sd3_medium_example_workflow_basic.json
- sd3_medium_example_workflow_multi_prompt.json
- sd3_medium_example_workflow_upscaling.json
I denne "Workshop" vil vi begrænse os til den grundlæggende model sd3_medium.safetensors (4,2 GB), tre encoderne — clip_g.safetensors (1,3 GB), clip_l.safetensors (234 MB) og t5xxl_fp8_e4m3fn.safetensors (4,7 GB), samt eksempelcykelgrafen sd3_medium_example_workflow_multi_prompt.json. Det er sådan, at på vores testmaskine er der, som vi husker, et GeForce GTX 1070 grafikkort med 8 GB videoram, og i denne størrelse kan større modeller med alle integrerede konvertere ikke rumme. Ved checkpoints baseret på SD 1.5 og SDXL er encodere som standard indlejret i hovedfilen, men i dette tilfælde er der ikke to, men tre af disse konvertere, med over 6 GB i alt — sammen med selve modellen bliver det allerede mere end 10 GB; og hvis man tager den 16-bit version af T5XXL encoder, er en endnu mere imponerende grafikkort nødvendig. I det scenarie, hvor konvertererne til tekst til tokens først indlæses i videohukommelsen, og derefter modellen, der arbejder med disse tokens, er det muligt selv med et 6 GB grafikkort at klare sig. Set fra denne vinkel vinder den modulære "tre" uden tvivl over en typisk SDXL-checkpoint på 5-7 GB.
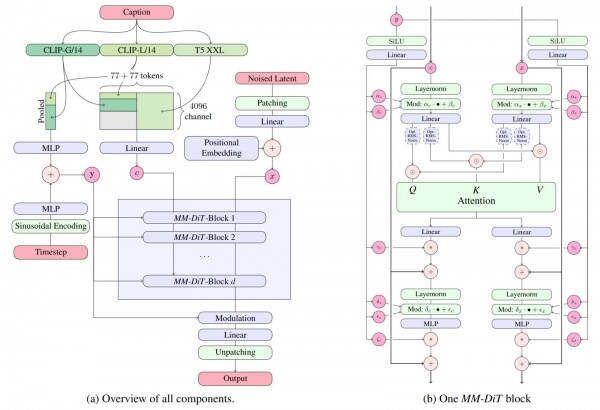
SD3M repræsenterer en model bygget på multimodale diffusions-transformatorer () — og adskiller sig dermed fundamentalt fra tidligere udviklinger fra Stability AI (og ikke kun dem), som er baseret på "Workshoppen" er ikke et sted for en dybdegående undersøgelse af forskellene mellem disse tilgange til AI-generering af billeder; lad os bare sige, at , dens evne til at arbejde med flere tokens (hvilket i sin tur giver operatøren mulighed for at formulere ret omfattende tekstprompter, og systemet — tilstrækkeligt præcist følge dem), samt bedre kvalitet af de resulterende billeder. Den fuldskala SD3 8B er i stand til at generere billeder på en lærred på 4 MP (2048×2048 pixels), og i sådanne kategorier som tekstrepræsentation i billedet, nøjagtigheden af overensstemmelsen mellem det resulterende billede og den tekstlige prompt og den generelle visuelle æstetik. Konverteringen af tekst til token-vektorer udføres her straks af tre encodere ( og én T5-XXL - "T5", for øvrigt fra ) — og for at sige det lige ud, er de ikke forpligtet til at arbejde med den samme prompt.
Men nok med indledninger: Lad os tage fat på det, som "Værkstedet" handler om - generering af billeder baseret på modellen SD3M. Vi bruger, som allerede nævnt, arbejdsområdet ComfyUI, som kan hentes . Det skal understreges, at denne version kun er til brug på NVIDIA-grafikkort eller direkte på AMD- eller Intel-CPU'er (hvilket selvfølgelig vil være meget langsommere): ejere af AMD-grafikkort rocm og pytorch, som kan installeres via pakkehåndtereren pip.
Når installationsarbejdet er afsluttet, skal de tidligere downloadede .safetensors-filer placeres: modellerne i biblioteket ComfyUImodelscheckpoints, tekst-til-token-konverterne i ComfyUImodelsclip. Og så er vi klar til at gå i gang!
Tid til at sped op
Det er værd at nævne, at AUTOMATIC1111, som er godt bekendt for læserne af tidligere "Værksteder" om AI-tegning, ved udgangen af juni også , men i ComfyUI er understøttelsen af den nye model stadig den mest omfattende. Det er ikke overraskende - for indtil for nylig var forfatteren til "nudelmonsteret", kendt i entusiasterfællesskabet under pseudonymet ComfyAnonimous, eller blot Comfy, , hvor han arbejdede blandt andet med det interne arbejdsområde, som udviklerne selv bruger. Som vi vil se senere, vidner den nyeste version af ComfyUI faktisk om, at dens forfatter har visse indsigter i, hvordan denne kontroversielle model fungerer - indsigter, som skaberne af andre arbejdsområder til lokal udførelse af Stable Diffusion 3 Medium af åbenlyse grunde ikke kan prale af.
Det er meget nemt at installere ComfyUI i en portabel version til Windows: efter at have downloadet det relevante ZIP-arkiv Det er tilstrækkeligt at pakke det ud i en hvilken som helst bekvem mappe; det er selvfølgelig bedst at gøre det på en logisk partition baseret på SSD, ikke HDD – udvekslingen mellem lagringsenheden og hukommelsen, under hensyntagen til de kommende indlæsnings- og aflæsningscyklusser for modellerne, selv for at generere et enkelt billede (miljøet skal først placere tekst-til-token omformere i video-RAM’en, derefter rydde videohukommelsen og indlæse selve SD3M) forventes at være betydelig, jo mindre videohukommelse denne computer har til rådighed. For resten er den portable installation også god, da den er helt uafhængig: intet – undtagen den ledige plads på den logiske disk – forhindrer at deployere så mange kopier af ComfyUI lokalt, som man ønsker, for at eksperimentere med forskellige udvidelser uden at frygte at ødelægge et allerede optimeret og godt fungerende system.
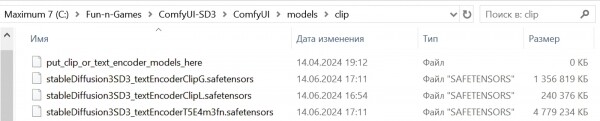
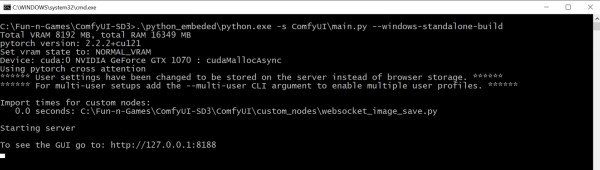
Når man har sikret sig, at SD3M hovedmodel filen uden indbyggede tekst-til-token kodere (filen stableDiffusion3SD3_sd3Medium.safetensors, 4,2 GB) er placeret i undermappen checkpoints (i vores testinstallation er den fulde sti – C:Fun-n-GamesComfyUI-SD3ComfyUImodelscheckpoints), og at alle tre kodermodeller (filene stableDiffusion3SD3_textEncoderClipG.safetensors, stableDiffusion3SD3_textEncoderClipL.safetensors og stableDiffusion3SD3_textEncoderT5E4m3fn.safetensors; 1,3 GB, 234 MB og 4,7 GB henholdsvis) er i undermappen clip (C:Fun-n-GamesComfyUI-SD3ComfyUImodelsclip), kan man starte arbejdsområdet med et dobbeltklik på filen run_nvidia_gpu.bat i roden af mappen (i vores tilfælde C:Fun-n-GamesComfyUI-SD3). Efter serverens opstart vil et nyt faneblad automatisk åbne i standardbrowseren i Windows (det antages af BAT-filens indstillinger) på adressen 127.0.0.1/8188, hvor webgrænsefladen vil være tilgængelig. (kun i første omgang) "pastamonsteret."
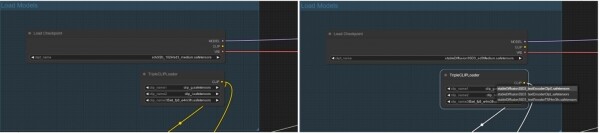
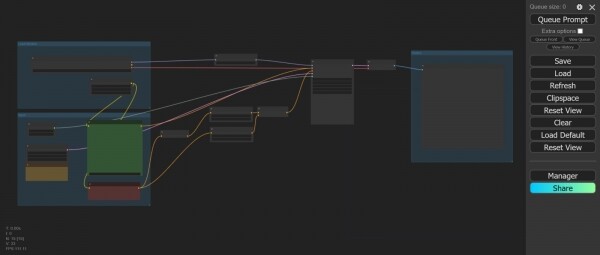
I princippet, hvis du har et nyere NVIDIA grafikkort (RTX generationen, ikke GTX, selv med kun 6 GB videohukommelse), kan du straks indlæse referencearbejdsgangen skabt af ComfyAnonimous, som tidligere nævnt — filen comfy_example_workflows_sd3_medium_example_workflow_multi_prompt.json med flere inputfelter til prompts, et for hver af de tre kodere, — og arbejde med den. Dog skal du først tilpasse navnene på de fire modelfiler (i deres indlæsningsnoder) til de eksisterende. Forfatteren af referencearbejdsgangen har åbenbart arbejdet med lokale filer, der var en smule anderledes navngivet, som han havde til rådighed på sin arbejdsplads (hos Stability AI, som tidligere nævnt), så hvis du trykker på knappen "Queue Prompt" i det spartanske ComfyUI-interface umiddelbart efter indlæsning af arbejdstegningen, vil arbejdsmiljøet returnere en fejltagsmelding.
Trekstrejf for AI-generering
Men det er heldigvis ikke svært at rette: Det er langt mere frustrerende, at vores brugte GTX 1070 behandler SD3M ekstremt langsomt — billedgenereringen tager 27-30 sekunder pr. iteration, og når man overvejer, at "Steps" parameteren i referencearbejdsgangen er sat til "28", går der unødigt meget tid. Derfor vil vi lave en lille optimering — vi vil bruge Python-modulet venv (, "virtuelle miljøer"), som især er designet til at accelerere arbejdet med generative AI-modeller. Det medfølger ikke i den bærbare version af ComfyUI, , som i sidste ende kommer ned til at implementere et fuldt Python-miljø på din lokale computer — og aktivere det nødvendige modul fra dette miljø.
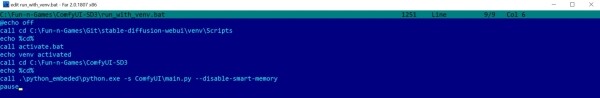
Lad os forudsætte, at de læsere, der følger vores "Værksteder", allerede har en aktiv installation af AUTOMATIC1111 på deres maskiner. I så fald er det meget lettere: modulet venv er allerede implementeret, og alt hvad der kræves for at aktivere det ved opstart af arbejdsmiljøet ComfyUI, er . Først skal du afslutte serverens arbejde ved at skifte til dets vindue og trykke på «Ctrl» + «C», og derefter indtaste «y» for at bekræfte; derefter skal du kopiere BAT-filen run_nvidia_gpu.bat til en ny fil, f.eks. run_with_venv.bat. Den oprindelige startfil er ret kortfattet — den kalder blot en bærbar version af Python med parameteren —windows-standalone-build:
.python_embededpython.exe -s ComfyUImain.py —windows-standalone-build
pause
Denne parameter er i sig selv ikke særlig entydig — den indebærer visse optimeringer, der sandsynligvis er designet til nyere NVIDIA-grafikkort og derfor kan forringe oplevelsen for dem, der stadig hænger ved deres pålidelige GTX. Af denne grund kan vi fjerne —windows-standalone-build fra kommandolinjen og samtidig droppe den moderne optimering — den som standard aktiverede «smarte hukommelsesmanager», smart memory, der , uden at lade den blive frigivet. Dette fremskynder virkelig tegningen af AI-billeder, men det gør samtidig vores moralsk forældede computer til et enopgave-system — det er ikke muligt at surfe på nettet, spille eller endda arbejde med dokumenter og e-mail på PC'en parallelt med aktiviteten i arbejdsmiljøet. Så for dem, der ikke har en dedikeret computer til AI-kunst, ville en sådan BAT-fil til at starte ComfyUI (ikke kun med det formål at generere billeder med SD3M, forresten — den fungerer også fint til SDXL):
@echo off
call cd C:Fun-n-GamesGitstable-diffusion-webuivenvScripts
echo %
call activate.bat
echo venv aktiveret
call cd C:Fun-n-GamesComfyUI-SD3
echo %
call .python_embededpython.exe -s ComfyUImain.py —disable-smart-memory
pause
Her antages det, at den bærbare installation af ComfyUI er gennemført i kataloget C:Fun-n-GamesComfyUI-SD3, og at AUTOMATIC1111 tidligere er installeret i C:Fun-n-GamesGitstable-diffusion-webui. De mange «echo»-kommandoer er kun nødvendige for visuel kontrol af, at skift af mapper fungerer korrekt, og at de nødvendige kommandoer udføres — når alt er debugget, kan de fjernes fra BAT-filen.
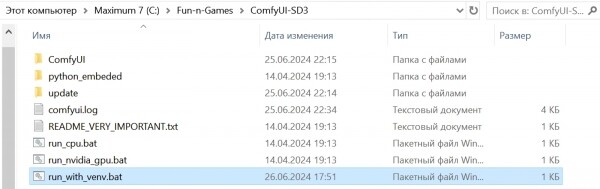
Vi starter arbejdsområdet igen, denne gang ved at klikke to gange på run_with_venv.bat. Da vi tidligere blot lukkede serveren, og vi ikke ændrede webgrænsefladen, bør den relevante fane stadig vise den samme referencecykeldiagram ComfyUI med de justerede modelnavne. Lad os bemærke højre side: der er noden «Preview Image», som ikke gemmer det færdige billede på disken, men blot viser det. Hvis vi hver gang kører cykeldiagrammet for at generere ét specifikt billede, vurderer det visuelt, ændrer noget i indstillingerne, og starter det igen — er det en fungerende mulighed: det ønskede billede kan altid gemmes manuelt ved at højreklikke på det. Men hvis man foretager mange generationer i arbejdsområdet sekventielt, er det bedre, at deres resultater automatisk gemmes i permanent hukommelse (i ComfyUIoutput-mappen som standard).
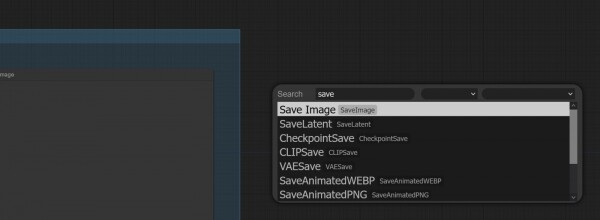
Så det er bedre straks at skifte noden «Preview Image» til «Save Image». For at gøre dette, klikker vi dobbelt med venstre museknap på et frit område af cykeldiagrammet — et vindue til valg af noder åbnes med en søgelinje. I denne søgelinje begynder vi at skrive «Save…» — og næsten straks ser vi det ønskede navn. Derefter er der kun tilbage at klikke på det og tilslutte indgangen af den nye node til udgangen «IMAGE» af noden «VAE Decode», hvor den oprindeligt var tilsluttet «Preview Image». Selve «Preview Image» kan derefter fjernes — blot marker den ved at klikke på overskriften og trykke «Del»-tasten på tastaturet.
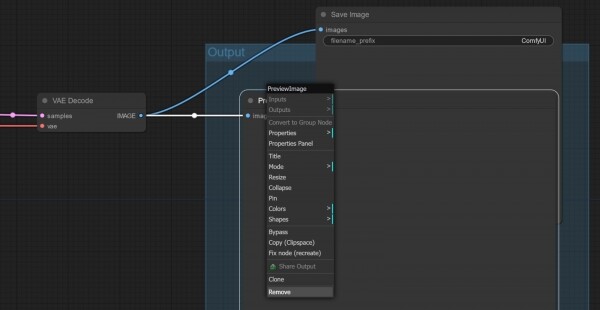
Og nu — er det tid til at køre referencecykeldiagrammet af ComfyAnonimous (med vores beskedne ændringer) til udførelse. Resultatet er som følger:
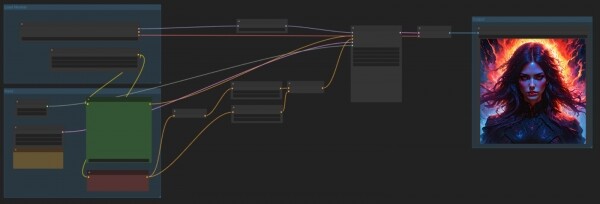
Et ganske imponerende billede, endda med en stemning — og man ville ikke gætte, at det er skabt ved hjælp af den samme model, som fuldstændigt mislykkedes i at tegne folk, der ligger på græsset. Systemet fungerer dog ret hurtigt — omkring 5-6 sekunder pr. iteration for et billede med en størrelse på 1 Mpixel på GTX 1070 betragtes som en anstændig præstation. Til sammenligning: den samme PC i den samme ComfyUI med den samme BAT-fil genererer SDXL-billeder af lignende størrelser, og bruger cirka 6-7 sekunder på hver iteration, så «treeren» kan helt klart betragtes som mindre krævende for hardwaren på den PC, hvor AI-generationen foregår.
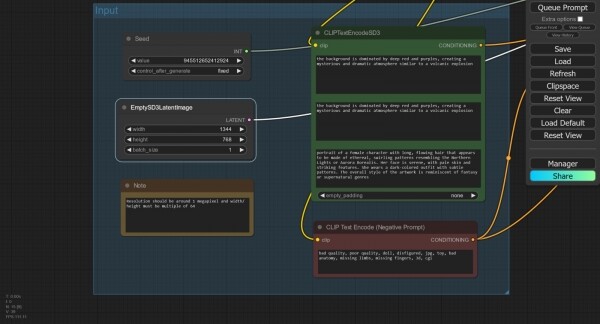
Lad os justere størrelsen på lærredet. Nærliggende noden "EmptySD3LatentImage", som definerer dem, er der en "tom" (det vil sige, ikke forbundet til noget) informationsnode "Note", hvor der står en vigtig påmindelse: det samlede areal af billedet i tilfælde af SD3M skal være cirka 1 MPix, - ud fra hvilket man bør vælge dimensionerne på de rektangulære lærredssider. Vi sætter dem således til 1344×768 - det er cirka 1,03 MPix.
Lad os bemærke: ovenfor er noden "Seed", hvor selve frøet er angivet, i dette tilfælde "945512652412924", og det er specificeret, at det ikke skal ændres efter genereringen (parameteren "fixed").
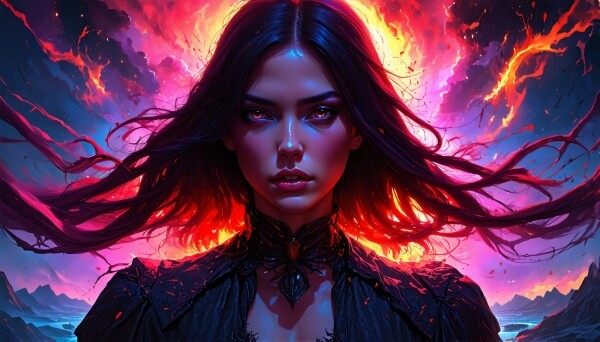
Vi udfører den samme cyklus med det tidligere frø, men nu for det rektangulære lærred. Det bliver straks bemærket, at der samlet set bruges mindre tid på udførelsen, selvom hastigheden for rendering forbliver den samme - under 6 sekunder pr. iteration. Og det giver mening: da de tekstuelle prompts ikke ændrede sig, er der ikke behov for at indlæse koderne til dem på ny. Billedet ved udgangen, som forventet, adskiller sig noget fra det første, kvadratiske, men ikke principielt - den overordnede komposition er, som man kunne forvente, bevaret.
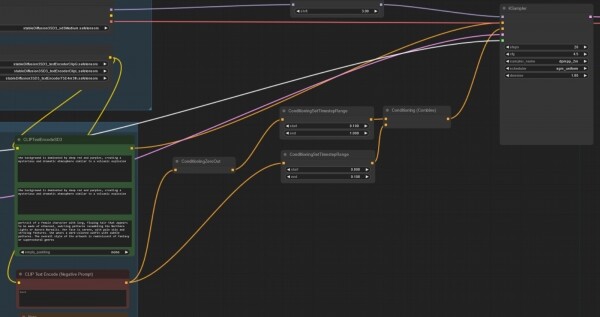
Nu lad os fokusere på noderne "CLIPTextEncodeSD3" og "CLIP Text Encode (Negative Prompt)". Den første skiller sig ud ved, at den indeholder tre inputfelter; hvis man fjerner teksten fra dem, bliver noterne synlige, hvad de er beregnet til for hvilke kodere - fra top til bund er det CLIP G, CLIP L og T5XXL. Tidligere har der ikke været sådanne noder i ComfyUI af åbenlyse grunde. Den grundlæggende cyklus indeholder duplikerede korte prompts for de første to tekstfelter (for konvertererne CLIP G og CLIP L) og en meget mere udførlig for den tredje - T5XXL. Det er klart, at indholdet i disse felter kan varieres i vid udstrækning, og selve studiet af, i hvilken grad ændringen af teksten i dem påvirker det endelige billede, udgør en ikke-trivial, men ekstremt interessant opgave. Men af grunde, der bliver klare lidt senere, vil vi ikke dykke dybt ned i den for nu.
Men i noden «CLIP Text Encode (Negative Prompt)» er der derimod ikke noget særligt — men overvej, hvor kompliceret vejen fra den til den relevante indgang «conditioning» i hovednoden «KSampler» er! Denne vej deler sig, hvoraf en af dens grene (den øverste i dette tilfælde) angiver, at fra 10% af generationstrinnene og til dens afslutning vil systemet overhovedet ikke tage den negative prompt i betragtning (at passere gennem noden «ConditioningZeroOut» betyder netop nulstilling af betingelsen). Den anden gren sender dog den negative prompt (også betinget med halveret vægt) videre til behandlingen uden ændringer — men kun i de første 10% af det samlede antal generationstrin.
Tåget fjern
Endnu en gang: I de første 10%, dvs. 3 af de 28 tildelte i dette tilfælde, bliver den negative prompt sendt til noden «KSampler», som er optaget af at danne billedet i det latente rum (i pixelrummet, dvs. det synlige billede, som resultatet oversættes af den næste node, «VAE Decoder»), på normal måde: den øverste gren (med nulstilling af betingelsen) er inaktiv, kun den nederste arbejder. De resterende 90% af trinene (25 ud af 28 i vores tilfælde) fungerer den negative prompt slet ikke: den øverste gren for transmission af betingelser er aktiv — med nulstillingen — mens bevægelsen langs den nederste er blokeret af en grænseparameter, der aktiverer den tilsvarende node «ConditioningSetTimestepRange». Nu er det tydeligt, hvorfor en række anmeldere hævder, at , — effekten af dem (hvis man ser på netop dette, basale, cyklusdiagram og antager, at de samme regler gælder for websteder med online generation ved hjælp af modellen SD3 Medium) er minimal.
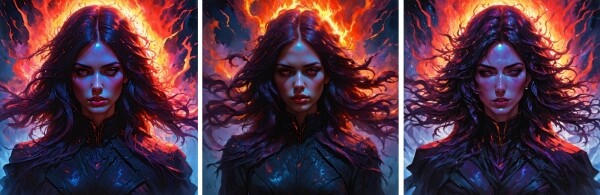
Og dog findes det: hvis man bare tager og forbinder udgangen af noden «CLIP Text Encode (Negative Prompt)» direkte med den tilsvarende indgang «KSampler» (eller markerer alle mellemnoder med betingelser på denne vej som «bypass», hvilket vil føre til samme effekt), vil kvaliteten af det endelige billede blive mærkbart forringet. Dette kan i øvrigt betragtes som indirekte bevis på «ufærdiggørelsen» af SD3M, da det egentlig burde have været muligt for udviklerne at justere styrken og betydningen af den negative prompt, før modellen blev offentliggjort. De to grene af de listigt stillede betingelser for anvendelse af den negative prompt er en slags lap, og i denne forstand de forventninger, som Stability AIs marketingafdeling har tændt for, helt berettigede.
Manglen på selv en kort officiel vejledning til at arbejde med SD3M har medført, at der allerede er rygter på nettet om, at denne model Det er selvfølgelig ikke tilfældet, men i hvert fald skal disse prompts anvendes helt anderledes end Specifikt hævder entusiaster på fuld seriøsitet, at tilføjelsen af så detaljerede beskrivelser af så mange uhæmmede ting som muligt i det negative felt (ja, ja, den gode gamle «nsfw, nude» er ikke nok - man må virkelig strække fantasien) selv af den berygtede pige, der ligger på græsset. Om det er sandt eller ej - kan ikke bevises uden grundig kontrol (og det er ikke sikkert, at selv mærkningen «18+» i toppen af vores hjemmeside vil beskytte publikationerne mod søgsmål fra rasende værger, hvis vi tør offentliggøre den af entusiaster sammensatte «vidunder-prompt» - til trods for at den er på engelsk). Denne sjove situation minder om en episode med , som netop fordi de indeholdt ret detaljerede beskrivelser af, hvad og hvordan man ikke skulle gøre som anstændige kristne, er nået frem til os i det mindste som fragmenterede skriftlige vidnesbyrd om tro og skikke i den førkristne Rus.
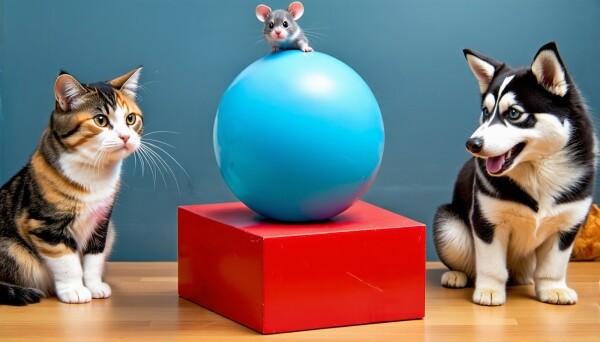
Nu håber jeg, det er blevet klarere, hvorfor det ikke virker som en fornuftig brug af tid og energi at dykke dybere ind i studiet af SD3M på dette stadium. Der er virkelig meget at diskutere og undersøge: både de relativt strenge anbefalinger for generation parametre i noden 'KSampler' (CFG - 4,5-5,0; antal trin - omkring 28; par sampler/scheduler - udelukkende dpmpp_2m/sgm_uniform, ellers falder kvaliteten mærkbart); og den ekstremt betydelige variation i den subjektive kvalitet af generationer ved præcist de samme startparametre, men med forskellige stikord; og at slippe af med den berygtede 'forbandelse af at ligge i/på græsset' (for hvilken allerede ); og, i virkeligheden, at finde ud af, hvilke specifikke generering parametre hver af de tre tekst-til-token omformere påvirker — og hvordan, ved at operere med dem, man kan opnå ægte mesterværker af AI-kunst (hvis det i princippet er muligt med 'treeren', selvfølgelig).
Især da opsigelsen af Emad Mostaq i marts og ComfyAnonimous i juni, , - ikke de eneste problemer, der har ramt Stability AI. Som Reuters rapporterer med henvisning til The Information, har denne britiske start-up lige netop (på tidspunktet for skrivningen af denne artikel) atter engang , som nu er blevet Prem Akkaraju, en kandidat fra den velkendte globale gruppe af IT-investorer - og de er, på deres side, klar til at investere en betydelig sum penge (). Stabiliteten af Stability AI som forretningsstruktur er i dag åbenlyst ustabil; mange skuffede — og i en sådan situation er det svært at forvente nogen gennemtænkt arbejde fra virksomheden, selv på så åbenlyse fejl.
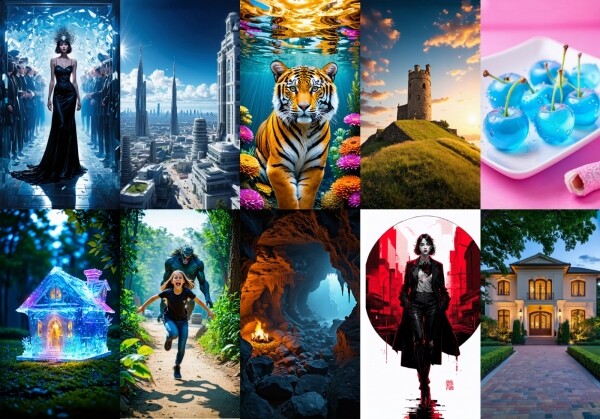
Den uigennemtænkte licenspolitik holder desværre fællesskabet tilbage fra at færdiggøre SD3M på egen hånd, ligesom det skete med SD 1.5 og SDXL. I det mindste vil afledte checkpoints og værktøjer som LoRA til de sidste to modeller med sikkerhed forblive tilgængelige til lokal udførelse, selv når (og hvis) Stability AI afslutter sin rejse som en kommerciel struktur. Straks efter det larmende fiasko for 'trekløveret' på faglige fora begyndte der at opstå flere stemmer til støtte for oprettelsen af et non-profit projekt til udvikling af en generativ model til at omdanne tekst til billeder baseret på crowdfunding, og på nuværende tidspunkt begynder denne bevægelse at tage form under navnet . Der er allerede erklæret vilje til aktivt at slutte sig til det fra Invoke (en af platformene for online AI-generering rettet mod professionelle studier), Comfy Org (holdet, der arbejder med støtte og udvikling af ComfyUI), Civitai (som ikke har brug for præsentation) samt holdet bag LAION (databasen med annoterede billeder, som for det meste bruges til at træne sådanne modeller).
Så i den overskuelige fremtid vil nye udgivelser af 'Værkstedet' sandsynligvis fokusere på at arbejde med de modeller, for hvilke fællesskabet allerede har skabt et bredt udvalg af forbedringer og yderligere værktøjer — på 'halvanden' og 'Oversize'. Måske er tiden til sejr for SD3M endnu ikke kommet — men i dag er det svært selv at forestille sig, hvornår det præcist vil ske. Indtil da kan interesserede downloade arkivet med de generationer af SD3M, der er nævnt i denne artikel (cyklogrammerne er integreret direkte i PNG-filerne; det er nok at trække billedet over på arbejdsfladen af ComfyUI fra 'Stifinder' i Windows for at genskabe hele rækkefølgen og parametrene for generationen) . Måske kan en af vores læsere finde den optimale måde at fordele teksten på de tre felt for prompts før de rutinerede Reddit- og Hugging Face-brugere?
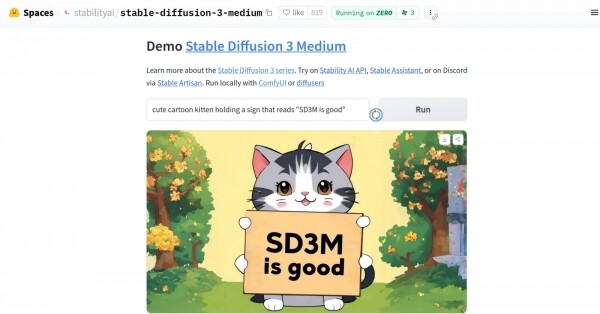
Materialer om emnet:
.
.
.
.
.
Kilde: 3dnews.ru
