

Firmaen NVIDIA har offentliggjort kildekoden til StyleGAN3, et maskinlæringssystem baseret på en generativ modstander-netværk (GAN), der har til formål at syntetisere realistiske billeder af menneskers ansigt. Koden er skrevet i Python ved hjælp af PyTorch-rammeværket og distribueres under NVIDIA Source Code License, som påbyder begrænsninger for kommerciel brug.
Der er også færdigtrænede modeller tilgængelige for download, der er trænet på Flickr-Faces-HQ (FFHQ) samlingen, som omfatter 70.000 højopløselige (1024×1024) PNG-billeder af menneskers ansigt. Derudover findes der modeller, der er bygget på samlingerne AFHQv2 (billeder af dyrehoved) og Metfaces (billeder af menneskers ansigt fra klassisk maleri). Under udviklingen er fokus på ansigt, men systemet kan trænes til at generere enhver art objekter, såsom landskaber og biler. Der tilbydes også værktøjer til selvstændig træning af neurale netværk med egne billedsamlinger. For at køre systemet kræves en eller flere NVIDIA-grafikkort (anbefales GPU Tesla V100 eller A100), mindst 12 GB RAM, PyTorch 1.9 og CUDA 11.1+ værktøjer. En særlig detektor udvikles for at bestemme den kunstige karakter af de genererede ansigt.
Systemet gør det muligt at syntetisere et billede af et nyt ansigt baseret på interpolation af egenskaber fra flere ansigtter, der kombinerer deres karakteristika og tilpasser det endelige billede til den ønskede alder, køn, hårlængde, smillets karakter, næseform, hudfarve, briller, og kameravinkel. Generatoren betragter billedet som en samling af stilarter, adskiller automatisk karakteristiske detaljer (som fregner, hår, briller) fra de generelle højere niveauattributter (som kropsholdning, køn, aldersforandringer) og muliggør en vilkårlig kombination, mens dominerende egenskaber defineres gennem vægtfaktorer. Resultatet er billeder, der ser ud til at være identiske med rigtige fotografier.
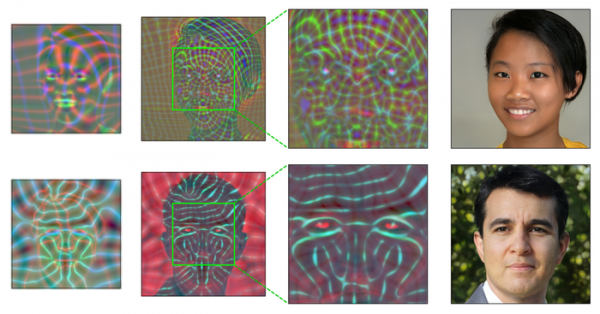
Den første version af teknologien StyleGAN blev offentliggjort i 2019, hvorefter en forbedret version, StyleGAN2, blev foreslået i 2020. Denne version forbedrer billedkvaliteten og eliminerer nogle artefakter. Systemet forblev dog statisk, det vil sige, at det ikke kunne opnå realistisk animation og ansigtbevægelser. Målet med udviklingen af StyleGAN3 var at tilpasse teknologien til brug i animation og video.
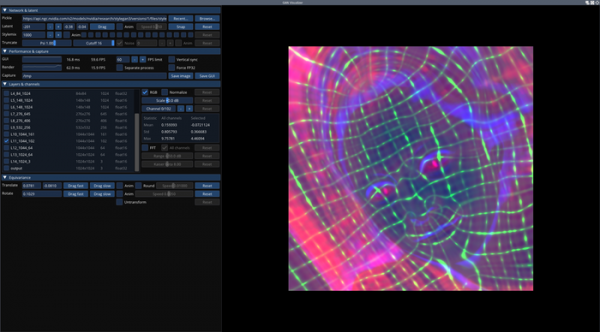
StyleGAN3 anvender en redesignet arkitektur til generering af billeder, fri for aliasing, og der er foreslået nye træningsscenarier for neurale netværk. Der er inkluderet nye værktøjer til interaktiv visualisering (visualizer.py), analyse (avg_spectra.py) og videogenerering (gen_video.py). Implementeringen har også reduceret hukommelsesforbruget og fremskyndet træningsprocessen.
En central funktion ved arkitekturen i StyleGAN3 er overgangen til at fortolke alle signaler i det neurale netværk som kontinuert proces. Dette muliggør manipulation af relativ positionering under dannelsen af detaljer, der ikke er bundet til absolutte koordinater for enkelte pixels på billedet, men er knyttet til overfladen af de afbildede objekter. I StyleGAN og StyleGAN2 førte bindingen til pixels under genereringen til problemer ved dynamisk visualisering, for eksempel observeredes diskrepans i små detaljer som rynker og hår, der bevægede sig som om de var adskilt fra resten af ansigtet. I StyleGAN3 er disse problemer løst, og teknologien er nu velegnet til videodannelse.
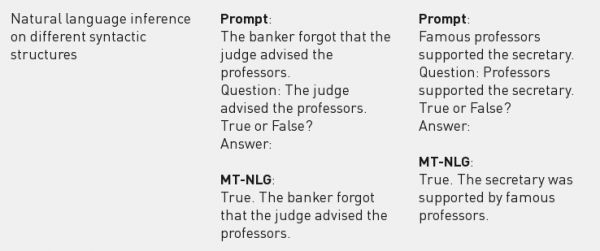
Derudover kan man nævne annonceringen af skabelsen af den største sprogmodel MT-NLG af virksomhederne NVIDIA og Microsoft baseret på en dyb neuralt netværk med transformer-arkitektur. Modellen omfatter 530 milliarder parametre, og der blev brugt et cluster bestående af 4480 GPU'er (560 DGX A100 med 8 GPU A100 80GB hver). servere Anvendelsesområderne for modellen inkluderer løsning af opgaver relateret til behandling af information på naturligt sprog, såsom forudsigelse af afslutningen på uafsluttede sætninger, besvarelse af spørgsmål, forståelse af læst materiale, dannelse af konklusioner på naturligt sprog og afklaring af tvetydighed i ords betydning.
Kilde: opennet.ru
