

Et detaljeret vejledning til optimering af Linux-miljøet for at opnå maksimal ydeevne ved behandling af HTTP-anmodninger er offentliggjort. De foreslåede metoder har øget ydeevnen for JSON-behandleren baseret på libreactor i Amazon EC2-miljøet (4 vCPU) fra 224.000 API-anmodninger per sekund med standardindstillingerne for Amazon Linux 2 med kerne 4.14 til 1,2 millioner anmodninger per sekund efter optimeringen (en stigning på 436%), og har samtidig reduceret forsinkelserne ved behandlingen af anmodninger med 79%. De foreslåede metoder er ikke specifikke for libreactor og fungerer med andre http-servere, herunder nginx, Actix, Netty og Node.js (libreactor blev brugt i testene, da løsningen baseret på det viste den bedste ydeevne).
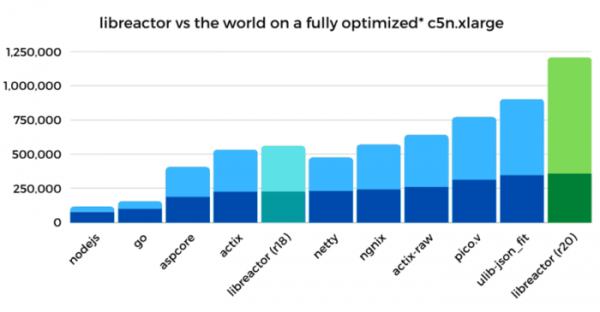
Hovedoptimeringer:
- Optimering af libreactor-koden. En variant R18 fra Techempower-sættet blev anvendt som grundlag, der blev forbedret ved at fjerne koden for at begrænse antallet af anvendte CPU-kerner (optimeringen kunne accelerere processen med 25-27%), kompilering i GCC med indstillingerne “-O3” (stigning på 5-10%) og “-march-native” (5-10%), udskiftning af read/write- kald med recv/send (5-10%) og reduktion af overhead ved brug af pthreads (2-3%). Den samlede performanceforøgelse efter kodeoptimeringen var 55%, og gennemløbet steg fra 224.000 req/s til 347.000 req/s.
- Deaktivering af beskyttelse mod sårbarheder forårsaget af spekulativ udførelse af instruktioner. Anvendelse af parametre ved indlæsning af kernen “nospectre_v1 nospectre_v2 pti=off mds=off tsx_async_abort=off” kunne øge ydeevnen med 28%, og gennemløbet steg fra 347.000 req/s til 446.000 req/s. For parameteren “nospectre_v1” (beskyttelse mod Spectre v1 + SWAPGS) var stigningen 1-2%, “nospectre_v2” (beskyttelse mod Spectre v2) — 15-20%, “pti=off” (Spectre v3/Meltdown) — 6%, “mds=off tsx_async_abort=off” (MDS/Zombieload og TSX Asynchronous Abort) — 6%. Indstillingerne til beskyttelse mod L1TF/Foreshadow-angreb (l1tf=flush), iTLB multi-hit, Speculative Store Bypass og SRBDS forblev uændrede, da de ikke påvirkede ydeevnen, da de ikke overlappede med den testede konfiguration (f.eks. specifik til KVM, indlejret virtualisering og andre CPU-modeller).
- Deaktivering af mekanismer til audit og låsning af systemopkald ved hjælp af kommandoen “auditctl -a never,task” og angivelse af indstillingen “—security-opt seccomp=unconfined” ved opstart af docker-containeren. Den samlede performanceforøgelse var 11%, og gennemløbet steg fra 446.000 req/s til 495.000 req/s.
- Deaktivering af iptables/netfilter ved at indlæse de relaterede kernelmoduler. Ideen om at deaktivere firewall'en, som ikke blev brugt i den specifikke serverløsning, blev fremmet af profileringsresultaterne, der viste, at funktionen nf_hook_slow brugte 18% af tiden. Det bemærkes, at nftables fungerer mere effektivt end iptables, men iptables bruges stadig i Amazon Linux. Efter deaktivering af iptables var der en præstationsforøgelse på 22%, og båndbredden steg fra 495k req/s til 603k req/s.
- Reduktion af migrationen af håndteringsrutiner mellem forskellige CPU-kerner for at øge effektiviteten af CPU-cachen. Optimeringen blev udført både på niveauet for binding af processer (libreactor) til CPU-kerner (CPU Pinning) og ved at fastsætte netværkshåndtere fra kernen (Receive Side Scaling). For eksempel blev irqbalance deaktiveret og bindinger til køer blev eksplicit fastsat i /proc/irq/$IRQ/smp_affinity_list. For at bruge den samme CPU-kerne til behandling af libreactor-processen og netværkskøen for indkommende pakker blev en brugerdefineret BPF-håndterer anvendt, tilsluttet ved at sætte flaget SO_ATTACH_REUSEPORT_CBPF, når der blev oprettet en socket. For at binde køerne for udgående pakker til CPU'en blev indstillingerne i /sys/class/net/eth0/queues/tx-<n>/xps_cpus ændret. Den samlede præstationsforøgelse var på 38%, og båndbredden steg fra 603k req/s til 834k req/s.
- Optimering af håndtering af interrupts og brug af polling. Aktivering af adaptive-rx tilstanden i ENA-driveren og manipulation med sysctl net.core.busy_read gjorde det muligt at hæve præstationen med 28% (båndbredden steg fra 834k req/s til 1.06M req/s, og latenserne faldt fra 361μs til 292μs).
- Deaktivering af systemtjenester, der fører til unødvendige blokeringer i netværksstakken. Deaktivering af dhclient og manual opsætning IP-adresser førte til en præstationsforøgelse på 6%, og båndbredden steg fra 1.06M req/s til 1.12M req/s. Årsagen til dhclients indvirkning på præstationen blev analyseret ved hjælp af raw-socket trafik.
- Bekæmpelse af Spin Lock. Overgang af netværksstakken til 'noqueue'-tilstand via sysctl 'net.core.default_qdisc=noqueue' og 'tc qdisc replace dev eth0 root mq' resulterede i en præstationsforøgelse på 2%, og båndbredden steg fra 1.12M req/s til 1.15M req/s.
- Endelige små optimeringer, såsom deaktivering af GRO (Generic Receive Offload) med kommandoen „ethtool -K eth0 gro off“ og ændring af algoritmen for overbelastningskontrol fra cubic til reno via sysctl „net.ipv4.tcp_congestion_control=reno“. Den samlede præstationsforbedring var 4%. Gennemløbsraten steg fra 1,15M req/s til 1,2M req/s.
Udover de gennemførte optimeringer diskuteres der i artiklen også metoder, der ikke førte til den forventede præstationsvækst. For eksempel var følgende ineffektive:
- Separat kørsel af libreactor viste sig ikke at være bedre i præstation end kørsel i containeren. Udskiftning af writev med send, øgning af maxevents i epoll_wait, eksperimenter med versioner og flag fra GCC havde ingen effekt (effekten var kun synlig for flagene „-O3“ og „-march-native“).
- Opdatering af Linux-kernen til versioner 4.19 og 5.4, brug af planlæggere SCHED_FIFO og SCHED_RR, samt manipulationer med sysctl kernel.sched_min_granularity_ns, kernel.sched_wakeup_granularity_ns, transparent_hugepages=never, skew_tick=1 og clocksource=tsc påvirkede ikke præstationen.
- I ENA-driveren havde aktivering af Offload-tilstande (segmentation, scatter-gather, rx/tx checksum), kompilering med flaget „-O3“ og anvendelse af parametre som ena.rx_queue_size og ena.force_large_llq_header ingen indflydelse.
- Ændringer i netværksstakken førte ikke til en præstationsforøgelse:
- Deaktivering af IPv6: ipv6.disable=1
- Deaktivering af VLAN: modprobe -rv 8021q
- Deaktivering af kildepakkeverifikationen
- net.ipv4.conf.all.rp_filter=0
- net.ipv4.conf.eth0.rp_filter=0
- net.ipv4.conf.all.accept_local=1 (negativ effekt)
- net.ipv4.tcp_sack=0
- net.ipv4.tcp_dsack=0
- net.ipv4.tcp_mem/tcp_wmem/tcp_rmem
- net.core.netdev_budget
- net.core.dev_weight
- net.core.netdev_max_backlog
- net.ipv4.tcp_slow_start_after_idle=0
- net.ipv4.tcp_moderate_rcvbuf=0
- net.ipv4.tcp_timestamps=0
- net.ipv4.tcp_low_latency=1
- SO_PRIORITY
- TCP_NODELAY
Kilde: opennet.ru
