

I et af chattene blev jeg spurgt:
— Er der noget at læse om, hvordan man korrekt pakker servere i skabe?
Jeg indså, at jeg ikke kender sådan en tekst, så jeg skrev min egen.
For det første handler denne tekst om fysiske servere i fysiske datacentre (DC). For det andet antager vi, at der er mange servere: hundredvis til tusindvis; for et mindre antal giver denne tekst ikke mening. For det tredje antager vi, at vi har tre begrænsninger: fysisk plads i skabene, elektrisk strøm pr. skab, og lad os sige, at skabene står i rækker, så vi kan bruge en ToR switch til at forbinde servere i naboskaber.
Svaret på spørgsmålet afhænger meget af, hvilken parameter vi optimerer, og hvad vi kan variere for at opnå det bedste resultat. For eksempel, at vi kun skal optage minimum plads for at efterlade mere til fremtidig vækst. Eller vi har måske frihed til at vælge højden på skabene, strømmen pr. skab, stikkontakter i PDU'en, antal skab i switchgrupper (én switch til 1, 2 eller 3 skab), ledningernes længde og arbejdet med kabeltræk (dette er kritisk i enderne af rækkerne: ved 10 skab i rækken og 3 skab til switchen skal man trække kabler til en anden række eller underudnytte porte i switchen), osv., osv. Separate historier: valg af servere og valg af DC, vi antager, at de allerede er valgt.
Det ville være godt at forstå nogle nuancer og detaljer, især det gennemsnitlige/maksimale strømforbrug for serverne og hvordan strømmen forsynes til os. Så hvis vi har russisk strømforsyning på 230V og én fase pr. skab, kan en 32A automatik holde ~7kW. Lad os antage, at vi nominelt betaler for 6kW pr. skab. Hvis udbyderen måler vores forbrug kun for rækken af 10 skab og ikke for hvert enkelt skab, og hvis automatikken er sat til ca. 7kW, kan vi teknisk set i ét enkelt skab trække 6.9kW, i et andet 5.1kW, og alt vil være ok — uden straf.
Normalt er vores primære mål at minimere omkostningerne. Det bedste mål for måling er at reducere TCO (total cost of ownership — de samlede ejeromkostninger). Den består af følgende dele:
- CAPEX: indkøb af datacenterinfrastruktur, servere, netværksudstyr og kabling
- OPEX: leje af datacentre, forbrugt elektricitet, vedligeholdelse. OPEX afhænger af levetiden. Det er rimeligt at antage, at det er lig med 3 år.
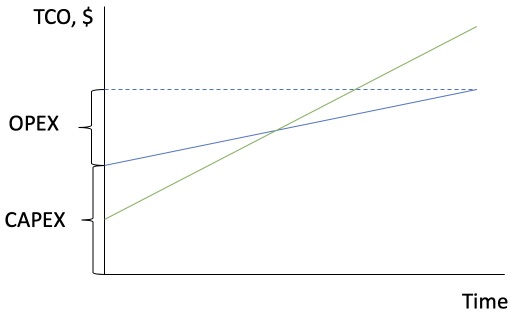
Afhængigt af hvor store de enkelte stykker er i den samlede kage, skal vi optimere det dyreste, mens resten kan bruge alle de resterende ressourcer så effektivt som muligt.
Lad os sige, at vi allerede har et eksisterende datacenter, der er højden på rack'en H enheder (for eksempel H=47), strømmen pr. rack Prack (Prack=6kW), og vi har besluttet at bruge h=2U to-enheds servere. Vi fjerner 2..4 enheder fra rack'en til switche, patchpaneler og organisatorer. Det vil sige fysisk, at der i rack'en kan være Sh=rounddown((H-2..4)/h) servere (dvs. Sh = rounddown((47-4)/2)=21 servere pr. rack). Lad os huske dette Sh.
I et simpelt tilfælde er alle servere i rack'en ens. Så hvis vi fylder rack'en servere, kan vi i gennemsnit bruge strøm Pserv=Prack/Sh (Pserv = 6000W/21 = 287W) pr. server. For enkelhedens skyld ignorerer vi strømforbruget fra switchen.
Lad os tage et skridt tilbage og definere, hvad den maksimale forbrugskraft for serveren Pmax er. Hvis det skal være meget simpelt, meget ineffektivt og helt sikkert, så læser vi, hvad der står på serverens strømforsyning - det er det.
Hvis vi går mere i dybden og er mere effektive, så tager vi TDP (thermal design package) for alle komponenterne og summerer dem (det er ikke helt rigtigt, men det kan lade sig gøre).
Normalt kender vi ikke TDP for komponenterne (undtagen CPU’en), så vi tager den mest korrekte, men også den mest komplicerede tilgang (det kræver et laboratorium) - vi tager en eksperimentel server med den ønskede konfiguration og belaster den, for eksempel med Linpack (CPU og hukommelse) og fio (diskene), for at måle forbruget. Hvis vi skal tage det seriøst, skal vi også skabe de mest varme forhold i den kolde korridor under testene, fordi det påvirker både ventilatorernes forbrug og CPU’ens forbrug. Vi får det maksimale forbrug for den specifikke server med den specifikke konfiguration under disse specifikke betingelser med denne specifikke belastning. Bare husk, at en ny firmware, en anden softwareversion eller andre betingelser kan påvirke resultatet.
Så i alt vender vi tilbage til Pserv og hvordan vi kan sammenligne det med Pmax. Det er et spørgsmål om forståelse af, hvordan tjenesterne fungerer, og hvor stærke nerverne hos din tekniske leder er.
Hvis vi slet ikke vil tage chancer, så antager vi, at alle servere kan begynde at forbruge deres maksimale samtidig. På dette tidspunkt kan en enkelt strømtilslutning i datacentret dannes. Infrastruktur skal levere service under disse forhold, derfor Pserv ≡ Pmax. Dette er en tilgang hvor pålidelighed er absolut vigtig.
Hvis IT-chefen ikke kun tænker på ideel sikkerhed, men også på virksomhedens økonomi og er tilstrækkeligt modig, kan det konkluderes, at
- vi begynder at styre vores leverandører, især ved at forbyde planlagt vedligeholdelse i perioder med forventet peakbelastning for at minimere nedbrud på én indgang;
- og/eller vores arkitektur tillader at miste en rack/kolonne/datacenter, mens tjenesterne fortsætter med at fungere;
- og/eller vi jævnt fordeler belastningen horisontalt over rackene, så vores tjenester aldrig springer op til maksimal forbrug i ét rack samtidig.
Her er det meget nyttigt ikke bare at gætte, men at overvåge forbruget og vide, hvordan serverne reelt bruger elektricitet under normale og peak-forhold. Derfor, efter en vis analyse, komprimerer IT-chefen alt, hvad han har, og siger: «vi træffer en beslutning om, at den maksimalt opnåelige gennemsnitlige forbrug pr. rack skal være **så meget** under det maksimale forbrug», hypotetisk Pserv=0.8*Pmax.
Og så kan der nu være 20 servere med Pserv = 375W * 0,8 = 300W i et rack på 6kW i stedet for de tidligere 16 servere med Pmax = 375W. Altså 25% flere servere. Dette er en stor besparelse — for vi får også brug for 25% færre racks (og vi sparer også penge på PDU, switches og kabler). En alvorlig ulempe ved denne beslutning er, at vi konstant skal overvåge, om vores forudsætninger stadig er gyldige. At den nye firmwareversion ikke væsentligt ændrer ventilatorernes drift og forbrug, og at udviklingen ikke pludselig begynder at bruge serverne langt mere effektivt med en ny version (dvs. opnår større belastning og højere forbrug per server). For så bliver både vores oprindelige forudsætninger og konklusioner straks forkerte. Det er en risiko, som vi skal tage ansvarligt (eller undgå, og så betale for tydeligt underbelastede racks).
Et vigtigt bemærkning — det er værd at forsøge at fordele serverne fra forskellige tjenester horisontalt over rackene, hvis det er muligt. Dette er for at undgå situationer, hvor en part af servere til en bestemt tjeneste ankommer, og rackene fyldes vertikalt med dem for at øge "tætheden" (fordi det er lettere). I virkeligheden medfører det, at et rack er fyldt med ensartede lavbelastede servere fra samme tjeneste, mens et andet er fyldt med ensartede højbelastede servere. Sandsynligheden for, at det andet rack fejler, er betydeligt højere, da belastningsprofilen er den samme, og alle servere i dette rack begynder at forbruge ensartet meget som et resultat af den øgede belastning.
Lad os vende tilbage til fordelingen af servere i rackene. Vi har overvejet fysiske begrænsninger af plads i rackene og begrænsninger i strømforsyningen, nu vil vi også se på netværket. Man kan bruge switche med 24/32/48 porte N (for eksempel har vi 48-portede ToR switche). Heldigvis er der ikke så mange muligheder, hvis man ikke tænker på break-out kabler. Vi overvejer scenarier, hvor vi har én switch pr. rack, én switch til to eller tre racks i en Rnet-gruppe. Jeg mener, at mere end tre racks i en gruppe er for meget, da kableringsproblemet mellem racks bliver meget større.
Så for hvert netværksscenarie (1, 2 eller 3 racks i gruppen) fordeler vi serverne over racks:
Srack = min(Sh, rounddown(Prack/Pserv), rounddown(N/Rnet))
Således, for varianten med 2 racks i gruppen:
Srack2 = min(21, rounddown(6000/300), rounddown(48/2)) = min(21, 20, 24) = 20 servere pr. rack.
Vi beregner lignende for de andre muligheder:
Srack1 = 20
Srack3 = 16
Og vi er næsten ved målet. Vi beregner antallet af racks til fordeling af alle vores servere S (lad os sige 1000):
R = roundup(S / (Srack * Rnet)) * Rnet
R1 = roundup(1000 / (20 * 1)) * 1 = 50 * 1 = 50 racks
R2 = roundup(1000 / (20 * 2)) * 2 = 25 * 2 = 50 racks
R3 = roundup(1000 / (16 * 3)) * 3 = 25 * 2 = 63 racks
Derefter beregner vi TCO for hver variant baseret på antallet af racks, det nødvendige antal switche, kablering osv. Vi vælger den mulighed, hvor TCO er mindre. Profit!
Vi bemærker, at selv om det nødvendige antal racks for mulighederne 1 og 2 er det samme, vil deres pris være forskellig, da antallet af switche for den anden mulighed er halveret, mens længden af de nødvendige kabler er større.
P.S. Hvis det er muligt at lege med effekten på serveren og tårnhøjden, øges variationen. Men processen kan reduceres til det ovenfor beskrevne, blot ved at gennemgå mulighederne. Ja, der vil være flere kombinationer, men det er stadig et ret begrænset antal — strømmen til serveren kan beregnes i trin af 1 kW, standard serverrum findes i et begrænset antal størrelser: 42U, 45U, 47U, 48U, 52U. Her kan en Excel What-If-analyse i Data Table-tilstand være til hjælp. Vi ser på de opnåede tabeller og vælger det minimum.
Kilde: habr.com
