

En gruppe forskere fra Shanghai Tekniske Universitet værktøjer , der ved hjælp af machine learning metoder simulerer menneskers bevægelser baseret på statiske billeder, samt kan ændre tøj, flytte til en anden kontekst og ændre vinklen, hvorfra objektet ses. Koden er skrevet i Python
ved brug af rammeværket . Der kræves også og CUDA Toolkit.
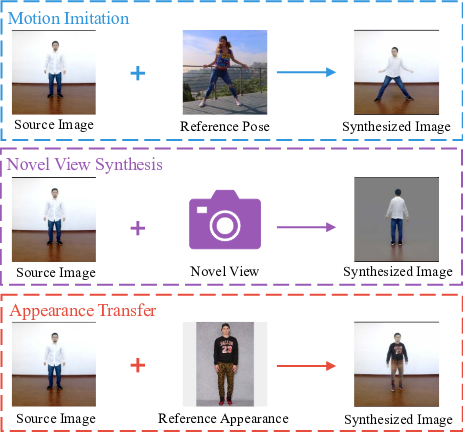
Værktøjet modtager et to-dimensionelt billede som input og syntetiserer et ændret resultat baseret på den valgte model. Der understøttes tre typer transformationer:
Oprettelse af et bevægeligt objekt, der gentager bevægelserne, som modellen er trænet på. Overførsel af elementer fra modellens udseende til objektet (f.eks. skift af tøj). Generering af en ny vinkel (f.eks. syntese af et profilbillede baseret på et ansigt til ansigt billede). Alle tre metoder kan kombineres; for eksempel kan man generere en video ud fra et billede, der imiterer udførelsen af et komplekst akrobatiske trick i andet tøj.
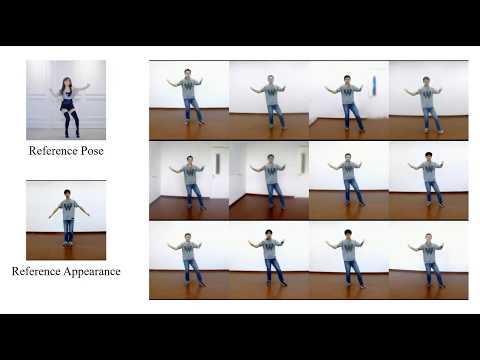
Under syntesens proces udføres operationer som objektsegmentering på billedet og dannelse af de manglende elementer i baggrunden ved flytning. Modellen til neurale netværk kan trænes én gang og anvendes til forskellige transformationer. For at hente færdige modeller, der gør det muligt at bruge værktøjet uden forudgående træning. Der kræves en GPU med mindst 8GB RAM.
I modsætning til transformationsmetoder baseret på transformation ved hjælp af nøglepunkter, der beskriver kroppens placering i to-dimensionelt rum, gør Impersonator et forsøg på at syntetisere et tredimensionalt net (mesh) med en kropsbeskrivelse ved brug af machine learning metoder.
Den foreslåede metode muliggør manipulation med hensyntagen til den personaliserede kropsform og den nuværende position, hvilket simulerer naturlige bevægelser af lemmerne.
For at bevare den oprindelige information, såsom teksturer, stil, farver og genkendeligheden af ansigtet, anvendes der (). Oplysninger om det oprindelige objekt og parametre for dets nøjagtige identifikation udtrækkes ved at anvende .

Kilde: opennet.ru
