

De største virksomheder inden for udvikling af maskinlæring har præsenteret projektet OpenXLA, der har til formål at fremme udviklingen af værktøjer til kompilering og optimering af modeller til maskinlæringssystemer. Projektet inkluderer værktøjer, der gør det muligt at standardisere kompileringen af modeller, der er udviklet i rammerne TensorFlow, PyTorch og JAX, for effektiv træning og udførelse på forskellige GPU'er og specialiserede accelerators. Virksomheder som Google, NVIDIA, AMD, Intel, Meta, Apple, Arm, Alibaba og Amazon har tilsluttet sig projektet.
Det forventes, at samarbejdet mellem førende forskerhold og medlemmer af samfundet vil stimulere udviklingen af maskinlæringssystemer og løse problemet med fragmentering af infrastrukturen for forskellige rammer og hardware. OpenXLA muliggør effektiv support af forskelligt udstyr, uanset hvilken ramme maskinlæringsmodellen er bygget på. Det forventes, at OpenXLA vil reducere træningstiden for modeller, forbedre båndbredde, reducere forsinkelser, sænke omkostningerne til computerressourcer og forkorte tiden til markedet.
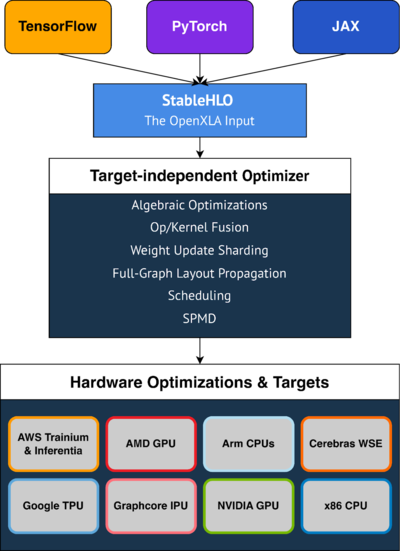
OpenXLA består af tre hovedkomponenter, hvis kode distribueres under Apache 2.0-licensen:
- XLA (Accelerated Linear Algebra) – en kompilator, der muliggør optimering af maskinlæringsmodeller til højtydende udførelse på forskellige hardware platforme, herunder GPU, CPU og specialiserede accelerators fra forskellige producenter.
- StableHLO – specifikationen og den grundlæggende implementering af et sæt højniveauregioner (HLO, High-Level Operations) til brug i modeller af maskinlæringssystemer. Det fungerer som et lag mellem maskinlæringsrammerne og kompilatorerne, der omdanner modellen til udførelse på specifikt udstyr. Lagene til generering af modeller i StableHLO-formatet er forberedt til rammerne PyTorch, TensorFlow og JAX. MHLO-sættet blev brugt som grundlag for StableHLO, som er udvidet med understøttelse af serialisering og versionering.
- IREE (Intermediate Representation Execution Environment) er en compiler og runtime, der konverterer modeller for maskinlæring til et universelt mellemliggende repræsentation baseret på MLIR (Multi-Level Intermediate Representation) formatet fra LLVM-projektet. Blandt funktionerne bemærkes muligheden for forudgående kompilering (ahead-of-time), support for flow control, mulighed for at bruge dynamiske elementer i modellerne, optimering til forskellige CPU'er og GPU'er samt lave overhead-omkostninger.
De vigtigste fordele ved OpenXLA-værktøjet:
- At opnå optimal ydeevne uden at skulle dykke ned i at skrive kode, der er specifik for bestemte enheder. Levering af klar tekstoptimeringer, herunder forenkling af algebraiske udtryk, effektiv hukommelsesplacering, og planlægning af udførelsen med hensyntagen til reduktion af spidsbelastninger i hukommelsen og overbelastning.
- Forenkling af skalerbarhed og parallelisering af beregninger. Udvikleren skal blot tilføje annotationer til et subset af kritiske tensorer, hvormed compileren automatisk kan generere kode til parallelle beregninger.
- Sikring af bærbarhed ved at støtte forskellige hardwareplatforme som AMD og NVIDIA GPU'er, CPU'er baseret på x86 og ARM-arkitekturer, Googles TPU ML-acceleratorer, AWS Trainium og Inferentia IPU'er, Graphcore og Cerebras Wafer-Scale Engine.
- Support for tilslutning af udvidelser med implementering af yderligere funktionaliteter, såsom støtte til udarbejdelse af primitive deep learning-koder ved hjælp af CUDA, HIP, SYCL, Triton og andre sprog til parallelle beregninger. Mulighed for manuel tuning af flaskehalse i modeller.
Kilde: opennet.ru
