

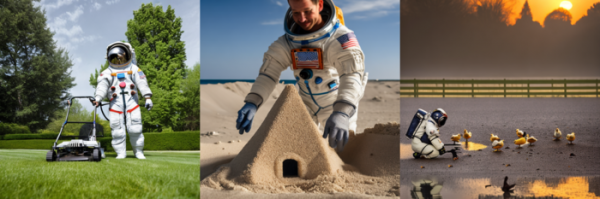
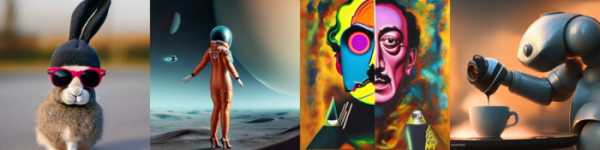
Firmaen Stability AI har udgivet den anden version af maskinlæringssystemet Stable Diffusion, der kan syntetisere og ændre billeder baseret på en foreslået skabelon eller tekstbeskrivelse på naturligt sprog. Koden til værktøjerne til at træne neurale netværk og generere billeder er skrevet i Python med brug af PyTorch-rammen og offentliggjort under MIT-licensen. Allerede trænede modeller er tilgængelige under den permissive Creative ML OpenRAIL-M-licens, som tillader kommerciel brug. Derudover er der en online billedgenerator til demonstration tilgængelig.
Nøgleforbedringer i den nye version af Stable Diffusion:
- En ny model til billedsyntese baseret på tekstbeskrivelser er blevet oprettet — SD2.0-v, som understøtter generation af billeder med en opløsning på 768×768. Den nye model er trænet ved hjælp af samlingen LAION-5B, der inkluderer 5,85 milliarder billeder med tekstbeskrivelser. Modellen bruger det samme sæt af parametre som modellen Stable Diffusion 1.5, men adskiller sig ved at anvende en helt ny encoder, OpenCLIP-ViT/H, hvilket har betydeligt forbedret kvaliteten af de genererede billeder.

- En forenklet version, SD2.0-base, er blevet forberedt, trænet på billeder med en størrelse på 256×256 ved hjælp af den klassiske støjforudsigelsesmodel og understøtter generering af billeder med en opløsning på 512×512.

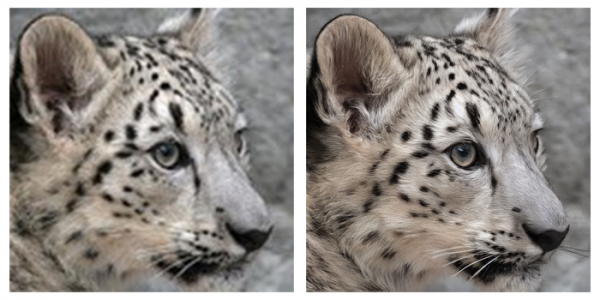
- Mulighed for at bruge superopløsnings-teknologi (Super Resolution) er blevet tilbudt for at øge opløsningen af det originale billede uden kvalitetsnedgang, ved hjælp af rumlige skalering og detaljegendannelsesalgoritmer. Den tilgængelige billedbehandlingsmodel (SD20-upscaler) understøtter en firefoldig skalering, hvilket muliggør generering af billeder med en opløsning på 2048×2048.

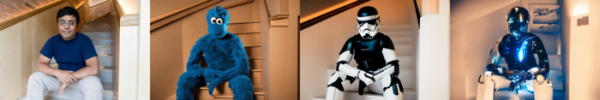
- Modellen SD2.0-depth2img, der tager hensyn til dybde og rumlig placering af objekter, er blevet foreslået. Systemet MiDaS bruges til monoculær dybdevurdering. Modellen gør det muligt at syntetisere nye billeder ved at bruge et andet billede som skabelon, der kan afvige radikalt fra originalen, men bevarer den overordnede komposition og dybde. For eksempel kan en menneskepose på et fotografi bruges til at skabe en anden karakter i den samme pose.


- Opdateret model til billedmodificering – SD 2.0-inpainting, der gør det muligt at erstatte og ændre dele af billedet ved hjælp af tekstmæssige prompt.
- Der er foretaget optimering af modellerne til brug på almindelige systemer med én GPU.
Kilde: opennet.ru
