

Vi gjorde det!
"Målet med dette kursus er at forberede dig på din tekniske fremtid."
 Hej, Habr. Kan I huske den fantastiske artikel (+219, 2588 tilføjelser, 429k læsninger)?
Så der er Hamming (ja, ja, de selvkontrollerende og selvkorrigerende ) der har en hel , skrevet inspireret af hans forelæsninger. Vi oversætter den, fordi fyren siger noget fornuftigt.
Det er ikke bare en IT-bog, det er en bog om tankestilen hos utrolig seje mennesker. "Det handler ikke kun om en positiv tankegang; den beskriver betingelserne, der øger chancerne for at gøre et stort stykke arbejde."
Tak til Andrei Pakhomov for oversættelsen.
Informationsteori blev udviklet af C. E. Shannon i slutningen af 1940'erne. Ledelsen af Bell Labs insisterede på, at han skulle kalde den "Kommunikationsteori", da det var en meget mere præcis betegnelse. Af åbenlyse grunde har betegnelsen "Informationsteori" dog en betydeligt større indflydelse på offentligheden, hvorfor Shannon valgte netop den, og det er den, vi kender i dag. Selve betegnelsen antyder, at teorien beskæftiger sig med information, og det gør den vigtig, da vi i stigende grad træder ind i informationsalderen. I dette kapitel vil jeg berøre nogle grundlæggende konklusioner fra denne teori og give ikke-strenge, men snarere intuitivt forståelige beviser for nogle af teoriets særlige udsagn, så I forstår, hvad "Informationsteori" faktisk er, hvor I kan anvende den, og hvor I ikke kan.
Først og fremmest, hvad er "information"? Shannon ligestiller information med usikkerhed. Han valgte den negative logaritme af hændelsesens sandsynlighed som en kvantitativ målestok for den information, du får, når en hændelse med sandsynlighed p indtræffer. For eksempel, hvis jeg siger til dig, at der er tåget vejr i Los Angeles, så er p tæt på 1, hvilket stort set ikke giver os meget information. Men hvis jeg siger, at der i juni regner i Monterey, vil der være usikkerhed i denne meddelelse, og den vil indeholde mere information. En sikker hændelse indeholder ikke nogen information, da log 1 = 0.
Lad os se nærmere på dette. Shannon mente, at den kvantitative måling af information skulle være en kontinuert funktion af sandsynligheden p, og for uafhængige hændelser skulle den være additiv – mængden af information, der opnås som følge af to uafhængige hændelser, skulle svare til mængden af information, der opnås som følge af en fælles hændelse. For eksempel betragtes resultatet af kastet med en terning og en mønt normalt som uafhængige hændelser. Lad os omsætte det ovenstående til matematik. Hvis I(p) er mængden af information, der er indeholdt i en hændelse med sandsynlighed p, så for den fælles hændelse, der består af to uafhængige hændelser x med sandsynlighed p1 og y med sandsynlighed p2, får vi
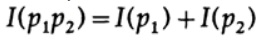
(x og y er uafhængige hændelser)
Dette er Cauchys funktionelle ligning, som er sand for alle p1 og p2. For at løse denne funktionelle ligning antager vi, at
p1 = p2 = p,
det giver
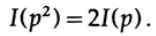
Hvis p1 = p2 og p2 = p, så
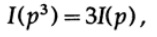
, osv. Ved at udvide denne proces og bruge den standardmetode for eksponenter, for alle rationale tal m / n, gælder følgende
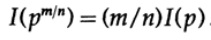
Fra den formodede kontinuitet af informationsmålingen følger det, at den logaritmiske funktion er den eneste kontinuerlige løsning på Cauchys funktionelle ligning.
Inden for informationsteori antages det, at logaritmens base er 2, så et binært valg indeholder præcist 1 bit information. Derfor måles information efter formlen
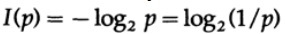
Lad os tage en pause og finde ud af, hvad der skete ovenfor. Først og fremmest har vi endnu ikke givet en definition af begrebet “information”, vi har blot defineret formlen for dens kvantitative måling.
For det andet afhænger denne måling af usikkerhed, og selvom den er passende til maskiner – for eksempel telefoner, radio, tv, computere osv. – så afspejler den ikke den normale menneskelige opfattelse af information.
For det tredje er dette en relativ måling; den afhænger af din nuværende viden. Hvis du ser på en strøm af “tilfældige tal” fra en tilfældig talgenerator, antager du, at hvert følgende tal er usikkert, men hvis du kender formlen til at beregne “tilfældige tal”, vil det næste tal være kendt, og dermed vil det ikke indeholde information.
Dermed er definitionen givet af Shannon for information i mange tilfælde passende for maskiner, men synes ikke at svare til den menneskelige forståelse af dette ord. Derfor burde "Informationsteorien" kaldes "Kommunikationsteorien". Alligevel er det allerede for sent til at ændre definitioner (som har gjort, at teorien opnåede sin oprindelige popularitet og som stadig får folk til at tro, at denne teori handler om "information"), så vi må finde os i dem, men samtidig skal du være klar over, hvor langt Shannons definition af information er fra dens almindelige betydning. Shannons information handler om noget helt andet, nemlig usikkerhed.
Dette er noget at overveje, når du foreslår nogen terminologi. Hvor meget stemmer den foreslåede definition, som f.eks. definitionen af information givet af Shannon, overens med din oprindelige idé, og hvor meget adskiller den sig? Der findes næsten ikke et begreb, der nøjagtigt afspejler dit tidligere syn på konceptet, men i sidste ende afspejler den anvendte terminologi konceptets betydning, så formalisering af noget gennem klare definitioner vil altid tilføje en vis støj.
Lad os overveje et system, hvis alfabet består af symboler q med sandsynligheder pi. I dette tilfælde det gennemsnitlige antal information i systemet (dens forventede værdi) er lig med:
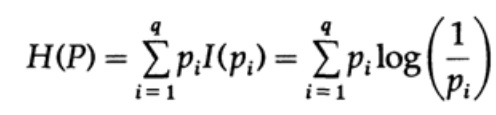
Dette kaldes systemets entropi med sandsynlighedsfordelingen {pi}. Vi bruger termen "entropi", fordi den samme matematiske form opstår i termodynamik og statistisk mekanik. Derfor skaber termen "entropi" en aura af vigtighed, som i sidste ende ikke er berettiget. Den samme matematiske form for skrivning indebærer ikke en ensartet fortolkning af symbolerne!
Entropien af sandsynlighedsfordelingen spiller en central rolle i kodningsteorien. Gibbs' ulighed for to forskellige sandsynlighedsfordelinger pi og qi er en af de vigtige følgekonsekvenser af denne teori. Så vi skal bevise, at
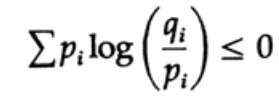
Beviset baseres på den åbenlyse graf, fig. 13.I, som viser, at
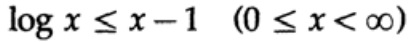
lighed opnås kun ved x = 1. Lad os anvende uligheden på hver term i summen fra venstre side:
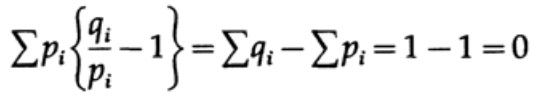
Hvis alfabetet i kommunikationssystemet består af q symboler, så ved at tage sandsynligheden for transmission af hver symbol qi = 1/q og indsætte q, får vi fra Gibbs' ulighed.
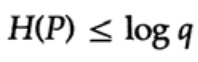
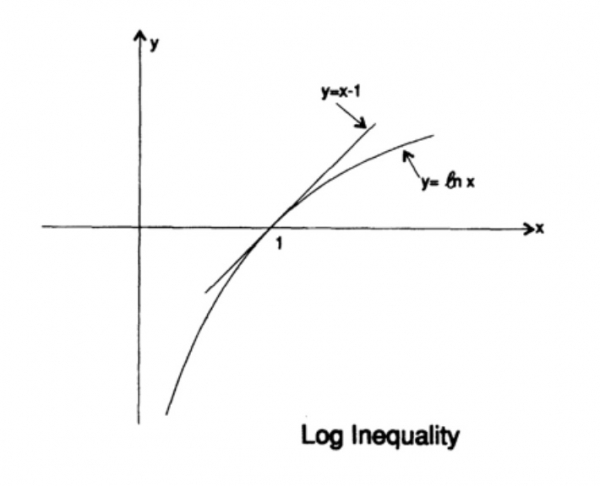
Figur 13.I
Dette betyder, at hvis sandsynligheden for transmission af alle q symboler er den samme og lig med — 1/q, så er den maksimale entropi lig med ln q; ellers gælder uligheden.
I tilfælde af entydigt dekodérkode har vi Krafts ulighed.
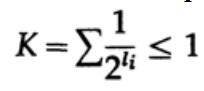
Nu, hvis vi definerer pseudomulighederne
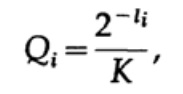
hvor selvfølgelig 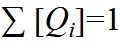 = 1, hvilket følger af Gibbs' ulighed,
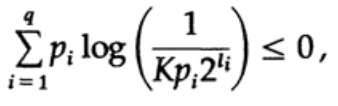
og anvender lidt algebra (husk, at K ≤ 1, så vi kan udelade det logaritmiske led og muligvis forstærke uligheden senere), får vi
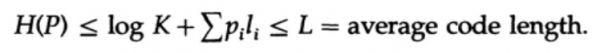
hvor L er den gennemsnitlige længde af koden.
Hermed er entropien den minimale grænse for enhver symbolkode med en gennemsnitlig længde af kodeordet L. Dette er Shannons teorem for et støjfrit kanal.
Nu overvejer vi hovedteoremet om begrænsninger i kommunikationssystemer, hvor informationen overføres i en strøm af uafhængige bits og der er støj til stede. Det antages, at sandsynligheden for korrekt transmission af en bit P > 1/2, og sandsynligheden for, at bitværdien vil blive inverteret under transmission (fejl opstår) er lig med Q = 1 — P. For nemheds skyld antager vi, at fejlene er uafhængige og sandsynligheden for fejl er den samme for hver sendt bit — det vil sige, der er
en hvid støj i kommunikationskanalen.

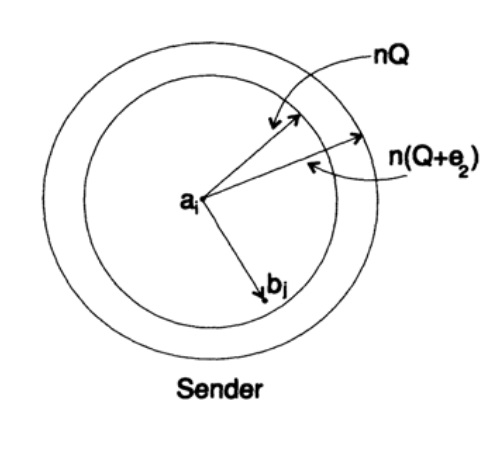
Vi har en lang strøm af n bits, kodet i en enkelt meddelelse — n-dimensionel udvidelse af en one-bit kode. Værdien af n vil vi definere senere. Lad os betragte en meddelelse bestående af n bits som et punkt i n-dimensionelt rum. Da vi har et n-dimensionelt rum — og for enkelthedernes skyld antager vi, at hver meddelelse har samme sandsynlighed for at opstå — findes der M mulige meddelelser (M vil også blive defineret senere), så sandsynligheden for enhver sendt besked er lig med
Graf 13.II
Lad os nu se på ideen om kanalens båndbredde. Uden at gå ind i detaljer, defineres kanalens båndbredde som den maksimale mængde information, der pålideligt kan overføres gennem kommunikationskanalen under hensyntagen til brugen af den mest effektive kodning. Der er ingen argumenter for, at der kan overføres mere information gennem kommunikationskanalen, end dens kapacitet. Dette kan bevises for en binær symmetrisk kanal (som vi bruger i dette tilfælde). Kanalens kapacitet, ved bit-for-bit overførsel, defineres som
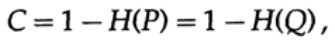
hvor, ligesom før, P er sandsynligheden for ikke at have en fejl i nogen sendt bit. Når vi sender n uafhængige bits, defineres kanalens kapacitet som
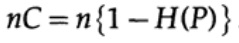
Hvis vi er tæt på kanalens båndbredde, skal vi sende næsten så meget information for hver af symbolerne ai, i = 1, …, M. Da sandsynligheden for at hver symbol ai opstår er 1 / M, får vi
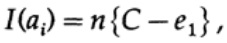
når vi sender et hvilket som helst af de M lige sandsynlige budskaber ai, har vi
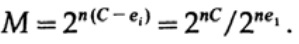
Når vi sender n bits, forventer vi nQ fejl. I praksis, for et budskab bestående af n bits, vil vi have cirka nQ fejl i det modtagne budskab. Ved store n vil den relative variation (variation = bredde af fordelingen,)
fordelingen af antallet af fejl blive stadig smalere med stigningen i n.
Så fra senderens side tager jeg budskabet ai til at sende og tegner en kugle omkring det med en radius af
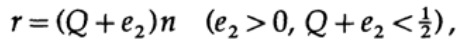
som er lidt større end en størrelse lig med e2, end det forventede antal fejl Q, (tegning 13.II). Hvis n er stort nok, er der en vilkårlig lille sandsynlighed for, at meddelelsespunket bj på modtagersiden falder uden for denne kugle. Lad os skitsere situationen, som jeg ser den fra senderens perspektiv: vi har vilkårlige radier fra det sendte budskab ai til det modtagne budskab bj med en fejlrate der er (eller næsten er) normalfordelt, der når sit maksimum ved nQ. For enhver given e2 findes der et n så stort, at sandsynligheden for at det modtagne punkt bj falder uden for min kugle, vil være så lille, som du ønsker.
Lad os nu se på den samme situation fra jeres synspunkt (fig. 13.III). På modtagerens side findes der en kugle S(r) med den samme radius r omkring den modtagne punkt bj i n-dimensionelt rum, sådan at hvis den modtagne meddelelse bj er inden for min kugle, så er den sendte meddelelse ai inden for jeres kugle.
Hvordan kan en fejl opstå? En fejl kan opstå i de tilfælde, der er beskrevet i tabellen nedenfor:
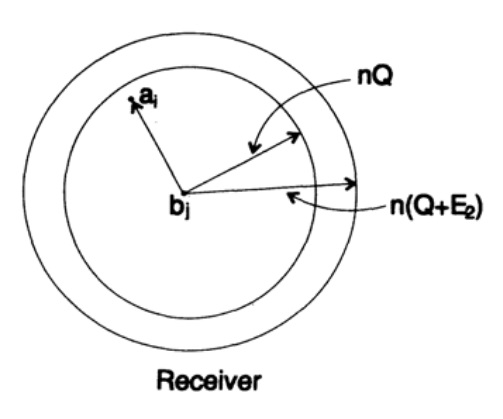
Figur 13.III
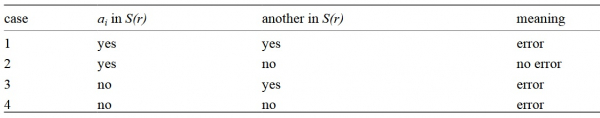
Her ser vi, at hvis der i kuglen bygget omkring det modtagne punkt findes et andet punkt, der svarer til en mulig sendt udekodet meddelelse, så er der sket en fejl under transmissionen, da du ikke kan bestemme, hvilken af disse meddelelser der blev sendt. Den sendte meddelelse indeholder ikke fejl, kun hvis punktet, der svarer til den, ligger i kuglen, og der ikke findes andre punkter, der er mulige i denne kode, som findes i samme kugle.
Vi har en matematisk ligning for fejlprocenten Pe, hvis meddelelsen ai blev sendt.
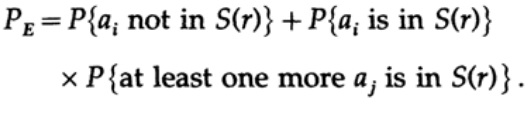
Vi kan kaste den første faktor væk i det andet led, ved at antage, at det er 1. Dermed får vi en ulighed.
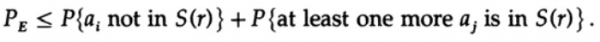
Det er åbenlyst, at
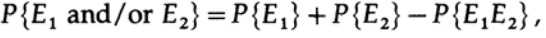
derfor
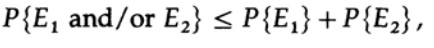
anvender vi igen på det sidste led til højre
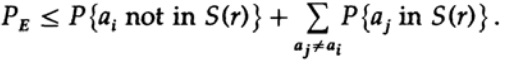
Ved at anta n som tilstrækkelig stort, kan det første led antages at være vilkårligt lille, lad os sige mindre end et bestemt tal d. Derfor har vi
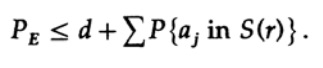
Lad os nu overveje, hvordan man kan konstruere en simpel substitutionskode til at kode M meddelelser bestående af n bits. Uden at have nogen idé om, hvordan man præcist konstruerer koden (koder med fejlkorrigering var ikke blevet opfundet endnu), valgte Shannon tilfældigt kodning. Kast en mønt for hver af de n bits i meddelelsen og gentag processen for M meddelelser. Der skal i alt laves nM møntkast, så der er mulige

kodeordbiblioteker, der har samme sandsynlighed ½nM. Selvfølgelig betyder den tilfældige proces til oprettelse af kodeordbiblioteket, at der er en risiko for, at duplikater optræder, samt kodepunkter, der vil være tæt på hinanden og derfor vil være kilder til sandsynlige fejl. Det skal bevises, at hvis dette ikke sker med en sandsynlighed, der er højere end det valgte lille fejlniveau, så er det givne n stort nok.
Det afgørende punkt er, at Shannon gennemsnittede alle mulige kodningsbøger for at finde den gennemsnitlige fejl! Vi vil bruge symbolet Av [.] for at angive gennemsnittet over mængden af alle mulige tilfældige kodeordbøger. Gennemsnitning over konstanten d giver naturligvis en konstant, da hvert medlem i gennemsnittet svarer til hvilket som helst andet medlem i summen.
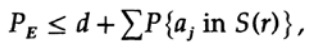
som kan øges (M–1 overgår til M)
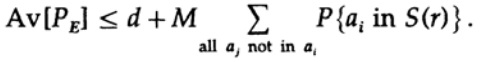
For ethvert specifikt budskab, når man gennemsnitser alle kodningsbøger, dækker kodningen alle mulige værdier, så den gennemsnitlige sandsynlighed for, at punktet er inden for kuglen, er forholdet mellem kuglens volumen og det samlede volumen af rummet. Kuglens volumen er derfor
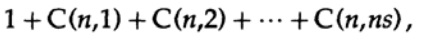
hvor s=Q+e2 <1/2 og ns skal være et helt tal.
Det sidste led til højre er det største i denne sum. Lad os først vurdere dens værdi ved hjælp af Stirling-formlen for fakulteter. Derefter ser vi på koefficienten, der reducerer leddet før det, bemærk, at denne koefficient stiger, når vi bevæger os til venstre, og derfor kan vi: (1) begrænse summen til summen af en geometrisk rækkefølge med denne startkoefficient, (2) udvide den geometriske rækkefølge med ns led til et uendeligt antal led, (3) beregne summen af den uendelige geometriske rækkefølge (standard algebra, intet væsentligt) og endelig opnå grænseværdien (for tilstrækkeligt stort n):
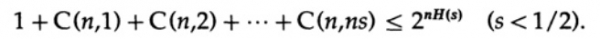
Bemærk, hvordan entropien H(s) optrådte i det binomiale lighed. Bemærk, at Taylor-udviklingen H(s)=H(Q+e2) giver en vurdering baseret kun på den første afledte og ignorerer alle de andre. Lad os nu samle det endelige udtryk:
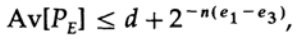
hvor
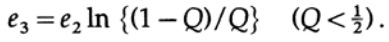
Alt, hvad vi skal gøre, er at vælge e2, så e3 < e1, og så vil det sidste led blive så lille som ønsket, når n er tilstrækkeligt stort. Derfor kan den gennemsnitlige fejl PE gøres så lille som ønskes ved en kanalkapacitet, der er så tæt på C som muligt.
Hvis gennemsnittet af alle koder har en tilstrækkelig lille fejl, så må mindst én kode være passende, hvilket indebærer, at der findes mindst ét passende kodningssystem. Dette er et vigtigt resultat opnået af Shannon — "Shannons sætning for støjende kanaler", selvom det skal bemærkes, at han bevist det for en meget mere generel situation end den enkle binære symmetriske kanal, jeg har brugt. I det generelle tilfælde er de matematiske udledninger væsentligt mere komplekse, men ideerne er ikke så forskellige, så man ofte kan forstå den sande mening af sætningen ved at tage udgangspunkt i det specifikke tilfælde.
Lad os kritisere resultatet. Vi har gentagne gange sagt: "Ved tilstrækkeligt store n". Men hvor stort et værd er n? Meget, meget stort, hvis du faktisk vil være tæt på kanalens kapacitet og være sikker på korrekt datatransmission! Så stort, at du faktisk vil være nødt til at vente meget længe for at akkumulere et budskab af så mange bits, at du efterfølgende kan kode det. På samme tid vil størrelsen af det tilfældige kodes ordbog være enorm (for der findes ingen kortere repræsentation af en sådan ordbog end den fulde liste af alle Mn bits, givet at n og M er meget store)!
Fejlkorrektionskoder undgår at vente på et meget langt budskab, med dets efterfølgende kodning og dekodning gennem meget store kodebøger, fordi de undgår kodebøger som sådan og i stedet bruger almindelige beregninger. I simpel teori mister sådanne koder typisk evnen til at nærme sig kanalens kapacitet, samtidig med at de opretholder en tilstrækkeligt lav fejlrate, men når koden korrigerer et stort antal fejl, viser de gode resultater. Med andre ord, hvis du afsætter en del af kanalens kapacitet til fejlkorrektion, skal du bruge evnen til at korrigere fejl det meste af tiden, dvs. i hver sendt besked skal der korrigeres mange fejl, ellers spilder du denne kapacitet.
Den bevist teorem er ikke meningsløs! Den viser, at effektive transmissionssystemer skal anvende gennemtænkte kodningsskemaer for meget lange bitstrenge. Et eksempel er de satellitter, der er sendt ud over de ydre planeter; efterhånden som de fjerner sig fra Jorden og Solen, er de nødt til at rette flere og flere fejl i datablokken: nogle satellitter bruger solpaneler, der giver omkring 5 W, mens andre bruger atomkilder, der giver omtrent samme effekt. Den lave effekt fra strømkilden, små størrelser på senderantenners skiver og begrænsede størrelser på modtagende skiver på Jorden, samt den enorme afstand, som signalet skal rejse — alt dette kræver brug af højfejlskorrektionskoder for at opbygge et effektivt kommunikationssystem.
Lad os vende tilbage til det n-dimensionale rum, som vi brugte i beviset ovenfor. I diskussionen viste vi, at næsten hele volumen af sphæren er koncentreret omkring overfladen — derfor vil det sendte signal næsten helt sikkert være placeret på overfladen af sphæren, bygget op omkring det modtagne signal, selv ved en relativt lille radius for en sådan sfære. Derfor er det ikke overraskende, at det modtagne signal efter at have rettet et vilkårligt antal fejl, nQ, viser sig at være så tæt som muligt på det fejlfri signal. Den kommunikationskanal, vi tidligere har set på, er nøglen til at forstå dette fænomen. Bemærk, at sådanne sfærer, bygget til Hamming-koder med fejlkorrigering, ikke overlapper hinanden. Det store antal praktisk ortogonale dimensioner i n-dimensionale rum viser, hvorfor vi kan placere M sfærer i rummet med lidt overlapning. Hvis vi tillader lidt, uendeligt lille overlapning, som kun kan føre til et lille antal fejl i dekodningen, kan vi opnå en tæt placering af sfærer i rummet. Hamming sikrede et bestemt niveau for fejlkorrigering, Shannon — en lav fejlprocent, men med opretholdelse af den faktiske båndbredde, der er så tæt som muligt på kommunikationskanalens kapacitet, hvilket Hamming-koderne ikke kan gøre.
Informationsteori fortæller os ikke, hvordan man designer et effektivt system, men den peger i retning af at skabe effektive kommunikationssystemer. Det er et værdifuldt værktøj til at bygge kommunikationssystemer mellem maskiner, men som tidligere nævnt har den ikke meget at gøre med, hvordan mennesker udveksler information med hinanden. Graden af, hvorvidt biologisk arv ligner tekniske kommunikationssystemer, er simpelthen ukendt, så det er i øjeblikket uklart, hvor anvendelig informationsteorien er i relation til gener. Der er ikke andet for os end simpelthen at prøve, og hvis succesen viser os den maskinlignende karakter af dette fænomen, så vil fiaskoen pege på andre væsentlige aspekter af informationens natur.
Lad os tage en kort pause. Vi har set, at alle oprindelige definitioner, i større eller mindre grad, skal udtrykke essensen af vores oprindelige overbevisninger, men de er præget af en vis grad af forvrængning, og derfor er de ikke anvendelige. Traditionelt antages det, at definitionen, som vi bruger, faktisk definerer essensen; men det viser os kun, hvordan vi skal håndtere tingene og bærer slet ikke nogen mening for os. Den postulerede tilgang, som i høj grad bifaldes i matematiske kredse, lader meget tilbage at ønske i praksis.
Nu skal vi se på et eksempel på IQ-tests, hvor definitionen er så cyklisk, som du ønsker, og som følge heraf kan forvirre dig. En test skabes, som formodes at skulle måle intelligens. Derefter bliver den revideret for at gøre den så konsistent som muligt, hvorefter den offentliggøres og kalibreres ved en simpel metode, så den målte "intelligens" viser sig at være normalt fordelt (naturligvis efter kalibreringskurven). Alle definitioner skal kontrolleres igen, ikke kun når de først foreslås, men også mange år senere, når de bruges i de dragne konklusioner. I hvilken grad passer grænserne for definitioner til den opgave, der skal løses? Hvor ofte begynder definitioner, der gives under én omstændighed, at blive brugt under tilstrækkeligt forskellige omstændigheder? Det sker ganske ofte! Inden for humaniora, som du uundgåeligt vil støde på i dit liv, sker dette oftere.
Derfor var et af formålene med denne præsentation af informationsteori, udover at demonstrere dens nytte, at advare dig om denne fare, eller at demonstrere hvordan den præcist kan bruges til at opnå det ønskede resultat. Det er længe blevet bemærket, at de oprindelige definitioner i højere grad påvirker, hvad du finder frem til, end det umiddelbart virker. De oprindelige definitioner kræver, at du er meget opmærksom, ikke kun i enhver ny situation, men også inden for områder, som du har arbejdet med i lang tid. Dette vil give dig mulighed for at forstå, i hvilken grad de opnåede resultater er tautologier frem for noget nyttigt.
Den kendte historie om Eddington fortæller om folk, der fangede fisk i havet med net. Efter at have undersøgt størrelsen på de fisk, de fangede, bestemte de den mindste størrelse på fiskene, der findes i havet! Deres konklusion var præget af det værktøj, der blev brugt, snarere end virkeligheden.
Fortsætter…
Den, der ønsker at hjælpe med oversættelse, layout og udgivelse af bog — skriv til mig i privatbeskeder eller på mail magisterludi2016@yandex.ru
Forresten har vi også startet oversættelsen af en anden fantastisk bog — )
Vi søger især dem, der kan hjælpe med at oversætte . (vi oversætter i 10 minutters bidder, de første 20 er allerede taget)
Indholdet i bogen og de oversatte kapitler
- Intro til The Art of Doing Science and Engineering: Learning to Learn (28. marts 1995)
- „Foundations of the Digital (Discrete) Revolution“ (30. marts 1995)
- «Historien om computere — Hardware» (31. marts 1995)
- «Historien om computere — Software» (4. april 1995)
- «Historien om computere — Applikationer» (6. april 1995)
- «Kunstig Intelligens — Del I» (7. april 1995)
- «Kunstig Intelligens — Del II» (11. april 1995)
- «Kunstig Intelligens III» (13. april 1995)
- «n-Dimensionelt Rum» (14. april 1995)
- «Kodeteori — Representationen af information, Del I» (18. april 1995)
- «Kodeteori — Representationen af information, Del II» (20. april 1995)
- «Fejlretterkoder» (21. april 1995)
- «Informationsteori» (25. april 1995)
- «Digitale Filtre, Del I» (27. april 1995)
- «Digitale Filtre, Del II» (28. april 1995)
- «Digitale Filtre, Del III» (2. maj 1995)
- «Digitale Filtre, Del IV» (4. maj 1995)
- «Simulation, Del I» (5. maj 1995)
- «Simulation, Del II» (9. maj 1995)
- «Simulation, Del III» (11. maj 1995)
- «Fiberoptik» (12. maj 1995)
- «Computerbaseret Undervisning» (16. maj 1995)
- «Matematik» (18. maj 1995)
- «Kvantemekanik» (19. maj 1995)
- «Kreativitet» (23. maj 1995). Oversættelse:
- «Eksperter» (25. maj 1995)
- «Utroværdige Data» (26. maj 1995)
- «Systems Engineering» (30. maj 1995)
- «Du får hvad du måler» (1. juni 1995)
- (2. juni 1995) oversætter i 10 minutters bidder
- Hamming, «Du og din forskning» (6. juni 1995).
Den, der ønsker at hjælpe med oversættelse, layout og udgivelse af bog — skriv til mig i privatbeskeder eller på mail magisterludi2016@yandex.ru
Kilde: habr.com
