

SciPy (udtales som 'sai pai') er et bibliotek af anvendte matematiske procedurer baseret på udvidelsen af Numpy Python. Med SciPy forvandles en interaktiv Python-session til et fuldt funktionelt databehandlings- og prototypeværktøj, ligesom MATLAB, IDL, Octave, R-Lab og SciLab. I dag ønsker jeg kort at beskrive, hvordan man korrekt anvender nogle kendte optimeringsalgoritmer i pakken scipy.optimize. Mere detaljeret og relevant dokumentation til brug af funktionerne kan altid findes ved hjælp af kommandoen help() eller ved at trykke Shift+Tab.
Introduktion
For at spare mig selv og læserne for at søge og læse de oprindelige kilder, vil links til beskrivelser af metoderne primært være til Wikipedia. Som regel er denne information tilstrækkelig til at forstå metoderne i brede træk og deres anvendelsesbetingelser. For at forstå essensen af de matematiske metoder henvises der til mere autoritative publikationer, som kan findes i slutningen af hver artikel eller via en søgemaskine.
Så modulen scipy.optimize indeholder implementeringen af følgende procedurer:
- Betinget og ubetinget minimalisering af skalarfunktioner med flere variabler (minim) ved hjælp af forskellige algoritmer (Nelder-Mead simplex, BFGS, Newtons konjugerede gradienter, og )
- Global optimering (for eksempel: , )
- Minimering af residualer (least_squares) og algoritmer til tilpasning af kurver med ikke-lineær MNL (curve_fit)
- Minimering af skalarfunktioner med én variabel (minim_scalar) og søgning efter rødder (root_scalar)
- Mange-dimensionelle løsningsmetoder til ligningssystemer (root) ved hjælp af forskellige algoritmer (hybrid Powell, eller storskala metoder som ).
I denne artikel vil vi kun se på det første punkt fra denne liste.
Ubetydelig minimalisering af skalarfunktioner med flere variabler
Funktionen minim fra pakken scipy.optimize giver et generelt interface til at løse opgaver med betinget og ubetinget minimalisering af skalarfunktioner med flere variabler. For at demonstrere dens funktionalitet, har vi brug for en passende funktion med flere variabler, som vi vil minimere på forskellig vis.
Til disse formål er Rosenbrock-funktionen af N variabler perfekt egnet, og den har følgende form:

Selvom Rosenbrock-funktionen og dens Jacobiske og Hessianske matricer (første og anden derivat henholdsvis) allerede er defineret i scipy.optimize-pakken, lad os definere det selv.
import numpy as np

def rosen(x):
    """Rosenbrock-funktionen"""
    return np.sum(100.0*(x[1:]-x[:-1]**2.0)**2.0 + (1-x[:-1])**2.0, axis=0)
For tydelighed vil vi plotte 3D-værdierne af Rosenbrock-funktionen fra to variabler.
Koden til plottet
from mpl_toolkits.mplot3d import Axes3D
import matplotlib.pyplot as plt
from matplotlib import cm
from matplotlib.ticker import LinearLocator, FormatStrFormatter

# Konfigurerer 3D-diagrammet
fig = plt.figure(figsize=[15, 10])
ax = fig.gca(projection='3d')

# Indstiller synsvinklen
ax.view_init(45, 30)

# Skaber data til diagrammet
X = np.arange(-2, 2, 0.1)
Y = np.arange(-1, 3, 0.1)
X, Y = np.meshgrid(X, Y)
Z = rosen(np.array([X,Y]))

# Tegner overfladen
surf = ax.plot_surface(X, Y, Z, cmap=cm.coolwarm)
plt.show()
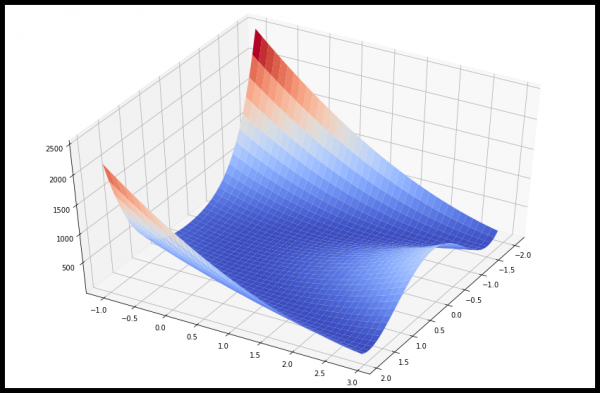
Da vi på forhånd ved, at minimum er 0 ved  , lad os se på eksempler på, hvordan man bestemmer minimumsværdien af Rosenbrock-funktionen ved hjælp af forskellige procedurer fra scipy.optimize.
Nelder-Mead simplexmetoden
Lad os antage, at der er et startpunkt x0 i et 5-dimensionelt rum. Vi vil finde det nærmeste punkt til minimum af Rosenbrock-funktionen ved hjælp af algoritmen (algoritmen angives som parameterens værdi method):
from scipy.optimize import minimize
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='nelder-mead',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimering afsluttet med succes.
Nuværende funktionsværdi: 0.000000
Iterationer: 339
Funktionsvurderinger: 571
[1. 1. 1. 1. 1.]Simplicemetoden er den mest enkle måde at minimere en klart defineret og ret glat funktion. Den kræver ikke beregning af funktionens derivater, kun dens værdier. Nelder-Mead-metoden er et godt valg til enkle minimiseringsopgaver. Men fordi den ikke bruger gradientvurderinger, kan det tage længere tid at finde minimum.
Powell-metoden
En anden optimeringsalgoritme, hvor der kun beregnes funktionsværdier, er . For at bruge den skal du angive method = ‘powell’ i minim-funktionen.
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='powell',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimering afsluttet med succes.
Nuværende funktionsværdi: 0.000000
Iterationer: 19
Funktionsvurderinger: 1622
[1. 1. 1. 1. 1.]Broyden-Fletcher-Goldfarb-Shanno (BFGS) algoritmen
For at opnå hurtigere konvergens til løsningen, proceduren bruger gradienten af mål-funktionen. Gradient kan angives som en funktion eller beregnes ved hjælp af første ordens forskelle. Under alle omstændigheder kræver metoden BFGS normalt færre funktionsopkald end simplexmetoden.
Lad os finde den analytiske afledte af Rosenbrock-funktionen:


Dette udtryk gælder for afledte af alle variabler undtagen den første og den sidste, som defineres som:


Lad os se på en Python-funktion, der beregner denne gradient:
def rosen_der (x):
    xm = x [1: -1]
    xm_m1 = x [: -2]
    xm_p1 = x [2:]
    der = np.zeros_like (x)
    der [1: -1] = 200 * (xm - xm_m1 ** 2) - 400 * (xm_p1 - xm ** 2) * xm - 2 * (1 - xm)
    der [0] = -400 * x [0] * (x [1] - x [0] ** 2) - 2 * (1 - x [0])
    der [-1] = 200 * (x [-1] - x [-2] ** 2)
    return der
Gradientberegningsfunktionen angives som værdien af parameteren jac til minim-funktionen, som vist nedenfor.
res = minimize(rosen, x0, method='BFGS', jac=rosen_der, options={'disp': True})
print(res.x)
Optimering afsluttet med succes.
Nuværende funktionsværdi: 0.000000
Iterationer: 25
Funktionsvurderinger: 30
Gradientvurderinger: 30
[1.00000004 1.0000001 1.00000021 1.00000044 1.00000092]Methoden til konjugerede gradienter (Newton)
Metode er en modificeret Newton-metode.
Newton-metoden er baseret på at tilnærme funktionen i et lokalt område med et andengradspolynomium:

hvor  er Hessian-matrixen (anden afledte matrix).
Hvis Hessianen er positivt definit, kan det lokale minimum af denne funktion findes ved at sætte den nulgradient kvadratiske form lig med nul. Dette resulterer i udtrykket:

Den inverse Hessian beregnes ved hjælp af metoden til konjugerede gradienter. Et eksempel på brugen af denne metode til at minimere Rosenbrock-funktionen er givet nedenfor. For at bruge Newton-CG-metoden skal der angives en funktion, der beregner Hessianen.
Hessianen af Rosenbrock-funktionen i analytisk form er lig med:


hvor  og
 , bestemmer matrixen
 .
De øvrige ikke-nul elementer i matrixen er lig med:


For eksempel i femdimensionelt rum N = 5 har Hessian-matrixen for Rosenbrock-funktionen en båndet form:

Koden, der beregner denne Hessian sammen med koden til at minimere Rosenbrock-funktionen ved hjælp af metoden til konjugerede gradienter (Newton):
def rosen_hess(x):
    x = np.asarray(x)
    H = np.diag(-400*x[:-1],1) - np.diag(400*x[:-1],-1)
    diagonal = np.zeros_like(x)
    diagonal[0] = 1200*x[0]**2-400*x[1]+2
    diagonal[-1] = 200
    diagonal[1:-1] = 202 + 1200*x[1:-1]**2 - 400*x[2:]
    H = H + np.diag(diagonal)
    return H

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hess=rosen_hess,
               options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimering afsluttet med succes.
Nuværende funktionsværdi: 0.000000
Iterationer: 24
Funktionsvurderinger: 33
Gradientvurderinger: 56
Hessianvurderinger: 24
[1. 1. 1. 0.99999999 0.99999999]Eksempel med definitionen af hessianens produkt og en vilkårlig vektor
I reelle opgaver kan beregningen og opbevaringen af hele Hessian-matrixen kræve betydelige ressourcer til tid og hukommelse. Faktisk er det ikke nødvendigt at specificere selve Hessian-matrixen, da der for minimeringsproceduren kun er behov for en vektor, der er lig med produktet af Hessian og en anden vilkårlig vektor. Derfor er det beregningsmæssigt meget mere fordelagtigt straks at definere en funktion, der returnerer resultatet af produktet af Hessian med en vilkårlig vektor.
Lad os overveje funktionen hess, der modtager minimiseringsvektoren som det første argument og en vilkårlig vektor som det andet argument (sammen med andre argumenter fra den minimiserede funktion). I vores tilfælde er det ikke særlig svært at beregne produktet af Hessianen for Rosenbrock-funktionen med en vilkårlig vektor. Hvis p — den vilkårlige vektor, så er produktet  givet ved:

Funktionen, der beregner produktet af Hessian og en vilkårlig vektor, gives som værdien af argumentet hessp i funktionen minimize:
def rosen_hess_p(x, p):
    x = np.asarray(x)
    Hp = np.zeros_like(x)
    Hp[0] = (1200*x[0]**2 - 400*x[1] + 2)*p[0] - 400*x[0]*p[1]
    Hp[1:-1] = -400*x[:-2]*p[:-2]+(202+1200*x[1:-1]**2-400*x[2:])*p[1:-1]
    -400*x[1:-1]*p[2:]
    Hp[-1] = -400*x[-2]*p[-2] + 200*p[-1]
    return Hp

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'xtol': 1e-8, 'disp': True})
Optimering afsluttet med succes.
         Nuværende funktionsværdi: 0.000000
         Iterationer: 24
         Funktionsvurderinger: 33
         Gradientvurderinger: 56
         Hessianvurderinger: 66
Algoritme for tillidsområde (trust region) af Newtons konjugerede gradienter
Dårlig konditionering af Hessian-matrixen og forkerte søge-retninger kan føre til, at Newtons konjugerede gradient-algoritme kan være ineffektiv. I sådanne tilfælde foretrækkes (trust-region) for Newtons konjugerede gradienter.
Eksempel med definitionen af Hessian-matrixen:
res = minimize(rosen, x0, method='trust-ncg',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
print(res.x)
Optimering afsluttet med succes.
Nuværende funktionsværdi: 0.000000
Iterationer: 20
Funktionsvurderinger: 21
Gradientvurderinger: 20
Hessianvurderinger: 19
[1. 1. 1. 1. 1.]Eksempel med produktet af hessian og en vilkårlig vektor:
res = minimize(rosen, x0, method='trust-ncg',
                jac=rosen_der, hessp=rosen_hess_p,
                options={'gtol': 1e-8, 'disp': True})
print(res.x)
Optimering afsluttet med succes.
Nuværende funktionsværdi: 0.000000
Iterationer: 20
Funktionsvurderinger: 21
Gradientvurderinger: 20
Hessianvurderinger: 0
[1. 1. 1. 1. 1.]Krylovtype metoder
Ligesom trust-ncg metoden er Krylovtype metoder godt egnet til løsning af storskala opgaver, da de kun bruger matrix-vektor produkter. Essensen er at løse opgaven i et tillidsområde begrænset af et afskåret Krylov-underindustri. For uveldefinerede opgaver er det bedre at bruge denne metode, da den bruger færre ikke-lineære iterationer takket være færre matrix-vektor produkter pr. delopgave sammenlignet med trust-ncg metoden. Derudover findes løsningen af den kvadratiske delopgave mere præcist end med trust-ncg metoden.
Eksempel med definitionen af Hessian-matrixen:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})

Optimering afsluttet med succes.
         Nuværende funktionsværdi: 0.000000
         Iterationer: 19
         Funktionsvurderinger: 20
         Gradientvurderinger: 20
         Hessianvurderinger: 18

print(res.x)

    [1. 1. 1. 1. 1.]
Eksempel med produktet af hessian og en vilkårlig vektor:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'gtol': 1e-8, 'disp': True})

Optimering afsluttet med succes.
         Nuværende funktionsværdi: 0.000000
         Iterationer: 19
         Funktionsvurderinger: 20
         Gradientvurderinger: 20
         Hessianvurderinger: 0

print(res.x)

    [1. 1. 1. 1. 1.]
Algoritme til tilnærmet løsning i tillidsområdet
Alle metoder (Newton-CG, trust-ncg og trust-krylov) er velegnede til løsning af storskala opgaver (med tusinder af variabler). Dette skyldes, at den underliggende algoritme for konjugerede gradienter indebærer en tilnærmet bestemmelse af den omvendte hessian matrix. Løsningen findes iterativt, uden eksplicit opdeling af hessian. Da det kun kræves at bestemme en funktion til produktet af hessian og en vilkårlig vektor, er denne algoritme særlig god til arbejde med sparsomme (båndede diagonale) matricer. Dette sikrer lave hukommelsesomkostninger og betydelige tidsbesparelser.
I opgaver af mellemstørrelse er omkostningerne ved lagring og faktorisering af Hessian ikke af afgørende betydning. Dette betyder, at man kan opnå en løsning med færre iterationer ved næsten præcist at løse delopgaverne inden for tillidsområdet. For dette bliver visse ikke-lineære ligninger løst iterativt for hver kvadratisk delopgave. En sådan løsning kræver normalt 3 eller 4 faktoriseringer af Hessian-matrixen. Som et resultat konvergerer metoden med færre iterationer og kræver færre beregninger af målfunktionen end andre implementerede metoder inden for tillidsområdet. Denne algoritme forudsætter kun bestemmelsen af den komplette Hessian-matrix og understøtter ikke muligheden for at bruge funktionen af Hessian og en vilkårlig vektor.
Eksempel med minimisering af Rosenbrock-funktionen:
res = minimize(rosen, x0, method='trust-exact',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
res.x
Optimering afsluttet med succes.
Aktuel funktionsværdi: 0.000000
Iterationer: 13
Funktionsvurderinger: 14
Gradientvurderinger: 13
Hessianvurderinger: 14
array([1., 1., 1., 1., 1.])Det var vist alt for nu. I næste artikel vil jeg forsøge at fortælle det mest spændende om betinget minimisering, anvendelsen af minimisering i løsning af tilnærmingsopgaver, minimisering af funktioner med en variabel, vilkårlige minimeringsmetoder og søgning efter rødder i ligningssystemer ved hjælp af pakken scipy.optimize.
Kilde:
Kilde: habr.com
