

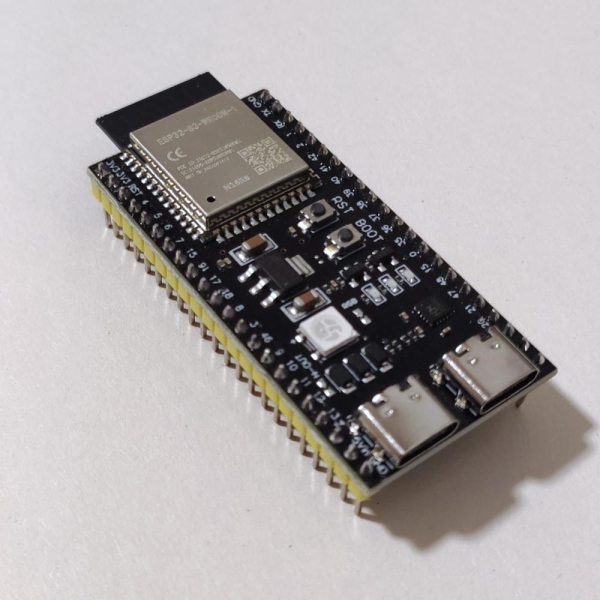
Udvikleren Vyacheslav Serbov, der bruger pseudonymet slvDev, demonstreret har udviklet en helt lokal tekstgenerator på mikrokontrolleren ESP32-S3. Den sprogmodel, han har skabt, indeholder 28,9 millioner parametre og genererer cirka 9,9 tokens pr. sekund uden at gøre brug af en server eller andre eksterne computerressourcer. De genererede korte fortællinger vises på en tilsluttet OLED-skærm.
Projekt esp32-ai er testet på ESP32-S3 N16R8-modulet, som har 512 KB indbygget SRAM, 8 MB PSRAM og 16 MB flashhukommelse. Quantiseret til fire bit fylder modellen 14,9 MB. Kildekoden til runtime-miljøet i C, trænings- og kvantiseringsværktøjerne, firmware, tests og dens upload-scripts er offentliggjort i depotet.
De angivne 28,9 millioner parametre bør ikke sammenlignes direkte med antallet af parametre for traditionelle desktop LLM'er. Ifølge den detaljerede rapport fra udvikleren,består modellen af et tæt beregningskerne med cirka 559 tusinde parametre, et udgangslag med 3,1 millioner parametre og et lagdelt vektortabel med cirka 25 millioner parametre. Det er især det sidste, der giver den primære del af den formelle størrelse af modellen, men behandles ikke helt ved genereringen af hvert token.
Tre niveauer af hukommelse anvendes til at håndtere modellen. De mest brugte data findes i den interne SRAM, udgangslaget, KV-cache og midlertidige buffere er i PSRAM, mens den 25-millioners tabel forbliver i flashhukommelsen og er tilgængelig gennem kortlægning til adressens rum. For hvert token bliver der kun læst omkring seks linjer med et samlet volumen på cirka 450 byte fra den.
Sådan en enhed er baseret på Per-Layer Embeddings-teknologien, anvendt af Google i Gemma 3n. Ifølge Google-dokumentationen,kan PLE-parametrene opbevares uden for modelens arbejdshukommelse og tilføjes i outputprocessen, mens de enkelte lag behandles. I esp32-ai er denne tilgang overført til mikrokontrollerens hukommelseshierarki, hvor hurtig SRAM er særligt begrænset.
Den første korrekte version af det udførte C-kørselmiljø gav kun 0,57 tokens per sekund. Efter at have placeret outputlaget i PSRAM, skiftet til 8-bit aktiveringer, fordelt beregninger mellem to Xtensa LX7-kerner og andre optimeringer, blev latenstiden reduceret til 94,9 ms pr. modeltrin. Den endelige målte hastighed nåede 9,88 tokens per sekund med hensyn til den samlede genereringsproces. Den primære begrænsning er nu PSRAM-båndbredden ved læsning af outputlaget.
Modellen er trænet på et syntetisk datasæt TinyStories, bestående af enkle engelsksprogede historier med et begrænset ordforråd. Derfor er den i stand til at fortsætte sætninger og skabe små sammenhængende historier, men den er ikke designet til at besvare spørgsmål, udføre instruktioner, programmere eller gengive faktiske viden. Udvikleren betragter arbejdet først og fremmest som en demonstration af en effektiv modellægningsplads i mikrocontrollerens hukommelse, snarere end som en færdig autonom chatbot.
I den aktuelle dokumentation understreger forfatteren, at esp32-ai er et uafhængigt projekt. Projekter llama2.c Andrej Karpaty og den tidligere lancering af den 260.000 parametre model på ESP32-S3 nævnes kun som pejlemærker og eksempler på tidligere arbejde: koden, kontrolpunkterne og metoden er ikke direkte lånt fra dem. Kildekoden til esp32-ai distribueres under MIT-licensen.
Kilde: linux.org.ru
