

I juni i år fandt der for tiende gang et arrangement med navnet . Denne gang samlede det mere end fem hundrede Haskell-entusiaster, fra begyndere til sproggrundlæggere. Selvom arrangørerne kalder det et hackathon, er det dog ikke en konference eller hackathon i klassisk forstand. Dets format adskiller sig fra traditionelle programmeringsarrangementer. Vi lærte om ZuriHac ved en lykkelig tilfældighed, deltog i det, og nu føler vi, at det er vores pligt at fortælle om denne usædvanlige opdagelse!
Om os
Denne artikel er skrevet af to tredjeårs studerende fra programmet 'Anvendt matematik og informatik' ved HSE — Sankt Petersborg: Vasily Alfyorov og Yelizaveta Vasilenko. Vores interesse for funktionel programmering begyndte for begge med en række forelæsninger af D. N. Moskvin på andet år på universitetet. I øjeblikket deltager Vasily i Google Summer of Code-programmet, hvor han arbejder med implementeringen af algebraiske grafer i Haskell under vejledning af projektteamet . Yelizaveta har anvendt de færdigheder, hun har opnået inden for funktionel programmering, i sit kursusprojekt, der handler om implementeringen af et anti-unifikationsalgoritme med efterfølgende anvendelse i type-teori.
Arrangementets format
Den målgruppe, der henvender sig til, er ejere af open source-projekter, programmører, der ønsker at deltage i deres udvikling, forskere inden for funktionel programmering samt blot Haskell-entusiaster. I år samledes udviklere fra mere end femti open source-projekter i Haskell fra hele verden på universitetet HSR Hochschule für Technik Rapperswil for at præsentere deres produkter og engagere nye folk i deres udvikling.
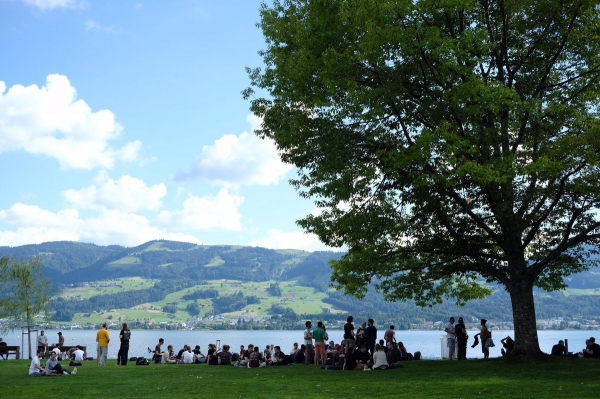
Billeder fra Twitter
Skemaet er meget enkelt: man skal på forhånd skrive et par sætninger om sit projekt og sende dem til arrangørerne, som vil offentliggøre informationen om dit projekt på arrangementets hjemmeside. Derudover har projektforfattere på den første dag tredive sekunder til meget kort at fortælle fra scenen, hvad de arbejder med, og hvad der skal gøres. Derefter opsøger interesserede folk forfatterne og spørger detaljeret om opgaverne.
Vi har endnu ingen egne åbne projekter, men vi ønsker virkelig at bidrage til eksisterende projekter, så vi har registreret os som almindelige deltagere. I løbet af tre dage arbejdede vi med to grupper af udviklere. Det viser sig, at fælles kodestudie og direkte kommunikation gør interaktionen mellem projektforfattere og bidragydere meget produktiv – på ZuriHac fik vi mulighed for at forstå nye områder og hjælpe to helt forskellige teams med at få løst opgaver i hvert af de projekter.
Ud over den værdifulde praksis blev der også holdt flere forelæsninger og workshops på ZuriHac. Vi mindes især to forelæsninger. I den første talte Andrey Mokhov fra Newcastle University om selektive applikative funktorer – en typeklasse, der skal fungere som et mellemtrin mellem applikative funktorer og monader. I den anden forelæsning fortalte en af grundlæggerne af Haskell, Simon Peyton Jones, om, hvordan typeudledningen i GHC-kompilatoren fungerer.
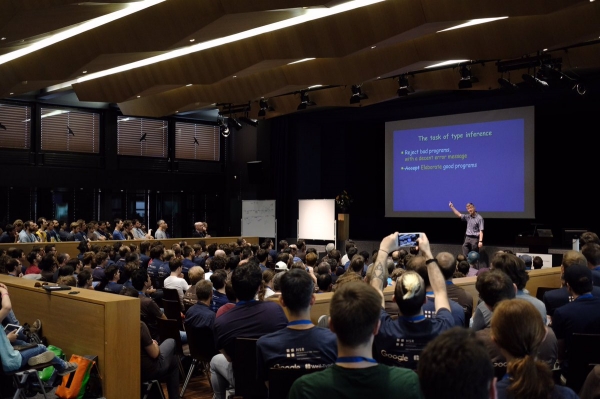
Forelæsning af Simon Peyton Jones. Foto fra Twitter
Workshops afholdt under hackathonet blev opdelt i tre kategorier afhængigt af deltagerens forberedelsesniveau. Opgaverne, der blev tilbudt deltagere, der sluttede sig til projektudviklingen, var også markeret med sværhedsgrad. Det lille, men sammenholdte samfund af funktionelle programmører tager gladeligt imod nybegyndere. Dog var vi meget glade for det kursus i funktionel programmering, vi havde gennemgået på universitetet, for at forstå forelæsningerne af Andrey Mokhov og Simon Peyton Jones.
For både almindelige deltagere og projektforfattere er tilmeldingen til arrangementet gratis. Vi indsendte vores ansøgninger i begyndelsen af juni, hvorefter vi hurtigt blev flyttet fra ventelisten til listen over bekræftede deltagere.
Nu vil vi fortælle om de projekter, som vi har deltaget i udviklingen af.
Pandoc
— er en universel konverter for tekstdokumenter, der i praksis kan konvertere fra ethvert format til ethvert. For eksempel fra docx til pdf, eller fra Markdown til MediaWiki. Dens forfatter, John MacFarlane, er professor i filosofi ved University of California, Berkeley. Generelt er Pandoc ret kendt, og nogle af vores bekendte blev overraskede, da de fandt ud af, at Pandoc er skrevet i Haskell.
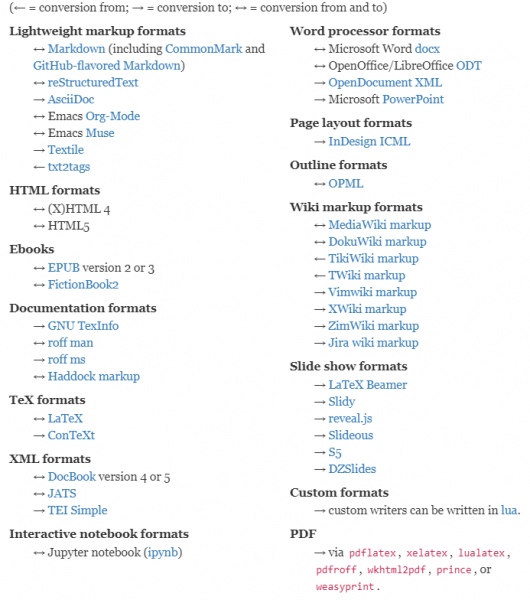
Liste over dokumentformater, der understøttes af Pandoc. Der findes også en hel grafik på hjemmesiden, men dette billede kan ikke inkluderes i artiklen.
Selvfølgelig er der ikke implementeret direkte konvertering for hver formatpar i Pandoc. For at understøtte et så omfattende antal konverteringer bruges en standardarkitektur: først oversættes hele dokumentet til en speciel intern mellemrepræsentation, og derefter genereres dokumentet i et andet format ud fra denne interne repræsentation. Den interne repræsentation kalder udviklerne "AST", som står for Abstract Syntax Tree, eller . Man kan nemt se den mellemrepræsentation: man skal blot angive "native" som outputformat.
$ cat example.html
<h1>Hej, verden!</h1>

$ pandoc -f html -t native example.html
[Header 1 ("hello-world",[],[]) [Str "Hej,",Space,Str "Verden!"]]
Læserne, der har arbejdet lidt med Haskell, kan allerede ud fra dette lille eksempel antage, at Pandoc er skrevet i Haskell: output af denne kommando er en repræsentation af Pandocs interne strukturer i form af en streng, skabt på en måde som det normalt gøres i Haskell, f.eks. i standardbiblioteket.
Så her kan man se, at den interne repræsentation er en rekursiv struktur, hvor der i hver intern node findes en liste. For eksempel er der på det øverste niveau en liste med et element - en overskrift af første niveau med attributterne “hello-world”,[],[]. Inden i denne overskrift gemmer sig en liste af strengen “Hello,”, et mellemrum og strengen “World!”.
Som det ses, adskiller den interne repræsentation sig ikke meget fra HTML. Den repræsenterer et træ, hvor hver interne node angiver noget information om formateringen af sine efterkommere, og i bladene findes selve indholdet af dokumentet.
Hvis man dykker ned i niveauet for den specifikke implementering, er datatypen for hele dokumentet defineret som følger:
data Pandoc = Pandoc Meta [Block]Her er Block netop de interne noder, som omtales ovenfor, mens Meta er metaoplysninger om dokumentet, såsom titel, oprettelsesdato, forfattere - for forskellige formater er dette forskelligt, og Pandoc forsøger at bevare sådanne oplysninger i videst mulige omfang ved konvertering mellem formater.
Næsten alle konstruktører af typen Block — som Header eller Para (afsnit) — accepterer attributter og en liste over lavere niveauer som argumenter — typisk Inline. For eksempel er Space eller Str konstruktører af typen Inline, og HTML-tagget
bliver også til en speciel Inline. Vi ser ikke nogen grund til at give en fuld definition af disse typer, men bemærker, at den kan ses her .
Det er interessant, at typen Pandoc er et monoid. Det betyder, at der findes et tomt dokument, og at dokumenter kan samles. Dette er praktisk, når man skriver Readers — man kan opdela dokumentet i dele med vilkårlig logik, parsed hver del for sig, og så samle det hele til et dokument. Samtidig vil meta-informationen blive samlet fra alle dele af dokumentet på én gang.
Ved konvertering, lad os sige fra LaTeX til HTML, transformerer en speciel modul kaldet LaTeXReader det indgående dokument til AST, derefter transformerer et andet modul kaldet HTMLWriter AST til HTML. Takket være denne arkitektur er det ikke nødvendigt at skrive et kvadratisk antal konverteringer — det er tilstrækkeligt at skrive en Reader og en Writer for hvert nyt format, og alle mulige par af konverteringer vil blive automatisk understøttet.
Det er klart, at en sådan arkitektur også har sine ulemper, der længe er blevet forudset af eksperter inden for softwarearkitektur. Den væsentligste er omkostningerne ved at ændre syntakstræet. Hvis ændringen er tilstrækkelig alvorlig, skal koden ændres i alle Readers og Writers. For eksempel er en af de opgaver, som Pandoc-udviklerne står overfor — understøttelse af komplekse tabelformater. I øjeblikket kan Pandoc kun håndtere de enkleste tabeller med overskrifter, kolonner og værdier i hver celle. For eksempel vil attributten colspan i HTML blive ignoreret. En af årsagerne til denne adfærd er fraværet af en ensartet skema til repræsentation af tabeller i alle eller i det mindste mange formater — følgelig er det uklart, i hvilken form tabeller skal opbevares i den interne repræsentation. Men selv efter at have valgt en konkret repræsentation, skal alle Readers og Writers, der understøtter arbejde med tabeller, ændres.
Haskell-sproget blev valgt ikke kun på grund af forfatternes store kærlighed til funktionel programmering. Haskell er kendt for de brede muligheder inden for tekstbehandling. Et eksempel er biblioteket — et bibliotek, der aktivt bruger koncepter fra netop funktionel programmering — monoid, monader, applikative og alternative funktorer — til at skrive vilkårlige parser. Den fulde kraft af Parsec kan ses i HaskellWiki, hvor en fuld parser for et simpelt imperativt programmeringssprog gennemgås. Selvfølgelig anvendes Parsec også aktivt i Pandoc.
For at beskrive det kort, bruges monader til sekventiel parsing, hvor noget kommer først, og så noget andet. For eksempel i dette eksempel:
whileParser :: Parser Stmt
whileParser = whiteSpace >> statement
Først skal der læses et mellemrum, og så en statement — som også har typen Parser Stmt.
Alternative funktorer bruges til at backtracke, hvis parsing ikke lykkes. For eksempel,
statement :: Parser Stmt
statement = parens statement  sequenceOfStmt
Betyder, at man enten skal forsøge at læse en statement i parenteser, eller sekventielt forsøge at læse flere statements.
Applikative funktorer bruges især som genveje til monader. For eksempel, lad os sige, at funktionen tok læser en eller anden token (dette er en reel funktion fra LaTeXReader). Lad os se på en sådan kombination
const tok tokDen vil læse to tokens efter hinanden og returnere den første.
For alle disse klasser i Haskell findes der smukke symbolske operatører, hvilket gør programmering af Readers lignende ASCII-kunst. Bare se på denne fantastiske kode.
Vores opgaver var relateret til LaTeXReader. Vasiliy havde ansvaret for at støtte kommandoerne mbox og hbox, som er nyttige ved pakkeoprettelse i LaTeX. Elizabeths ansvar var at støtte epigraph-kommandoen, der muliggør formatering af epigrafer i LaTeX-dokumenter.
Hatrace
I UNIX-lignende operativsystemer er systemkaldet ptrace ofte implementeret. Det er nyttigt til debugging og simulering af programmiljøer, idet det muliggør overvågning af de systemkald, som programmet foretager. For eksempel bruger det meget nyttige værktøj strace netop ptrace internt.
Hatrace er et bibliotek, der tilbyder et interface til ptrace i Haskell. Problemet med ptrace er, at det er meget komplekst og at bruge det direkte er ret svært, især fra funktionelle sprog.
Hatrace fungerer som strace ved opstart og accepterer lignende argumenter. Forskellen fra strace er, at det også er et bibliotek, der giver et mere enkelt interface end bare ptrace.
Med hatrace har vi allerede fundet en uheldig bug i Haskell-kompilatoren GHC — når den afsluttes ubelejligt, genererer den ugyldige objektfiler og genkompilerer dem ikke ved genstart. Sk scripting af systemopkald gjorde det muligt at reproducere fejlen hos et enkelt opkald, hvor tilfældige afslutninger reproducerede fejlen på cirka to timer.
Vi har tilføjet systemopkaldsinterfacer til biblioteket — Elizaveta tilføjede brk, og Vasily tilføjede mmap. Som resultat af vores arbejde kan argumenterne til disse systemopkald nu bruges mere enkelt og præcist ved brug af biblioteket.
Kilde: habr.com
