

30. november – 1. december fandt der. Deltagerne blev bedt om at skabe en prototype af et produkt med Intel OpenVINO toolkit. Arrangørerne foreslog en liste over emner, som kunne bruges som retningslinjer for opgavevalg, men den endelige beslutning lå hos holdene. Derudover blev det opmuntret at bruge modeller, som ikke er inkluderet i produktet.
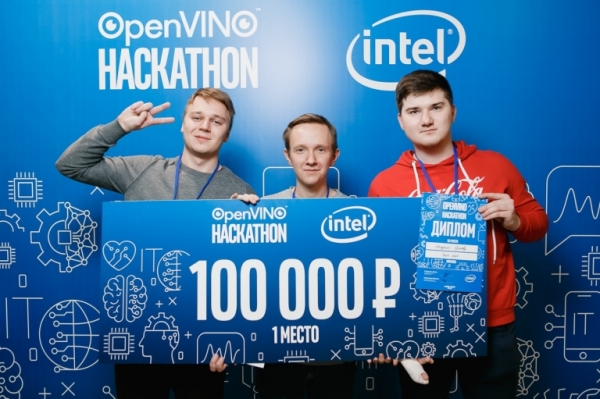
I artiklen vil vi fortælle om, hvordan vi skabte vores produktprototype, som vi til sidst vandt førstepladsen med.
Over 10 hold deltog i hackathonen. Det var dejligt, at nogle af dem kom fra andre regioner. Stedet for hackathonen var valgt til at være komplekset “Kremlevskiy na Pochaine”, som indeholder gamle fotografier af Nizjnij Novgorod, virkelig stemningsfuldt! (jeg minder om, at Intel's centrale kontor lige nu ligger i Nizjnij Novgorod). Deltagerne havde 26 timer til at skrive kode, og til sidst skulle de præsentere deres løsning. Et ekstra plus var muligheden for en demo-session for at sikre, at alt, der var planlagt, faktisk var implementeret og ikke bare forblev idéer i præsentationen. Merchandise, snacks, mad, alt var der også!
Derudover tilbød Intel, hvis ønskes, kameraer, Raspberry PI og Neural Compute Stick 2.
Valg af opgave
En af de sværeste dele af forberedelsen til hackathonet med fri tema er valget af opgave. Vi besluttede straks at finde på noget, der ikke er i produktet endnu, da det blev sagt i annoncen, at dette blev varmt anbefalet.
Ved at analysere , som er en del af produktet i den nuværende udgave, konkluderer vi, at de fleste af dem løser forskellige computer vision opgaver. Det er meget svært at finde på en computer vision opgave, som ikke kan løses ved hjælp af OpenVINO, og hvis en sådan kan findes, er det vanskeligt at finde foruddannede modeller offentligt tilgængeligt. Vi beslutter os for at dykke ind i en anden retning – mod talebehandling og -analyse. Vi overvejer en interessant opgave om genkendelse af følelser udfra tale. Det skal siges, at der allerede findes en model i OpenVINO, der identificerer menneskers følelser gennem ansigtet, men:
- Teoretisk set kan man lave en kombineret algoritme, der vil fungere både på lyd og billede, hvilket burde resultere i en forbedring af nøjagtigheden.
- Kameraer har som regel en smal synsvinkel, så for at dække et større område kræves der mere end én kamera; lyden har ikke denne begrænsning.
Lad os udvikle ideen: vi tager udgangspunkt i en løsning til detailsektoren. Vi kan måle kundetilfredshed ved kasserne i butikkerne. Hvis en kunde er utilfreds med servicen og begynder at hæve stemmen - kan vi straks tilkalde en administrator til hjælp.
I dette tilfælde skal vi inkludere talegenkendelse, hvilket gør os i stand til at skelne mellem butikspersonale og kunder, og således levere analyser for hver enkelt person. Desuden kan vi analysere adfærden hos medarbejderne i butikken og vurdere atmosfæren i teamet, det lyder godt!
Vi definerer kravene til vores løsning:
- Lille størrelse af mål-enheden
- Arbejder i realtid
- Lav pris
- Let skalerbarhed
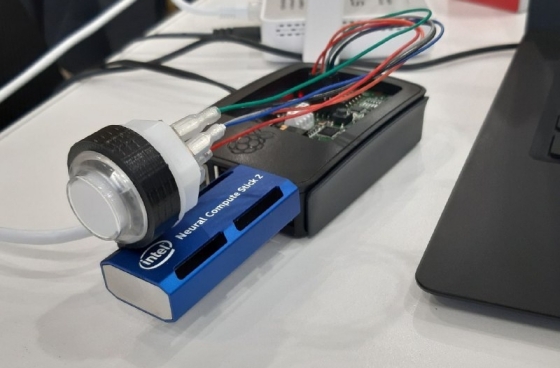
Som mål-enhed vælger vi Raspberry Pi 3 med .
Her er det vigtigt at bemærke en vigtig egenskab ved NCS - det fungerer bedst med standard CNN-arkitekturer; hvis vi skal køre en model med tilpassede lag, så forvent en lavniveau optimering.
Det handler om det små: vi skal have fat i en mikrofon. En almindelig USB-mikrofon vil også være fin, men den vil ikke se så godt ud sammen med RPI. Men her er løsningen lige ved hånden. Til optagelse af stemmen beslutter vi at bruge Voice Bonnet-kortet fra sættet , som har en indbygget stereomikrofon.
Vi downloader Raspbian fra og uploader det til et USB-drev; vi tester, at mikrofonen fungerer med følgende kommando (den vil optage lyd i 5 sekunder og gemme det i en fil):
arecord -d 5 -r 16000 test.wavJeg vil straks nævne, at mikrofonen er meget følsom og opfanger støj godt. For at rette op på dette går vi ind i alsamixer, vælger Capture-enheder og sænker indgangsniveauet til 50-60%.
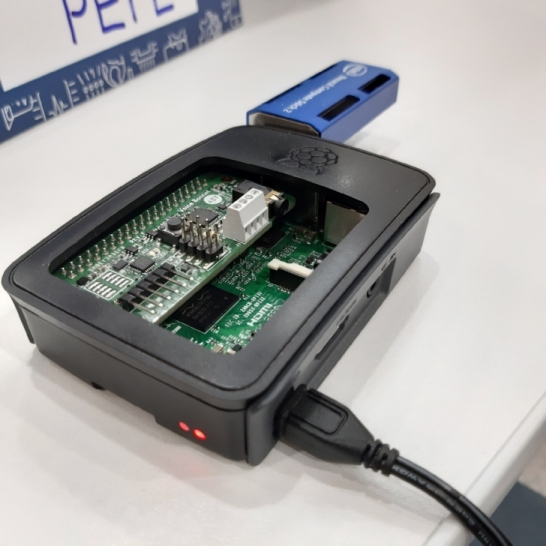
Vi tilpasser kabinettet med en fil, og alt passer, vi kan endda lukke låget.
Vi tilføjer en indikator-knap.
Under adskillelsen af AIY Voice Kit husker vi, at der er en RGB-knap, som kan styres programmæssigt. Vi søger "Google AIY Led" og finder dokumentationen:
Hvorfor ikke bruge denne knap til at vise den genkendte følelse? Vi har kun 7 klasser, og knappen har 8 farver, så det passer perfekt!
Vi tilslutter knappen via GPIO til Voice Bonnet, og indlæser de nødvendige biblioteker (de er allerede installeret i AIY projects-distributionen)
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Vi opretter en dict, hvor hver følelse svarer til en farve i form af en RGB-tuple og et objekt af klassen aiy.leds.Leds, som vi vil bruge til at opdatere farven:
led_dict = {'neutral': (255, 255, 255), 'happy': (0, 255, 0), 'sad': (0, 255, 255), 'angry': (255, 0, 0), 'fearful': (0, 0, 0), 'disgusted':  (255, 0, 255), 'surprised':  (255, 255, 0)}
leds = Leds()
Og til sidst, efter hver nye følelse, vil vi opdatere knapfarven i overensstemmelse hermed (efter nøgle).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))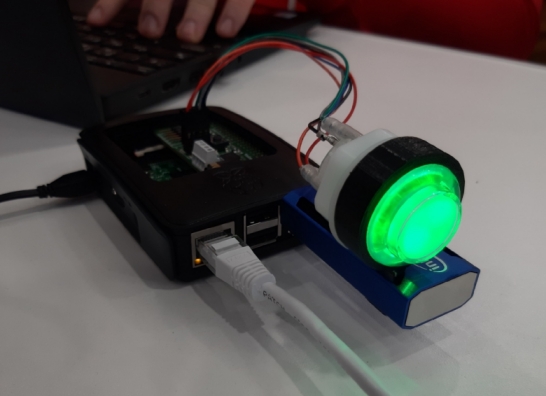
Lysknappen, lys!
Vi arbejder med stemmen
Vi vil bruge pyaudio til at fange strømmen fra mikrofonen og webrtcvad til at filtrere støj og detektere stemmen. Derudover opretter vi en kø, hvor vi asynkront vil tilføje og tage uddrag med stemmen.
Da webrtcvad har en begrænsning på størrelsen af den indsendte fragment — den skal være lig med 10/20/30 ms, og modellen til følelsernes genkendelse (som vi senere vil finde ud af) blev trænet på et datasæt med 48 kHz, vil vi fange chunks af størrelse 48000×20 ms/1000×1(mono)=960 bytes. Webrtcvad vil returnere True/False for hvert af disse chunks, hvilket svarer til tilstedeværelsen eller fraværet af stemme i chunket.
Vi implementerer følgende logik:
- Vi vil tilføje de chunks, hvor der er stemme, til listen, hvis der ikke er stemme, så inkrementerer vi tælleren for tomme chunks.
- Hvis tælleren for tomme chunks >=30 (600 ms), så ser vi på størrelsen af listen af akkumulerede chunks, hvis den >250, så tilføjer vi den til køen, hvis ikke, betragter vi at længden af optagelsen er utilstrækkelig til at sende den til modellen for identifikation af taleren.
- Hvis tælleren for tomme chunks stadig er < 30, og størrelsen af listen af akkumulerede chunks overstiger 300, så tilføjer vi uddraget til køen for en mere præcis forudsigelse. (fordi følelser har en tendens til at ændre sig over tid)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
Det er tid til at søge efter foruddannede modeller i det åbne, vi går til GitHub og Googler, men husk at vi har en begrænsning på den anvendte arkitektur. Dette er en forholdsvis kompleks del, fordi vi skal teste modeller på vores egne inputdata, og derudover konvertere til OpenVINOs interne format — IR (Intermediate Representation). Vi har prøvet omkring 5-7 forskellige løsninger fra GitHub, og mens modellen til følelsesgenkendelse fungerede med det samme, så tog det lidt længere tid med stemmegenkendelsen — der bruges mere komplekse arkitekturer.
Vi stopper ved følgende:
- Følelser fra stemmen —
Den fungerer efter følgende princip: lydklippene skæres i stykker af en bestemt størrelse, for hver af disse stykker identificerer vi og derefter sender vi dem som input til CNN - Stemmegengivelse —
Her arbejder vi i stedet for MFCC med spektrogrammet, efter FFT sender vi signalet til CNN, hvor vi får en vektorisk repræsentation af stemmen ud.
Derefter vil vi tale om konvertering af modeller, vi starter med teorien. OpenVINO inkluderer flere moduler:
- Open Model Zoo, modellerne fra hvilke kan anvendes og inkluderes i dit produkt
- Model Optimizer, som muliggør konvertering af modellen fra forskellige rammeformat (Tensorflow, ONNX osv.) til formatet Intermediate Representation, som vi derefter skal arbejde med
- Inference Engine muliggør kørsel af modeller i IR-format på Intel-processorer, Myriad-chips og Neural Compute Stick-acceleratorer
- Den mest effektive version af OpenCV (med støtte til Inference Engine)
Hver model i IR-format beskrives af to filer: .xml og .bin.
Modellerne konverteres til IR-format via Model Optimizer som følger:python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typeangiver formatet for de data, modellen vil arbejde med. FP32, FP16, INT8 understøttes. Valget af den optimale datatype kan give en god præstationsforøgelse.
--input_shapeangiver dimensionerne for inputdataene. Muligheden for dynamisk at ændre dette ser ud til at være tilgængelig i C++ API'en, men vi har ikke gravet så dybt, og for en af modellerne har vi blot fastlagt det.
Dernæst vil vi forsøge at indlæse den allerede konverterede model i IR-format gennem DNN-modulet i OpenCV og udføre en fremadrettet beregning på den.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)Den sidste linje gør det muligt at omdirigere beregningerne til Neural Compute Stick; beregningerne udføres som standard på processoren, men i tilfælde af Raspberry Pi fungerer det ikke, så vi skal bruge sticket.
Logikken er herefter følgende: vi opdeler vores lyd i vinduer af en bestemt størrelse (det er 0,4 sekunder for os), hver af disse vinduer omdanner vi til MFCC, som vi derefter sender til netværket:
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
Efterfølgende tager vi den mest almindelige klasse for alle vinduer. En simpel løsning, men til hackathonen må vi ikke opfinde noget alt for kompliceret, medmindre der er tid. Vi har stadig meget arbejde, så vi går videre — vi skal finde ud af stemmegennkendelse. Vi skal lave en database, hvor spektragrammerne af de forudindspillede stemmer opbevares. Da der er lidt tid tilbage, løser vi dette problem på den måde, vi kan.
Specifikt opretter vi et script til at optage en stemmeprøve (det fungerer ligesom beskrevet ovenfor, men når det stoppes med tastaturet, gemmer det stemmen i en fil).
Lad os prøve:
python3 voice_db/record_voice.py test.wavVi optager stemmerne fra flere personer (i vores tilfælde tre medlemmer af teamet)
Dernæst udfører vi en hurtig Fourier-transform for hver optaget stemme, får et spektragram og gemmer det som en numpy-array (.npy):for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)Mere information findes i filen
create_base.py
Som resultat, når vi kører det primære script, får vi i begyndelsen embeddings fra disse spektragrammer:for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)Efter at have modtaget embedding fra den afspillede sekvens kan vi bestemme, hvem den tilhører, ved at tage cosine distance fra sekvensen til alle stemmer i databasen (jo mindre, jo mere sandsynligt) - for demoen har vi sat en grænse på 0,3):
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
Til sidst vil jeg bemærke, at inferenshastigheden var hurtig og gjorde det muligt at tilføje endnu 1-2 modeller (for et sample på 7 sekunder tog inferens 2,5). Vi nåede ikke at tilføje nye modeller og fokuserede på at skrive prototypen af webapplikationen.
Webapplikation
Vigtigt punkt: Vi tager en router med hjemmefra og opsætter vores lokale netværk, det hjælper med at forbinde enheden og bærbare computere via netværket.
Backend fungerer som en kommunikationskanal mellem frontend og Raspberry Pi, baseret på websocket-teknologi (http over tcp-protokol).
Det første trin er at modtage den behandlede information fra Raspberry'en, det vil sige forudsagte data pakket i json, som undervejs gemmes i databasen for at kunne danne statistik om brugerens følelsesmæssige tilstand over en periode. Derefter sendes dette paket til frontend, der bruger abonnement og modtager pakker fra websocket-endpointet. Hele backend-mekanismen er bygget på golang, da det er velegnet til asynkrone opgaver, som gorutiner er gode til.
Når brugeren tilgår endpointet, registreres de og tilføjes til strukturen, hvorefter deres besked modtages. Både brugeren og beskeden tilføjes til det fælles hub, hvorfra beskederne sendes videre (til den abonnerede frontend), og hvis brugeren lukker forbindelsen (Raspberry eller frontend), ophæves deres abonnement, og de fjernes fra hubben.
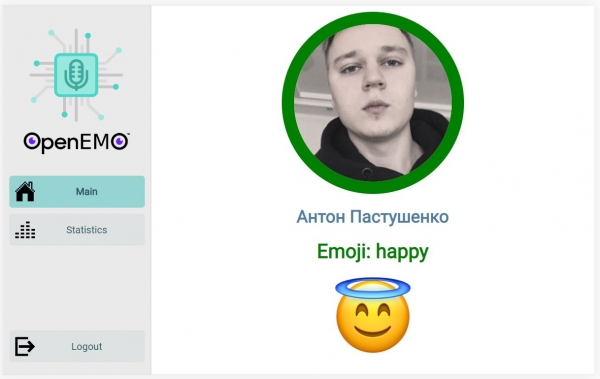
Vi afventer forbindelse med backendFront-end er en webapplikation skrevet i JavaScript med brug af React-biblioteket for at fremskynde og forenkle udviklingsprocessen. Formålet med denne applikation er at visualisere data, der modtages gennem algoritmer, der kører på back-end siden og direkte på Raspberry Pi. På siden er der routing mellem sektionerne, realiseret ved hjælp af react-router, men hovedinteressen ligger i startsiden, hvor der i realtid strømmer en kontinuerlig dataflow fra serveren via WebSocket-teknologien. Raspberry Pi registrerer stemmen, bestemmer tilhørsforholdet til en bestemt person fra den registrerede database og sender en liste over sandsynlighed til klienten. Klienten viser de nyeste relevante data, viser avatar af den person, som mest sandsynligt talte ind i mikrofonen, samt den følelse, som han eller hun udtrykker.

Startsiden med opdaterede forudsigelserKonklusion
Vi fik ikke afsluttet alt som planlagt; vi havde ganske enkelt ikke tid, så vores hovedhåb var på demoen, at alt ville fungere. Under præsentationen blev der fortalt om, hvordan alt er opbygget, hvilke modeller der blev brugt, og hvilke problemer vi stødte på. Derefter var der en del demonstrationen – eksperter gik rundt i lokalet i vilkårlig rækkefølge og kom hen til hvert hold for at se den fungerende prototype. De stillede os spørgsmål, og hver især svarede på sin del; vi efterlod en webversion på computeren, og det fungerede faktisk, som vi havde forventet.
Jeg vil bemærke, at den samlede pris for vores løsning var 150$:
- Raspberry Pi 3 ~ 35$
- Google AIY Voice Bonnet (kan være et respeaker board) ~ 15$
- Intel NCS 2 ~ 100$
Hvordan forbedre:
- Brug klientregistrering — helst få dem til at læse en tekst, som vi genererer tilfældigt.
- Tilføje et par modeller mere: stemmen kan bruges til at bestemme køn og alder.
- Skelne mellem samtidige stemmer (diarisering)
Repository:

Trætte, men glade viAfslutningsvis vil jeg gerne takke arrangørerne og deltagerne. Af andre holds projekter, kunne vi personligt lide løsningen til overvågning af ledige parkeringspladser. For os var dette en fantastisk oplevelse at dykke ned i produktet og udviklingen. Jeg håber, at der vil blive afholdt flere interessante arrangementer i regionerne, også inden for AI-tematikken.
Kilde: habr.com
