

Hello, Habr!
I efteråret sidste år fandt der et konkurrence på Kaggle sted om klassificering af håndtegnede billeder i Quick Draw Doodle Recognition, hvor et hold af R-folk deltog, bestående af , og . Vi vil ikke gå i detaljer med konkurrencen, da det allerede er beskrevet i .
. Denne gang lykkedes det ikke at få medaljer, men vi fik meget værdifuld erfaring, så jeg vil gerne dele nogle af de mest interessante og nyttige ting fra Kaggle og vores daglige arbejde med samfundet. Blandt de emner, vi overvejede, var det ikke let at klare sig uden OpenCV, parsing af JSON (i disse eksempler betragtes integration af C++-kode i scripts eller pakker i R ved hjælp af Rcpp), parameterisering af scripts og dockerisering af den endelige løsning. Al koden fra indlægget er tilgængelig i en kørbar form i .
Indhold:
1. Effektiv indlæsning af data fra CSV til MonetDB
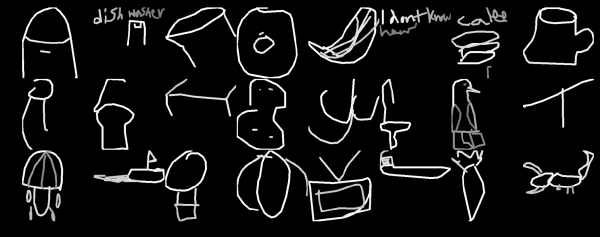
Data i denne konkurrence stilles ikke til rådighed som færdige billeder, men i form af 340 CSV-filer (én fil pr. klasse), der indeholder JSON-data med koordinaterne for punkterne. Ved at forbinde disse punkter med linjer får vi det endelige billede med en størrelse på 256x256 pixels. Derudover giver hver post en label, der angiver, om billedet blev korrekt genkendt af den klassifikator, der blev brugt på tidspunktet for indsamlingen af datasættet, en to-bogstav kode for landet, hvor forfatteren bor, et unikt ID, et tidsstempel og klassens navn, som stemmer overens med filnavnet. Den forenklede version af de oprindelige data vejer 7,4 GB i arkivet og cirka 20 GB efter udpakkes, mens de fulde data efter udpakkes fylder 240 GB. Arrangørerne garanterede, at begge versioner gengiver de samme tegninger, så den fulde version er overflødig. Under alle omstændigheder blev opbevaringen af 50 millioner billeder i grafiske filer eller i form af arrays straks anerkendt som ineffektiv, og vi besluttede at samle alle CSV-filerne fra arkivet train_simplified.zip i en database med efterfølgende generering af billeder i den nødvendige størrelse "on-the-fly" for hver batch.
Som en database blev en veletableret løsning valgt MonetDB, nemlig implementeringen til R i form af en pakke . Pakken inkluderer en embedded version af databaseserveren og gør det muligt at starte serveren direkte fra R-sessionen og arbejde med den der. Oprettelse af databasen og tilslutning til den udføres med en enkelt kommando:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Vi skal oprette to tabeller: en til alle data og en til kontroloplysninger om de uploadede filer (nødvendig, hvis noget går galt, og processen skal genoptages efter at have uploadet flere filer):
Oprettelse af tabeller
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
Den hurtigste måde at uploade data til databasen viste sig at være direkte kopiering af CSV-filer ved hjælp af SQL — kommandoen COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT, hvor tablename — navnet på tabellen og path — stien til filen. Under arbejdet med arkivet blev det opdaget, at den indbyggede implementering unzip i R fungerede forkert med nogle filer fra arkivet, så vi brugte systemet unzip (ved hjælp af parameteren getOption("unzip")).
Funktionen til at skrive til databasen
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
Hvis det er nødvendigt at transformere tabellen inden skrivning til databasen, er det tilstrækkeligt at videresende argumentet preprocess funktionen, der vil transformere dataene.
Koden til sekventiel upload af data til databasen:
Skrivning af data til databasen
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Tiden for upload af data kan variere afhængigt af hastighedsfordelene ved den anvendte lagringsenhed. I vores tilfælde tager læsning og skrivning mellem en SSD eller fra en USB-nøgle (kildefilen) til SSD'en (databasen) mindre end 10 minutter.
Yderligere sekunder kræves til at oprette en kolonne med en heltals klasseetiket og en indekskolonne (ORDERED INDEX) med række-numre, som observationerne vil blive udvalgt fra ved oprettelse af batches:
Oprettelse af yderligere kolonner og indeks
message("Genererer etiketter")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Generer rækningsnumre")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
For at løse opgaven med at danne batches "on the fly" måtte vi sikre os den maksimale hastighed til at trække tilfældige rækker fra tabellen doodles. Til dette brugte vi 3 tricks. Det første var at reducere datatypens dimension, hvori observations-ID'et gemmes. I det oprindelige datasæt kræves typen bigint, men antallet af observationer tillader os at passe deres identifikatorer, der svarer til rækkefølgen, ind i typen int. Søgningen foregår derved betydeligt hurtigere. Det andet trick var brugen af ORDERED INDEX — denne løsning kom vi frem til empirisk, efter at have gennemgået alle tilgængelige . Det tredje bestod i brugen af parameteriserede forespørgsler. Metoden består i én gang at udføre kommandoen PREPARE og derefter anvende den forberedte erklæring ved oprettelsen af en bunke ensartede forespørgsler, men gevinsten i praksis sammenlignet med en simpel SELECT var omkring den statistiske fejlmargin.
Dataindsætningsprocessen forbruger ikke mere end 450 MB RAM. Det vil sige, at den beskrevne tilgang gør det muligt at håndtere datasæt på flere titusinde gigabyte på stort set enhver budgetmaskine, inklusiv visse single-board computere, hvilket er ret imponerende.
Det er tilbage at måle hastigheden for at hente (tilfældige) data og vurdere skaleringen ved valg af batches af forskellige størrelser:
Database benchmark
library(ggplot2)

set.seed(0)
# Oprettelse af forbindelse til databasen
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Funktion til forberedelse af forespørgsel på serveren
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Funktion til at hente data
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Udførelse af måling
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Benchmark parametre
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("median tid, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 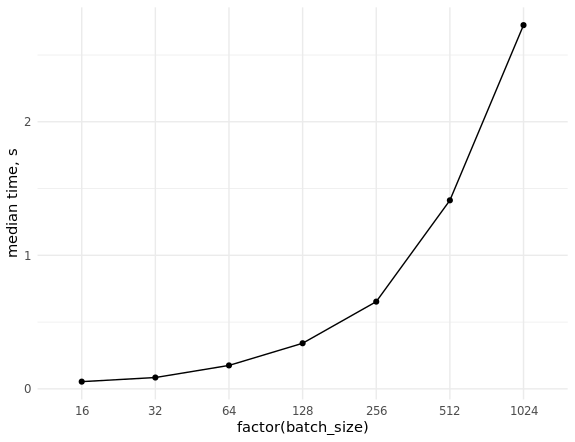
2. Forberedelse af batches
Hele batch-forberedelsesprocessen består af følgende faser:
- Parsing af flere JSON-filer, der indeholder vektorer af strenge med punkters koordinater.
- Tegning af farvede linjer baseret på punkternes koordinater på et billede af den ønskede størrelse (f.eks. 256×256 eller 128×128).
- Transformation af de modtagne billeder til en tensor.
I forbindelse med konkurrencen blandt kernels i Python blev opgaven løst primært ved hjælp af OpenCV. En af de mest simple og åbenlyse ækvivalenter i R ville se således ud:
Implementering af transformationen fra JSON til tensor i R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Parsing JSON
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Deletes the temporary file upon function completion
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Empty plot
  plot.new()
  # Plot window dimensions
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Line colors
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Convert image to a three-dimensional array
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Combine three-dimensional image arrays into a four-dimensional tensor
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
Tegning udføres ved hjælp af standardværktøjer i R, gemmes som en midlertidig PNG, der opbevares i RAM (i Linux findes de midlertidige mapper for R i en mappe /tmp, der er monteret i RAM). Denne fil læses derefter som et tredimensionelt array med tal i intervallet fra 0 til 1. Dette er vigtigt, da det mere almindelige BMP ville være blevet læst som et raw-array med hex-koder for farver.
Lad os teste resultatet:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 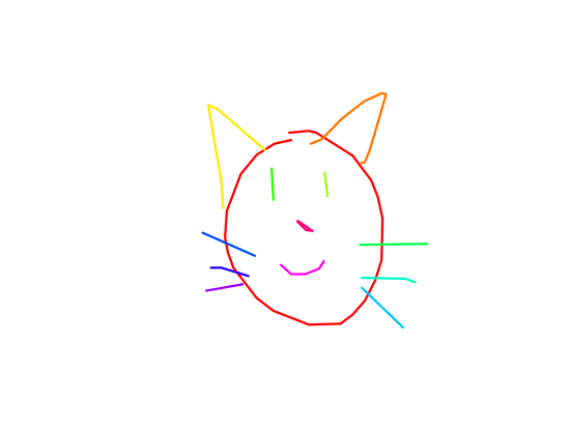
Batchen vil blive dannet på følgende måde:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Denne implementering virkede ikke optimal for os, da dannelsen af store batches tager uacceptabelt lang tid, og vi besluttede os for at drage fordel af erfaringerne fra kolleger og benytte et kraftfuldt bibliotek OpenCV. På det tidspunkt fandtes der ikke et færdigt package til R (og der er stadig ikke), så der blev skrevet en minimal implementering af den nødvendige funktionalitet i C++ med integration i koden i R ved hjælp af Rcpp.
Til opgaven blev følgende pakker og biblioteker brugt:
OpenCV til billedbehandling og linjeretning. Vi brugte forhåndsinstallerede systembiblioteker og header-filer samt dynamisk linking.
xtensor til at arbejde med multidimensionale arrays og tensorer. Vi brugte header-filer inkluderet i det navngivne R-pakke. Biblioteket muliggør arbejde med multidimensionale arrays, både i row major og column major orden.
ndjson til parsing af JSON. Dette bibliotek bruges i xtensor automatisk, hvis det er tilgængeligt i projektet.
RcppThread til at organisere multitrådet behandling af vektorer fra JSON'er. Vi brugte header-filer leveret af denne pakke. Dette er mere populært end RcppParallel pakken adskiller sig blandt andet ved at have en indbygget mekanisme til at afbryde løkker (interrupt).
Det skal bemærkes, at xtensor var en gave: udover at have et omfattende funktionssæt og høj ydeevne, var deres udviklere meget lydhøre og svarede hurtigt og grundigt på eventuelle spørgsmål. Med deres hjælp kunne vi implementere transformationer af OpenCV-matricer til xtensor-tensorer, samt en metode til at kombinere 3-dimensionale billedtensorer til en 4-dimensionel tensor med korrekt dimension (faktisk batch).
Materialer til at studere Rcpp, xtensor og RcppThread
For at kompilere filer, der bruger systemfiler og dynamisk linkning med installerede biblioteker i systemet, brugte vi plugin-mekanismen implementeret i pakken Rcpp. For automatisk at finde stier og flag brugte vi det populære linux-værktøj pkg-config.
Implementering af Rcpp-plugin til brug af OpenCV-biblioteket
Rcpp::registerPlugin("opencv", function() {
  # Mulige navne på pakken
  pkg_config_name <- c("opencv", "opencv4")
  # Binær fil til pkg-config utility
  pkg_config_bin <- Sys.which("pkg-config")
  # Tjek for tilgængelighed af utility i systemet
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Tjek for konfigurationsfil for OpenCV til pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("OpenCV config for the pkg-config not found", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
Som et resultat af pluginens arbejde vil de følgende værdier blive indsat under kompileringen:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
Koden til implementeringen af JSON-parsing og batch-dannelse til overførsel til modellen er angivet under spoileren. Først tilføjer vi den lokale projektmappe for at finde headerfiler (dette er nødvendigt for ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implementering af konvertering af JSON til tensor i C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Denne kode skal placeres i filen src/cv_xt.cpp og kompilere med kommandoen Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); der kræves også nlohmann/json.hpp af . Koden er opdelt i flere funktioner:
to_xt— en templatiseret funktion til at konvertere et billedmatrix (cv::Mat) til tensorxt::xtensor;parse_json— funktionen parser JSON-strengen, udtrækker punktkoordinater og pakker dem i en vektor;ocv_draw_lines— fra den modtagne punktevektor tegnes farvede linjer;process— kombinerer de ovenfor beskrevne funktioner og tilføjer muligheden for skalering af det modtagne billede;cpp_process_json_str— en wrapper rundt om funktionenprocess, der eksporterer resultatet til et R-objekt (flermatrix);cpp_process_json_vector— en wrapper rundt om funktionencpp_process_json_str, som muliggør behandling af en strengvektor i multitrådet tilstand.
Til tegning af farvede linjer blev farvemodellen HSV brugt med efterfølgende konvertering til RGB. Lad os teste resultatet:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 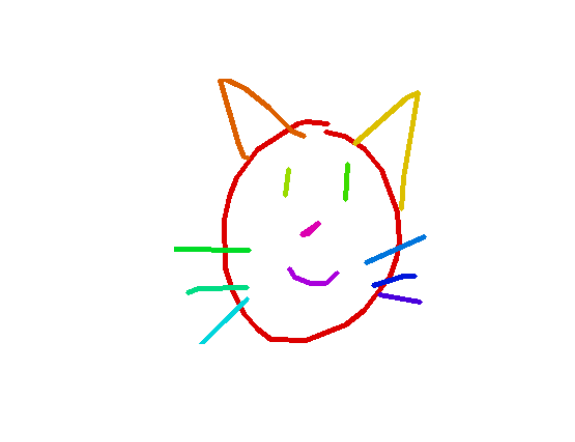
Sammenligning af hastigheden for implementeringerne i R og C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Benchmark parameters
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/sec` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Conducting measurement
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/sec` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>     <dbl>   <bch:tm> <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("median time, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 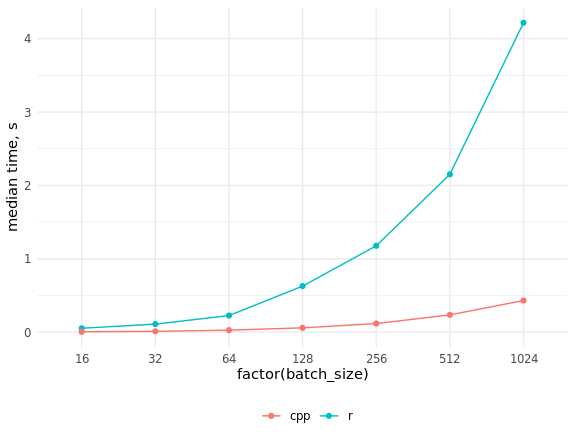
Som vi kan se, var hastighedsgevinsten meget betydelig, og det er ikke muligt at indhente C++-koden ved hjælp af parallelisering af R-koden.
3. Iteratorer til udtræk af batcher fra databasen
R har et velfortjent rygte som et sprog til behandling af data, der passer ind i RAM, mens Python er mere karakteriseret ved iterativ databehandling, der gør det nemt og uformelt at implementere out-of-core beregninger (beregninger med ekstern hukommelse). et klassisk og vigtigt eksempel på disse beregninger i vores kontekst er dybe neurale netværk, der trænes med gradient descent-metoden ved at approximere gradienten i hvert trin på en lille portion observationer eller mini-batch.
Frameworks til dyb læring skrevet i Python har specielle klasser, der implementerer iteratorer over data: tabeller, billeder i mapper, binære formater mv. Man kan bruge færdige løsninger eller skrive sine egne til specifikke opgaver. I R kan vi udnytte alle mulighederne fra Pythons bibliotek keras med sine forskellige backend ved hjælp af den tilsvarende pakke, som i sin tur kører oven på pakken reticulate. Sidstnævnte fortjener en stor artikel i sig selv; den tillader ikke kun at køre Python-kode fra R, men sikrer også overførsel af objekter mellem R- og Python-sessioner, automatisk udføre alle nødvendige typekonverteringer.
Vi har frigjort os fra nødvendigheden af at opbevare alle data i RAM ved at bruge MonetDBLite, alt "neuro-netværks" arbejde vil blive udført af original Python-kode, vi skal blot skrive en dataiterator, da der ikke findes en færdig løsning til denne situation hverken i R eller Python. Der er i princippet kun to krav til det: det skal returnere batcher i en uendelig løkke og bevare sin tilstand mellem iterationerne (sidstnævnte i R kan simpelthen implementeres ved hjælp af closures). Tidligere var det nødvendigt inden i iteratoren eksplicit at konvertere R-arrays til numpy-arrays, men den aktuelle version af pakken keras gør det selv.
Iteratoren til trænings- og valideringsdataene ser således ud:
Iterator til trænings- og valideringsdata
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
Funktionen tager en variabel med forbindelsen til databasen, numrene på de anvendte rækker, antallet af klasser, batchstørrelsen, skala (scale = 1 svarende til at tegne billeder på 256x256 pixels, scale = 0.5 - 128x128 pixels), farveindikator (color = FALSE definerer tegning i gråtoner, når den bruges farve = TRUE hver streg tegnes med en ny farve) og en præprocesseringsindikator for netværk, der er foruddannet på imagenet. Sidstnævnte er nødvendig for at skalere pixelværdierne fra intervallet [0, 1] til intervallet [-1, 1], som blev brugt under træningen af de medfølgende keras modeller.
Den eksterne funktion indeholder en typekontrol af argumenterne, en tabel data.table med tilfældigt blandede rækkenumre fra samples_index og batchnumre, en tæller og maksimalt antal batches samt et SQL-udtryk til at hente data fra databasen. Derudover definerede vi hurtigt en analog funktion keras::to_categorical(). Vi brugte næsten alle data til træning og efterlod et halvt procent til validering, så størrelsen af epokerne blev begrænset af parameteren steps_per_epoch ved kald af keras::fit_generator(), og betingelsen if (i > max_i) blev kun aktiveret for valideringsiteratoren.
I den indre funktion udtages rækkenumre for den næste batch, data hentes fra databasen med en stigning i batchtælleren, JSON'er parses (funktionen cpp_process_json_vector(), skrevet i C++) og arrays, der svarer til billederne, oprettes. Derefter oprettes one-hot vektorer med klasseetiketter, arrays med pixelværdier og etiketterne kombineres i en liste, som er returværdien. For at fremskynde arbejdet blev der anvendt oprettelse af indekser i tabellerne data.table og referencemodifikation — uden disse "tricks" i pakken data.table er det ret svært at forestille sig effektivt arbejde med nogen væsentlige datamængder i R.
Resultaterne af hastighedsmålinger på en bærbar computer med Core i5 ser således ud:
Benchmark for iteratoren
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Indekser for træningsdatasættet
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Indekser for valideringsdatasættet
val_ind <- ind[-train_ind]
rm(ind)
# Skaleringsfaktor
scale <- 0.5

# Udførelse af benchmark
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Benchmarkparametre
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("median tid, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 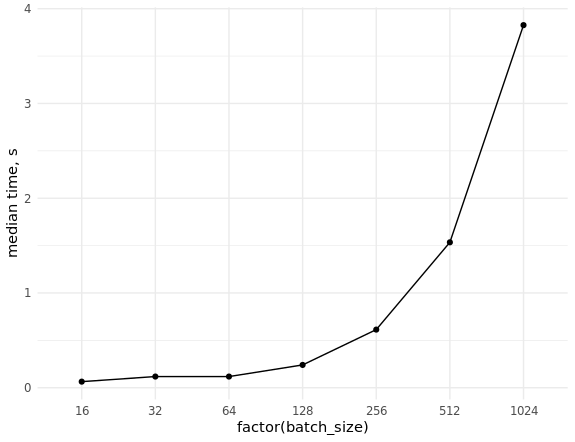
Hvis der er tilstrækkelig RAM, kan databasearbejde accelereres betydeligt ved at flytte den til denne RAM (32 GB er tilstrækkeligt til vores opgave). I Linux monteres som standard et partition /dev/shm, der tager op til halvdelen af RAM'ens størrelse. Man kan også afsætte mere ved at redigere /etc/fstab, så det ligner en indtastning som tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Sørg for at genstarte og kontrollere resultatet med kommandoen df -h.
Iteratoren til testdata ser meget enklere ud, da hele testdatasættet passer ind i RAM:
Iterator til testdata
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Valg af modelarkitektur
Den første anvendte arkitektur var , hvis egenskaber er beskrevet i meddelelsen. Den findes i standardleverancen keras og er derfor tilgængelig i den tilsvarende pakke til R. Men ved forsøg på at bruge den med enkeltkanals billeder viste det sig, at indgangstensoren altid skal have dimensionerne (batch, højde, bredde, 3), så antallet af kanaler kan ikke ændres. I Python findes der ikke nogen sådan begrænsning, derfor skyndte vi os at skrive vores egen implementering af denne arkitektur i overensstemmelse med den oprindelige artikel (uden dropout, som findes i den keras-version):
mobilenet v1-arkitektur
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Ulemperne ved denne tilgang er åbenlyse. Der er mange modeller, vi gerne vil teste, men vi ønsker ikke at skrive hver arkitektur manuelt. Desuden var vi frataget muligheden for at bruge vægtene fra modeller, der var foruddannet på imagenet. Som sædvanlig hjalp det at studere dokumentationen. Funktionen get_config() giver mulighed for at få beskrivelse af modellen i en redigerbar form (base_model_conf$layers — almindelig R-liste), og funktionen from_config() udfører den omvendte transformation til en modelobjekt:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Det er nu let at skrive en universel funktion til at få enhver af de modeller, der leveres med keras vægte trænet på imagenet eller uden:
Funktion til at indlæse færdige arkitekturer
get_model <- function(name = "mobilenet_v2",
                      input_shape = NULL,
                      weights = "imagenet",
                      pooling = "avg",
                      num_classes = NULL,
                      optimizer = keras::optimizer_adam(lr = 0.002),
                      loss = "categorical_crossentropy",
                      metrics = NULL,
                      color = TRUE,
                      compile = FALSE) {
  # Tjekker argumenterne
  checkmate::assert_string(name)
  checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3)
  checkmate::assert_count(num_classes)
  checkmate::assert_flag(color)
  checkmate::assert_flag(compile)

  # Får objektet fra keras-pakken
  model_fun <- get0(paste0("application_", name), envir = asNamespace("keras"))
  # Tjekker om objektet findes i pakken
  if (is.null(model_fun)) {
    stop("Model ", shQuote(name), " ikke fundet.", call. = FALSE)
  }

  base_model <- model_fun(
    input_shape = input_shape,
    include_top = FALSE,
    weights = weights,
    pooling = pooling
  )

  # Hvis billedet ikke er farvet, ændrer vi dimensionerne på input
  if (!color) {
    base_model_conf <- keras::get_config(base_model)
    base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
    base_model <- keras::from_config(base_model_conf)
  }

  predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output
  predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax")
  model <- keras::keras_model(
    inputs = base_model$input,
    outputs = predictions
  )

  if (compile) {
    keras::compile(
      object = model,
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )
  }

  return(model)
}
Når der anvendes monochrome billeder, bruges de foruddannede vægte ikke. Dette kunne rettes: ved hjælp af funktionen get_weights() for at få vægtene fra modellen som en liste af R-arrays, ændre dimensionen på det første element i denne liste (ved at tage en farvekanal eller gennemsnitligt de tre), og derefter indlæse vægtene tilbage i modellen med funktionen set_weights(). Vi tilføjede ikke denne funktionalitet, da det på dette tidspunkt allerede var klart, at det var mere produktivt at arbejde med farvebilleder.
Vi udførte hovedparten af eksperimenterne ved hjælp af mobilenet version 1 og 2 samt resnet34. I denne konkurrence klarede mere moderne arkitekturer som SE-ResNeXt sig godt. Desværre havde vi ikke færdige implementeringer til rådighed, og vi skrev ikke vores egne (men vi vil helt sikkert gøre det).
5. Parameterisering af scripts
For nemheds skyld blev koden til at starte træningen udformet som et enkelt script, parametriseret ved hjælp af som følger:
doc <- '
Usage:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [options]

Options:
  -h --help                   Vis denne meddelelse.
  -l --list-models            List tilgængelige modeller.
  -m --model=          Navn på neuralt netværksmodel [standard: mobilenet_v2].
  -b --batch-size=      Batch-størrelse [standard: 32].
  -s --scale-factor=   Skaleringsfaktor [standard: 0.5].
  -c --color                  Brug farvede linjer [standard: FALSE].
  -d --db-dir=          Sti til databasekatalog [standard: Sys.getenv("db_dir")].
  -r --validate-ratio= Validering sample ratio [standard: 0.995].
  -n --n-gpu=         Antal GPUs [standard: 1].
'
args <- docopt::docopt(doc)
Pakken docopt repræsenterer en implementering for R. Med den kan scripts startes med enkle kommandoer som Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db eller ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, hvis filen train_nn.R er eksekverbar (denne kommando vil starte træningen af modellen resnet50 på RGB-billeder med størrelsen 128x128 pixels, databasen skal befinde sig i mappen /home/andrey/doodle_db). Der kan tilføjes læringshastighed, type optimizer og alle andre konfigurerbare parametre. Under forberedelsen af publikationen blev det konstateret, at arkitekturen mobilenet_v2 fra den aktuelle version keras kan anvendes i R på grund af uovervejede ændringer i R-pakken — vi venter på, at det bliver rettet.
Denne tilgang gjorde det muligt at fremskynde eksperimenterne med forskellige modeller betydeligt sammenlignet med den mere traditionelle kørsel af scripts i RStudio (som et muligt alternativ kan vi nævne pakken ). Men den største fordel er muligheden for nemt at styre kørsel af scripts i Docker eller blot på serveren, uden at skulle installere RStudio.
6. Dockerisering af scripts
Vi brugte Docker for at sikre portabilitet af miljøet til træning af modeller mellem teammedlemmer og til hurtig implementering i skyen. Du kan begynde at lære denne forholdsvis uvante værktøj til R-programmører ved hjælp af en række publikationer eller med .
Docker gør det muligt at oprette egne billeder "fra bunden" samt at bruge andre billeder som grundlag for at oprette egne. Ved gennemgang af de tilgængelige muligheder kom vi frem til, at installationen af NVIDIA-drivere, CUDA+cuDNN og Python-biblioteker er en ret omfattende del af billedet, og vi besluttede at tage udgangspunkt i det officielle billede tensorflow/tensorflow:1.12.0-gpu, og tilføje de nødvendige R-pakker.
Det endelige dockerfile blev som følger:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
For nemheds skyld er de anvendte pakker blevet flyttet til variabler; hovedparten af de skrevne scripts kopieres ind i containerne under byggeprocessen. Vi har også ændret kommandoskallen til /bin/bash for at gøre brugen af indholdet mere bekvemt /etc/os-release. Dette har gjort det unødvendigt at angive OS-versionen i koden.
Derudover blev der skrevet et lille bash-script, der muliggør opstart af containeren med forskellige kommandoer. For eksempel kan det være scripts til træning af neurale netværk, der tidligere blev inkluderet i containeren, eller en kommandolinje til fejlfinding og overvågning af containerens drift:
Script til at starte containeren
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Hvis dette bash-script køres uden argumenter, vil et script med standardværdier blive kaldt inden i containeren; hvis det første positionelle argument er "bash", vil containeren blive startet i interaktiv tilstand med kommandolinjen. I alle andre tilfælde vil de positionelle argumenter blive indsat: train_nn.R CMD="Rscript /app/train_nn.R $@" Det er værd at bemærke, at mapperne med rådata og databasen samt mappen til gemte træningsmodeller monteres ind i containeren fra værtsystemet, hvilket gør det muligt at få adgang til resultatet af scriptets arbejde uden unødvendige manipulationer..
7. Brug af flere GPU'er i Google Cloud
En af de bemærkelsesværdige træk ved konkurrencen var de ret støjende data (se det øverste billede, lånt fra @Leigh.plt fra ODS-slacken). Store batches hjælper med at tackle dette, og efter eksperimenter på en PC med 1 GPU besluttede vi at lære modeltræning på flere GPU'er i skyen. Vi brugte Google Cloud (
en god vejledning til grundlæggende arbejdsmådedev/shm Den mest interessante del af koden, der håndterer brugen af flere GPU'er, starter med at modellen oprettes på CPU'en ved hjælp af en kontekstyder, ligesom i Python:.
with(tensorflow::tf$device("/cpu:0"), { model_cpu <- get_model( name = model_name, input_shape = input_shape, weights = weights, metrics =(top_3_categorical_accuracy, compile = FALSE ) })
Derefter kopieres den ikke-kompilerede (det er vigtigt) model til det angivne antal tilgængelige GPU'er, og først derefter kompilere den:model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu) keras::compile( object = model, optimizer = keras::optimizer_adam(lr = 0.0004), loss = "categorical_crossentropy", metrics = c(top_3_categorical_accuracy) )
Den klassiske metode med at fryse alle lag undtagen det sidste, træne det sidste lag, tø elefanten op og finjustere hele modellen for flere GPU'er, kunne ikke realiseres.Der blev overvåget træning uden brug af
tensorboard tensorboard, ved kun at registrere logs og gemme modeller med informative navne efter hver epoke:
Callbacks
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. I stedet for konklusion
En række problemer, som vi har stødt på, er endnu ikke løst:
- i keras der mangler en klar funktion til automatisk at finde den optimale læringsrate (analog til
lr_finderi biblioteket fast.ai); med lidt indsats kan man portere til R tredjepartsimplementeringer, for eksempel ; - som følge af det forrige punkt, var det ikke muligt at finde den rigtige læringsrate ved brug af flere GPU'er;
- vi mangler moderne arkitekturer for neurale netværk, især fortrænet på imagenet;
- der er ikke one cycle policy og diskriminerende læringsrater (cosine annealing blev på vores anmodning , tak ).
Hvad værdifuldt har vi lært fra denne konkurrence:
- På relativt svag hardware kan man arbejde smertefrit med betydelige (mange gange større end RAM-størrelsen) datamængder. Pakken data.table sparer hukommelse ved hjælp af in-place modifikationer af tabeller, hvilket gør det muligt at undgå deres kopiering, og når den bruges korrekt, viser den næsten altid den højeste hastighed blandt alle kendte værktøjer til skriptsprog. Opbevaring af data i en database betyder, at man i mange tilfælde slet ikke behøver at tænke på at presse hele datasættet ind i RAM.
- Langsomme funktioner i R kan erstattes af hurtige i C++ ved hjælp af pakken Rcpp. Hvis man desuden bruger RcppThread eller RcppParallel, får vi tværplatformede multitrådede implementeringer, så koden på R-niveau skal ikke paralleliseres.
- Pakken Rcpp kan anvendes uden omfattende viden om C++, det nødvendige minimum er beskrevet . Header-filer for en række seje C-biblioteker som xtensor er tilgængelige på CRAN, hvilket betyder, at der dannes en infrastruktur til implementering af projekter, der integrerer klart højtydende C++-kode i R. Yderligere bekvemmelighed er syntaksfremhævning og statisk kodeanalyseværktøj til C++ i RStudio.
- docopt giver mulighed for at køre selvstændige scripts med parametre. Dette er praktisk til brug på en fjernserver, inklusive under Docker. Det er besværligt at udføre time-lange eksperimenter med træning af neurale netværk i RStudio, og installation af IDE'en på serveren er ikke altid berettiget.
- Docker sikrer bærbarhed af kode og reproducerbarhed af resultater mellem udviklere med forskellige versioner af OS og biblioteker samt enkelheden ved opstart på servere. Man kan starte hele pipeline til træning med blot en enkelt kommando.
- Google Cloud er en budgetvenlig måde at eksperimentere med dyr hardware på, men det er vigtigt at vælge konfigurationer omhyggeligt.
- At måle hastigheden af individuelle kodefragmenter er meget nyttigt, især når man kombinerer R og C++, og med pakken bench er det også meget nemt.
Overordnet set har denne oplevelse været meget nyttig, og vi fortsætter med at arbejde på løsning af nogle af de nævnte problemer.
Kilde: habr.com
