

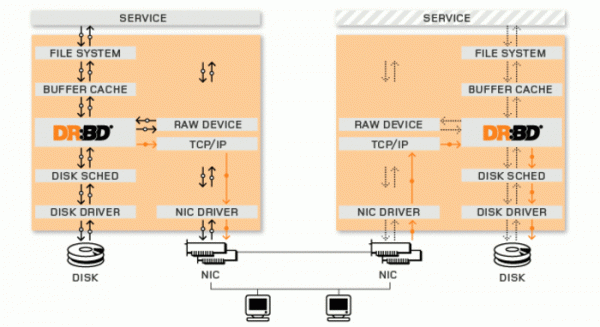
Die Veröffentlichung des verteilten, replizierbaren Blockgeräts DRBD 9.2.0 wurde bekannt gegeben, das die Realisierung einer RAID-1-ähnlichen Anordnung ermöglicht, die aus über das Netzwerk verbundenen Festplatten verschiedener Maschinen besteht (Netzwerk-Spiegelung). Das System ist als Modul für den Linux-Kernel gestaltet und wird unter der GPLv2-Lizenz verbreitet. Der Branch drbd 9.2.0 kann für einen transparenten Austausch mit drbd 9.x.x verwendet werden und ist auf Protokollebene sowie hinsichtlich der Konfigurationsdateien und -werkzeuge vollständig kompatibel.
DRBD ermöglicht es, die Speichergeräte der Knoten eines Clusters zu einem gemeinsamen, ausfallsicheren Speicher zu verbinden. Für Anwendungen und das System erscheint dieser Speicher für alle Systeme als identisches Blockgerät. Bei der Verwendung von DRBD werden alle Operationen mit der lokalen Festplatte an andere Knoten gesendet und mit den Festplatten anderer Maschinen synchronisiert. Fällt ein Knoten aus, funktioniert der Speicher automatisch weiter über die verbleibenden Knoten. Bei der Wiederherstellung der Verfügbarkeit des ausgefallenen Knotens wird dessen Zustand automatisch auf den aktuellen Stand gebracht.
Zum Cluster, der den Speicher bildet, können mehrere Dutzend Knoten gehören, die sowohl im lokalen Netzwerk als auch geografisch verteilt in verschiedene Rechenzentren. Die Synchronisation in solchen verteilten Speichern erfolgt durch den Einsatz von Mesh-Netzwerktechnologien (Daten fließen in einer Kette von Knoten zu Knoten). Die Replikation der Knoten kann sowohl synchron als auch asynchron erfolgen. Beispielsweise können lokal platzierte Knoten die synchrone Replikation verwenden, während für die Übertragung zu entfernten Standorten die asynchrone Replikation mit zusätzlicher Kompression und Verschlüsselung des Traffics eingesetzt werden kann.
In der neuen Version:
- Die Latenzen für die gespiegelt geschriebenen Anfragen wurden gesenkt. Eine engere Integration mit dem Netzwerk-Stack ermöglichte eine Reduzierung der Kontextwechsel des Planers.
- Die Konkurrenz zwischen dem Eingabe-/Ausgabeverkehr der Anwendungen und dem Eingabe-/Ausgabeverkehr der Resynchronisation wurde durch Optimierung der Sperren während der Resynchronisation von Extents verringert.
- Die Leistung der Resynchronisation in Backends, die dynamische Speicherzuweisung („thin provisioning“) verwenden, wurde erheblich verbessert. Die Leistung konnte gesteigert werden, indem die Operationen trim/discard zusammengeführt wurden, die deutlich länger als normale Schreiboperationen dauern.
- Die Unterstützung von Netzwerk-Namensräumen (network namespaces) wurde hinzugefügt, die die Integration mit Kubernetes zur Übertragung des Replikationstraffics über ein für Container getrenntes Netzwerk anstelle des Hostnetzwerks ermöglicht.
- Ein Modul transport_rdma wurde hinzugefügt, um Infiniband/RoCE als Transport statt TCP/IP über Ethernet zu verwenden. Der Einsatz des neuen Transports ermöglicht geringere Latenzen, reduziert die CPU-Last und gewährleistet die Datenübertragung ohne zusätzliche Kopieroperationen (zero-copy).
Quelle: opennet.ru
