

Die größten Unternehmen, die sich mit der Entwicklung im Bereich des maschinellen Lernens beschäftigen, haben das Projekt OpenXLA vorgestellt, das auf die gemeinsame Entwicklung von Werkzeugen zur Kompilierung und Optimierung von Modellen für Systeme des maschinellen Lernens abzielt. Unter das Projekt fiel die Entwicklung von Werkzeugen, die es ermöglichen, die Kompilierung von Modellen, die in den Frameworks TensorFlow, PyTorch und JAX vorbereitet wurden, zu vereinheitlichen, um ein effektives Lernen und eine Ausführung auf verschiedenen GPUs und spezialisierten Beschleunigern zu ermöglichen. An der gemeinsamen Arbeit an dem Projekt beteiligten sich Unternehmen wie Google, NVIDIA, AMD, Intel, Meta, Apple, Arm, Alibaba und Amazon.
Es wird erwartet, dass durch die Zusammenlegung der Anstrengungen führender Forschungsteams und Vertreter der Community die Entwicklung von Systemen des maschinellen Lernens angeregt und das Problem der Fragmentierung der Infrastruktur für verschiedene Frameworks und Hardware gelöst werden kann. OpenXLA ermöglicht eine effiziente Unterstützung verschiedener Hardware, unabhängig davon, auf welchem Framework das Modell des maschinellen Lernens basiert. Es wird erwartet, dass OpenXLA dazu beitragen kann, die Trainingszeit von Modellen zu verkürzen, die Bandbreite zu erhöhen, Latenzzeiten zu reduzieren, die Kosten für Rechenressourcen zu senken und die Markteinführungszeit zu verkürzen.
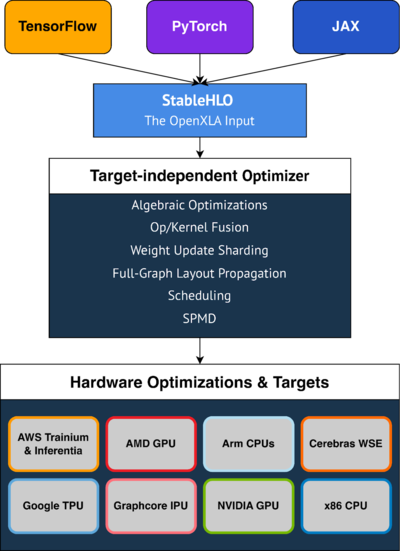
OpenXLA besteht aus drei Hauptkomponenten, deren Code unter der Lizenz Apache 2.0 verbreitet wird:
- XLA (Accelerated Linear Algebra) — ein Compiler, der es ermöglicht, Modelle des maschinellen Lernens für eine hochleistungsfähige Ausführung auf verschiedenen Hardwareplattformen zu optimieren, einschließlich GPUs, CPUs und spezialisierten Beschleunigern verschiedener Hersteller.
- StableHLO — eine Spezifikation und eine grundlegende Implementierung einer Reihe von hochgradigen Operationen (HLO, High-Level Operations) zur Verwendung in Modellen von Systemen des maschinellen Lernens. Es fungiert als Schnittstelle zwischen den Frameworks des maschinellen Lernens und den Compilern, die das Modell für die Ausführung auf spezifischer Hardware umwandeln. Schnittstellen zur Generierung von Modellen im StableHLO-Format wurden für die Frameworks PyTorch, TensorFlow und JAX vorbereitet. Als Grundlage für StableHLO wurde das MHLO-Set verwendet, das um die Unterstützung von Serialisierung und Versionierung erweitert wurde.
- IREE (Intermediate Representation Execution Environment) — ein Compiler und Runtime, der Modelle des maschinellen Lernens in eine universelle Zwischenrepräsentation umwandelt, die auf dem MLIR-Format (Multi-Level Intermediate Representation) des LLVM-Projekts basiert. Zu den besonderen Merkmalen gehören die Möglichkeit der Vorabkompilierung (ahead-of-time), die Unterstützung der Steuerflusskontrolle, die Nutzung dynamischer Elemente in Modellen, die Optimierung für verschiedene CPUs und GPUs sowie geringe Overheadkosten.
Die Hauptvorteile des OpenXLA-Toolkits:
- Erzielen optimaler Leistung, ohne dass tiefgreifende Kenntnisse in der programmierung gerätespezifischer Codes erforderlich sind. Bereitstellung fertiger Optimierungen, einschließlich der Vereinfachung algebraischer Ausdrücke, effizienter Speichereinteilung und der Planung der Ausführung unter Berücksichtigung der Reduzierung des maximalen Speicherverbrauchs und von Überlastungen.
- Vereinfachung der Skalierung und Parallelisierung von Berechnungen. Der Entwickler muss lediglich Annotationen für eine Teilmenge kritischer Tensoren hinzufügen, auf deren Grundlage der Compiler automatisch Code für parallele Berechnungen generieren kann.
- Gewährleistung der Portabilität durch Unterstützung verschiedener Hardwareplattformen, wie AMD- und NVIDIA-GPUs, CPUs auf Basis der Architekturen x86 und ARM, ML-Beschleuniger von Google TPU, IPU AWS Trainium und Inferentia, Graphcore und Cerebras Wafer-Scale Engine.
- Unterstützung für die Anbindung von Erweiterungen zur Implementierung zusätzlicher Funktionen, wie die Unterstützung der Programmierung von primitives für tiefes maschinelles Lernen mit CUDA, HIP, SYCL, Triton und anderen Sprachen für parallele Berechnungen. Möglichkeit der manuellen Feinabstimmung von Engpässen in Modellen.
Quelle: opennet.ru
